本節の導入:
前の2つの節では、Android組み込みのHTTPリクエスト方式であるHttpURLConnectionとHttpClientについて説明しました。もともとはOkHttpがすでに組み込まれていると思っていたので、OkHttpの基本的な使い方を解説しようと思っていましたが、結局のところサードパーティの導入が必要だと分かったので、それはさておき、上級編に回すことにしました。本節では、Androidが提供する3つのXMLデータ解析の方法について学びます。それはSAX、DOM、PULLの3つの解析方式です。それでは、これらについて学んでいきましょう。
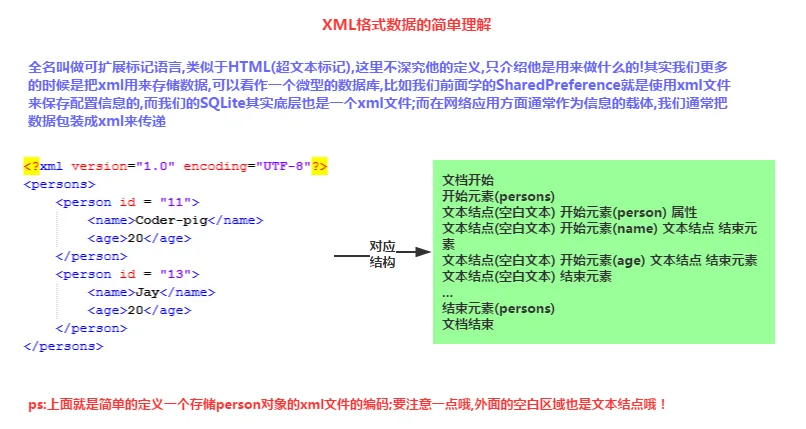
1. XMLデータの要点の紹介
まず、XMLデータの要件と概念について見てみましょう:
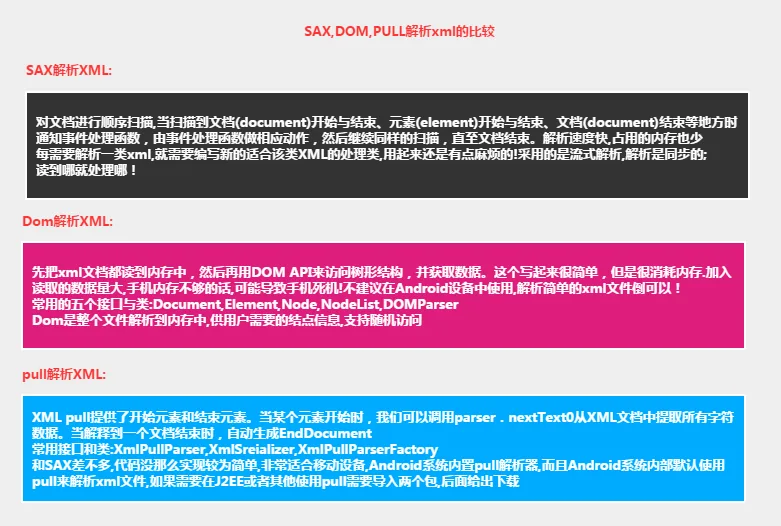
2. XML解析方法3種の比較
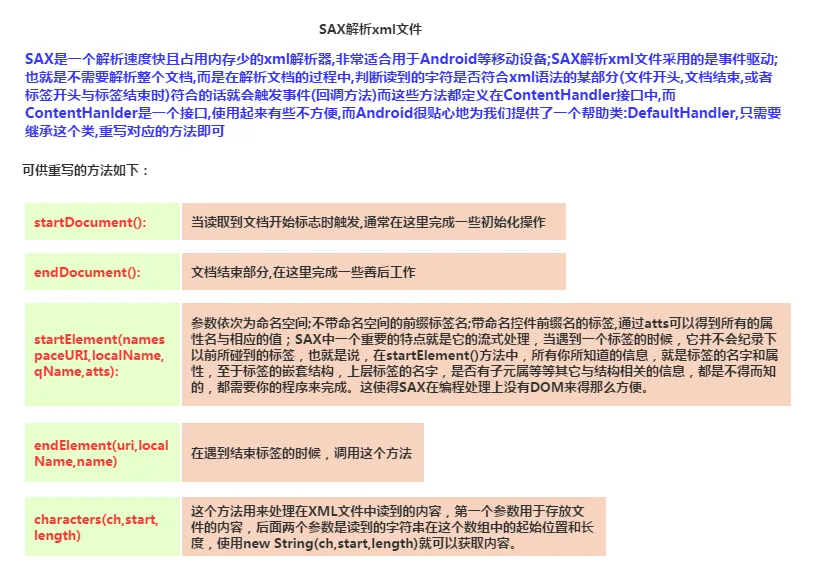
3. SAXによるXMLデータ解析
コアコード:
SAX解析クラス:SaxHelper.java:
/**
 * Created by Jay on 2015/9/8 0008.
 */
public class SaxHelper extends DefaultHandler {
    private Person person;
    private ArrayList<Person> persons;
    //当前解析的元素标签
    private String tagName = null;

    /**
     * 当读取到文档开始标志是触发,通常在这里完成一些初始化操作
     */
    @Override
    public void startDocument() throws SAXException {
        this.persons = new ArrayList<Person>();
        Log.i("SAX", "读取到文档头,开始解析xml");
    }


    /**
     * 读到一个开始标签时调用,第二个参数为标签名,最后一个参数为属性数组
     */
    @Override
    public void startElement(String uri, String localName, String qName,
                             Attributes attributes) throws SAXException {
        if (localName.equals("person")) {
            person = new Person();
            person.setId(Integer.parseInt(attributes.getValue("id")));
            Log.i("SAX", "开始处理person元素~");
        }
        this.tagName = localName;
    }


    /**
     * 读到到内容,第一个参数为字符串内容,后面依次为起始位置与长度
     */

    @Override
    public void characters(char[] ch, int start, int length)
            throws SAXException {
        //判断当前标签是否有效
        if (this.tagName != null) {
            String data = new String(ch, start, length);
            //读取标签中的内容
            if (this.tagName.equals("name")) {
                this.person.setName(data);
                Log.i("SAX", "处理name元素内容");
            } else if (this.tagName.equals("age")) {
                this.person.setAge(Integer.parseInt(data));
                Log.i("SAX", "处理age元素内容");
            }

        }

    }

    /**
     * 处理元素结束时触发,这里将对象添加到结合中
     */
    @Override
    public void endElement(String uri, String localName, String qName)
            throws SAXException {
        if (localName.equals("person")) {
            this.persons.add(person);
            person = null;
            Log.i("SAX", "处理person元素结束~");
        }
        this.tagName = null;
    }

    /**
     * 读取到文档结尾时触发,
     */
    @Override
    public void endDocument() throws SAXException {
        super.endDocument();
        Log.i("SAX", "读取到文档尾,xml解析结束");
    }

    //获取persons集合
    public ArrayList<Person> getPersons() {
        return persons;
    }

}
次にMainActivity.javaにそのようなメソッドを書いて、XMLを解析したいときに呼び出せばOKです。
private ArrayList<Person> readxmlForSAX() throws Exception {
    //获取文件资源建立输入流对象
    InputStream is = getAssets().open("person1.xml");
    //①创建XML解析处理器
    SaxHelper ss = new SaxHelper();
    //②得到SAX解析工厂
    SAXParserFactory factory = SAXParserFactory.newInstance();
    //③创建SAX解析器
    SAXParser parser = factory.newSAXParser();
    //④将xml解析处理器分配给解析器,对文档进行解析,将事件发送给处理器
    parser.parse(is, ss);
    is.close();
    return ss.getPersons();
}
補足の説明:
ああ、そうそう、皆さんに伝えるのを忘れていましたが、以下のようなperson1.xmlファイルを定義して、assetsディレクトリに置いています。ファイルの内容は次の通りです:person1.xml
<?xml version="1.0" encoding="UTF-8"?>
<persons>
    <person id = "11">
        <name>SAX解析</name>
        <age>18</age>
    </person>
    <person id = "13">
        <name>XML1</name>
        <age>43</age>
    </person>
</persons>
3つの解析方式を1つのデモにまとめているので、最後に全体の効果画像を載せます。ここでは、出力されたログを見せます。これでSAXでXMLを解析する流れがより明確になるでしょう:
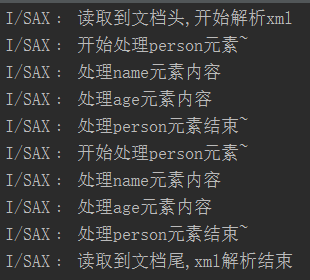
また、外側の空白テキストもテキストノードです!解析時にはこれらのノードも走査されます!
4. DOMによるXMLデータ解析
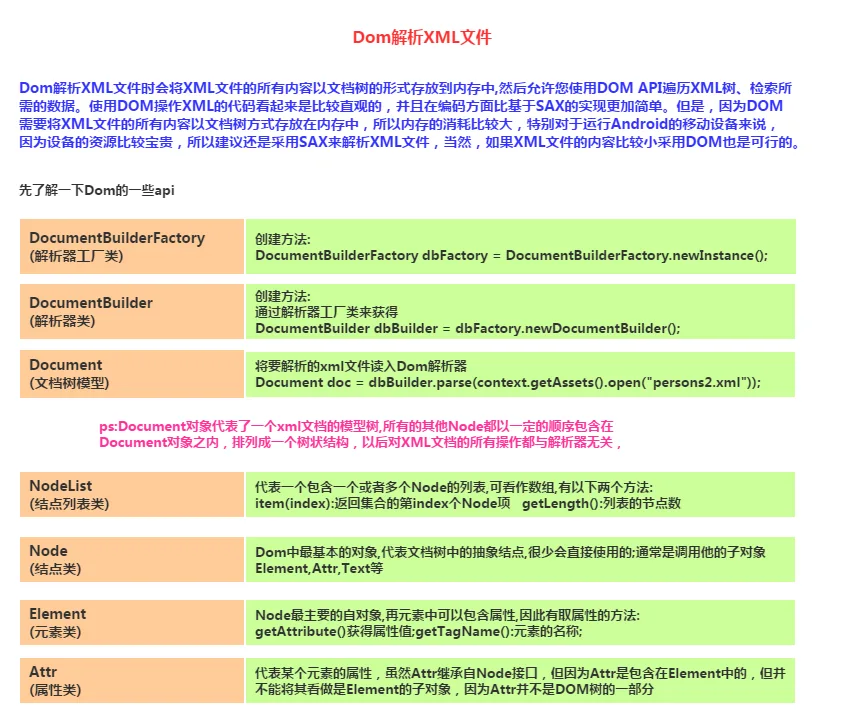
コアコード:
DomHelper.java
/**
 * Created by Jay on 2015/9/8 0008.
 */
public class DomHelper {
    public static ArrayList<Person> queryXML(Context context)
    {
        ArrayList<Person> Persons = new ArrayList<Person>();
        try {
            //①获得DOM解析器的工厂示例:
            DocumentBuilderFactory dbFactory = DocumentBuilderFactory.newInstance();
            //②从Dom工厂中获得dom解析器
            DocumentBuilder dbBuilder = dbFactory.newDocumentBuilder();
            //③把要解析的xml文件读入Dom解析器
            Document doc = dbBuilder.parse(context.getAssets().open("person2.xml"));
            System.out.println("处理该文档的DomImplemention对象=" + doc.getImplementation());
            //④得到文档中名称为person的元素的结点列表
            NodeList nList = doc.getElementsByTagName("person");
            //⑤遍历该集合,显示集合中的元素以及子元素的名字
            for(int i = 0;i < nList.getLength();i++)
            {
                //先从Person元素开始解析
                Element personElement = (Element) nList.item(i);
                Person p = new Person();
                p.setId(Integer.valueOf(personElement.getAttribute("id")));

                //获取person下的name和age的Note集合
                NodeList childNoList = personElement.getChildNodes();
                for(int j = 0;j < childNoList.getLength();j++)
                {
                    Node childNode = childNoList.item(j);
                    //判断子note类型是否为元素Note
                    if(childNode.getNodeType() == Node.ELEMENT_NODE)
                    {
                        Element childElement = (Element) childNode;
                        if("name".equals(childElement.getNodeName()))
                            p.setName(childElement.getFirstChild().getNodeValue());
                        else if("age".equals(childElement.getNodeName()))
                            p.setAge(Integer.valueOf(childElement.getFirstChild().getNodeValue()));
                    }
                }
                Persons.add(p);
            }
        } catch (Exception e) {e.printStackTrace();}
        return Persons;
    }
}
コード分析:
コードからDOMでXMLを解析する流れがわかります。まずファイル全体をDOMパーサーに読み込み、ツリーを形成します。そしてノードリストを走査して、必要なデータを取得できます。
5. PULLによるXMLデータ解析
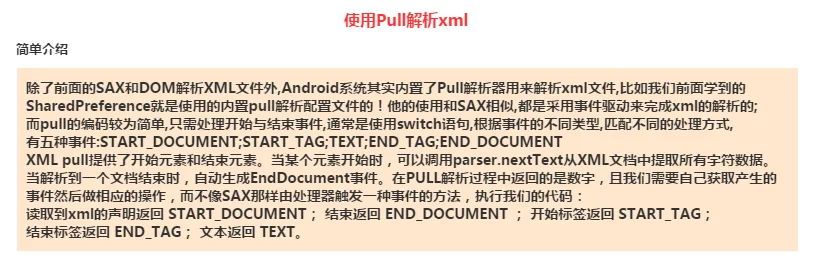
PULLを使ってXMLデータを解析する流れ:
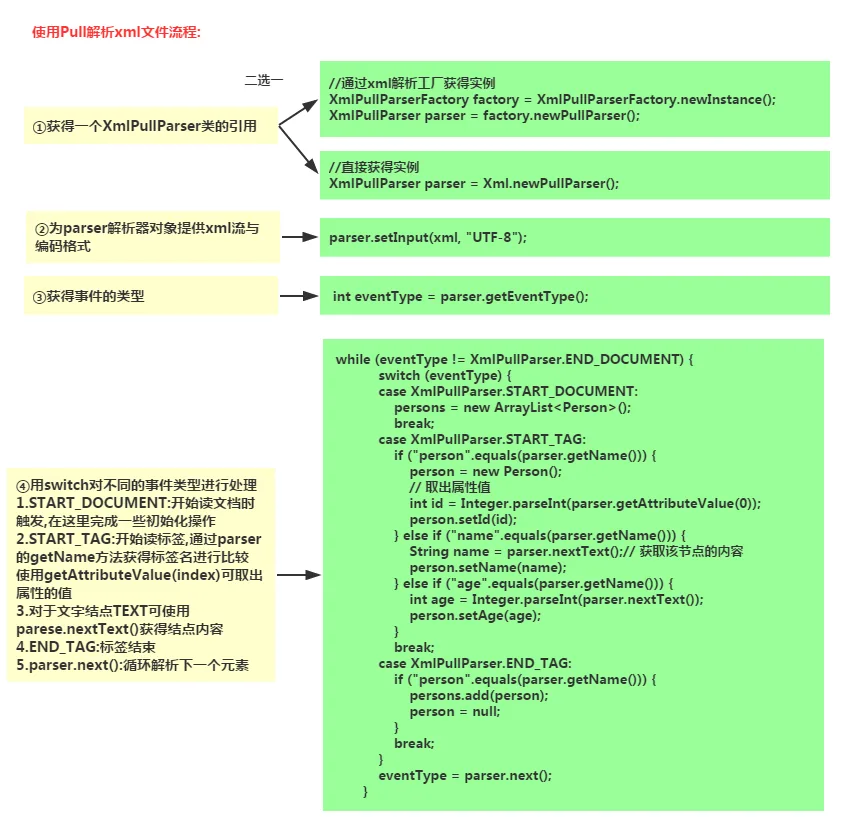
コアコード:
public static ArrayList<Person> getPersons(InputStream xml)throws Exception
{
    //XmlPullParserFactory pullPaser = XmlPullParserFactory.newInstance();
    ArrayList<Person> persons = null;
    Person person = null;
    // 创建一个xml解析的工厂
    XmlPullParserFactory factory = XmlPullParserFactory.newInstance();
    // 获得xml解析类的引用
    XmlPullParser parser = factory.newPullParser();
    parser.setInput(xml, "UTF-8");
    // 获得事件的类型
    int eventType = parser.getEventType();
    while (eventType != XmlPullParser.END_DOCUMENT) {
        switch (eventType) {
        case XmlPullParser.START_DOCUMENT:
            persons = new ArrayList<Person>();
            break;
        case XmlPullParser.START_TAG:
            if ("person".equals(parser.getName())) {
                person = new Person();
                // 取出属性值
                int id = Integer.parseInt(parser.getAttributeValue(0));
                person.setId(id);
            } else if ("name".equals(parser.getName())) {
                String name = parser.nextText();// 获取该节点的内容
                person.setName(name);
            } else if ("age".equals(parser.getName())) {
                int age = Integer.parseInt(parser.nextText());
                person.setAge(age);
            }
            break;
        case XmlPullParser.END_TAG:
            if ("person".equals(parser.getName())) {
                persons.add(person);
                person = null;
            }
            break;
        }
        eventType = parser.next();
    }
    return persons;
}
Pullを使ってXMLデータを生成する流れ:
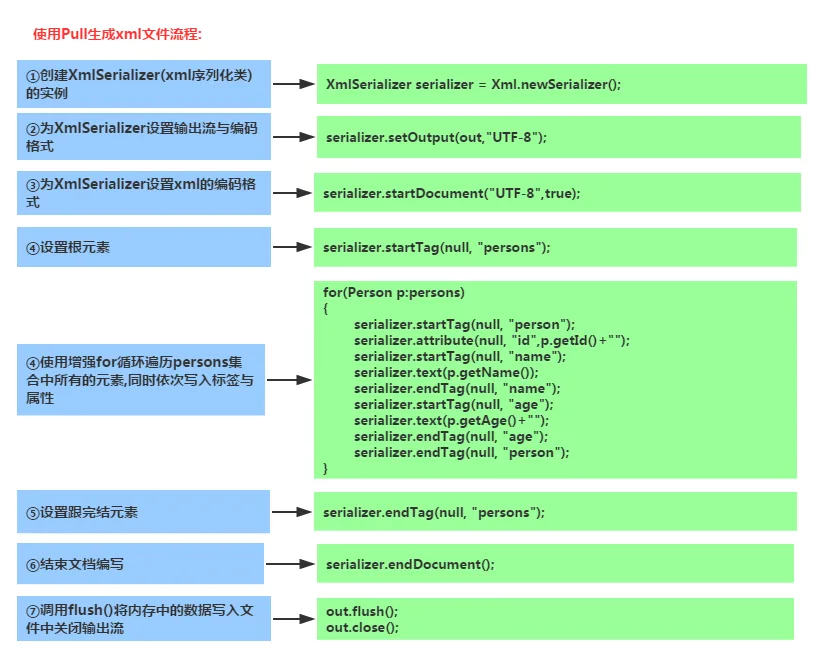
コアコード:
public static void save(List<Person> persons, OutputStream out) throws Exception {
    XmlSerializer serializer = Xml.newSerializer();
    serializer.setOutput(out, "UTF-8");
    serializer.startDocument("UTF-8", true);
    serializer.startTag(null, "persons");
    for (Person p : persons) {
        serializer.startTag(null, "person");
        serializer.attribute(null, "id", p.getId() + "");
        serializer.startTag(null, "name");
        serializer.text(p.getName());
        serializer.endTag(null, "name");
        serializer.startTag(null, "age");
        serializer.text(p.getAge() + "");
        serializer.endTag(null, "age");
        serializer.endTag(null, "person");
    }

    serializer.endTag(null, "persons");
    serializer.endDocument();
    out.flush();
    out.close();
}
6. コード例のダウンロード:
実行結果のスクリーンショット:
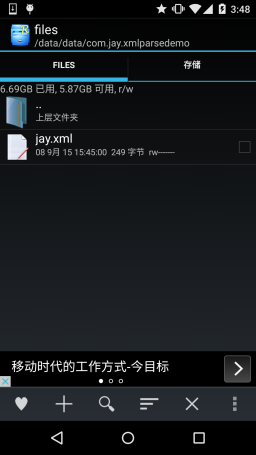
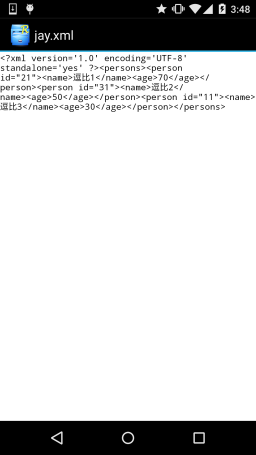
コードのダウンロード: XMLParseDemo.zip:XMLParseDemo.zip をダウンロード
本節のまとめ:
本節では、Androidでよく使われる3つのXML解析方式、DOM、SAX、PULLを紹介しました。モバイル端末では、後の2つ(SAXとPULL)を使うことをお勧めします。特にPULLはより簡単に使えます。ここでは詳しく説明しませんが、コードこそが最良の教師です。本節はここまでです。次節では、Androidが提供しているJSON解析方式を学びます。ありがとうございました。