Abschnittseinführung:
In den beiden vorherigen Abschnitten haben wir die in Android integrierten HTTP-Anfragemethoden behandelt: HttpURLConnection und HttpClient. Ursprünglich dachten wir, OkHttp sei bereits integriert, und wollten dann die grundlegende Verwendung von OkHttp erklären. Später stellten wir fest, dass es immer noch das Importieren einer Drittanbieterbibliothek erfordert, also verschieben wir es in den fortgeschrittenen Abschnitt. In diesem Abschnitt lernen wir drei von Android für uns bereitgestellte XML-Parsing-Lösungen kennen! Sie sind: SAX, DOM und PULL. Im Folgenden wollen wir sie kennenlernen!
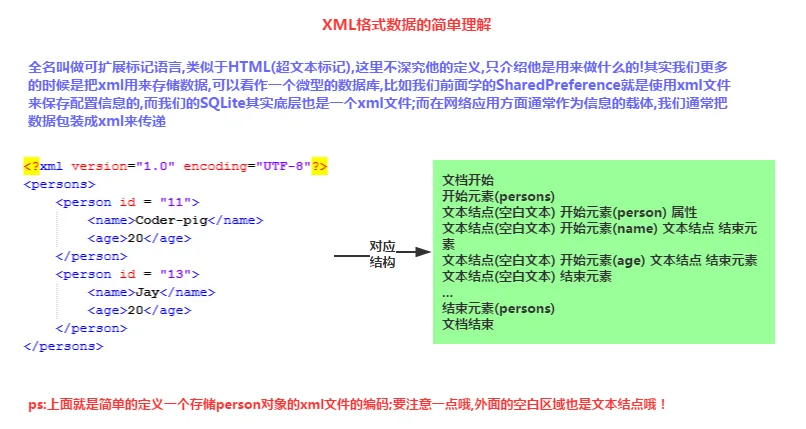
1. Kernpunkte von XML-Daten
Schauen wir uns zunächst einige Anforderungen und Konzepte von XML-Daten an:
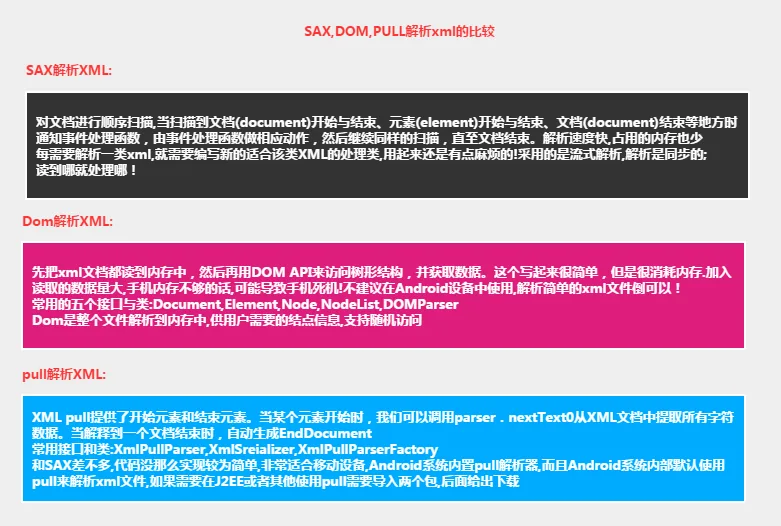
2. Vergleich dreier XML-Parsing-Methoden
3. SAX-Parsing von XML-Daten
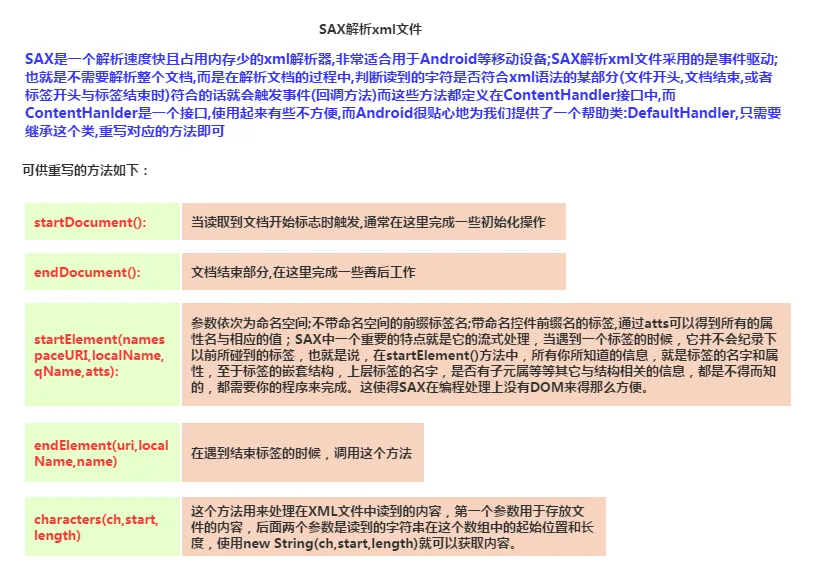
Kerncode:
SAX-Parsing-Klasse:SaxHelper.java:
/**
 * Created by Jay on 2015/9/8 0008.
 */
public class SaxHelper extends DefaultHandler {
    private Person person;
    private ArrayList<Person> persons;
    //当前解析的元素标签
    private String tagName = null;

    /**
     * 当读取到文档开始标志是触发,通常在这里完成一些初始化操作
     */
    @Override
    public void startDocument() throws SAXException {
        this.persons = new ArrayList<Person>();
        Log.i("SAX", "读取到文档头,开始解析xml");
    }


    /**
     * 读到一个开始标签时调用,第二个参数为标签名,最后一个参数为属性数组
     */
    @Override
    public void startElement(String uri, String localName, String qName,
                             Attributes attributes) throws SAXException {
        if (localName.equals("person")) {
            person = new Person();
            person.setId(Integer.parseInt(attributes.getValue("id")));
            Log.i("SAX", "开始处理person元素~");
        }
        this.tagName = localName;
    }


    /**
     * 读到到内容,第一个参数为字符串内容,后面依次为起始位置与长度
     */

    @Override
    public void characters(char[] ch, int start, int length)
            throws SAXException {
        //判断当前标签是否有效
        if (this.tagName != null) {
            String data = new String(ch, start, length);
            //读取标签中的内容
            if (this.tagName.equals("name")) {
                this.person.setName(data);
                Log.i("SAX", "处理name元素内容");
            } else if (this.tagName.equals("age")) {
                this.person.setAge(Integer.parseInt(data));
                Log.i("SAX", "处理age元素内容");
            }

        }

    }

    /**
     * 处理元素结束时触发,这里将对象添加到结合中
     */
    @Override
    public void endElement(String uri, String localName, String qName)
            throws SAXException {
        if (localName.equals("person")) {
            this.persons.add(person);
            person = null;
            Log.i("SAX", "处理person元素结束~");
        }
        this.tagName = null;
    }

    /**
     * 读取到文档结尾时触发,
     */
    @Override
    public void endDocument() throws SAXException {
        super.endDocument();
        Log.i("SAX", "读取到文档尾,xml解析结束");
    }

    //获取persons集合
    public ArrayList<Person> getPersons() {
        return persons;
    }

}
Dann schreiben wir in MainActivity.java eine solche Methode und rufen sie einfach auf, wenn wir XML parsen müssen.
private ArrayList<Person> readxmlForSAX() throws Exception {
    //获取文件资源建立输入流对象
    InputStream is = getAssets().open("person1.xml");
    //①创建XML解析处理器
    SaxHelper ss = new SaxHelper();
    //②得到SAX解析工厂
    SAXParserFactory factory = SAXParserFactory.newInstance();
    //③创建SAX解析器
    SAXParser parser = factory.newSAXParser();
    //④将xml解析处理器分配给解析器,对文档进行解析,将事件发送给处理器
    parser.parse(is, ss);
    is.close();
    return ss.getPersons();
}
Einige zusätzliche Hinweise:
Nun, übrigens, ich habe vergessen, dir zu sagen, dass wir eine person1.xml-Datei wie unten definiert und sie im assets-Verzeichnis abgelegt haben! Der Dateiinhalt ist wie folgt:person1.xml
<?xml version="1.0" encoding="UTF-8"?>
<persons>
    <person id = "11">
        <name>SAX解析</name>
        <age>18</age>
    </person>
    <person id = "13">
        <name>XML1</name>
        <age>43</age>
    </person>
</persons>
Wir haben alle drei Parsing-Methoden in einer Demo zusammengefasst, daher werden wir die Screenshots des Gesamteffekts am Ende posten. Hier wollen wir die ausgegebenen Logs posten; ich glaube, jeder wird ein klareres Verständnis des SAX-XML-Parsing-Prozesses bekommen:
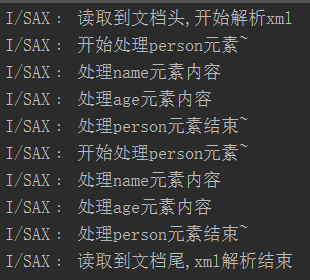
Darüber hinaus ist der Leerraumtext außerhalb ebenfalls ein Textknoten! Während des Parsens werden diese Knoten ebenfalls durchlaufen!
4. DOM-Parsing von XML-Daten
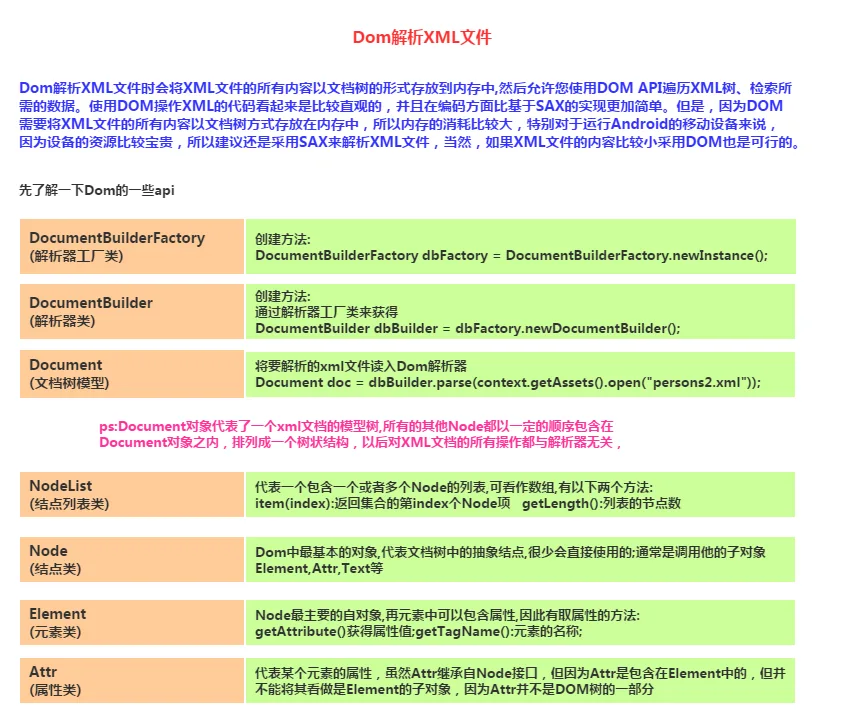
Kerncode:
DomHelper.java
/**
 * Created by Jay on 2015/9/8 0008.
 */
public class DomHelper {
    public static ArrayList<Person> queryXML(Context context)
    {
        ArrayList<Person> Persons = new ArrayList<Person>();
        try {
            //①获得DOM解析器的工厂示例:
            DocumentBuilderFactory dbFactory = DocumentBuilderFactory.newInstance();
            //②从Dom工厂中获得dom解析器
            DocumentBuilder dbBuilder = dbFactory.newDocumentBuilder();
            //③把要解析的xml文件读入Dom解析器
            Document doc = dbBuilder.parse(context.getAssets().open("person2.xml"));
            System.out.println("处理该文档的DomImplemention对象=" + doc.getImplementation());
            //④得到文档中名称为person的元素的结点列表
            NodeList nList = doc.getElementsByTagName("person");
            //⑤遍历该集合,显示集合中的元素以及子元素的名字
            for(int i = 0;i < nList.getLength();i++)
            {
                //先从Person元素开始解析
                Element personElement = (Element) nList.item(i);
                Person p = new Person();
                p.setId(Integer.valueOf(personElement.getAttribute("id")));

                //获取person下的name和age的Note集合
                NodeList childNoList = personElement.getChildNodes();
                for(int j = 0;j < childNoList.getLength();j++)
                {
                    Node childNode = childNoList.item(j);
                    //判断子note类型是否为元素Note
                    if(childNode.getNodeType() == Node.ELEMENT_NODE)
                    {
                        Element childElement = (Element) childNode;
                        if("name".equals(childElement.getNodeName()))
                            p.setName(childElement.getFirstChild().getNodeValue());
                        else if("age".equals(childElement.getNodeName()))
                            p.setAge(Integer.valueOf(childElement.getFirstChild().getNodeValue()));
                    }
                }
                Persons.add(p);
            }
        } catch (Exception e) {e.printStackTrace();}
        return Persons;
    }
}
Codeanalyse:
Aus dem Code können wir den Prozess des DOM-Parsings von XML erkennen: Zuerst wird die gesamte Datei in den DOM-Parser eingelesen, dann wird ein Baum gebildet, und anschließend können wir die Knotenliste durchlaufen, um die benötigten Daten zu erhalten!
5. PULL-Parsing von XML-Daten
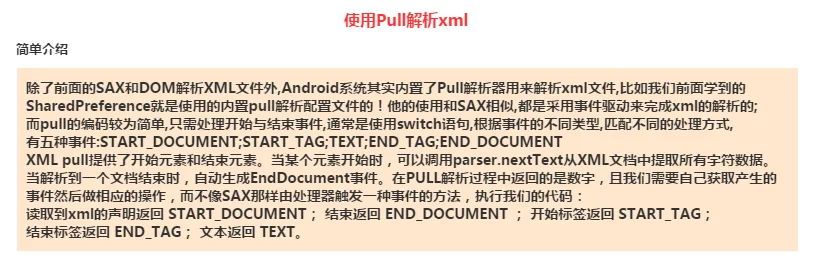
Der Prozess der Verwendung von PULL zum Parsen von XML-Daten:
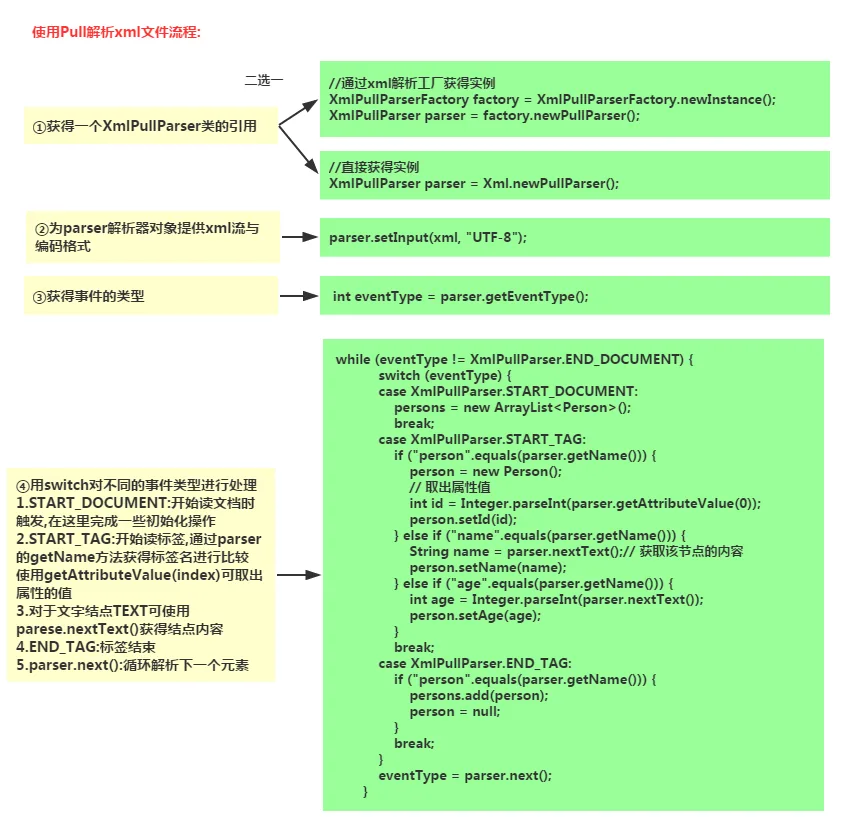
Kerncode:
public static ArrayList<Person> getPersons(InputStream xml)throws Exception
{
    //XmlPullParserFactory pullPaser = XmlPullParserFactory.newInstance();
    ArrayList<Person> persons = null;
    Person person = null;
    // 创建一个xml解析的工厂
    XmlPullParserFactory factory = XmlPullParserFactory.newInstance();
    // 获得xml解析类的引用
    XmlPullParser parser = factory.newPullParser();
    parser.setInput(xml, "UTF-8");
    // 获得事件的类型
    int eventType = parser.getEventType();
    while (eventType != XmlPullParser.END_DOCUMENT) {
        switch (eventType) {
        case XmlPullParser.START_DOCUMENT:
            persons = new ArrayList<Person>();
            break;
        case XmlPullParser.START_TAG:
            if ("person".equals(parser.getName())) {
                person = new Person();
                // 取出属性值
                int id = Integer.parseInt(parser.getAttributeValue(0));
                person.setId(id);
            } else if ("name".equals(parser.getName())) {
                String name = parser.nextText();// 获取该节点的内容
                person.setName(name);
            } else if ("age".equals(parser.getName())) {
                int age = Integer.parseInt(parser.nextText());
                person.setAge(age);
            }
            break;
        case XmlPullParser.END_TAG:
            if ("person".equals(parser.getName())) {
                persons.add(person);
                person = null;
            }
            break;
        }
        eventType = parser.next();
    }
    return persons;
}
Der Prozess der Verwendung von Pull zum Generieren von XML-Daten:
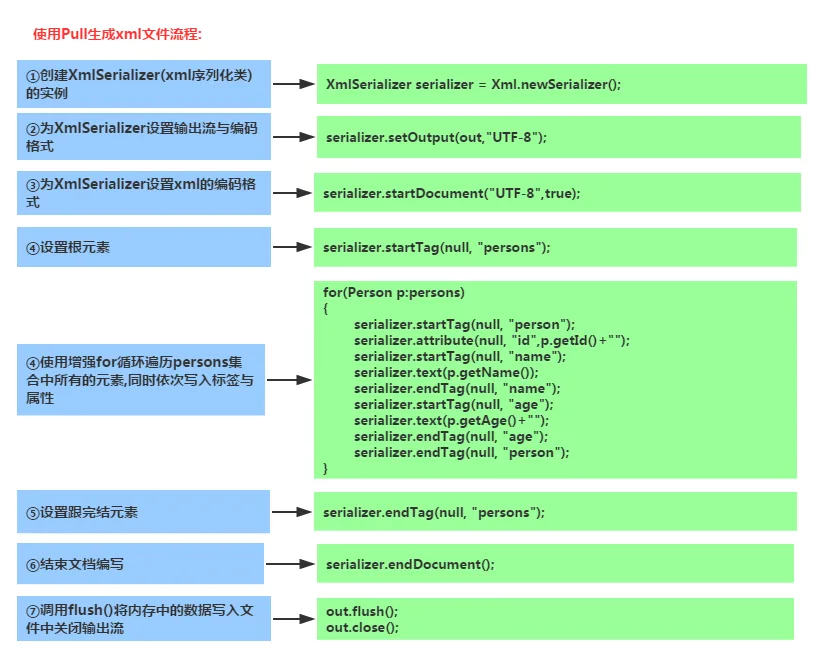
Kerncode:
public static void save(List<Person> persons, OutputStream out) throws Exception {
    XmlSerializer serializer = Xml.newSerializer();
    serializer.setOutput(out, "UTF-8");
    serializer.startDocument("UTF-8", true);
    serializer.startTag(null, "persons");
    for (Person p : persons) {
        serializer.startTag(null, "person");
        serializer.attribute(null, "id", p.getId() + "");
        serializer.startTag(null, "name");
        serializer.text(p.getName());
        serializer.endTag(null, "name");
        serializer.startTag(null, "age");
        serializer.text(p.getAge() + "");
        serializer.endTag(null, "age");
        serializer.endTag(null, "person");
    }

    serializer.endTag(null, "persons");
    serializer.endDocument();
    out.flush();
    out.close();
}
6. Codebeispiel-Download:
Screenshot des Ausführungsergebnisses:
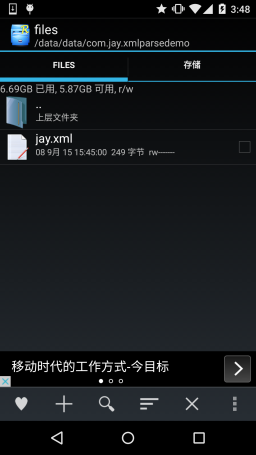
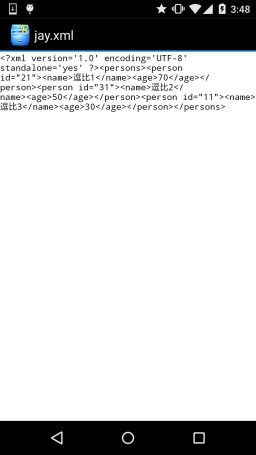
Code-Download: XMLParseDemo.zip:XMLParseDemo.zip herunterladen
Zusammenfassung des Abschnitts:
Dieser Abschnitt stellt drei häufig verwendete XML-Parsing-Methoden in Android vor: DOM, SAX und PULL. Für mobile Geräte empfehlen wir die letzten beiden, wobei PULL einfacher zu verwenden ist. Hier gibt es nicht viel mehr zu sagen; Code ist der beste Lehrer. Das war alles für diesen Abschnitt. Im nächsten Abschnitt lernen wir die einfache JSON-Parsing-Methode kennen, die Android bereitstellt. Danke!