Einführung in diesen Abschnitt:
Ehe wir uns versahen, sind wir endlich beim Kapitel Android-Netzwerkprogrammierung angekommen. Alles, womit wir uns vorher beschäftigt haben, war eigenständig, also war es sicher nicht befriedigend, oder? Ab diesem Abschnitt lernen wir einige Dinge im Zusammenhang mit Android-Netzwerkprogrammierung: Was macht die Netzwerkprogrammierung auf Android-Seite? Das HTTP-Protokoll lernen, die integrierte JSON-Parsing-Klasse verwenden, um JSON zu parsen, mehrere gängige XML-Parsing-Methoden, die Verwendung von HttpUrlConnection und HttpClient, Datei-Upload und -Download; die Verwendung von WebService, WebView, Socket-Kommunikation und so weiter!
Außerdem sind wir der Client; serverseitige Inhalte liegen nicht in unserem Zuständigkeitsbereich, und Little Pig ist darin auch nicht gut. Unsere Mindestanforderung ist:Die Fähigkeit zu beherrschen, die vom Server zurückgegebenen Daten abzurufen und zu parsen!Genug geredet, beginnen wir mit dem Inhalt dieses Abschnitts!
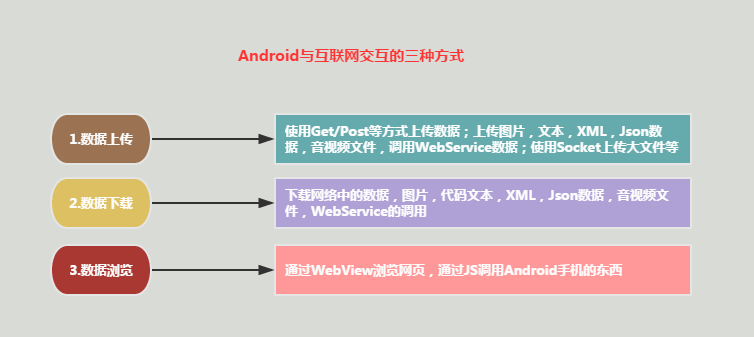
1. Drei Arten, wie Android mit dem Internet interagiert
2. Erstes Kennenlernen des HTTP-Protokolls
In der tatsächlichen Entwicklung verwenden wir beim Umgang mit dem Server im Allgemeinen eine Kommunikation auf Basis des HTTP-Protokolls, daher ist es sehr wichtig, das HTTP-Protokoll gut zu lernen. Natürlich müssen wir nicht zu sehr auf Details achten; ein allgemeines Verständnis reicht aus! Das sind alles konzeptionelle Dinge!
1) Was ist das HTTP-Protokoll?
Antwort: HTTP (Hypertext Transfer Protocol), ein Protokoll der Anwendungsschicht des TCP/IP-Protokolls, wird verwendet, um den Prozess des Datenaustauschs zwischen einem Webbrowser und einem Webserver zu definieren. Nachdem ein Client eine Verbindung zu einem Webserver hergestellt hat, muss er, wenn er eine Webressource auf dem Webserver abrufen möchte, bestimmte Kommunikationsformate einhalten. Das HTTP-Protokoll wird verwendet, um das Kommunikationsformat zwischen dem Client und dem Webserver zu definieren.
2) Unterschiede zwischen HTTP 1.0 und HTTP 1.1
Antwort: Im 1.0-Protokoll kann der Client nach dem Aufbau einer Verbindung mit dem Webserver nur eine Webressource abrufen! Im 1.1-Protokoll darf der Client nach dem Aufbau einer Verbindung mit dem Webserver mehrere Webressourcen über eine Verbindung abrufen!
3) Zugrunde liegender Arbeitsprozess des HTTP-Protokolls:
Antwort: Zuerst müssen wir zwei Begriffe kennen:
- SYNSYN (synchron): das Handshake-Signal, das beim Aufbau einer TCP/IP-Verbindung verwendet wird
- ACKACK (Acknowledgement): Bestätigungszeichen, das bestätigt, dass die gesendeten Daten korrekt empfangen wurden
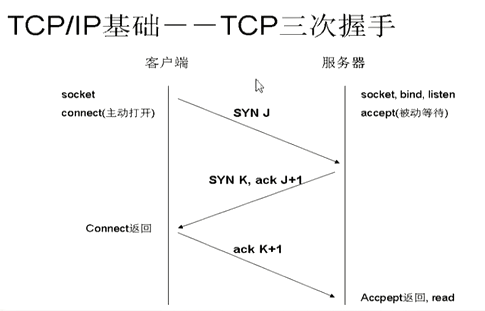
Dann kommtdas TCP/IP-Drei-Wege-HandshakeKonzept:
- Der Client sendet ein SYN-Paket (syn = j) an den Server, wechselt in den Zustand SYN_SEND und wartet dann auf die Bestätigung des Servers.
- Der Server empfängt das SYN-Paket, bestätigt das SYN des Clients (ack = j + 1) und sendet gleichzeitig auch ein SYN-Paket (syn = k), d. h. ein SYN + ACK-Paket. Der Server wechselt in den Zustand SYN_RECV.
- Der Client empfängt das SYN + ACK-Paket und sendet ein Bestätigungspaket ACK (ack = k + 1) an den Server. Nach dem Senden wechseln der Client und der Server in den Zustand ESTABLISHED, schließen den Drei-Wege-Handshake ab und beginnen dann mit der Datenübertragung.
Wenn es noch nicht klar ist, schauen wir uns das schematische Diagramm des Drei-Wege-Handshakes an:
Du verstehst es jetzt, oder? Dann sehen wir uns einen Ablauf von HTTP-Operationen an:
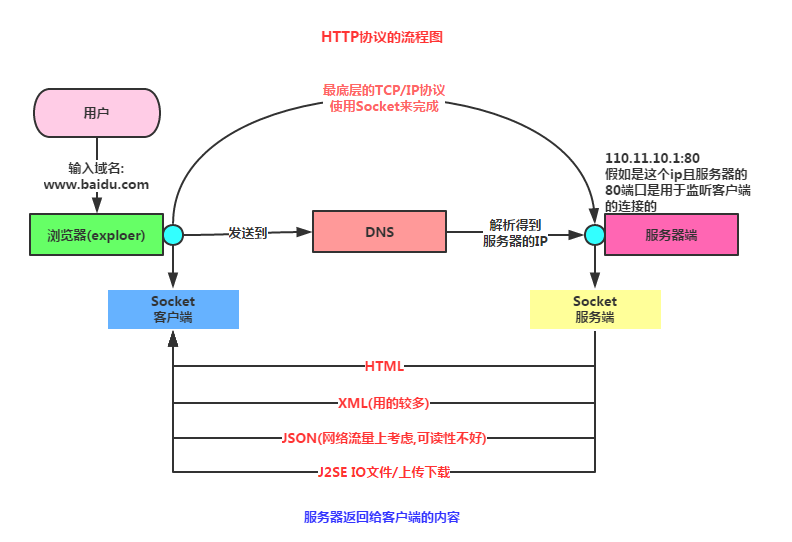
- Der Benutzer klickt im Browser auf eine URL (Hyperlink), und der Webbrowser baut eine Verbindung mit dem Webserver auf.
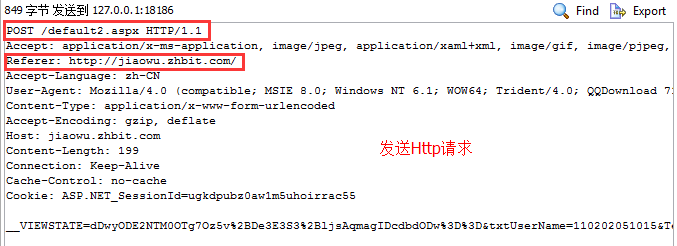
- Nachdem die Verbindung hergestellt wurde, sendet der Client eine Anfrage an den Server. Das Anfrageformat ist: Uniform Resource Identifier (URL) + Protokollversionsnummer (normalerweise 1.1) + MIME-Informationen (mehrere Nachrichtenheader) + eine Leerzeile
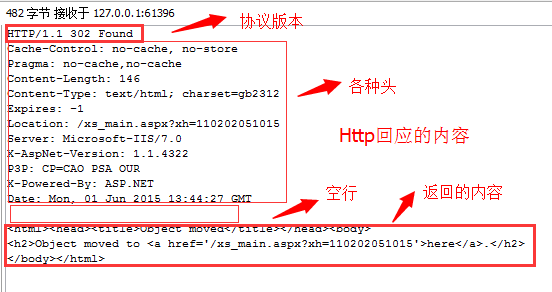
- Nachdem der Server die Anfrage empfangen hat, liefert er entsprechende Rückgabeinformationen. Das Rückgabeformat ist: Protokollversionsnummer + Statuszeile (Verarbeitungsergebnis) + mehrere Informationsheader + Leerzeile + Entitätsinhalt (z. B. das zurückgegebene HTML)
- Der Client empfängt die Rückgabeinformationen vom Server, zeigt sie über den Browser an und trennt dann die Verbindung zum Server. Wenn in einem Zwischenschritt ein Fehler auftritt, werden die Fehlerinformationen natürlich an den Client zurückgegeben und angezeigt, wie der klassische 404-Fehler!
Wenn der obige Ablauf noch nicht klar ist, können wir HttpWatch oder Firefox verwenden, um Pakete aufzuzeichnen. PS: Die Testseite ist das Verwaltungssystem für akademische Angelegenheiten der Schule von Little Pig. Nach Eingabe von Konto und Passwort und Anforderung der Anmeldung können wir die folgenden Informationen sehen:
In einer HTTP-Anfrage enthaltene Inhalte:
In einer HTTP-Antwort enthaltene Inhalte:
Jetzt ist es auf einen Blick klar, oder!
4) Geschäftsprozess des HTTP-Protokolls
5) Mehrere Anfragemethoden von HTTP
In der tatsächlichen Entwicklung verwenden wir GET und POST häufiger, aber in der tatsächlichen Entwicklung verwenden wir möglicherweise auch andere Anfragemethoden wie PUT. Little Pig hat es in tatsächlichen Projekten verwendet. Nachfolgend listen wir zur allgemeinen Bequemlichkeit alle Anfragemethoden auf:
- GetAnfrage zum Abrufen der durch Request-URI identifizierten Ressource
- POSTNeue Daten nach der durch Request-URI identifizierten Ressource anhängen
- HEADAnfrage zum Abrufen des Headers der Antwortnachricht für die durch die Request-URI identifizierte Ressource
- PUTFordert den Server auf, eine Ressource zu speichern und die Request-URI als deren Bezeichner zu verwenden
- DELETEFordert den Server auf, die durch die Request-URI identifizierte Ressource zu löschen
- TRACEFordert den Server auf, die empfangenen Anfrageinformationen zurückzuspiegeln; wird hauptsächlich für Tests oder Diagnose verwendet
- CONNECTFür zukünftige Verwendung reserviert
- OPTIONSAnfrage zur Abfrage der Serverleistung oder von Optionen, die sich auf die Ressource beziehen
6) Vergleich von GET und POST
Die beiden am häufigsten verwendeten, natürlich müssen wir sie vergleichen!
- GETGET: Die an den Server zu übermittelnden Daten werden in Form von `?` an die Anfrage-URL-Adresse angehängt, wobei mehrere Datenelemente durch `&` getrennt werden, aber die Datenkapazität üblicherweise 2K nicht überschreiten darf, zum Beispiel: `http://xxx?username=…&pawd=…` dies ist GET.
- POSTPOST: Dieser kann Daten im Entity-Inhalt der Anfrage an den Server senden, und es gibt keine Begrenzung der Übertragungsmenge.
- Noch etwas am Rande: Diese beiden dienen beide dem Senden von Daten, aber die Sendemechanismen sind unterschiedlich. Glauben Sie nicht, was online gesagt wird: 'GET ruft Serverdaten ab, POST sendet Daten an den Server'!! Außerdem ist die Sicherheit von GET sehr gering, die Sicherheit von POST relativ hoch, aber die Ausführungseffizienz ist besser als bei der POST-Methode. Im Allgemeinen verwenden wir GET für Abfragen und POST zum Hinzufügen, Löschen und Ändern von Daten!!
7) Sammlung von HTTP-Statuscodes
Natürlich dienen diese Statuscodes nur als Referenz; tatsächlichliegt die Entscheidung bei der Serverseite (Backend).Eine Lösung ist: Nach einer Anfrage gibt uns der Server einen Status zurück; oder eine andere, die am besten geeignet ist, wenn die App keine mehrsprachigen Versionen benötigt, besteht darin, uns direkt einen JSON-String mit Ergebnisinformationen zurückzugeben, und wir zeigen ihn einfach an. Das kann viel Arbeit sparen! Unten steht die Liste der Statuscodes, nur als Referenz:
- 100~199: Die Anfrage wurde erfolgreich angenommen; der Client muss die nächste Anfrage senden, um den gesamten Verarbeitungsprozess abzuschließen.
- 200: OK, die Client-Anfrage war erfolgreich.
- 300~399: Die angeforderte Ressource wurde an eine neue Adresse verschoben (302, 307, 304).
- 401: Nicht autorisierte Anfrage; dieser Statuscode muss zusammen mit dem Header-Feld WWW-Authenticate verwendet werden.
- 403: Verboten. Der Server hat die Anfrage erhalten, weigert sich jedoch, den Dienst bereitzustellen.
- 404: Nicht gefunden. Die angeforderte Ressource existiert nicht. Dazu muss man nicht mehr sagen.
- 500: Interner Serverfehler. Auf dem Server ist ein unerwarteter Fehler aufgetreten.
- 503: Server nicht verfügbar. Der Server kann die Client-Anfrage derzeit nicht verarbeiten; nach einer gewissen Zeit kann er wieder normal funktionieren.
8) Eigenschaften des HTTP-Protokolls
Das sind konzeptionelle Dinge; man muss sie nur kennen, nicht auswendig lernen. Das stammt aus Baidu Baike und wurde direkt kopiert und eingefügt:
1. Unterstützt den Client/Server-Modus.。
2. Einfach und schnell.Wenn ein Client einen Dienst von einem Server anfordert, muss er nur die Anforderungsmethode und den Pfad übertragen. Übliche Anforderungsmethoden sind GET, HEAD, POST. Jede Methode gibt eine andere Art der Kontaktaufnahme zwischen Client und Server an. Da das HTTP-Protokoll einfach ist, ist die Programmgröße eines HTTP-Servers klein, daher ist die Kommunikationsgeschwindigkeit hoch.
3. Flexibel.HTTP erlaubt die Übertragung beliebiger Arten von Datenobjekten. Der übertragene Typ wird durch Content-Type gekennzeichnet.
4. Verbindungslos.Verbindungslos bedeutet, jede Verbindung auf die Verarbeitung nur einer Anfrage zu beschränken. Nachdem der Server die Anfrage des Clients verarbeitet und die Antwort des Clients empfangen hat, trennt er die Verbindung. Diese Methode kann Übertragungszeit sparen.
5. Zustandslos.:Das HTTP-Protokoll ist ein zustandsloses Protokoll. Zustandslos bedeutet, dass das Protokoll keine Speicherfähigkeit für die Transaktionsverarbeitung hat. Das Fehlen von Zustand bedeutet, dass, wenn die nachfolgende Verarbeitung vorherige Informationen benötigt, diese erneut übertragen werden müssen, was dazu führen kann, dass die pro Verbindung übertragene Datenmenge zunimmt. Andererseits ist die Antwort des Servers schneller, wenn er vorherige Informationen nicht benötigt.
PS: Bezüglich des OSI-Sieben-Schichten-Protokolls und des TCP-Vier-Schichten-Modells werden sie in der Grundlagenreihe nicht erklärt~ Wenn Sie interessiert sind, können Sie sich selbst darüber informieren!
Zusammenfassung dieses Abschnitts:
In diesem Abschnitt wurden die Tools erläutert, die wir in der netzwerkbezogenen Android-Entwicklung benötigen, sowie die zugehörigen Konzepte des HTTP-Protokolls. Ich glaube, jeder hat jetzt einen vagen Eindruck von der Interaktion zwischen mobilen Android-Clients und Servern. Im nächsten Abschnitt werden wir die Anfrage-Header und Antwort-Header des HTTP-Protokolls untersuchen! Dieser Abschnitt endet hier, danke~