Introduction à cette section :
Sans nous en rendre compte, nous sommes enfin arrivés au chapitre de la programmation réseau Android. Tout ce avec quoi nous avons joué avant était autonome, donc ça ne devait pas être satisfaisant, n'est-ce pas ? À partir de cette section, nous allons apprendre certaines choses liées à la programmation réseau Android : Que fait la programmation réseau côté Android ? Apprendre le protocole HTTP, utiliser la classe d'analyse JSON intégrée pour analyser du JSON, plusieurs méthodes courantes d'analyse XML, l'utilisation de HttpUrlConnection et HttpClient, le téléversement et le téléchargement de fichiers ; l'utilisation de WebService, WebView, la communication Socket, et ainsi de suite !
De plus, nous sommes le client ; le contenu côté serveur n'est pas dans notre périmètre, et Little Pig n'y est pas bon non plus. Notre exigence minimale est :Être capable de maîtriser la capacité d'obtenir et d'analyser les données renvoyées par le serveur !Bon, assez parlé, commençons le contenu de cette section !
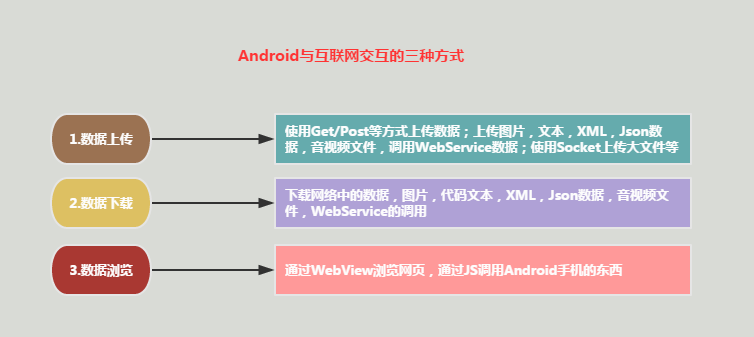
1. Trois façons pour Android d'interagir avec Internet
2. Première compréhension du protocole HTTP
Dans le développement réel, lorsque nous traitons avec le serveur, nous utilisons généralement une communication basée sur le protocole HTTP, il est donc très important de bien apprendre le protocole HTTP. Bien sûr, nous n'avons pas besoin d'être trop pointilleux sur les détails ; une compréhension générale suffit ! Ce sont toutes des choses conceptuelles !
1) Qu'est-ce que le protocole HTTP ?
Réponse : HTTP (Hypertext Transfer Protocol), un protocole de couche application du protocole TCP/IP, utilisé pour définir le processus d'échange de données entre un navigateur web et un serveur web. Après qu'un client se connecte à un serveur web, s'il veut obtenir une ressource web sur le serveur web, il doit suivre certains formats de communication. Le protocole HTTP est utilisé pour définir le format de communication entre le client et le serveur web.
2) Différences entre HTTP 1.0 et HTTP 1.1
Réponse : dans le protocole 1.0, après que le client a établi une connexion avec le serveur web, il ne peut obtenir qu'une seule ressource web ! Dans le protocole 1.1, après que le client a établi une connexion avec le serveur web, il est autorisé à obtenir plusieurs ressources web sur une même connexion !
3) Processus de fonctionnement sous-jacent du protocole HTTP :
Réponse : Tout d'abord, nous devons connaître deux termes :
- SYNSYN (synchrone) : le signal de poignée de main utilisé lors de l'établissement d'une connexion TCP/IP
- ACKACK (accusé de réception) : caractère de confirmation, confirmant que les données envoyées ont été correctement reçues
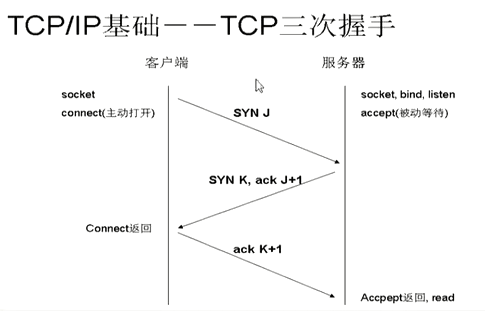
Vient ensuitele concept de poignée de main en trois étapes TCP/IP:
- Le client envoie un paquet SYN (syn = j) au serveur, entre dans l'état SYN_SEND, puis attend la confirmation du serveur.
- Le serveur reçoit le paquet SYN, accuse réception du SYN du client (ack = j + 1) et envoie en même temps un paquet SYN (syn = k), c'est-à-dire un paquet SYN + ACK. Le serveur entre dans l'état SYN_RECV.
- Le client reçoit le paquet SYN + ACK et envoie un paquet de confirmation ACK (ack = k + 1) au serveur. Après l'envoi, le client et le serveur entrent dans l'état ESTABLISHED, terminant la poignée de main en trois étapes, puis les deux commencent à transmettre des données.
Si ce n'est toujours pas clair, regardons le schéma de la poignée de main en trois étapes :
Vous comprenez maintenant, n'est-ce pas ? Alors regardons un déroulement des opérations HTTP :
- L'utilisateur clique sur une URL (hyperlien) dans le navigateur, et le navigateur web établit une connexion avec le serveur web.
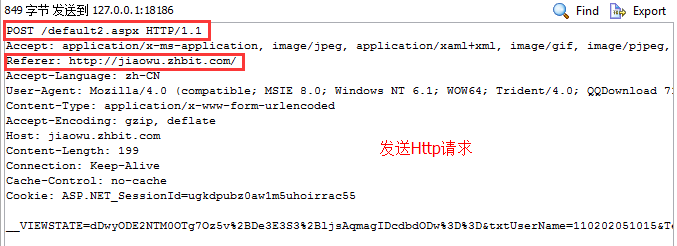
- Après l'établissement de la connexion, le client envoie une requête au serveur. Le format de la requête est : Uniform Resource Identifier (URL) + numéro de version du protocole (généralement 1.1) + informations MIME (plusieurs en-têtes de message) + une ligne vide
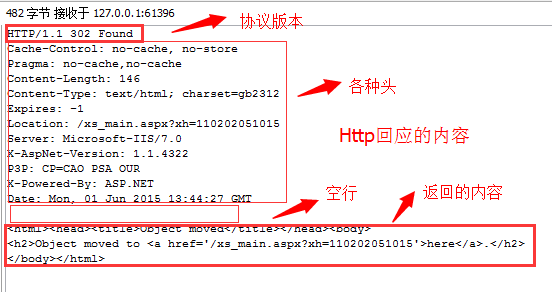
- Après avoir reçu la requête, le serveur fournit les informations de retour correspondantes. Le format de retour est : numéro de version du protocole + ligne d'état (résultat du traitement) + plusieurs en-têtes d'information + ligne vide + contenu d'entité (comme le HTML renvoyé)
- Le client reçoit les informations de retour du serveur, les affiche via le navigateur, puis se déconnecte du serveur. Bien sûr, si une erreur se produit à une étape intermédiaire, les informations d'erreur seront renvoyées au client et affichées, comme la classique erreur 404 !
Si le flux ci-dessus n'est toujours pas clair, nous pouvons utiliser HttpWatch ou Firefox pour capturer les paquets. PS : Le site de test est le système des affaires académiques de l'école de Little Pig. Après avoir saisi le compte et le mot de passe et demandé la connexion, nous pouvons voir les informations suivantes :
Contenu inclus dans une requête HTTP :
Contenu inclus dans une réponse HTTP :
Maintenant, c'est clair au premier coup d'œil, non !
4) Processus métier du protocole HTTP
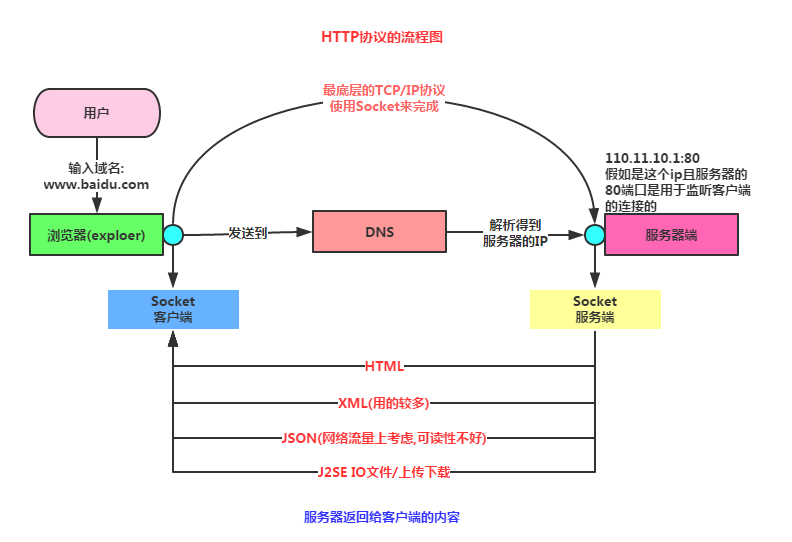
5) Plusieurs méthodes de requête HTTP
Dans le développement réel, nous utilisons plus souvent GET et POST, mais dans le développement réel, nous pouvons aussi utiliser d'autres méthodes de requête, comme PUT. Little Pig l'a utilisé dans des projets réels. Ci-dessous, pour la commodité de chacun, listons toutes les méthodes de requête :
- GetRequête pour obtenir la ressource identifiée par Request-URI
- POSTAjouter de nouvelles données après la ressource identifiée par Request-URI
- HEADRequête visant à obtenir l'en-tête du message de réponse de la ressource identifiée par Request-URI
- PUTRequête demandant au serveur de stocker une ressource et d'utiliser Request-URI comme son identifiant
- DELETERequête demandant au serveur de supprimer la ressource identifiée par Request-URI
- TRACERequête demandant au serveur de renvoyer les informations de requête reçues, principalement utilisée pour les tests ou le diagnostic
- CONNECTRéservé à un usage futur
- OPTIONSRequête pour interroger les performances du serveur, ou les options relatives à la ressource
6) Comparaison de GET et POST
Les deux les plus utilisés, il faut bien sûr les comparer !
- GETGET : Ajouter les données à soumettre au serveur après l'adresse URL de la requête sous la forme `?`, plusieurs données étant séparées par `&`, mais la capacité des données ne peut généralement pas dépasser 2K, par exemple : `http://xxx?username=…&pawd=…` ceci est du GET.
- POSTPOST : Celui-ci peut envoyer des données au serveur dans le contenu d'entité de la requête, et il n'y a aucune limite sur la quantité transmise.
- Autre chose à mentionner : ces deux méthodes servent toutes les deux à envoyer des données, mais les mécanismes d'envoi sont différents. Ne croyez pas ce qui est dit en ligne : « GET obtient les données du serveur, POST envoie des données au serveur » !! De plus, la sécurité de GET est très faible, celle de POST est relativement élevée, mais l'efficacité d'exécution est meilleure que celle de la méthode POST. En général, nous utilisons GET pour les requêtes, et POST pour ajouter, supprimer et modifier des données !!
7) Collection des codes d'état HTTP
Bien sûr, ces codes d'état ne sont donnés qu'à titre indicatif ; en fait,la décision revient au côté serveur (backend).Une solution consiste à : après une requête, le serveur nous renvoie un statut ; ou une autre, qui est surtout utile lorsque l'application n'a pas besoin de versions multilingues, est de nous renvoyer directement une chaîne JSON contenant les informations de résultat, et nous n'avons plus qu'à l'afficher. Cela peut faire gagner beaucoup de temps ! Voici la liste des codes d'état, à titre indicatif :
- 100~199 : la requête a été acceptée avec succès ; le client doit soumettre la requête suivante pour terminer l'ensemble du processus de traitement.
- 200 : OK, la requête du client a réussi.
- 300~399 : la ressource demandée a été déplacée vers une nouvelle adresse (302, 307, 304).
- 401 : requête non autorisée ; ce code d'état doit être utilisé avec le champ d'en-tête WWW-Authenticate.
- 403 : Interdit. Le serveur a reçu la requête mais refuse de fournir le service.
- 404 : Introuvable. La ressource demandée n'existe pas. Inutile d'en dire plus.
- 500 : Erreur interne du serveur. Une erreur inattendue s'est produite sur le serveur.
- 503 : Serveur indisponible. Le serveur ne peut pas traiter actuellement la requête du client ; il peut revenir à la normale après un certain temps.
8) Caractéristiques du protocole HTTP
Ce sont des notions conceptuelles ; contentez-vous de les connaître, ne les mémorisez pas. Ceci provient de Baidu Baike, directement copié et collé :
1. Prend en charge le mode client/serveur.。
2. Simple et rapide.Lorsqu’un client demande un service à un serveur, il lui suffit de transmettre la méthode de requête et le chemin. Les méthodes de requête courantes sont GET, HEAD, POST. Chaque méthode spécifie un type de contact différent entre le client et le serveur. Comme le protocole HTTP est simple, la taille du programme d’un serveur HTTP est réduite, ce qui rend la vitesse de communication rapide.
3. Flexible.HTTP permet de transmettre tout type d’objet de données. Le type transmis est indiqué par Content-Type.
4. Sans connexion.La signification de « sans connexion » est de limiter chaque connexion au traitement d’une seule requête. Après que le serveur a traité la requête du client et reçu la réponse du client, il se déconnecte. Cette méthode peut faire gagner du temps de transmission.
5. Sans état.: Le protocole HTTP est un protocole sans état. Sans état signifie que le protocole n’a aucune capacité de mémorisation pour le traitement des transactions. L’absence d’état signifie que si un traitement ultérieur nécessite des informations précédentes, celles-ci doivent être retransmises, ce qui peut augmenter la quantité de données transmises par connexion. En revanche, lorsque le serveur n’a pas besoin des informations précédentes, sa réponse est plus rapide.
PS : Concernant le protocole OSI à sept couches et le modèle TCP à quatre couches, ils ne seront pas expliqués dans la série de base~ Si cela vous intéresse, vous pouvez vous renseigner par vous-même !
Résumé de cette section :
Cette section a expliqué les outils dont nous avons besoin pour mener à bien le développement Android lié au réseau, ainsi que les concepts associés au protocole HTTP. Je pense que tout le monde a maintenant une impression vague de l’interaction entre les clients mobiles Android et les serveurs. Dans la prochaine section, nous étudierons les en-têtes de requête et les en-têtes de réponse du protocole HTTP ! Cette section se termine ici, merci~