1. Algo de cháchara
Me da vergüenza decirlo, pero ha pasado más de un año desde la última entrega de DrySister. Durante ese tiempo, muchos compañeros me han enviado mensajes privados diciendo que estaba bien escrito y preguntando cuándo se actualizaría; básicamente respondí que lo había abandonado... Las razones concretas son variadas. Últimamente he estado bastante libre, así que quiero terminar la primera versión. Cuando empecé a escribir eraAS 2.1.2, ahora yaAS 3.0.1, el contenido de esta sección
- Paso 1: Repasar lo que se ha visto en las secciones anteriores
- Paso 2: Hacer algunos ajustes para que el código funcione en AS 3.0.1
- Paso 3: Escribir una clase de registro
En la próxima sección hablaremos sobre la firma, la ofuscación y la publicación en el mercado de aplicaciones~ Sin más preámbulos, ¡comencemos con el contenido de esta sección!
2. Revisión del código
- Sección 1: Configuración del proyecto e implementación simple
- 1. Operaciones relacionadas con Git
- 2. Clase simple de carga de imágenes (obtener flujo de red -> convertir a imagen -> actualizar la interfaz de usuario con Handler)
- Sección 2: Análisis de los datos del backend
- 1. Usar el cutre analizador Json incorporado de Android para analizar los datos Json devueltos por el backend (cadena Json -> List<Bean>)
- 2. Usar AsyncTask para realizar solicitudes de red asíncronas
- Sección 3: Optimización de la carga de imágenes (escribir un pequeño marco de caché de imágenes)
- 1. El enfoque básico del almacenamiento en caché de imágenes
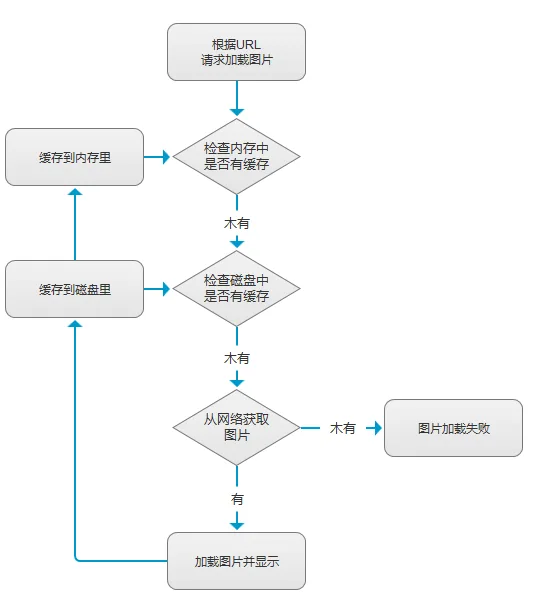
- 2. Usarel método de compresión por muestreoComprimir Bitmap para evitar OOM
- 3. Grupo de subprocesos para gestionar múltiples subprocesos de carga de imágenes
- 4. Handler para actualizar la interfaz de usuario
- 5. Convertir cadena String (aquí URL) a MD5
- 6. Clase de caché en memoriaLruCacheel uso de
- 7. Clase de caché en discoDiskLruCacheel uso de
- 8. Diseño lógico de todo el proceso de carga asíncrona de imágenes y caché
- 1. El enfoque básico del almacenamiento en caché de imágenes
- Sección 4: Añadir caché de datos (integrando SQLite)
- 1. Comprobación del estado de la red
- 2. Personalizar SQLiteOpenHelper para crear la base de datos
- 3. Operaciones relacionadas con la base de datos: agregar, eliminar, modificar, consultar, transacciones, paginación, etc.
Lo anterior es el contenido de las cuatro secciones anteriores, en las que se han aplicado los conocimientos importantes para la introducción básica a Android. Si los dominas todos, se puede decir que apenas has entrado en Android; ¡el camino que queda por delante es largo!
3. Ajustes del código
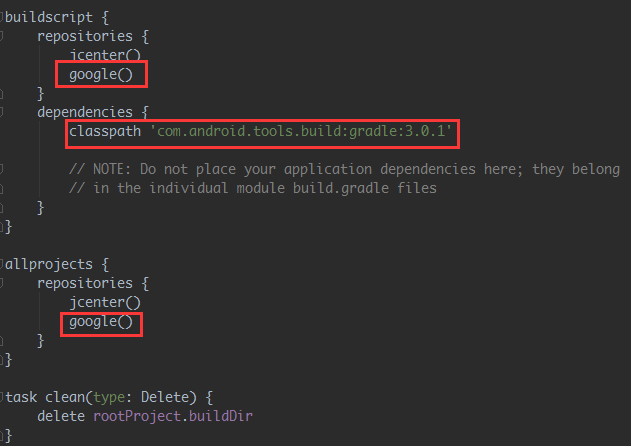
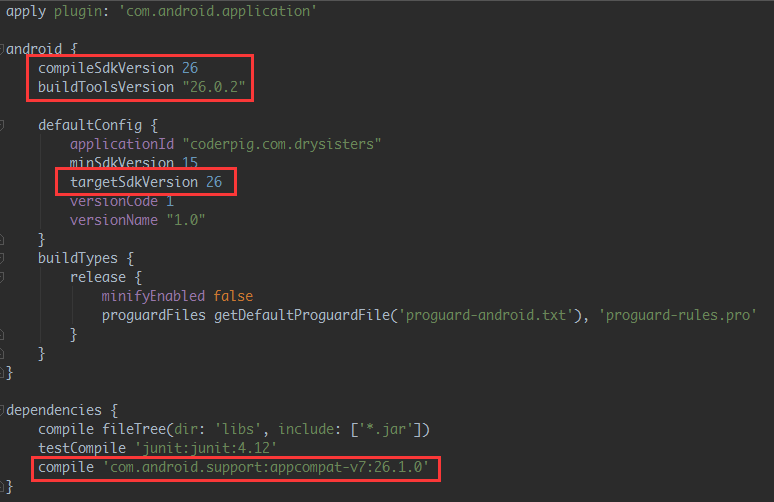
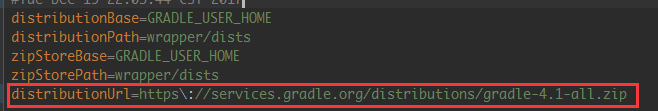
Después de cambiar AS a 3.0, el código de los siguientes archivos debe modificarse. Como siempre, ejecutemos el comando de cambio de rama:git checkout -b fixcodeas3.0.1, y luego comenzar a modificar el código:
A nivel de proyecto:build.gradle:
A nivel de APP:build.gradle:
gradle-wrapper.properties:
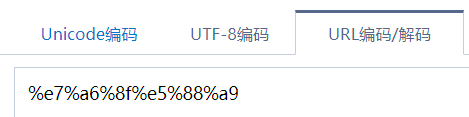
Hay otro lugar que debe cambiarse ligeramente:SisterApi.java, cambiarbeneficiopor:%e7%a6%8f%e5%88%a9Esto implica el problema de la transcodificación de caracteres chinos, y HttpUrlConnection no puede abrir enlaces que contengan chino; es necesario llamar a la codificación de la parte china medianteURLEncoder.encode(parteChina,"utf-8");para transcodificar; recuerdasolo la parte china, no toda la url¡¡¡También es necesario capturar la excepción. Como aquí solo hay un lugar que necesita transcodificación, simplemente usé una herramienta de transcodificación en línea para hacerlo:https://c.example.com/front-end/695
Resultado después de la conversión:
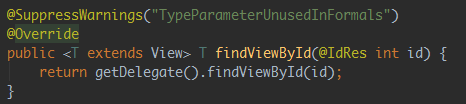
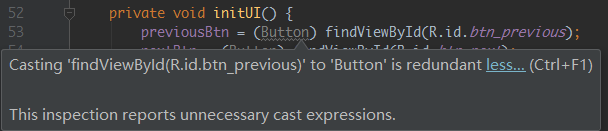
Además, hay algunos otros cambios menores,buildToolsVersion 26 o superior,findViewById no necesita conversión forzada, si entras en el método lo verás; usa genéricos, así que elimina todos los findViewById:
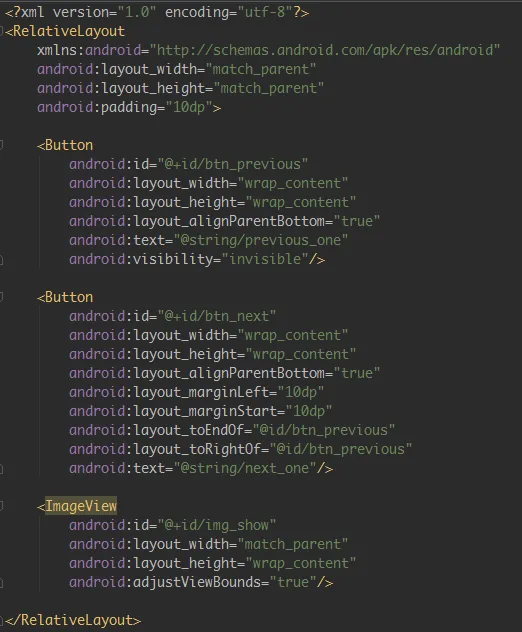
Finalmente, sentí que el efecto al ejecutarlo en mi Meilan E2 era un poco diferente, así que ajusté ligeramente el diseño de la página: hice que el ancho de la imagen llenara la pantalla y que la altura se adaptara automáticamente. El atributo que se usa aquí esandroid:adjustViewBounds = "true", es decir, escalar el ancho y el alto proporcionalmente; además, pon el texto de "paso anterior" y "paso siguiente" enstrings.xmlel archivo, y ajusta ligeramente los márgenes:
Finalmente, veamos el resultado de ejecución de nuestro proyecto: (vaya, las chicas bonitas son agradables a la vista):
Luego fusiona esta rama en la rama develop. Aquí no usamos el método de fusión merge anterior, sino rebase para fusionar. El proceso concreto es el siguiente:
git add .
git commit -m "fix code in as3.0"
git checkout develop    # 切换到develop分支
git rebase fix_code_as3.0.1 # 合并分支
git push origin develop # 推送develop到远程分支
git branch -d fix_code_as3.0.1  # 删除合并后的本地分支
Si todavía no entiendes Git, puedes aprenderlo en otro artículo; aquí no explicaré demasiado:Resumen del uso de Git de Xiao Zhu
4. Escribir la clase de utilidades de registro y la clase de captura de registros de fallos
Imprimir registros con Log no debería ser desconocido para ningún desarrollador; es indispensable en la depuración diaria. Cuando la aplicación se empaqueta y se entrega al tester, y el tester informa de que la aplicación crashea, lo primero que pensamos es pedirle que nos proporcione el registro. Hablando de hacer Log, a muchos compañeros les gusta poner un Log.e(xxx,xxx) al azar, y todos los registros son de nivel Error. La razón básica es:el rojo es más llamativo, ¡jaja! Luego simplemente imprimen el valor de la variable, o lo añaden en algún método para verificar si el método se ejecuta, etc. Si recuerdan eliminarlo en la versión oficial, está bien; si no lo recuerdan, es buscarse la muerte. En fin, antes me regañó un jefe de la empresa anterior, ¡y todavía lo recuerdo vívidamente! La gestión del Log es muy importante; las dos clases de utilidades que vamos a escribir son las siguientes:
- 1. En modo debug, los registros se imprimen normalmente; en release, no se imprimen.
- 2.Captura de registros de fallos, si lo pruebas tú mismo o lo prueba el tester, no pasa nada; cuando falla, conectas el teléfono al ordenador y miras el logcat y todo queda claro. Pero si la aplicación está instalada en el teléfono del usuario y la aplicación falla y deja de ejecutarse, el usuario no te enviará el registro; además, los fallos repetidos pueden hacer que el usuario desinstale tu APP. Por lo tanto, necesitamos guardar el registro cuando la APP falla, y cuando el usuario se conecta al wifi o vuelve a abrir la aplicación, subir este registro a nuestro servidor. Aquí solo lo hacemos por diversión, así que solo hacemoscaptura local de registros de fallos, normalmente la recolección de registros se realiza integrando herramientas de estadísticas de terceros, como Umeng, Bugly, etc.
Bien, los requisitos son los dos puntos anteriores. A continuación, nos preparamos para empezar a escribir el código. Pero antes de escribir el código, expliquemos dos cosas sobre Log; quizás la mayoría de los compañeros ya lo saben, y si lo saben pueden saltárselo:
1) Impresión rápida de Log
Abre los ajustes y haz clic en:Live Templates -> AndroidLogMarca todas las opciones de impresión de registros. También puedes escribir tu propia plantilla en el Template text de abajo~
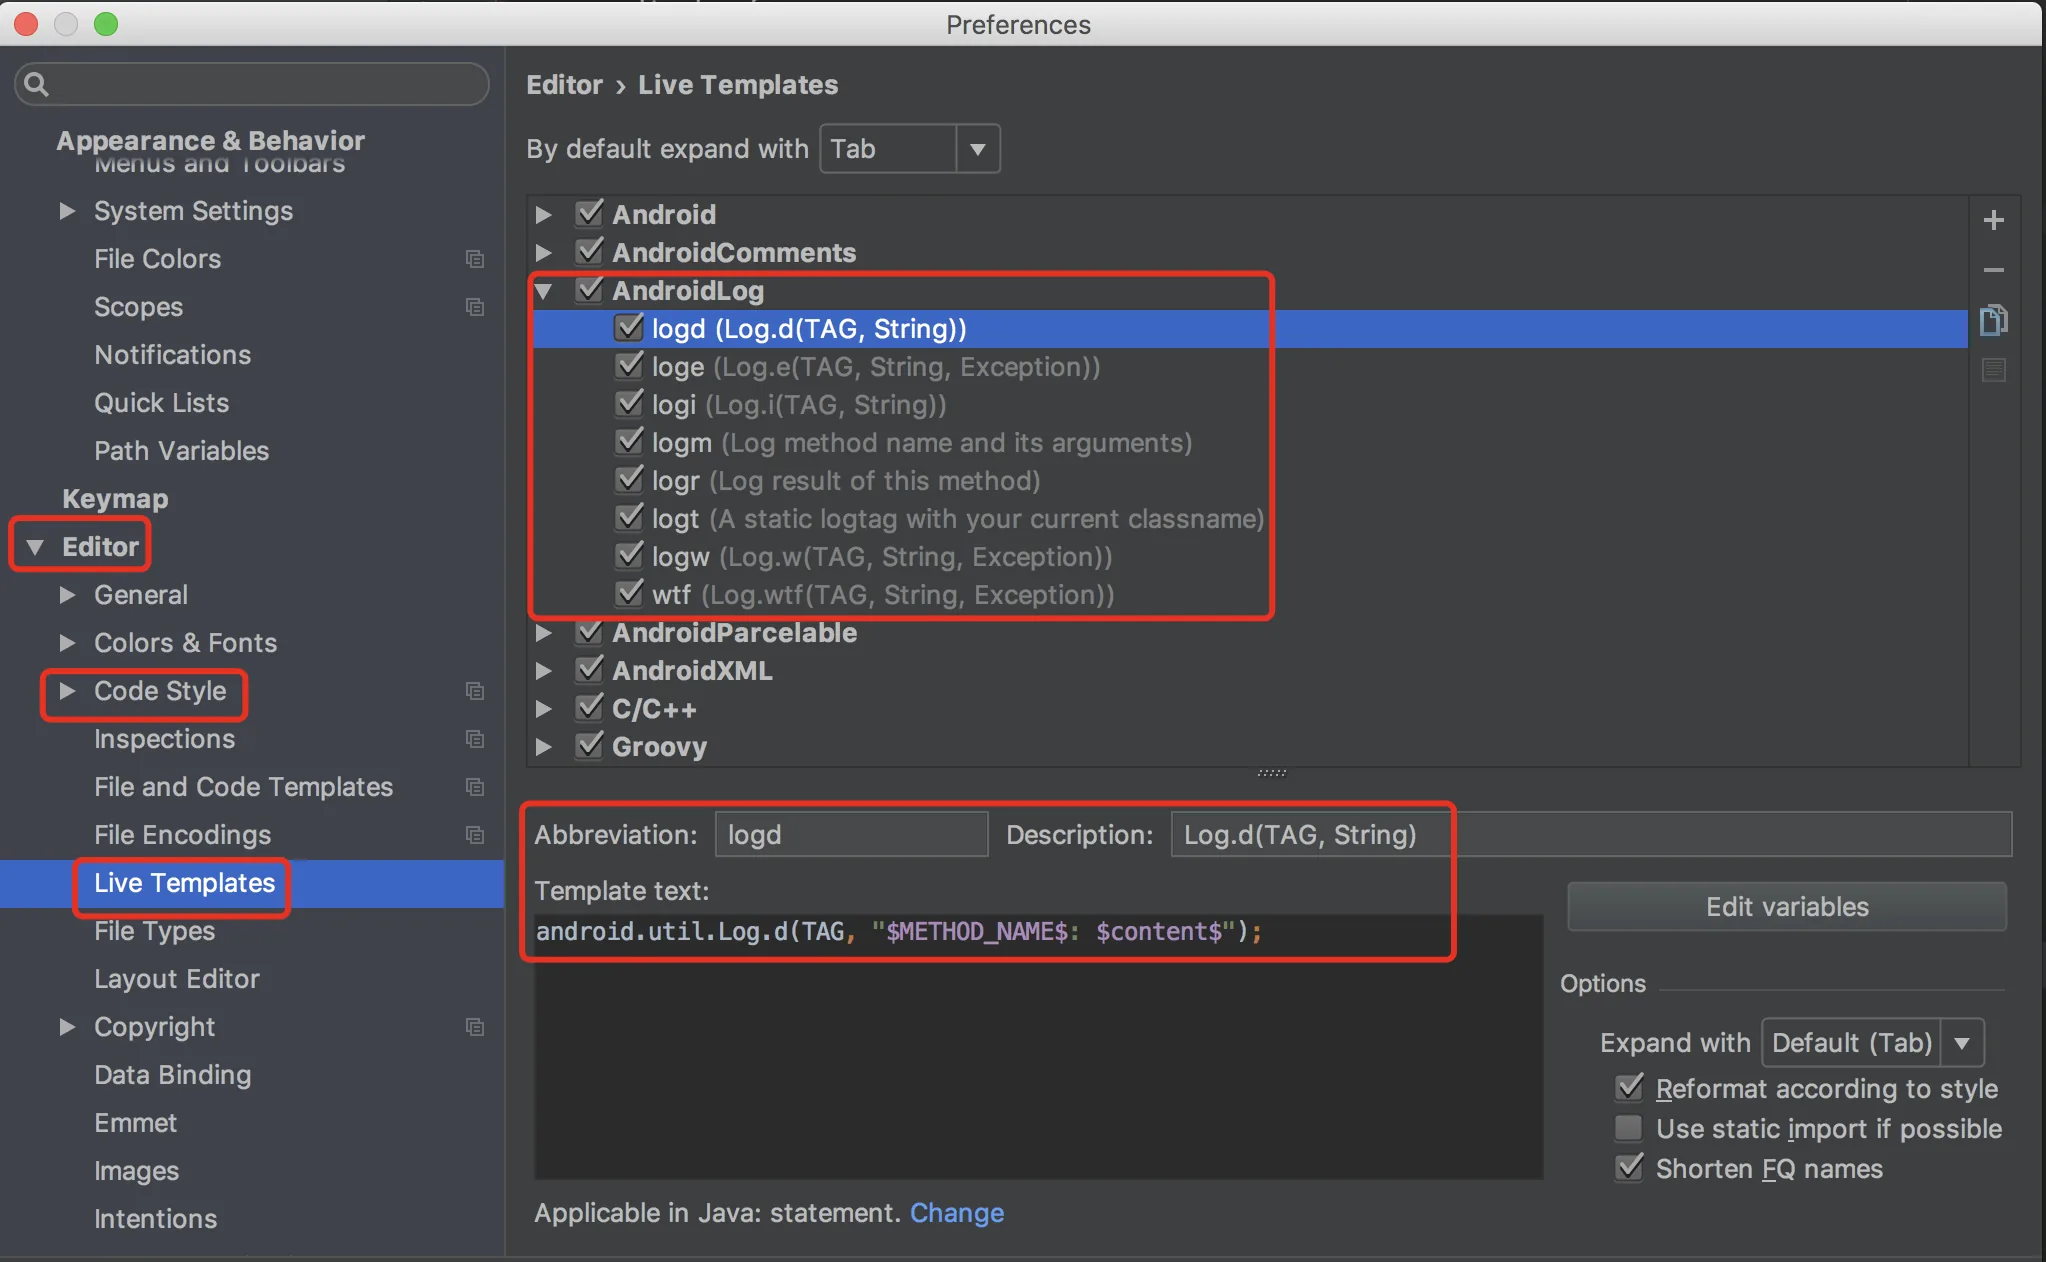
Luego escribe el log... anterior en cualquier lugar del código y, con un Enter, aparecerá la sentencia Log; el TAG será directamente el nombre de tu método actual.
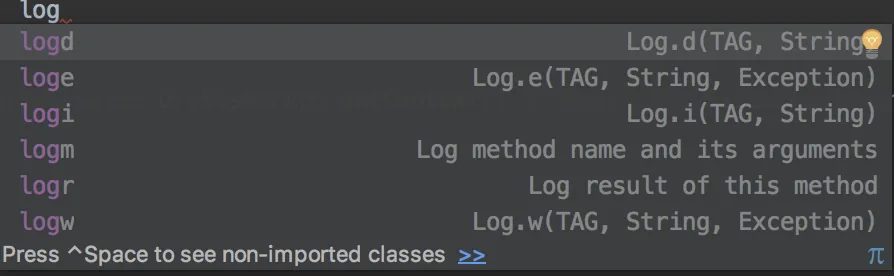
2. Explicación sobre el uso de Log
1) Comando de impresión rápida de Log
Abre Settings y haz clic en:Live Templates -> AndroidLogMarca todas las opciones de impresión de registros. También puedes escribir tu propia plantilla en el Template text de abajo~
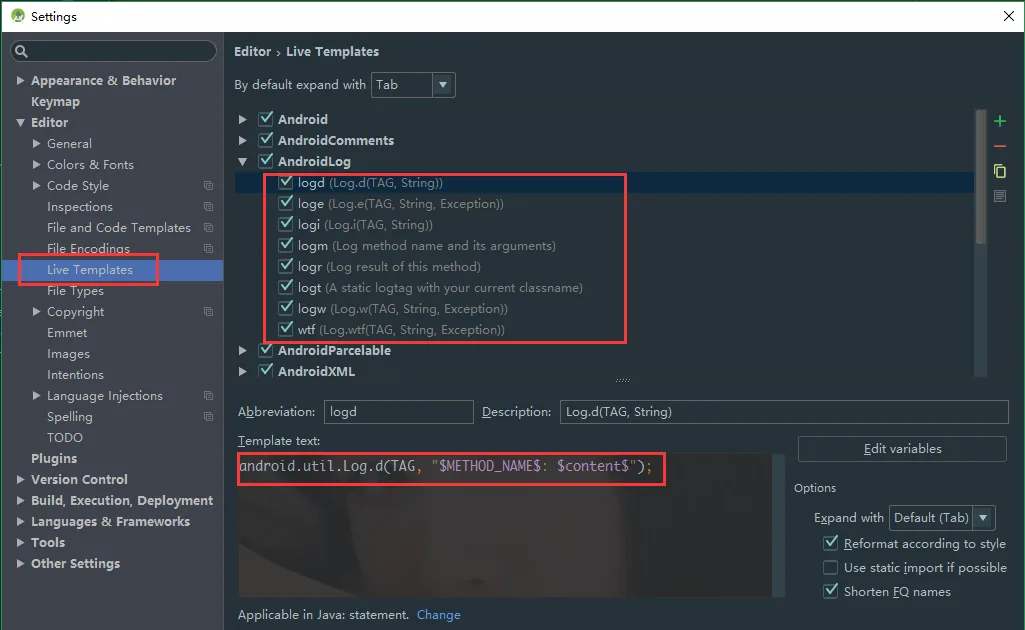
Luego escribe el log... anterior en cualquier lugar del código y, con un Enter, aparecerá la sentencia Log~
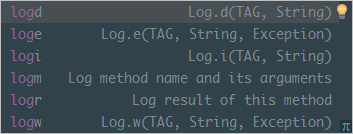

Si estás fuera de un método, al escribir logt se puede generar directamente un TAG con el nombre de la clase correspondiente:
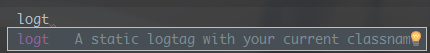

2) Explicación de los niveles de Log
Antes, cuando el líder de grupo tenía una reunión breve, mencionó nuestro mal hábito de usar directamente Log.e al depurar; los diferentes niveles de Log deberían imprimir información diferente:
- Log.v:Verbose (verboso)Información detallada durante el desarrollo y la depuración; no debería compilarse en el producto, solo se usa en la etapa de desarrollo.
- Log.d: Debug (depuración)Información utilizada para la depuración; se compila en el producto y se desactiva en tiempo de ejecución.
Los siguientes tres niveles no deben usarse como información de depuración ordinaria. Estos niveles de Log son pistas importantes para analizar cuando la aplicación tiene problemas. Si se usan arbitrariamente, causarán molestias innecesarias a los desarrolladores a la hora de analizar errores.
- Log.i: Info (información)Por ejemplo, cierta información de estado en tiempo de ejecución; esta información de estado puede ser de ayuda cuando surgen problemas.
- Log.w: Warning (advertencia)Advierte que la aplicación ha tenido una anomalía, pero no necesariamente producirá un error de inmediato; hay que prestarle atención.
- Log.e: Error (error)La aplicación ha tenido un error, ¡es lo que más requiere atención y solución!
3) Escribir la clase de utilidades de registro
Como siempre, primero creamos una rama:buglogcatchEsto es muy simple: se muestra en depuración, no se muestra en la versión oficial; usandoBuildConfig.Debugpara hacer el juicio está bien. El código es el siguiente:
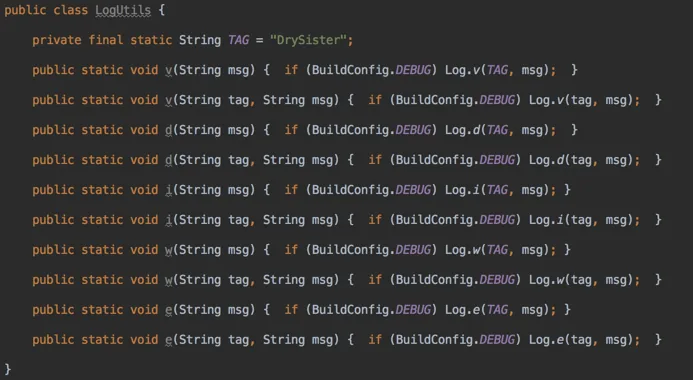
4) Escribir la clase de captura de registros de fallos
La clase de captura de registros de fallos depende deApplicationyThread.UncaughtExceptionHandlerpara implementarse. Cuando el programa, debido aexcepción no capturadaCuando el hilo esté a punto de terminar y salir, se consultará el UncaughtExceptionHandler del hilo mediante Thread.UncaughtExceptionHandler y se llamará ael método uncaughtException, pasando el hilo y la excepción como parámetros. Si el hilono tiene un UncaughtExceptionHandler establecido explícitamente, entonces se usará suThreadGroupThreadGroup como su UncaughtExceptionHandler, y luego se pasará al manejador de excepciones no capturadas predeterminado para que la procese. Así que solo necesitamosimplementar la interfaz UncaughtExceptionHandler, sobrescribirel método uncaughtExceptionpara implementar nuestro manejo personalizado. Primero vamos a ordenar la lista de la lógica:
- 1.Crear una carpeta dedicada a los archivos de registro:hay que determinar si la tarjeta de almacenamiento está disponible y luego comprobar si la carpeta existe; si no existe, crear la carpeta;
- 2. Se necesita un método para escribir una cadena en un archivo.
- 3.Composición del contenido del registro de fallos:hora actual, versión de la aplicación, información del dispositivo y registro de fallos.
- 4. Obtener el manejador UncaughtException predeterminado del sistema y luego comprobar si es null; si no es nulo, establecerlo como UncaughtException personalizado. Aquí usamos un singleton.
- 5. Por último, el reinicio de la aplicación: establecer que la aplicación se reinicie después de 1 segundo.
La lógica general es la anterior; vamos paso a paso. Primero los pasos 1 y 2:
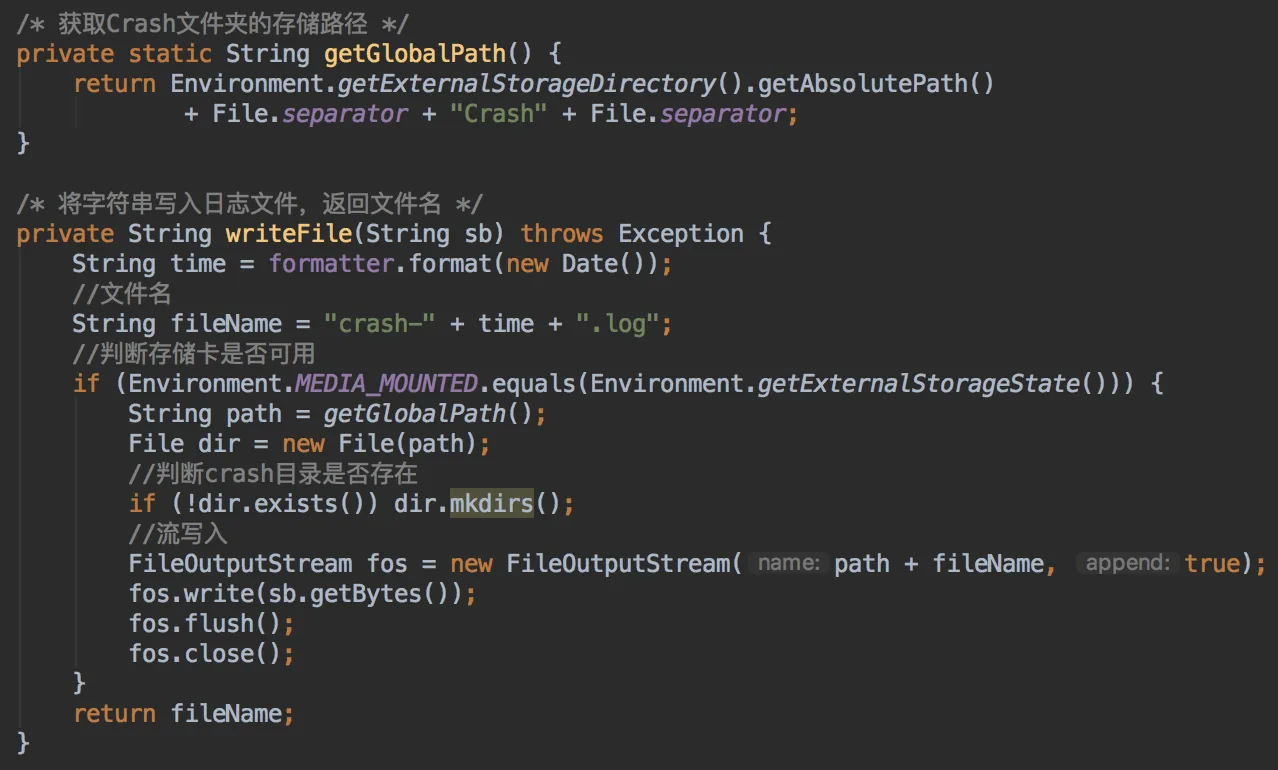
A continuación, el registro de fallos se compone de varias partes: primero la hora actual,

luego la versión de la aplicación y la información del dispositivo. Aquí usamos un HashMap para almacenarla:
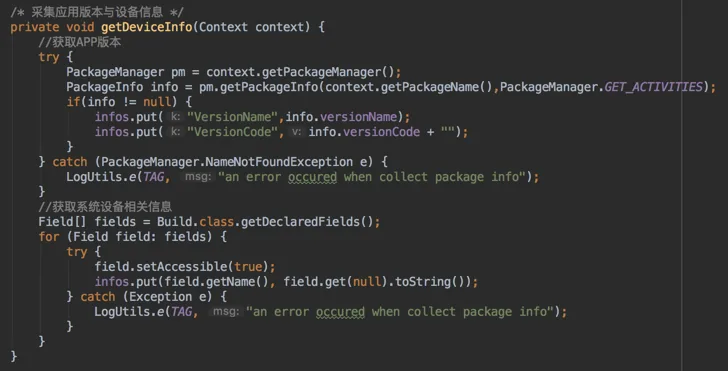
Después viene la información de la excepción. Esto es fácil: basta con pasar el objeto de la excepción y llamar a printStackTrace. Al final, todo junto queda así:
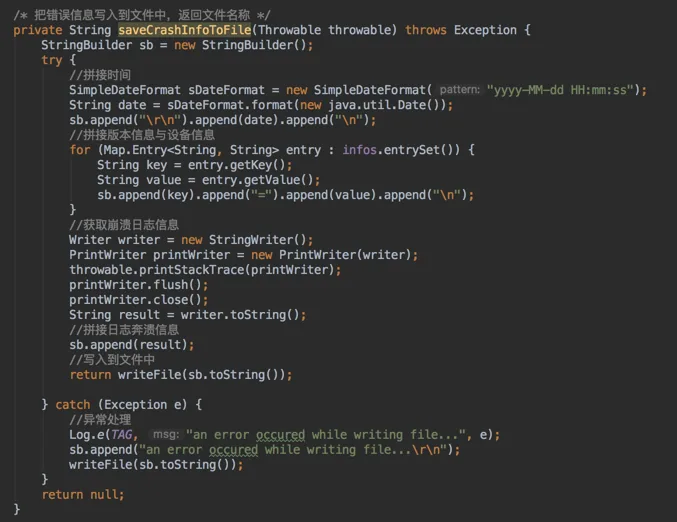
Escribir en el archivo también está resuelto. Luego viene el singleton del UncaughtExceptionHandler personalizado y la obtención del manejador UncaughtExceptionHandler predeterminado; se establece como UncaughtExceptionHandler personalizado y además hay que sobrescribir el método uncaughtException.
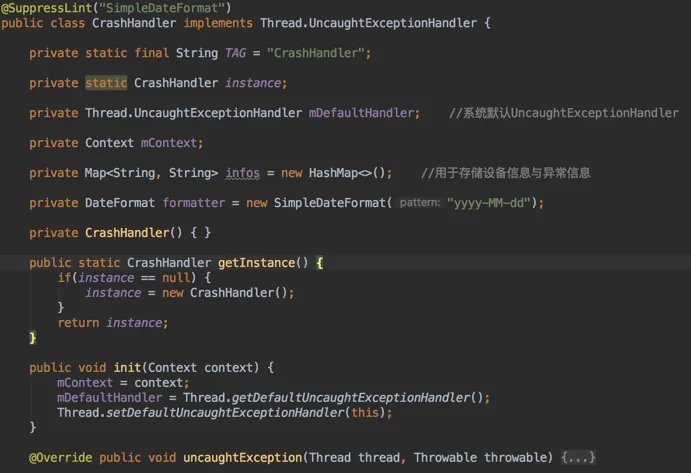
A continuación, escribimos todo el conjunto del manejo de excepciones en un método. Cuando ocurre una excepción, se muestra un Toast para avisar al usuario de que la aplicación se reiniciará, y también se llama al método de escritura del registro:
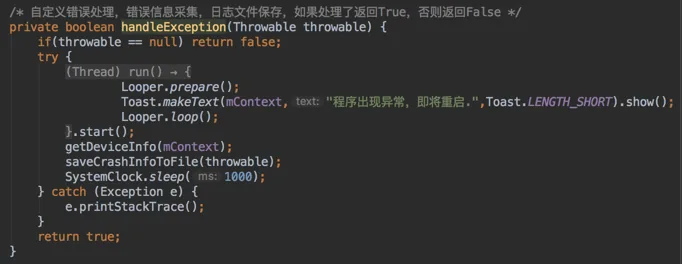
Luego, el método uncaughtException sobrescrito hace una comprobación: si la excepción se ha procesado mediante el manejo personalizado y si el UncaughtExceptionHandler predeterminado es null, es decir:¿La excepción se ha manejado?Si no se ha manejado, se pasa al UncaughtExceptionHandler personalizado; si se ha manejado, se reinicia la aplicación.
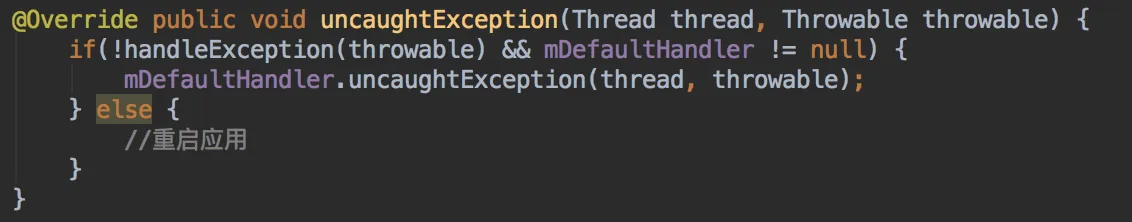
Finalmente, agregamos el código relacionado con el reinicio de la aplicación y ¡listo!:
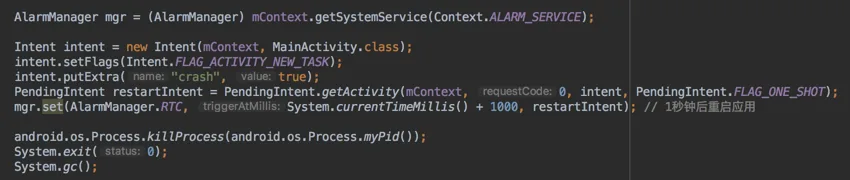
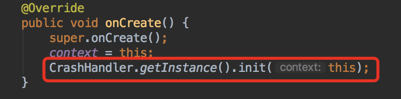
Con esto, nuestra clase de herramienta de recopilación de registros de fallos está terminada. Para habilitarla, hay que añadir en el método onCreate() de DrySisterApp.java:
Si quieres probar si funciona, es muy sencillo: basta con provocar un fallo manualmente. Por ejemplo, hago una operación de división por cero en el botón del siguiente paso:
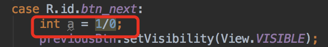
Después de ejecutar la aplicación y hacer clic en "Siguiente", se produce un bloqueo directo. Abre el directorio raíz del almacenamiento interno y mira si existe una carpeta Crash; si la abres y ves nuestro archivo de registro, significa que ha sido un éxito:
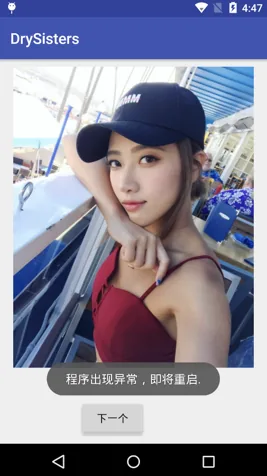
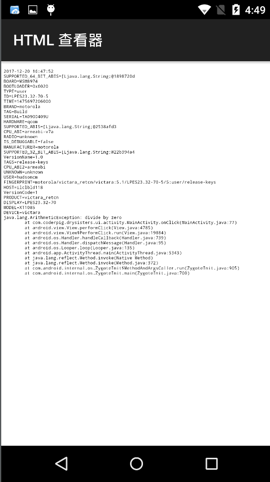
Con esto queda terminado. Fusiona la rama a develop y luego haz push al repositorio remoto:
git add .
git commit -m "add LogUtils and CrashHandler"
git checkout develop    # 切换到develop分支
git rebase bug_log_catch # 合并分支
git push origin develop # 推送develop到远程分支
git branch -d bug_log_catch  # 删除合并后的本地分支
5. Resumen
En esta sección primero revisamos el código escrito anteriormente; luego, debido al cambio a AS 3.0, ajustamos un poco el código. Finalmente, también escribimos la clase de utilidad de registro y la clase de utilidad de recopilación de registros de fallos. Pequeño pero completo; aunque sea solo un pequeño programa de visualización de imágenes, cubre la mayor parte de los conocimientos de introducción. La siguiente sección será el capítulo final de la primera versión:firma y empaquetado,,ofuscacióny la publicación enCoolapk. ¡Estén atentos!
Descarga del código:
https://github.com/coder-pig/DrySister/tree/developBienvenidos a hacer follow y star; si creen que hay algo que añadir, pueden plantear issues.