Common Data Types
This chapter will introduce you to the four most common data types in machine learning: numerical, textual, image, and categorical data.
Data types are like the kinds of ingredients, different ingredients require different processing methods. Similarly, different types of data also require different processing techniques and algorithms.
Four Major Data Type Categories
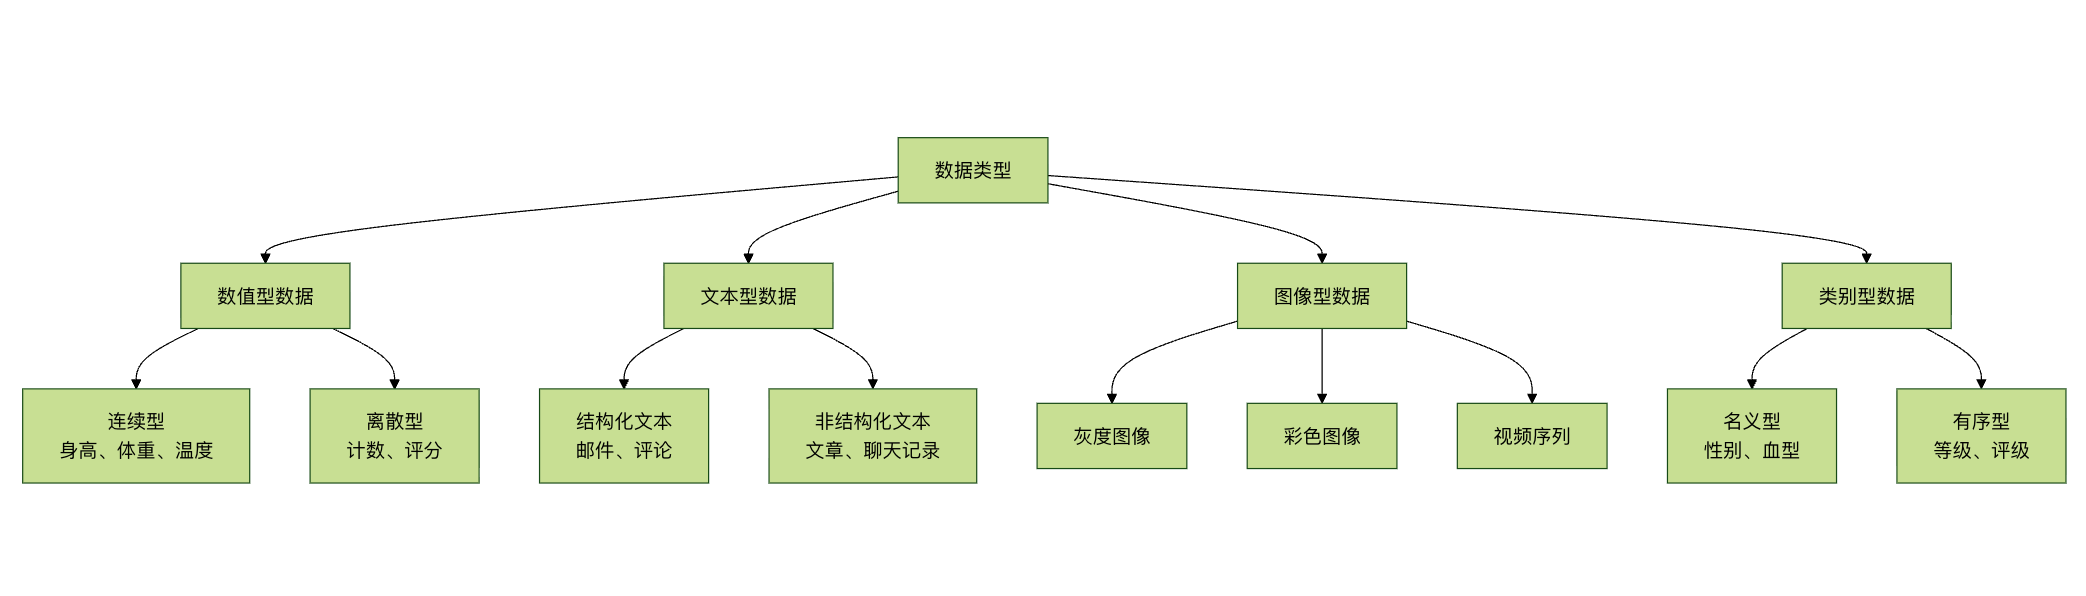
Numerical Data
What is numerical data?
Numerical data is like the result of a ruler measurement, can perform mathematical operations, and is the most common data type in machine learning.
Classification of numerical data
1. Continuous numerical data
Example
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
def continuous_data_example():
"""Example of continuous numerical data"""
print("=== Continuous Numerical Data Example ===")
# Generate continuous data
np.random.seed(42)
n_samples = 1000
# Height data (continuous)
heights = np.random.normal(170, 10, n_samples) # Mean 170, standard deviation 10
weights = heights * 0.7 + np.random.normal(0, 5, n_samples) # Weight is correlated with height
temperatures = np.random.normal(36.5, 0.5, n_samples) # Body temperature
# Create data frame
continuous_data = pd.DataFrame({
'Height (cm)': heights,
'Weight (kg)': weights,
'Body temperature (°C)': temperatures,
'Age': np.random.randint(18, 65, n_samples)
})
print("Continuous data example:")
print(continuous_data.head())
print(f"\nData statistics information:")
print(continuous_data.describe())
# Visualize continuous data distribution
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.hist(continuous_data['Height (cm)'], bins=30, alpha=0.7, color='skyblue')
plt.title('Height distribution')
plt.xlabel('Height (cm)')
plt.ylabel('Frequency')
plt.subplot(2, 2, 2)
plt.hist(continuous_data['Weight (kg)'], bins=30, alpha=0.7, color='lightgreen')
plt.title('Weight distribution')
plt.xlabel('Weight (kg)')
plt.ylabel('Frequency')
plt.subplot(2, 2, 3)
plt.hist(continuous_data['Body temperature (°C)'], bins=30, alpha=0.7, color='salmon')
plt.title('Body temperature distribution')
plt.xlabel('Body temperature (°C)')
plt.ylabel('Frequency')
plt.subplot(2, 2, 4)
plt.scatter(continuous_data['Height (cm)'], continuous_data['Weight (kg)'], alpha=0.6)
plt.title('Height vs Weight')
plt.xlabel('Height (cm)')
plt.ylabel('Weight (kg)')
plt.tight_layout()
plt.show()
return continuous_data
# Run example
continuous_df = continuous_data_example()
. Discrete numerical data
Example
def discrete_data_example():
"""Example of discrete numerical data"""
print("\n=== Discrete Numerical Data Example ===)
# Generate discrete data
np.random.seed(42)
n_samples = 500
# Discrete data
customer_count = np.random.poisson(10, n_samples) # Poisson distribution: number of customers
product_rating = np.random.randint(1, 6, n_samples) # 1-5 star rating
defect_count = np.random.binomial(20, 0.1, n_samples) # Binomial distribution: number of defects
call_duration = np.random.exponential(5, n_samples) * 60 # Exponential distribution: call duration (seconds)
# Create data frame
discrete_data = pd.DataFrame({
'Number of customers': customer_count,
'Product rating': product_rating,
'Number of defects': defect_count,
'Call duration (seconds)': call_duration.astype(int)
})
print("Discrete data example:")
print(discrete_data.head())
print(f"\nData statistics information:")
print(discrete_data.describe())
# Visualize discrete data
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.hist(discrete_data['Number of customers'], bins=range(0, max(discrete_data['Number of customers'])+2),
alpha=0.7, color='orange')
plt.title('Number of customers distribution')
plt.xlabel('Number of customers')
plt.ylabel('Frequency')
plt.subplot(2, 2, 2)
value_counts = discrete_data['Product rating'].value_counts().sort_index()
plt.bar(value_counts.index, value_counts.values, color='purple', alpha=0.7)
plt.title('Product rating distribution')
plt.xlabel('Rating')
plt.ylabel('Frequency')
plt.subplot(2, 2, 3)
plt.hist(discrete_data['Number of defects'], bins=range(0, max(discrete_data['Number of defects'])+2),
alpha=0.7, color='red')
plt.title('Number of defects distribution')
plt.xlabel('Number of defects')
plt.ylabel('Frequency')
plt.subplot(2, 2, 4)
plt.hist(discrete_data['Call duration (seconds)'], bins=30, alpha=0.7, color='brown')
plt.title('Call duration distribution')
plt.xlabel('Call duration (seconds)')
plt.ylabel('Frequency')
plt.tight_layout()
plt.show()
return discrete_data
# Run example
discrete_df = discrete_data_example()
Methods for processing numerical data
Example
class NumericDataProcessor:
def __init__(self):
self.scalers = {}
self.transformers = {}
def detect_outliers(self, data, method='iqr'):
"""Detect outliers"""
outliers_info = {}
for column in data.select_dtypes(include=[np.number]).columns:
if method == 'iqr':
Q1 = data[column].quantile(0.25)
Q3 = data[column].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
outliers = data[(data[column] < lower_bound) |
(data[column] > upper_bound)]
elif method == 'zscore':
z_scores = np.abs((data[column] - data[column].mean()) / data[column].std())
outliers = data[z_scores > 3]
outliers_info[column] = {
'count': len(outliers),
'indices': outliers.index.tolist(),
'percentage': (len(outliers) / len(data)) * 100
}
return outliers_info
def handle_missing_values(self, data, strategy='mean'):
"""Handle missing values"""
processed_data = data.copy()
for column in processed_data.select_dtypes(include=[np.number]).columns:
if processed_data[column].isnull().sum() > 0:
if strategy == 'mean':
processed_data[column].fillna(processed_data[column].mean(), inplace=True)
elif strategy == 'median':
processed_data[column].fillna(processed_data[column].median(), inplace=True)
elif strategy == 'mode':
processed_data[column].fillna(processed_data[column].mode()[0], inplace=True)
elif strategy == 'forward':
processed_data[column].fillna(method='ffill', inplace=True)
elif strategy == 'backward':
processed_data[column].fillna(method='bfill', inplace=True)
return processed_data
def normalize_data(self, data, method='minmax'):
"""Data standardization"""
from sklearn.preprocessing import MinMaxScaler, StandardScaler, RobustScaler
processed_data = data.copy()
numeric_columns = data.select_dtypes(include=[np.number]).columns
if method == 'minmax':
scaler = MinMaxScaler()
elif method == 'standard':
scaler = StandardScaler()
elif method == 'robust':
scaler = RobustScaler()
else:
raise ValueError("Method must be 'minmax', 'standard', or 'robust'")
processed_data[numeric_columns] = scaler.fit_transform(processed_data[numeric_columns])
self.scalers[method] = scaler
return processed_data
def create_features(self, data):
"""Feature engineering"""
processed_data = data.copy()
numeric_columns = data.select_dtypes(include=[np.number]).columns
# Create polynomial features
if len(numeric_columns) >= 2:
col1, col2 = numeric_columns[0], numeric_columns[1]
processed_data[f'{col1}_x_{col2}'] = data[col1] * data[col2]
processed_data[f'{col1}_div_{col2}'] = data[col1] / (data[col2] + 1e-8)
# Create statistical features
for column in numeric_columns:
processed_data[f'{column}_log'] = np.log1p(data[column])
processed_data[f'{column}_sqrt'] = np.sqrt(np.abs(data[column]))
processed_data[f'{column}_square'] = data[column] ** 2
return processed_data
# Usage example
processor = NumericDataProcessor()
# Detect outliers
outliers = processor.detect_outliers(continuous_df)
print("\nOutlier detection results:")
for column, info in outliers.items():
if info['count'] > 0:
print(f"{column}: {info['count']} outliers ({info['percentage']:.2f}%)")
# Data standardization
normalized_data = processor.normalize_data(continuous_df, method='standard')
print("\nStandardized data example:")
print(normalized_data.head())
Textual Data
What is textual data?
Textual data is like the expression of human language, contains rich semantic information, but requires special processing before it can be used by machine learning models.
Classification of textual data
1. Structured text data
Example
import pandas as pd
import re
from collections import Counter
def structured_text_example():
"""Example of structured text data"""
print("\n=== Structured Text Data Example ===)
# Create structured text data
structured_data = pd.DataFrame({
'Email ID': range(1, 11),
'Sender': [
'[email protected]', '[email protected]', '[email protected]',
'[email protected]', '[email protected]', '[email protected]',
'[email protected]', '[email protected]', '[email protected]',
'[email protected]'
],
'Subject': [
'Meeting notice: meeting at 3 pm tomorrow',
'Product quotation: latest price list',
'Customer feedback: service satisfaction survey',
'Project progress: first phase completed',
'Holiday arrangement: National Day holiday notice',
'Technical update: system upgrade announcement',
'Academic conference: paper call notice',
'Training notice: new employee training',
'Policy document: latest regulations',
'Health reminder: physical examination notice'
],
'Content length': [156, 234, 189, 145, 98, 267, 198, 134, 312, 87]
})
print("Structured text data example:")
print(structured_data)
# Text feature extraction
print("\n=== Text Feature Analysis ===)
# Email domain analysis
domains = [email.split('@')[1] for email in structured_data['Sender']]
domain_counts = Counter(domains)
print(f"Email domain distribution: {dict(domain_counts)}")
# Subject keyword analysis
all_words = []
for subject in structured_data['Subject']:
words = re.findall(r'[\u4e00-\u9fff]+', subject) # Extract Chinese vocabulary
all_words.extend(words)
word_counts = Counter(all_words)
print(f"Subject word frequency: {dict(word_counts)}")
# Content length statistics
print(f"Content length statistics:")
print(structured_data['Content length'].describe())
return structured_data
# Run example
structured_text_df = structured_text_example()
2. Unstructured text data
Example
def unstructured_text_example():
"""Example of unstructured text data"""
print("\n=== Unstructured Text Data Example ===)
# Create unstructured text data
unstructured_texts = [
"""
Artificial intelligence technology is developing rapidly, and major breakthroughs have been made in fields such as deep learning, machine learning, and natural language processing.
These technologies are widely applied in multiple industries such as healthcare, finance, education, and transportation, bringing new opportunities for social development.
In the future, with improved computing power and better algorithms, artificial intelligence will play an important role in more fields.
""",
"""
The weather is really nice today, sunny and breezy. I decided to take a walk in the park and enjoy this wonderful time.
There are many flowers in the park, red, yellow, purple, colorful and very beautiful. Little birds are singing in the trees,
Butterflies are dancing among the flowers, and everything seems so harmonious and natural.
""",
"""
The stock market performed strongly today, with the Shanghai Composite Index up 2.3% and the Shenzhen Component Index up 1.8%.
Tech stocks led the gains, with many stocks hitting the daily limit. Analysts believe this is mainly due to the favorable policies recently introduced.
Investor confidence has been boosted, market trading is active, and trading volume has expanded significantly.
""",
"""
A healthy lifestyle includes a balanced diet, moderate exercise, adequate sleep, and a positive mindset.
It is recommended to eat vegetables and fruits daily and reduce greasy food; exercise at least 3 times a week, each session over 30 minutes;
Ensure 7-8 hours of sleep; learn to regulate emotions and maintain a positive and optimistic attitude.
"""
]
text_categories = ['Technology', 'Life', 'Finance', 'Health']
# Create dataframe
unstructured_df = pd.DataFrame({
'Text': unstructured_texts,
'Category': text_categories
})
print("Example of unstructured text data:")
for i, row in unstructured_df.iterrows():
print(f"\nCategory: {row['类别']}")
print(f"Text: {row['文本'][:100]}...")
return unstructured_df
# Run example
unstructured_text_df = unstructured_text_example()
Text data processing methods
Example
# Text data processing methods
import jieba
from sklearn.feature_extraction.text import TfidfVectorizer, CountVectorizer
from sklearn.preprocessing import LabelEncoder
class TextDataProcessor:
def __init__(self):
self.vectorizers = {}
self.label_encoders = {}
def clean_text(self, text):
"""Text cleaning"""
# Remove special characters and numbers
text = re.sub(r'[^\u4e00-\u9fff\s]', '', text)
# Remove extra spaces
text = re.sub(r'\s+', ' ', text).strip()
return text
def tokenize_chinese(self, text):
"""Chinese word segmentation"""
words = jieba.lcut(text)
# Remove stop words (simplified version)
stop_words = {'of', 'already', 'at', 'is', 'I', 'have', 'and', 'then', 'not', 'person', 'all', 'one', 'one', 'on', 'also', 'very', 'to', 'say', 'want', 'go', 'you', 'will', '-ing', 'none', 'see', 'good', 'self', '这'}
words = [word for word in words if word not in stop_words and len(word) > 1]
return words
def extract_features(self, texts, method='tfidf'):
"""Feature extraction"""
# Text preprocessing
cleaned_texts = [self.clean_text(text) for text in texts]
if method == 'tfidf':
vectorizer = TfidfVectorizer(max_features=1000, token_pattern=r'(?u)\b\w+\b')
elif method == 'count':
vectorizer = CountVectorizer(max_features=1000, token_pattern=r'(?u)\b\w+\b')
else:
raise ValueError("Method must be 'tfidf' or 'count'")
features = vectorizer.fit_transform(cleaned_texts)
self.vectorizers[method] = vectorizer
return features.toarray(), vectorizer.get_feature_names_out()
def analyze_text_statistics(self, texts):
"""Text statistical analysis"""
stats = []
for text in texts:
cleaned_text = self.clean_text(text)
words = self.tokenize_chinese(cleaned_text)
stats.append({
'Character count': len(text),
'Character count after cleaning': len(cleaned_text),
'Word count': len(words),
'Average word length': np.mean([len(word) for word in words]) if words else 0,
'Unique word count': len(set(words))
})
return pd.DataFrame(stats)
def encode_labels(self, labels):
"""Label encoding"""
encoder = LabelEncoder()
encoded_labels = encoder.fit_transform(labels)
self.label_encoders['default'] = encoder
return encoded_labels, encoder.classes_
# Usage example
text_processor = TextDataProcessor()
# Text statistical analysis
text_stats = text_processor.analyze_text_statistics(unstructured_text_df['Text'])
print("\nText statistical analysis: ")
print(text_stats)
# Feature extraction
features, feature_names = text_processor.extract_features(
unstructured_text_df['Text'], method='tfidf'
)
print(f"\nFeature matrix shape: {features.shape}")
print(f"First 10 features: {feature_names[:10]}")
# Label encoding
encoded_labels, label_classes = text_processor.encode_labels(
unstructured_text_df['Category']
)
print(f"\nEncoded labels: {encoded_labels}")
print(f"Label classes: {label_classes}")
Image Data
What is image data?
Image data is like a digital representation of the visual world, composed of pixels, containing rich spatial and color information.
Classification of image data
1. Grayscale image
Example
import numpy as np
import matplotlib.pyplot as plt
from PIL import Image
def grayscale_image_example():
"""Grayscale image example"""
print("\n=== Grayscale image example ===")
# Create a simple grayscale image
# Create a 100x100 grayscale image
height, width = 100, 100
# Create gradient image
gradient = np.zeros((height, width))
for i in range(height):
gradient[i, :] = i # Vertical gradient
# Create checkerboard pattern
checkerboard = np.zeros((height, width))
for i in range(0, height, 10):
for j in range(0, width, 10):
if (i // 10 + j // 10) % 2 == 0:
checkerboard[i:i+10, j:j+10] = 255
# Create circle pattern
circle = np.zeros((height, width))
center_x, center_y = width // 2, height // 2
radius = 30
for i in range(height):
for j in range(width):
if (i - center_y) ** 2 + (j - center_x) ** 2 <= radius ** 2:
circle[i, j] = 255
# Display image
plt.figure(figsize=(12, 4))
plt.subplot(1, 3, 1)
plt.imshow(gradient, cmap='gray')
plt.title('Gradient image')
plt.axis('off')
plt.subplot(1, 3, 2)
plt.imshow(checkerboard, cmap='gray')
plt.title('Checkerboard pattern')
plt.axis('off')
plt.subplot(1, 3, 3)
plt.imshow(circle, cmap='gray')
plt.title('Circle pattern')
plt.axis('off')
plt.tight_layout()
plt.show()
# Image data information
print(f"Gradient image shape: {gradient.shape}")
print(f"Data type: {gradient.dtype}")
print(f"Pixel value range: {gradient.min()} - {gradient.max()}")
return gradient, checkerboard, circle
# Run example
gradient_img, checkerboard_img, circle_img = grayscale_image_example()
2. Color image
Example
def color_image_example():
"""Color image example"""
print("\n=== Color image example ===")
height, width = 100, 100
# Create RGB color image
# Red gradient
red_gradient = np.zeros((height, width, 3), dtype=np.uint8)
red_gradient[:, :, 0] = np.linspace(0, 255, width) # Red channel gradient
# Green gradient
green_gradient = np.zeros((height, width, 3), dtype=np.uint8)
green_gradient[:, :, 1] = np.linspace(0, 255, width) # Green channel gradient
# Blue gradient
blue_gradient = np.zeros((height, width, 3), dtype=np.uint8)
blue_gradient[:, :, 2] = np.linspace(0, 255, width) # Blue channel gradient
# Rainbow pattern
rainbow = np.zeros((height, width, 3), dtype=np.uint8)
for i in range(width):
hue = i / width
# Simplified HSV to RGB conversion
if hue < 1/3:
rainbow[:, i] = [255 * (1 - 3*hue), 255 * 3*hue, 0]
elif hue < 2/3:
rainbow[:, i] = [0, 255 * (2 - 3*hue), 255 * (3*hue - 1)]
else:
rainbow[:, i] = [255 * (3*hue - 2), 0, 255 * (3 - 3*hue)]
# Display image
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.imshow(red_gradient)
plt.title('Red gradient')
plt.axis('off')
plt.subplot(2, 2, 2)
plt.imshow(green_gradient)
plt.title('Green gradient')
plt.axis('off')
plt.subplot(2, 2, 3)
plt.imshow(blue_gradient)
plt.title('Blue gradient')
plt.axis('off')
plt.subplot(2, 2, 4)
plt.imshow(rainbow)
plt.title('Rainbow pattern')
plt.axis('off')
plt.tight_layout()
plt.show()
# Image channel information
print(f"Color image shape: {rainbow.shape}")
print(f"Data type: {rainbow.dtype}")
print(f"Pixel value range: {rainbow.min()} - {rainbow.max()}")
return red_gradient, green_gradient, blue_gradient, rainbow
# Run example
red_img, green_img, blue_img, rainbow_img = color_image_example()
Image data processing methods
Example
# Image data processing methods
from skimage import filters, feature, measure, transform
from skimage.color import rgb2gray, rgb2hsv
class ImageDataProcessor:
def __init__(self):
pass
def resize_image(self, image, target_size):
"""Resize image"""
from skimage.transform import resize
return resize(image, target_size, anti_aliasing=True)
def normalize_image(self, image):
"""Image normalization"""
return (image - image.min()) / (image.max() - image.min())
def extract_color_features(self, image):
"""Extract color features"""
if len(image.shape) == 3: # Color image
# Calculate statistical features for each channel
features = {}
for i, channel in enumerate(['R', 'G', 'B']):
channel_data = image[:, :, i]
features[f'{channel}_mean'] = np.mean(channel_data)
features[f'{channel}_std'] = np.std(channel_data)
features[f'{channel}_min'] = np.min(channel_data)
features[f'{channel}_max'] = np.max(channel_data)
# Calculate color histogram features
hist_r, _ = np.histogram(image[:, :, 0], bins=256, range=(0, 256))
hist_g, _ = np.histogram(image[:, :, 1], bins=256, range=(0, 256))
hist_b, _ = np.histogram(image[:, :, 2], bins=256, range=(0, 256))
features.update({
'hist_r_peak': np.argmax(hist_r),
'hist_g_peak': np.argmax(hist_g),
'hist_b_peak': np.argmax(hist_b)
})
return features
else: # Grayscale image
return {
'mean': np.mean(image),
'std': np.std(image),
'min': np.min(image),
'max': np.max(image)
}
def extract_texture_features(self, image):
"""Extract texture features"""
if len(image.shape) == 3:
image = rgb2gray(image)
# Calculate edge features
edges = filters.sobel(image)
edge_density = np.sum(edges > 0) / edges.size
# Calculate local binary pattern (simplified version)
lbp = feature.local_binary_pattern(image, P=8, R=1, method='uniform')
lbp_hist, _ = np.histogram(lbp.ravel(), bins=10)
return {
'edge_density': edge_density,
'lbp_hist': lbp_hist.tolist()
}
def augment_image(self, image):
"""Image augmentation"""
augmented = []
# Original image
augmented.append(image)
# Horizontal flip
augmented.append(np.fliplr(image))
# Vertical flip
augmented.append(np.flipud(image))
# Rotate 90 degrees
augmented.append(np.rot90(image))
# Brightness adjustment
if len(image.shape) == 3:
brightened = np.clip(image * 1.2, 0, 255).astype(np.uint8)
else:
brightened = np.clip(image * 1.2, 0, 1)
augmented.append(brightened)
return augmented
def visualize_image_channels(self, image):
"""Visualize image channels"""
if len(image.shape) == 3:
plt.figure(figsize=(12, 3))
plt.subplot(1, 4, 1)
plt.imshow(image)
plt.title('Original image')
plt.axis('off')
plt.subplot(1, 4, 2)
plt.imshow(image[:, :, 0], cmap='Reds')
plt.title('Red channel')
plt.axis('off')
plt.subplot(1, 4, 3)
plt.imshow(image[:, :, 1], cmap='Greens')
plt.title('Green channel')
plt.axis('off')
plt.subplot(1, 4, 4)
plt.imshow(image[:, :, 2], cmap='Blues')
plt.title('Blue channel')
plt.axis('off')
plt.tight_layout()
plt.show()
# Usage example
image_processor = ImageDataProcessor()
# Extract color features
color_features = image_processor.extract_color_features(rainbow_img)
print("\nColor features: ")
for key, value in color_features.items():
if not key.startswith('hist'):
print(f"{key}: {value:.2f}")
# Extract texture features
texture_features = image_processor.extract_texture_features(checkerboard_img)
print("\nTexture features: ")
for key, value in texture_features.items():
if key != 'lbp_hist':
print(f"{key}: {value:.4f}")
# Image augmentation
augmented_images = image_processor.augment_image(circle_img)
print(f"\nImage augmentation: generated {len(augmented_images)} variants")
# Visualize image channels
image_processor.visualize_image_channels(rainbow_img)
Categorical Data
What is categorical data?
Categorical data is like classification labels, representing different categories or groups, and cannot undergo mathematical operations.
Classification of categorical data
1. Nominal data
Example
def nominal_data_example():
"""Nominal data example"""
print("\n=== Nominal data example ===")
# Create nominal data
nominal_data = pd.DataFrame({
'Student ID': range(1, 11),
'Name': ['Zhang San', 'Li Si', 'Wang Wu', 'Zhao Liu', 'Qian Qi', 'Sun Ba', 'Zhou Jiu', 'Wu Shi', 'Zheng Shiyi', 'Chen Shier'],
'Gender': ['Male', 'Female', 'Male', 'Male', 'Female', 'Female', 'Male', 'Female', 'Male', 'Female'],
'Blood type': ['A', 'B', 'O', 'AB', 'A', 'B', 'O', 'AB', 'A', 'O'],
'City': ['Beijing', 'Shanghai', 'Guangzhou', 'Shenzhen', 'Beijing', 'Shanghai', 'Guangzhou', 'Shenzhen', 'Beijing', 'Shanghai'],
'Major': ['Computer Science', 'Mathematics', 'Physics', 'Chemistry', 'Computer Science', 'Mathematics', 'Physics', 'Chemistry', 'Computer Science', 'Mathematics']
})
print("Nominal data example:")
print(nominal_data)
# Categorical statistical analysis
print("\n=== Categorical Statistical Analysis ===)
for column in nominal_data.select_dtypes(include=['object']).columns:
if column != 'Name': # Skip name column
value_counts = nominal_data[column].value_counts()
print(f"\n{column} distribution:")
print(value_counts)
print(f"Number of unique values: {len(value_counts)}")
return nominal_data
# Run example
nominal_df = nominal_data_example()
2. Ordinal data
Example
def ordinal_data_example():
"""Ordinal data example"""
print("\n=== Ordinal Data Example ===)
# Create ordinal data
ordinal_data = pd.DataFrame({
'Product ID': range(1, 11),
'Product Name': [f'Product {i}' for i in range(1, 11)],
'Quality Rating': ['Excellent', 'Good', 'Average', 'Excellent', 'Good', 'Average', 'Poor', 'Excellent', 'Good', 'Average'],
'Customer Satisfaction': ['Very Satisfied', 'Satisfied', 'Neutral', 'Very Satisfied', 'Satisfied', 'Neutral', 'Dissatisfied', 'Very Satisfied', 'Satisfied', 'Neutral'],
'Price Range': ['High', 'Medium', 'Low', 'High', 'Medium', 'Low', 'Low', 'High', 'Medium', 'Medium'],
'Sales Ranking': [1, 3, 5, 2, 4, 7, 9, 6, 8, 10]
})
print("Ordinal data example:")
print(ordinal_data)
# Ordinal data statistical analysis
print("\n=== Ordinal Data Statistical Analysis ===)
# Define order
quality_order = ['Poor', 'Average', 'Good', 'Excellent']
satisfaction_order = ['Dissatisfied', 'Neutral', 'Satisfied', 'Very Satisfied']
price_order = ['Low', 'Medium', 'High']
# Convert to ordinal categories
ordinal_data['quality_rating_ordered'] = pd.Categorical(
ordinal_data['quality_rating'], categories=quality_order, ordered=True
)
ordinal_data['customer_satisfaction_ordered'] = pd.Categorical(
ordinal_data['customer_satisfaction'], categories=satisfaction_order, ordered=True
)
ordinal_data['price_range_ordered'] = pd.Categorical(
ordinal_data['price_range'], categories=price_order, ordered=True
)
# Statistical analysis
for column in ['quality_rating_ordered', 'customer_satisfaction_ordered', 'price_range_ordered']:
print(f"\n{column} distribution:")
value_counts = ordinal_data[column].value_counts().sort_index()
print(value_counts)
# Calculate median
median_value = ordinal_data[column].median()
print(f"Median: {median_value}")
return ordinal_data
# Run example
ordinal_df = ordinal_data_example()
Categorical data processing methods
Example
# Categorical data processing methods
from sklearn.preprocessing import LabelEncoder, OneHotEncoder, OrdinalEncoder
class CategoricalDataProcessor:
def __init__(self):
self.encoders = {}
self.feature_names = {}
def label_encoding(self, data, columns):
"""Label Encoding"""
encoded_data = data.copy()
for column in columns:
encoder = LabelEncoder()
encoded_data[f'{column}_encoded'] = encoder.fit_transform(data[column])
self.encoders[f'{column}_label'] = encoder
print(f"{column} label encoding:")
for i, category in enumerate(encoder.classes_):
print(f" {category} -> {i}")
return encoded_data
def one_hot_encoding(self, data, columns):
"""One-Hot Encoding"""
encoded_data = data.copy()
for column in columns:
encoder = OneHotEncoder(sparse=False, drop='first') # Avoid multicollinearity
encoded_features = encoder.fit_transform(data[[column]])
# Create new column names
feature_names = [f'{column}_{category}' for category in encoder.categories_[0][1:]]
# Add to DataFrame
for i, feature_name in enumerate(feature_names):
encoded_data[feature_name] = encoded_features[:, i]
self.encoders[f'{column}_onehot'] = encoder
self.feature_names[f'{column}_onehot'] = feature_names
print(f"{column} one-hot encoding: created {len(feature_names)} features")
return encoded_data
def ordinal_encoding(self, data, columns, categories_list):
"""Ordinal Encoding"""
encoded_data = data.copy()
for column, categories in zip(columns, categories_list):
encoder = OrdinalEncoder(categories=[categories])
encoded_data[f'{column}_ordinal'] = encoder.fit_transform(data[[column]])
self.encoders[f'{column}_ordinal'] = encoder
print(f"{column} ordinal encoding:")
for i, category in enumerate(categories):
print(f" {category} -> {i}")
return encoded_data
def target_encoding(self, data, categorical_column, target_column):
"""Target Encoding"""
encoded_data = data.copy()
# Calculate target mean for each category
target_means = data.groupby(categorical_column)[target_column].mean()
# Apply encoding
encoded_data[f'{categorical_column}_target'] = data[categorical_column].map(target_means)
print(f"{categorical_column} target encoding:")
for category, mean_value in target_means.items():
print(f" {category} -> {mean_value:.4f}")
return encoded_data
def frequency_encoding(self, data, columns):
"""Frequency Encoding"""
encoded_data = data.copy()
for column in columns:
# Calculate frequency for each category
frequency = data[column].value_counts(normalize=True)
# Apply encoding
encoded_data[f'{column}_frequency'] = data[column].map(frequency)
print(f"{column} frequency encoding:")
for category, freq in frequency.head().items():
print(f" {category} -> {freq:.4f}")
return encoded_data
def analyze_categorical_importance(self, data, categorical_columns, target_column):
"""Analyze categorical feature importance"""
importance_scores = {}
for column in categorical_columns:
# Calculate the target mean difference for each category
category_means = data.groupby(column)[target_column].mean()
mean_difference = category_means.max() - category_means.min()
# Calculate the number of categories
unique_count = data[column].nunique()
# Simple importance score
importance = mean_difference * np.log(unique_count + 1)
importance_scores[column] = importance
# Sort
sorted_importance = sorted(importance_scores.items(), key=lambda x: x[1], reverse=True)
print("\nCategorical feature importance:")
for column, importance in sorted_importance:
print(f"{column}: {importance:.4f}")
return importance_scores
# Usage example
cat_processor = CategoricalDataProcessor()
# Add numeric target for nominal data
nominal_df_with_target = nominal_df.copy()
nominal_df_with_target['Score'] = np.random.randint(60, 100, len(nominal_df))
# Label encoding
label_encoded = cat_processor.label_encoding(
nominal_df_with_target, ['Gender', 'Blood Type', 'City']
)
# One-hot encoding
onehot_encoded = cat_processor.one_hot_encoding(
nominal_df_with_target, ['Major']
)
# Target encoding
target_encoded = cat_processor.target_encoding(
nominal_df_with_target, 'City', 'Score'
)
# Frequency encoding
frequency_encoded = cat_processor.frequency_encoding(
nominal_df_with_target, ['Gender', 'Blood Type']
)
# Analyze feature importance
importance_scores = cat_processor.analyze_categorical_importance(
nominal_df_with_target, ['Gender', 'Blood Type', 'City', 'Major'], 'Score'
)
Multimodal Data Fusion
Data type fusion example
Example
class MultiModalDataProcessor:
def __init__(self):
self.numeric_processor = NumericDataProcessor()
self.text_processor = TextDataProcessor()
self.image_processor = ImageDataProcessor()
self.categorical_processor = CategoricalDataProcessor()
def create_multimodal_dataset(self):
"""Create multimodal dataset"""
print("\n=== Multimodal Dataset Example ===)
n_samples = 100
# Numeric features
numeric_features = {
'Age': np.random.randint(18, 65, n_samples),
'Income': np.random.normal(50000, 15000, n_samples),
'Work Experience': np.random.randint(0, 20, n_samples)
}
# Categorical features
categorical_features = {
'Gender': np.random.choice(['Male', 'Female'], n_samples),
'Education Level': np.random.choice(['High School', "Bachelor's", "Master's", 'PhD'], n_samples),
'City': np.random.choice(['Beijing', 'Shanghai', 'Guangzhou', 'Shenzhen'], n_samples)
}
# Text features
text_features = [
f"This is the text description of sample {i}, containing some basic information and features."
for i in range(n_samples)
]
# Image features (simulated)
image_features = np.random.rand(n_samples, 64, 64, 3) # Simulate 64x64 color images
# Target variable
target = np.random.choice([0, 1], n_samples)
# Create dataset
dataset = {
'numeric': pd.DataFrame(numeric_features),
'categorical': pd.DataFrame(categorical_features),
'text': text_features,
'image': image_features,
'target': target
}
print(f"Dataset size: {n_samples}")
print(f"Numeric features: {list(numeric_features.keys())}")
print(f"Categorical features: {list(categorical_features.keys())}")
print(f"Text features: {len(text_features)} entries")
print(f"Image features: {image_features.shape}")
print(f"Target variable: {np.bincount(target)}")
return dataset
def process_multimodal_data(self, dataset):
"""Process multimodal data"""
print("\n=== Multimodal Data Processing ===)
processed_features = {}
# Process numeric features
numeric_data = dataset['numeric']
numeric_processed = self.numeric_processor.normalize_data(numeric_data, method='standard')
processed_features['numeric'] = numeric_processed
# Process categorical features
categorical_data = dataset['categorical']
categorical_processed = self.categorical_processor.one_hot_encoding(
categorical_data, list(categorical_data.columns)
)
# Keep only encoded columns
categorical_encoded = categorical_processed.select_dtypes(include=[np.number])
processed_features['categorical'] = categorical_encoded
# Process text features
text_data = dataset['text']
text_features, _ = self.text_processor.extract_features(text_data, method='tfidf')
processed_features['text'] = text_features
# Process image features
image_data = dataset['image']
# Extract simple image features (mean, standard deviation, etc.)
image_features = []
for img in image_data:
features = self.image_processor.extract_color_features(img)
feature_vector = list(features.values())[:10] # Take the first 10 features
image_features.append(feature_vector)
processed_features['image'] = np.array(image_features)
# Print processing results
for modality, features in processed_features.items():
if isinstance(features, pd.DataFrame):
print(f"{modality} features: {features.shape}")
else:
print(f"{modality} features: {features.shape}")
return processed_features
def fuse_features(self, processed_features):
"""Feature Fusion"""
print("\n=== Feature Fusion ===)
# Merge all features
feature_arrays = []
for modality, features in processed_features.items():
if isinstance(features, pd.DataFrame):
feature_arrays.append(features.values)
else:
feature_arrays.append(features)
# Horizontal concatenation
fused_features = np.hstack(feature_arrays)
print(f"Fused feature shape: {fused_features.shape}")
return fused_features
# Usage example
multimodal_processor = MultiModalDataProcessor()
# Create multimodal dataset
multimodal_dataset = multimodal_processor.create_multimodal_dataset()
# Process multimodal data
processed_multimodal = multimodal_processor.process_multimodal_data(multimodal_dataset)
# Feature fusion
fused_features = multimodal_processor.fuse_features(processed_multimodal)