Conceptos de MLOps
Imagina que eres un científico de datos y, tras semanas de esfuerzo, finalmente has entrenado un modelo de aprendizaje automático con un rendimiento excelente en el conjunto de prueba. Con entusiasmo, entregas estemodel.pklarchivo a un colega ingeniero de software. Sin embargo, los problemas no se hacen esperar: ¿cómo puede este modelo funcionar de manera estable en un servidor que procesa millones de solicitudes al día? ¿Cómo monitorear si su rendimiento con datos reales está decayendo? Cuando lleguen nuevos datos, ¿cómo se puede reentrenar y actualizar el modelo automáticamente?
Esta escena revela un desafío central en los proyectos de aprendizaje automático:cómo transformar el código de modelos de carácter experimental en un sistema de producción confiable que genere valor continuo para el negocio. MLOps nació precisamente como un conjunto de conceptos y prácticas para resolver esta brecha.
En pocas palabras, MLOps esMachine LearningyDevOpsla combinación de. Toma prestadas las ideas de automatización, colaboración y monitoreo de DevOps en el desarrollo de software, y las aplica a la gestión del ciclo de vida de los sistemas de aprendizaje automático, con el objetivo de lograrel desarrollo eficiente, el despliegue confiable y la operación continua de los modelos de ML.。
¿Qué es MLOps?
Definición esencial
MLOps es un conjunto de prácticas de ingeniería paraestandarizar y automatizarlos distintos pasos del ciclo de vida de los sistemas de aprendizaje automático, incluyendo:
- desarrollo y experimentación de modelos
- entrenamiento y evaluación continuos de modelos
- despliegue y servicio de modelos
- monitoreo, mantenimiento e iteración en entornos de producción
Su objetivo final esconstruir flujos de trabajo de aprendizaje automático reproducibles, escalables, auditables y con una colaboración eficiente, para que los modelos puedan pasar del laboratorio a la producción de forma rápida y segura, y mantener su valor de manera continua.
Una analogía sencilla: comparación con DevOps
Para entenderlo mejor, podemos comparar MLOps con DevOps, que es más familiar para todos:
| Aspecto | DevOps (desarrollo de software tradicional) | MLOps (desarrollo de sistemas de aprendizaje automático) |
|---|---|---|
| Producto principal | Aplicación / servicio | Modelo de aprendizaje automático + su entorno de ejecución |
| Objeto de iteración | Código | Código + datos + modelo |
| Enfoque de pruebas | Pruebas funcionales, pruebas de integración | Pruebas de rendimiento del modelo, validación de datos, detección de deriva de conceptos |
| Unidad de despliegue | Ejecutable / imagen de contenedor | Archivo de modelo + código de inferencia + entorno de dependencias específico |
| Métricas de monitoreo | Uso de CPU/memoria, latencia de solicitudes, tasa de errores | Calidad de las predicciones del modelo (por ejemplo, precisión), distribución de los datos de entrada, métricas de negocio |
Esta comparación revela la complejidad única de MLOps: no solo gestiona el código, sino tambiénlos datosylos modelosestos dos elementos dinámicos y cambiantes.
¿Por qué se necesita MLOps?
Los proyectos de aprendizaje automático sin MLOps suelen caer en el "purgatorio de los prototipos" —el modelo se queda para siempre en la fase experimental y no logra generar un impacto real. MLOps rompe este estancamiento resolviendo los siguientes problemas clave:
1. Desafíos de colaboración y reproducibilidad
- Problema: los científicos de datos experimentan en Jupyter Notebook, con dependencias de entorno desordenadas y pasos de experimento irreproducibles.
- Enfoque de MLOps: usar control de versiones (como Git) para gestionar el código, versiones de datos (como DVC) y versiones de modelos; contenerización (como Docker) para fijar el entorno, garantizando que cualquier experimento pueda reproducirse con precisión.
2. Complejidad del despliegue y la operación
- Problema: el despliegue manual de modelos es un proceso tedioso y propenso a errores; el servicio de modelos es difícil de escalar y carece de monitoreo.
- Enfoque de MLOps: automatizar los pipelines de CI/CD para desplegar el modelo como un servicio API con un solo clic; utilizar tecnologías nativas de la nube para lograr un escalado elástico; y crear paneles de monitoreo integrales.
3. Degradación del rendimiento del modelo
- Problema: la distribución de los datos en el entorno de producción cambia con el tiempo (deriva de conceptos), lo que hace que el rendimiento del modelo se degrade silenciosamente sin que nadie lo note.
- Enfoque de MLOps: monitorear continuamente el rendimiento de las predicciones y la distribución de los datos de entrada, configurar alertas automáticas y activar el proceso de reentrenamiento del modelo.
4. Necesidades de gobernanza y cumplimiento
- Problema: no se puede rastrear qué versión del modelo realizó una predicción ni sobre qué datos se basó, lo que dificulta cumplir con los requisitos de auditoría y normativa.
- Enfoque de MLOps: seguimiento de versiones de principio a fin, registro de experimentos y trazabilidad de los resultados de las predicciones.
Componentes clave y flujo de trabajo de MLOps
Un sistema MLOps típico incluye múltiples componentes que colaboran entre sí, y su flujo de trabajo puede visualizarse como un ciclo:
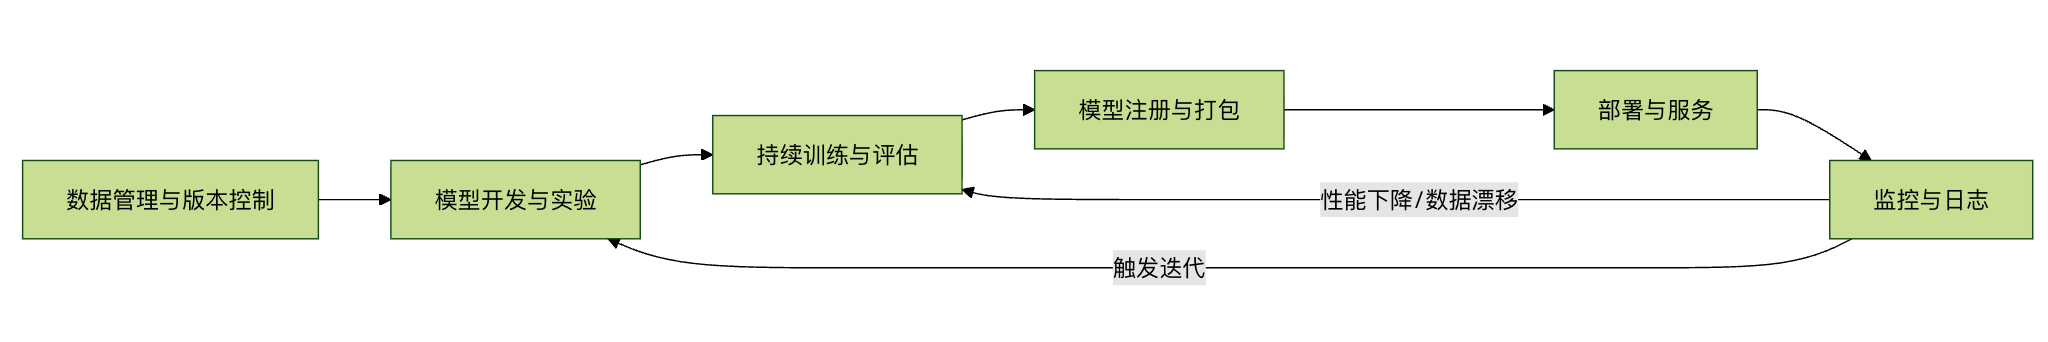
A continuación desglosamos cada uno de los pasos clave del diagrama:
1. Gestión de datos y control de versiones
Esta es la base de MLOps. A diferencia del código, los archivos de datos suelen ser muy grandes y cambian constantemente.
- Práctica: usar herramientas comoDVC (Data Version Control)oLakeFSy otras, que gestionan los datos y los archivos de modelos de la misma manera que Git gestiona el código. Estas herramientas almacenan los metadatos de las versiones de los datos, mientras que los archivos reales pueden guardarse en el almacenamiento en la nube.
- Ejemplo: cada experimento puede asociarse a un snapshot de datos específico, garantizando la reproducibilidad de los resultados.
2. Desarrollo y experimentación de modelos
Este es el campo principal de los científicos de datos, pero requiere estándares de ingeniería.
- Práctica: refactorizar el código de experimentación de Notebook a scripts de Python modulares; usarMLflow TrackingoWeights & Biasespara registrar los hiperparámetros, las métricas y los modelos generados en cada experimento, facilitando la comparación.
3. Entrenamiento y evaluación continuos
Cuando llegan nuevos datos o se detecta una caída en el rendimiento, el sistema debe poder reentrenar el modelo automática o semiautomáticamente.
- Práctica: construir un pipeline de entrenamiento automatizado (por ejemplo, usandoKubeflow PipelinesoApache Airflow). El pipeline incluye validación de datos, ingeniería de características, entrenamiento del modelo y evaluación (en elconjunto de validación diferente del conjunto de entrenamiento) y otros pasos. Solo los modelos que alcanzan el estándar de evaluación pueden pasar a la siguiente etapa.
4. Registro y empaquetado de modelos
Los modelos entrenados deben gestionarse adecuadamente y prepararse para el despliegue.
- Práctica: usarun registro central de modelos(por ejemplo, MLflow Model Registry). Este almacena, anota y gestiona el modelo como un activo versionable. El modelo generalmente se empaqueta junto con el código de inferencia enuna imagen de contenedor Docker, para garantizar la consistencia del entorno de producción.
5. Despliegue y servicio
Poner el modelo a disposición de los usuarios u otros sistemas.
- Modos:
- Predicción por lotes: realizar predicciones periódicamente sobre grandes volúmenes de datos y generar informes.
- Servicio API en tiempo real: el modelo actúa como un servicio REST API o gRPC que responde a las solicitudes en tiempo real. Las herramientas comunes incluyenFastAPI, TensorFlow Serving, TorchServeo los servicios gestionados de los proveedores de la nube.
- Estrategia: se pueden adoptarel despliegue azul-verdeoel lanzamiento canario, migrando gradualmente el tráfico al nuevo modelo para reducir el riesgo.
6. Monitoreo y registros
Estos son los "ojos" que garantizan el funcionamiento saludable del modelo en producción.
- Contenido del monitoreo:
- Métricas del sistema: latencia de API, rendimiento, tasa de errores, uso de recursos.
- Métricas del modelo: distribución de los resultados de las predicciones, cambios en las características importantes (detección de deriva de datos).
- Métricas de negocio: el impacto empresarial final de las decisiones del modelo (por ejemplo, tasa de clics, tasa de conversión).
- Práctica: integrar herramientas de monitoreo (comoPrometheus, Grafana) y sistemas de registro (comoELK Stack), y configurar reglas de alerta para las métricas clave.
Un ejemplo práctico simplificado de MLOps
Veamos, a través de un flujo de código conceptual, cómo usar MLflow, una herramienta popular, para implementar el seguimiento de experimentos, el registro y el empaquetado de modelos.
Ejemplo
import mlflow
import mlflow.sklearn
from sklearn.datasets import load_iris
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# 2. Configurar el servidor de seguimiento de MLflow (asumiendo que ya se está ejecutando localmente)
mlflow.set_tracking_uri("http://127.0.0.1:5000")
mlflow.set_experiment("Iris_Classification")
# 3. Iniciar una ejecución de experimento
with mlflow.start_run():
# Cargar los datos y dividirlos
data = load_iris()
X_train, X_test, y_train, y_test = train_test_split(data.data, data.target, test_size=0.2)
# Definir y entrenar el modelo
n_estimators = 100
model = RandomForestClassifier(n_estimators=n_estimators, random_state=42)
model.fit(X_train, y_train)
# Predicción y evaluación
y_pred = model.predict(X_test)
acc = accuracy_score(y_test, y_pred)
# 4. Registrar la información del experimento en el servidor de seguimiento de MLflow
mlflow.log_param("n_estimators", n_estimators) # Registrar los hiperparámetros
mlflow.log_metric("accuracy", acc) # Registrar las métricas de evaluación
# 5. Registrar el modelo en sí (incluyendo su entorno de dependencias)
# mlflow.sklearn.log_model registrará el modelo y generará un archivo de entorno conda.yaml
mlflow.sklearn.log_model(model, "random_forest_model")
print(f"Entrenamiento del modelo completado, precisión: {acc:.4f}")
print(f"Experimento registrado, puedes verlo en la interfaz de MLflow (http://127.0.0.1:5000).")
# 6. (Pasos posteriores) En la interfaz de MLflow, puedes "registrar" este modelo guardado en el Model Registry.
# 7. Luego, puedes obtener el modelo del Registry y empaquetarlo como una imagen de Docker usando el comando `mlflow models build-docker`.
# 8. Finalmente, despliega esta imagen en Kubernetes o en un servidor en la nube para proporcionar el servicio.
Explicación del código:
- Este ejemplo muestra, en MLOps,el seguimiento de experimentos,yel registro de modelos,como eslabones centrales.
mlflow.log_paramymlflow.log_metricEsto asegura la trazabilidad de los experimentos.mlflow.sklearn.log_modelNo solo guarda el archivo del modelo, sino que también registra automáticamente las versiones de las bibliotecas de Python (entorno) que crearon el modelo, un paso clave para lograr la reproducibilidad.- Los pasos posteriores de registro, empaquetado y despliegue se completan normalmente en la interfaz de usuario o mediante un pipeline de CI/CD.
Niveles de madurez de MLOps
La implementación de MLOps no se logra de la noche a la mañana; generalmente se consideran tres etapas evolutivas:
- Nivel básico de MLOps (proceso manual): Los procesos de despliegue y entrenamiento se activan manualmente y el monitoreo es limitado. Este es el punto de partida de muchos equipos.
- Nivel intermedio de MLOps (pipeline automatizado): Se implementa laintegración continua (CI)yy entrega continua (CD)del entrenamiento y despliegue de modelos, con un alto grado de automatización.
- Nivel avanzado de MLOps (entrenamiento continuo CT): El sistema cuenta con un ciclo completo de monitoreo y retroalimentación automatizado, capaz de activar automáticamente la recopilación de datos, el reentrenamiento, la evaluación y el despliegue, logrando un verdaderoentrenamiento continuo (Continuous Training)。
Resumen y perspectivas
MLOps no es una herramienta específica, sino unmarco integral que abarca cultura, procesos y tecnología. Requiere una estrecha colaboración entre científicos de datos, ingenieros de aprendizaje automático e ingenieros de operaciones.
Para principiantes, comprender el concepto de MLOps es el primer paso para construir sistemas de aprendizaje automático confiables. Puedes comenzar con las siguientes prácticas:
- Usar Git para un control estricto de versiones del código。
- Probar MLflow para gestionar tus experimentos y modelos。
- Poner el modelo en servicio, por ejemplo, escribir una API de predicción simple con FastAPI.
- Pensar en cómo monitorear los resultados de predicción de tus modelos。
A medida que el aprendizaje automático se aplica cada vez más en la industria, MLOps se ha convertido en una capacidad de ingeniería clave para garantizar que los proyectos de aprendizaje automático sean exitosos, controlables y escalables. Dominar el pensamiento de MLOps puede ayudarte a transformar los modelos en tus manos, de un cristal brillante en el laboratorio, a un motor estable que impulse el crecimiento del negocio.
Otras extensiones