Aprendizaje automático - Caso de visualización de PCA
Imagina que estás ordenando una habitación desordenada llena de objetos diversos. Para comprender mejor la distribución de la habitación, podrías tomar varias fotografías desde diferentes ángulos (por ejemplo, frontal, lateral y cenital).
Análisis de Componentes Principales (Principal Component Analysis, abreviado como PCA)Hace algo similar en el aprendizaje automático.
PCA es una poderosareducción de dimensionalidadyvisualizaciónherramienta. Cuando nuestros datos contienen cientos o miles de características (dimensiones), estos datos se encuentran en un espacio de altísima dimensionalidad que los seres humanos no pueden comprender de forma intuitiva.
PCA nos ayuda a encontrar la perspectiva más importante de los datos (es decir, los componentes principales), proyectando los datos en las dos o tres dimensiones más importantes, lo que nos permite observar la estructura y la distribución de datos de alta dimensionalidad mediante diagramas de dispersión bidimensionales o tridimensionales.
En pocas palabras, los objetivos de PCA son:
- Reducción de dimensionalidad: representar los datos originales con menos características, reduciendo el costo computacional y el espacio de almacenamiento, y eliminando el ruido.
- Visualización: reducir los datos de alta dimensionalidad a 2 o 3 dimensiones para que podamos observar intuitivamente las relaciones entre los puntos de datos (como agrupamientos o separaciones).
Principios fundamentales y flujo de trabajo de PCA
La idea central de PCA es encontrar las direcciones de máxima varianza en los datos.
Cuanto mayor es la varianza, más dispersos están los puntos proyectados en esa dirección y mayor es la cantidad de información que contienen.
La primera dirección encontrada es elprimer componente principal (PC1), y la segunda dirección ortogonal a PC1 con la segunda mayor varianza es elsegundo componente principal (PC2), y así sucesivamente.
Diagrama de flujo de trabajo de PCA
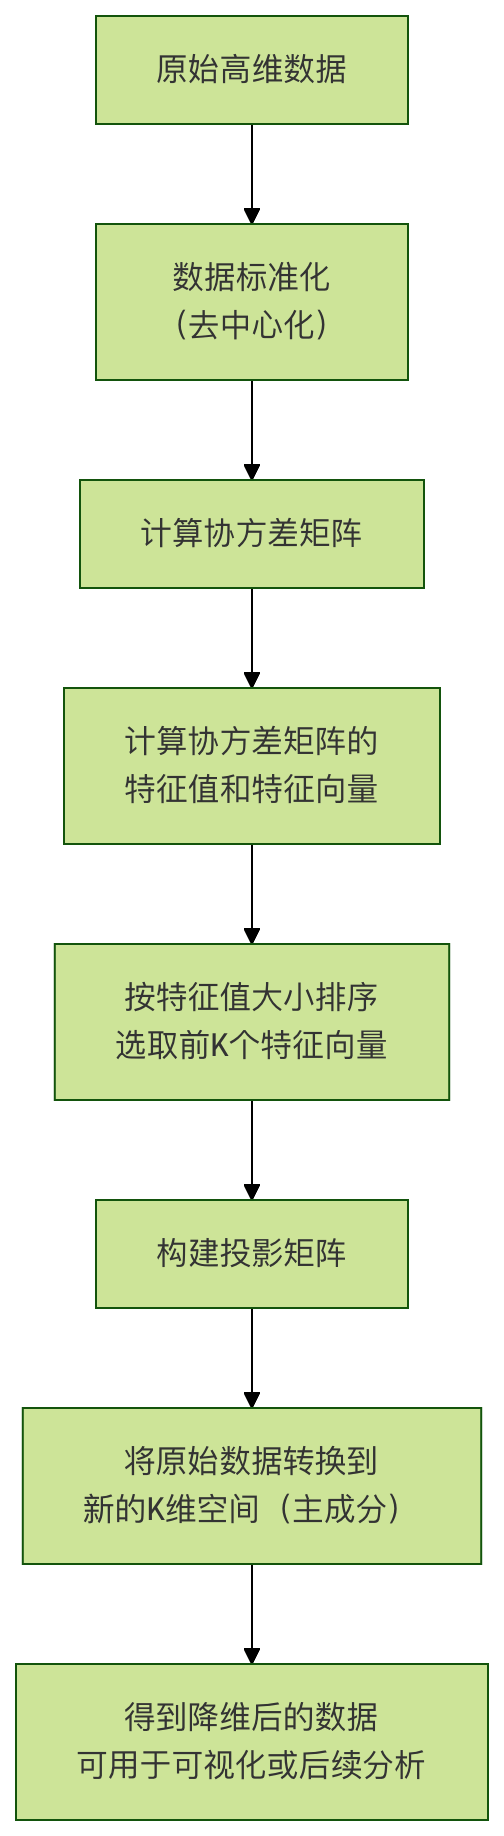
Explicación de los pasos clave del proceso:
Estandarización: hacer que cada característica tenga una media de 0 y una desviación estándar de 1, para garantizar que todas las características tengan la misma importancia en el cálculo.
Matriz de covarianza: calcula la correlación entre características. PCA analiza esta matriz para encontrar las direcciones principales de variación de los datos.
Valores propios y vectores propios:
- Vectores propios: son las direcciones de los componentes principales que buscamos.
- Valores propios: corresponden a la magnitud de la varianza de los datos en la dirección del vector propio. Cuanto mayor es el valor propio, más importante es ese componente principal.
Selección de componentes principales: ordenamos los valores propios de mayor a menor y seleccionamos los vectores propios correspondientes a los K valores propios más grandes. K es la dimensión objetivo a la que queremos reducir (por ejemplo, para visualización, K=2 o 3).
Transformación de datos: formamos una matriz de proyección con los K vectores propios seleccionados; al multiplicar los datos originales por esta matriz, obtenemos las coordenadas en los K nuevos componentes principales, es decir, los datos reducidos de dimensionalidad.
Caso práctico: Visualización del conjunto de datos Iris
Usaremos el clásicoconjunto de datos Irispara demostrar PCA. Este conjunto de datos contiene 150 muestras, cada una con 4 características (longitud del sépalo, ancho del sépalo, longitud del pétalo, ancho del pétalo), y pertenecen a 3 variedades diferentes.
Nuestro objetivo es: reducir estos datos de 4 dimensiones a 2 dimensiones con PCA y trazarlos en un plano bidimensional para observar si las flores de diferentes variedades pueden distinguirse.
Preparación del entorno y carga de datos
Primero, asegúrate de tener instaladas las bibliotecas de Python necesarias:scikit-learn, matplotlib, numpy,pandas。
Ejemplo
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler
# Configurar la fuente china y el estilo del gráfico (opcional)
plt.rcParams['font.sans-serif'] = ['SimHei'] # Para mostrar correctamente las etiquetas en chino
plt.rcParams['axes.unicode_minus'] = False # Para mostrar correctamente los signos negativos
# Cargar el conjunto de datos Iris
iris = datasets.load_iris()
X = iris.data # Datos de características, forma (150, 4)
y = iris.target # Etiquetas objetivo (variedades), forma (150,)
target_names = iris.target_names # Nombres de las variedades: ['setosa', 'versicolor', 'virginica']
print(f"Forma del conjunto de datos: {X.shape}")
print(f"Nombres de las características: {iris.feature_names}")
print(f"Clases objetivo: {target_names}")
Salida:
数据集形状: (150, 4)
特征名称: ['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)']
目标类别: ['setosa' 'versicolor' 'virginica']
Estandarización de datos
Antes de aplicar PCA, estandarizar los datos es unpaso crucial.
Debido a que PCA es muy sensible a la escala de las características, si el rango de valores de una característica (por ejemplo, la longitud del pétalo en centímetros, con valores entre 1 y 10) es mucho mayor que el de otra (por ejemplo, el ancho del sépalo en milímetros, con valores entre 0.1 y 1), la característica con el rango mayor dominará la dirección de los componentes principales, lo cual normalmente no es lo que deseamos.
Ejemplo
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
print("Datos de las primeras 5 muestras después de la estandarización:")
print(X_scaled[:5])
Aplicar PCA para reducir la dimensionalidad
Usamos lascikit-learndePCAclase, que puede realizar fácilmente todos los cálculos matemáticos.
Ejemplo
pca = PCA(n_components=2)
# Ajustar el modelo PCA sobre los datos estandarizados y realizar la transformación de datos
X_pca = pca.fit_transform(X_scaled)
print(f"Forma de los datos tras la reducción de dimensionalidad: {X_pca.shape}")
print(f"Coordenadas de las primeras 5 muestras en PC1 y PC2:\n{X_pca[:5]}")
# Ver la tasa de varianza explicada de cada componente principal
print(f"Tasa de varianza explicada de los componentes principales: {pca.explained_variance_ratio_}")
print(f"Tasa de varianza explicada acumulada de los dos primeros componentes principales: {sum(pca.explained_variance_ratio_):.4f}")
Análisis del código:
n_components=2: especifica que queremos reducir los datos a 2 dimensiones.
fit_transform(X_scaled): este método realiza dos cosas a la vez:
fit: basándose en los datos de entradaX_scaledcalcula los parámetros necesarios para PCA (como las direcciones de los componentes principales).transform: usando los parámetros calculados, transforma los datosX_scaledal nuevo espacio bidimensional.
explained_variance_ratio_: esta es una propiedad muy importante. Nos indica la proporción de la varianza de los datos originales que captura cada componente principal.proporción de la varianza de los datos originales capturada. Por ejemplo, si la salida es[0.73, 0.23], significa que PC1 conserva el 73% de la información de los datos originales, PC2 conserva el 23%, y juntos conservan el 96%. Esto nos ayuda a evaluar la pérdida de información tras la reducción de dimensionalidad.
Visualización de resultados
Ahora tenemos los datos bidimensionalesX_pca, que podemos visualizar fácilmente con un diagrama de dispersión.
Ejemplo
plt.figure(figsize=(8, 6))
# Establecer diferentes colores y marcadores para cada variedad
colors = ['navy', 'turquoise', 'darkorange']
lw = 2 # Ancho de línea
# Recorrer las tres variedades y trazarlas por separado
for color, i, target_name in zip(colors, [0, 1, 2], target_names):
plt.scatter(X_pca[y == i, 0], # Seleccionar las coordenadas PC1 de las muestras pertenecientes a la variedad actual i
X_pca[y == i, 1], # Seleccionar las coordenadas PC2 de las muestras pertenecientes a la variedad actual i
color=color, alpha=0.8, lw=lw,
label=target_name)
# Añadir el título del gráfico y las etiquetas de los ejes
plt.title('Visualización 2D con PCA del conjunto de datos Iris')
plt.xlabel(f'Primer componente principal (PC1) - Tasa de varianza explicada: {pca.explained_variance_ratio_)
plt.ylabel(f'Segundo componente principal (PC2) - Tasa de varianza explicada: {pca.explained_variance_ratio_)
plt.legend(loc='best', shadow=False, scatterpoints=1)
plt.grid(True, linestyle='--', alpha=0.6)
# Mostrar el gráfico
plt.tight_layout()
plt.show()
Interpretación del resultado de la visualización:Al ejecutar el código anterior, obtendrás un diagrama de dispersión bidimensional.
- Eje X (PC1): representa la dirección de mayor varianza entre las 4 características originales, y es la dimensión más importante para distinguir los datos. En la figura se puede observar que separa muy bien la variedadSetosa (iris setosa)del resto de las otras dos variedades.
- Eje Y (PC2): representa la dirección ortogonal a PC1 con la segunda mayor varianza, y proporciona información adicional para la discriminación. Ayuda a distinguir mejorVersicolor (iris versicolor)yy Virginica (iris virginica)., aunque ambos tienen cierta superposición.
- Conclusión: Mediante PCA, proyectamos exitosamente los datos de 4 dimensiones a un plano de 2 dimensiones y observamos claramente la agrupación de las tres variedades. Setosa está completamente separada, mientras que Versicolor y Virginica se superponen parcialmente en la proyección bidimensional. Esto indica que usar solo los dos primeros componentes principales (que retienen aproximadamente el 95% de la información) no es suficiente para distinguir perfectamente las dos últimas variedades, pero su principal tendencia de distribución ya es muy evidente.
Exploración en profundidad y reflexión
¿Cómo elegir el número de componentes principales (valor K)?
En proyectos reales, es posible que no sepamos a cuántas dimensiones reducir. Un método común es dibujarel gráfico de pedregal (Scree Plot), que muestra la tasa de varianza explicada por cada componente principal.
Ejemplo
pca_full = PCA()
pca_full.fit(X_scaled)
# Dibujar el gráfico de pedregal
plt.figure(figsize=(8, 5))
plt.plot(range(1, len(pca_full.explained_variance_ratio_) + 1),
pca_full.explained_variance_ratio_, 'o-', linewidth=2)
plt.title('Gráfico de pedregal de la tasa de varianza explicada por PCA')
plt.xlabel('Número de componente principal')
plt.ylabel('Tasa de varianza explicada')
plt.grid(True, linestyle='--', alpha=0.6)
plt.xticks(range(1, len(pca_full.explained_variance_ratio_) + 1))
plt.tight_layout()
plt.show()
# Dibujar el gráfico de varianza explicada acumulada
plt.figure(figsize=(8, 5))
plt.plot(range(1, len(pca_full.explained_variance_ratio_) + 1),
np.cumsum(pca_full.explained_variance_ratio_), 's-', linewidth=2, color='red')
plt.title('Varianza explicada acumulada de PCA')
plt.xlabel('Número de componentes principales')
plt.ylabel('Tasa de varianza explicada acumulada')
plt.axhline(y=0.95, color='gray', linestyle='--', label='Umbral del 95%') # Umbral común
plt.legend()
plt.grid(True, linestyle='--', alpha=0.6)
plt.xticks(range(1, len(pca_full.explained_variance_ratio_) + 1))
plt.tight_layout()
plt.show()
¿Cómo elegir el valor de K?
- Observar el punto de inflexión: En el gráfico de pedregal, busca el punto donde la tendencia decreciente de la tasa de varianza explicada se vuelve repentinamente más lenta (es decir, el codo); los componentes posteriores contribuyen poco.
- Establecer un umbral: En el gráfico de varianza acumulada, elige el valor mínimo de K que haga que la tasa de varianza acumulada alcance un umbral satisfactorio (como 95% o 99%). En el gráfico acumulado de los datos de iris, se puede ver que los dos primeros componentes principales ya explican más del 95% de la varianza, por lo que K=2 es una muy buena elección.
Entender el significado de los componentes principales
También podemos observar lascargas (Loadings), es decir, los pesos de contribución de cada característica original a los componentes principales, lo que ayuda a explicar el significado práctico de los componentes principales.
Ejemplo
pca_components = pca.components_ # La forma es (2, 4)
# Mostrar con DataFrame, más claro
df_components = pd.DataFrame(pca_components,
columns=iris.feature_names,
index=['PC1', 'PC2'])
print("Matriz de cargas de componentes principales (vectores propios):")
print(df_components)
# Se puede visualizar con un mapa de calor
import seaborn as sns
plt.figure(figsize=(8, 4))
sns.heatmap(df_components, annot=True, cmap='RdBu_r', center=0)
plt.title('Mapa de calor de cargas de componentes principales')
plt.tight_layout()
plt.show()
Interpretación de la matriz de cargas:
- ParaPC1, si la longitud del pétalo y el ancho del pétalo tienen un peso grandecorrecto, mientras que el ancho del sépalo tiene un peso grandecarga, entonces PC1 puede representar principalmente la característica combinada de la comparación entre el tamaño del pétalo y el ancho del sépalo.
- ParaPC2, el patrón de pesos es diferente; puede representar otra combinación de características. Al analizar estos pesos, podemos dar a los componentes principales abstractos algunos significados biológicos o comerciales prácticos.
Resumen y ejercicios prácticos
Resumen de puntos clave
- Qué es PCA: Un método de reducción de dimensionalidad lineal no supervisado que reformula los datos encontrando direcciones ortogonales (componentes principales) con la mayor varianza en los datos.
- Pasos principales: Estandarización -> Calcular la matriz de covarianza -> Calcular valores propios y vectores propios -> Seleccionar componentes principales -> Proyección de datos.
- Conceptos importantes:
- Componentes principales: Nuevos ejes de características no correlacionados.
- Tasa de varianza explicada: Métrica que mide la importancia de cada componente principal.
- Cargas: El puente que conecta las características originales con los componentes principales, utilizado para interpretar el significado de los componentes principales.
- Principales aplicaciones: Visualización de datos, eliminación de ruido y redundancia, y como paso de preprocesamiento para otros modelos (como clasificación, regresión) para acelerar el entrenamiento.
Práctica
Para consolidar los conocimientos, intenta completar los siguientes ejercicios:
Ejercicio 1: Explorar diferentes conjuntos de datosIntenta aplicarscikit-learnotros conjuntos de datos en (comodigitsel conjunto de datos de dígitos escritos a mano owineel conjunto de datos de vinos) con visualización de PCA. Observa si las imágenes después de la reducción de dimensionalidad aún mantienen la distinción entre diferentes clases.
Ejemplo
from sklearn.datasets import load_wine
wine = load_wine()
# ... repetir el proceso de PCA
Ejercicio 2: Visualización tridimensionalReduce los datos de iris a 3 dimensiones y usampl_toolkits.mplot3dla biblioteca para dibujar un diagrama de dispersión tridimensional. Observa si, después de agregar una dimensión, la superposición entre Versicolor y Virginica se reduce.
Ejemplo
pca3 = PCA(n_components=3)
X_pca3 = pca3.fit_transform(X_scaled)
# ... crear una figura 3D para graficar