Concepts MLOps
Imaginez que vous êtes un data scientist. Après des semaines de travail acharné, vous avez enfin entraîné un modèle d'apprentissage automatique qui obtient d'excellentes performances sur l'ensemble de test. Avec enthousiasme, vous remettez cemodel.pklfichier à votre collègue ingénieur logiciel. Cependant, les problèmes s'enchaînent : comment ce modèle peut-il fonctionner de manière stable sur des serveurs traitant des millions de requêtes par jour ? Comment surveiller si ses performances sur des données réelles diminuent ? Lorsque de nouvelles données arrivent, comment réentraîner et mettre à jour automatiquement le modèle ?
Ce scénario révèle un défi central des projets d'apprentissage automatique :comment transformer le code expérimental d'un modèle en un système de production fiable qui crée continuellement de la valeur pour l'entreprise.MLOps est exactement un ensemble de philosophies et de pratiques conçu pour combler cet écart.
En termes simples, MLOps est une combinaison del'apprentissage automatiqueet deDevOps. Il s'inspire des idées d'automatisation, de collaboration et de surveillance de DevOps dans le développement logiciel et les applique à la gestion du cycle de vie des systèmes d'apprentissage automatique, visant à obtenirun développement efficace, un déploiement fiable et une exploitation continue des modèles ML.。
Qu'est-ce que le MLOps ?
Définition principale
MLOps est un ensemble de pratiques d'ingénierie utilisées pourstandardiser et automatiserles différentes étapes du cycle de vie des systèmes d'apprentissage automatique, notamment :
- Développement et expérimentation de modèles
- Entraînement et évaluation continus des modèles
- Déploiement et mise en service des modèles
- Surveillance, maintenance et itération dans les environnements de production
Son objectif ultime estde créer des flux de travail d'apprentissage automatique reproductibles, évolutifs, auditables et collaboratifsafin que les modèles puissent passer du laboratoire à la production rapidement et en toute sécurité, et conserver continuellement leur valeur.
Une analogie simple : comparaison avec DevOps
Pour mieux comprendre, nous pouvons comparer MLOps avec le DevOps plus familier :
| Aspect | DevOps (développement logiciel traditionnel) | MLOps (développement de systèmes d'apprentissage automatique) |
|---|---|---|
| Livrable principal | Application/Service | Modèle d'apprentissage automatique + son environnement d'exécution |
| Objet d'itération | Code | Code + Données + Modèle |
| Objectif des tests | Tests fonctionnels, tests d'intégration | Tests de performance du modèle, validation des données, détection de dérive conceptuelle |
| Unité de déploiement | Exécutable/Image de conteneur | Fichier de modèle + code d'inférence + environnement de dépendances spécifique |
| Métriques de surveillance | Utilisation CPU/mémoire, latence des requêtes, taux d'erreur | Qualité des prédictions du modèle (par ex., exactitude), distribution des données d'entrée, métriques métier |
Cette comparaison révèle la complexité unique de MLOps : il gère non seulement le code, mais aussiles donnéesetles modèlesCes deux éléments changeant dynamiquement.
Pourquoi MLOps ?
Les projets d'apprentissage automatique sans MLOps tombent souvent dans le "purgatoire des prototypes" — les modèles restent bloqués pour toujours au stade expérimental et ne parviennent pas à avoir un impact réel. MLOps brise cette impasse en s'attaquant aux problèmes clés suivants :
1. Défis de collaboration et de reproductibilité
- Problème: Les data scientists expérimentent dans Jupyter Notebooks, avec des dépendances d'environnement désordonnées, et les étapes expérimentales ne peuvent pas être reproduites.
- Solution MLOps: Utiliser le contrôle de version (par ex., Git) pour gérer le code, les versions des données (par ex., DVC) et les versions des modèles ; utiliser la conteneurisation (par ex., Docker) pour figer les environnements, en garantissant que toute expérience peut être reproduite précisément.
2. Complexité du déploiement et de l'exploitation
- Problème: Le déploiement manuel des modèles est fastidieux et propice aux erreurs ; la mise en service des modèles est difficile à mettre à l'échelle, et la surveillance fait défaut.
- Solution MLOps: Automatiser les pipelines CI/CD pour déployer des modèles en tant que services API en un clic ; tirer parti des technologies cloud-native pour la mise à l'échelle élastique ; mettre en place des tableaux de bord de surveillance complets.
3. Dégradation des performances des modèles
- Problème: La distribution des données en production change avec le temps (dérive conceptuelle), ce qui entraîne une dégradation silencieuse des performances du modèle sans que personne ne s'en aperçoive.
- Solution MLOps: Surveiller en continu les performances de prédiction et la distribution des données d'entrée, configurer des alertes automatisées et déclencher des workflows de réentraînement des modèles.
4. Exigences de gouvernance et de conformité
- Problème: Il est impossible de retracer quelle version du modèle et quelles données ont produit une prédiction donnée, ce qui rend difficile de satisfaire aux exigences d'audit et de réglementation.
- Solution MLOps: Suivi des versions de bout en bout, journalisation des expériences et traçabilité des résultats de prédiction.
Composants essentiels et flux de travail de MLOps
Un système MLOps typique contient plusieurs composants collaborant, et son flux de travail peut être visualisé comme une boucle :
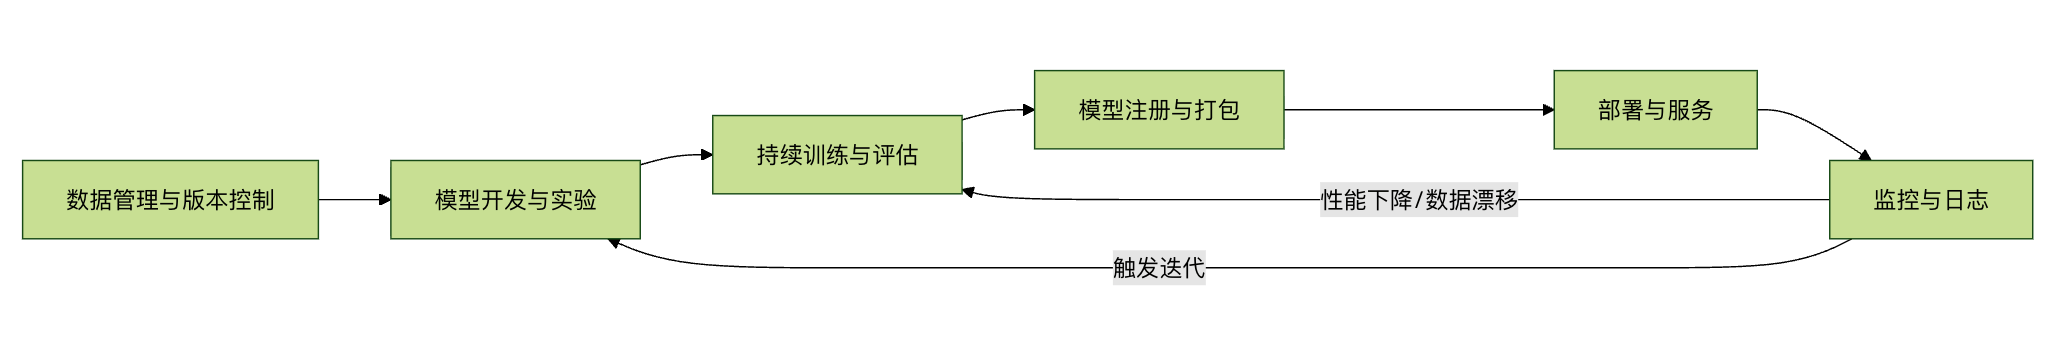
Décomposons chaque étape clé dans le diagramme ci-dessous :
1. Gestion des données et gestion des versions
C'est la pierre angulaire du MLOps. Contrairement au code, les fichiers de données sont souvent volumineux et changent constamment.
- Practice: Utilisez des outils tels queDVC (Data Version Control)ouLakeFSpour gérer les fichiers de données et de modèles comme Git gère le code. Ils stockent les métadonnées de version des données, tandis que les fichiers réels peuvent être placés dans le stockage cloud.
- Example: Chaque expérience peut être associée à un instantané de données spécifique, garantissant des résultats reproductibles.
2. Développement et expérimentation de modèles
C'est le principal champ de bataille pour les data scientists, mais cela exige une discipline d'ingénierie.
- Practice: Refactorisez le code expérimental des notebooks en scripts Python modulaires ; utilisezMLflow TrackingouWeights & Biasespour enregistrer les hyperparamètres, les métriques et les modèles produits pour chaque expérience afin de faciliter la comparaison.
3. Entraînement et évaluation continus
Lorsque de nouvelles données arrivent ou qu'une dégradation des performances est détectée, le système doit pouvoir réentraîner le modèle automatiquement ou semi-automatiquement.
- Practice: Construisez des pipelines d'entraînement automatisés (par exemple, en utilisantKubeflow PipelinesouApache Airflow). Le pipeline comprend la validation des données, l'ingénierie des caractéristiques, l'entraînement du modèle et l'évaluation (surun ensemble de validation distinct de l'ensemble d'entraînement) et d'autres étapes. Seuls les modèles qui réussissent l'évaluation peuvent passer à l'étape suivante.
4. Enregistrement et empaquetage du modèle
Les modèles entraînés doivent être correctement gérés et préparés pour le déploiement.
- Pratique: Utilisez unregistre de modèles(par exemple, MLflow Model Registry). Il stocke, annote et gère les modèles comme des actifs versionnables. Les modèles sont généralement empaquetés avec le code d'inférence dans desimages de conteneur Dockerpour garantir la cohérence avec l'environnement de production.
5. Déploiement et mise en service
Fournissez le modèle aux utilisateurs ou à d'autres systèmes.
- Modes:
- Prédiction par lots: Effectuez périodiquement des prédictions sur de grandes quantités de données et générez des rapports.
- Service d'API en temps réel: Le modèle agit comme une API REST ou un service gRPC, répondant aux requêtes en temps réel. Les outils courants incluentFastAPI, TensorFlow Serving, TorchServeou des services gérés par des fournisseurs cloud.
- Stratégies: Vous pouvez adopter undéploiement bleu-vertouou des versions canaripour déplacer progressivement le trafic vers le nouveau modèle et réduire les risques.
6. Surveillance et journalisation
Ce sont les « yeux » qui garantissent que le modèle en production fonctionne de manière saine.
- Contenu de la surveillance:
- Métriques système: latence de l'API, débit, taux d'erreur, utilisation des ressources.
- Métriques du modèle: Distribution des résultats de prédiction, changements dans les caractéristiques importantes (détection de la dérive des données).
- Métriques métier: L'impact commercial ultime des décisions du modèle (par ex., taux de clics, taux de conversion).
- Pratique: Intégrer des outils de supervision (par ex.,Prometheus, Grafana) et des systèmes de journalisation (par ex.,ELK Stack), et configurer des règles d'alerte pour les métriques clés.
Un exemple simplifié de pratique MLOps
Parcourons un flux de code conceptuel pour voir comment mettre en œuvre le suivi des expériences, l'enregistrement des modèles et l'empaquetage avec MLflow, un outil populaire.
Exemple
import mlflow
import mlflow.sklearn
from sklearn.datasets import load_iris
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# 2. Configurer le serveur de suivi MLflow (en supposant qu'il s'exécute déjà localement)
mlflow.set_tracking_uri("http://127.0.0.1:5000")
mlflow.set_experiment("Iris_Classification")
# 3. Démarrer une exécution d'expérience
with mlflow.start_run():
# Charger les données et les diviser
data = load_iris()
X_train, X_test, y_train, y_test = train_test_split(data.data, data.target, test_size=0.2)
# Définir et entraîner le modèle
n_estimators = 100
model = RandomForestClassifier(n_estimators=n_estimators, random_state=42)
model.fit(X_train, y_train)
# Prédire et évaluer
y_pred = model.predict(X_test)
acc = accuracy_score(y_test, y_pred)
# 4. Enregistrer les informations d'expérience sur le serveur de suivi MLflow
mlflow.log_param("n_estimators", n_estimators) # Enregistrer les hyperparamètres
mlflow.log_metric("accuracy", acc) # Enregistrer les métriques d'évaluation
# 5. Enregistrer le modèle lui-même (y compris son environnement de dépendances)
# mlflow.sklearn.log_model enregistre le modèle et génère un fichier d'environnement conda.yaml
mlflow.sklearn.log_model(model, "random_forest_model")
print(f"Entraînement du modèle terminé, précision : {acc:.4f}")
print(f"Expérience enregistrée. Vous pouvez la consulter dans l'interface MLflow (http://127.0.0.1:5000).")
# 6. (Étape suivante) Dans l'interface MLflow, vous pouvez "enregistrer" ce modèle journalisé dans le Model Registry.
# 7. Ensuite, vous pouvez récupérer le modèle depuis le Registry et l'empaqueter en image Docker à l'aide de la commande `mlflow models build-docker`.
# 8. Enfin, déployez cette image sur Kubernetes ou un serveur cloud pour servir le modèle.
Explication du code:
- Cet exemple illustre les aspects fondamentaux du MLOps :Suivi des expériencesetJournalisation des modèlesCes aspects sont essentiels.
mlflow.log_parametmlflow.log_metricCela garantit la traçabilité des expériences.mlflow.sklearn.log_modelNon seulement cela sauvegarde le fichier du modèle, mais cela enregistre également automatiquement les versions des bibliothèques Python (environnement) utilisées pour créer le modèle, ce qui est une étape clé vers la reproductibilité.- Les étapes ultérieures d'enregistrement, d'empaquetage et de déploiement sont généralement réalisées dans l'interface utilisateur ou via des pipelines CI/CD.
Niveaux de maturité MLOps
La mise en œuvre de MLOps n'est pas un effort ponctuel ; on considère généralement qu'elle comporte trois étapes d'évolution :
- MLOps de base (processus manuel): Les processus de déploiement et d'entraînement sont déclenchés manuellement, avec une surveillance limitée. C'est le point de départ de nombreuses équipes.
- MLOps intermédiaire (pipelines automatisés): met en œuvre l'intégration continue (CI)Intégration continue (CI)etLivraison continue (CD)pour l'entraînement et le déploiement de modèles, avec un haut degré d'automatisation.
- MLOps avancé (entraînement continu, CT): Le système dispose de boucles de surveillance et de rétroaction automatisées complètes, capables de déclencher automatiquement la collecte de données, le réentraînement, l'évaluation et le déploiement, atteignant ainsi un véritableentraînement continu。
Résumé et perspectives
MLOps n'est pas un outil spécifique, mais uncadre complet couvrant la culture, les processus et la technologie. Il exige une collaboration étroite entre les data scientists, les ingénieurs en machine learning et les ingénieurs des opérations.
Pour les débutants, comprendre les concepts de MLOps est la première étape vers la construction de systèmes de machine learning fiables. Vous pouvez commencer par les pratiques suivantes :
- Utilisez Git pour un contrôle de version strict du code。
- Essayez MLflow pour gérer vos expériences et vos modèles。
- Servez votre modèle, par exemple, écrivez une API de prédiction simple avec FastAPI.
- Réfléchissez à la façon de surveiller les résultats de prédiction de votre modèle。
À mesure que le machine learning devient de plus en plus appliqué dans l'industrie, MLOps est devenu une capacité d'ingénierie clé pour garantir le succès, la contrôlabilité et l'évolutivité des projets ML. Maîtriser l'état d'esprit MLOps peut vous aider à transformer les modèles entre vos mains, de brillants cristaux de laboratoire en un moteur stable qui stimule la croissance de l'entreprise.
Autres extensions