MLOps 概念
あなたはデータサイエンティストだと想像してください。数週間の努力を経て、ついにテストセットで優れた性能を発揮する機械学習モデルを訓練しました。あなたは興奮してこのmodel.pklファイルをソフトウェアエンジニアの同僚に渡しました。しかし、問題が次々と発生します。このモデルは、毎日数百万のリクエストを処理するサーバー上でどのように安定して動作するのでしょうか? 実データでのパフォーマンスが低下していないかどうかをどのように監視するのでしょうか? 新しいデータが来たときに、どのように自動的に再トレーニングしてモデルを更新すればよいのでしょうか?
このシナリオは、機械学習プロジェクトにおける中心的な課題を浮き彫りにします:実験的なモデルコードを、ビジネスに継続的に価値を生み出す信頼性の高い本番システムにどう変換するか。MLOps はまさにこのギャップを解決するために生まれた、一連の理念と実践の体系です。
簡単に言うと、MLOps はMachine LearningとDevOpsの組み合わせです。ソフトウェア開発における DevOps の自動化・コラボレーション・モニタリングの考え方を借用し、それを機械学習システムのライフサイクル管理に適用し、ML モデルの効率的な開発、信頼性の高いデプロイ、継続的な運用。
MLOps とは何か?
中核となる定義
MLOps は、以下のために使用される一連のエンジニアリング実践です:標準化と自動化機械学習システムのライフサイクルにおける各ステップ(以下を含む):
- モデル開発と実験
- モデルの継続的なトレーニングと評価
- モデルのデプロイとサービス提供
- 本番環境での監視、保守、反復
その最終目標は再現可能で、拡張可能で、監査可能で、コラボレーション効率の高い機械学習ワークフローを構築することモデルが迅速かつ安全にラボから本番へ移行し、価値を維持し続けることを可能にします。
簡単な類推:DevOps との比較
よりよく理解するために、MLOps を、より馴染みのある DevOps と比較してみましょう:
| 側面 | DevOps(従来のソフトウェア開発) | MLOps(機械学習システム開発) |
|---|---|---|
| 主要な成果物 | アプリケーション/サービス | 機械学習モデル + その実行環境 |
| 反復の対象 | コード | コード + データ + モデル |
| テストの重点 | 機能テスト、統合テスト | モデル性能テスト、データ検証、コンセプトドリフト検出 |
| デプロイ単位 | 実行ファイル/コンテナイメージ | モデルファイル + 推論コード + 特定の依存環境 |
| 監視指標 | CPU/メモリ使用率、リクエスト遅延、エラー率 | モデルの予測品質(例:精度)、入力データ分布、ビジネス指標 |
この比較は、MLOps の独自の複雑さを明らかにしています:コードだけでなく、データとモデルという2つの動的に変化する要素も管理する必要があります。
なぜ MLOps が必要なのか?
MLOps のない機械学習プロジェクトは、しばしば「プロトタイプ煉獄」——モデルが永遠に実験段階にとどまり、実際の影響を生み出せない状態に陥ります。MLOps は、以下の重要な問題を解決することで、このジレンマを打破します:
1. コラボレーションと再現性の課題
- 問題:データサイエンティストが Jupyter Notebook で実験し、環境依存関係が乱れており、実験手順を再現できません。
- MLOps による解決策:バージョン管理(Git など)を使用してコード、データバージョン(DVC など)、モデルバージョンを管理し、コンテナ化(Docker など)で環境を固定化して、あらゆる実験を正確に再現できるようにします。
2. デプロイと運用の複雑さ
- 問題:手動でモデルをデプロイするため、プロセスが煩雑でエラーが発生しやすく、モデルサービスの拡張が難しく、監視が欠如しています。
- MLOps による解決策:CI/CD パイプラインを自動化し、モデルをワンクリックで API サービスとしてデプロイします。クラウドネイティブ技術を利用して弾性スケーリングを実現し、包括的な監視ダッシュボードを構築します。
3. モデル性能の劣化
- 問題:本番環境のデータ分布が時間とともに変化し(コンセプトドリフト)、モデルの性能が静かに低下し、誰も気づかないことがあります。
- MLOps による解決策:予測性能と入力データ分布を継続的に監視し、自動アラートを設定して、モデルの再トレーニングプロセスをトリガーします。
4. ガバナンスとコンプライアンスのニーズ
- 問題:特定の予測がどのバージョンのモデルとどのデータに基づいて行われたかを追跡できないため、監査や法規制の要件を満たすことが困難です。
- MLOps による解決策:終始一貫したバージョン追跡、実験ログの記録、予測結果のトレーサビリティ。
MLOps の主要コンポーネントとワークフロー
典型的な MLOps システムは、相互に連携する複数のコンポーネントで構成され、そのワークフローは循環として視覚化できます:
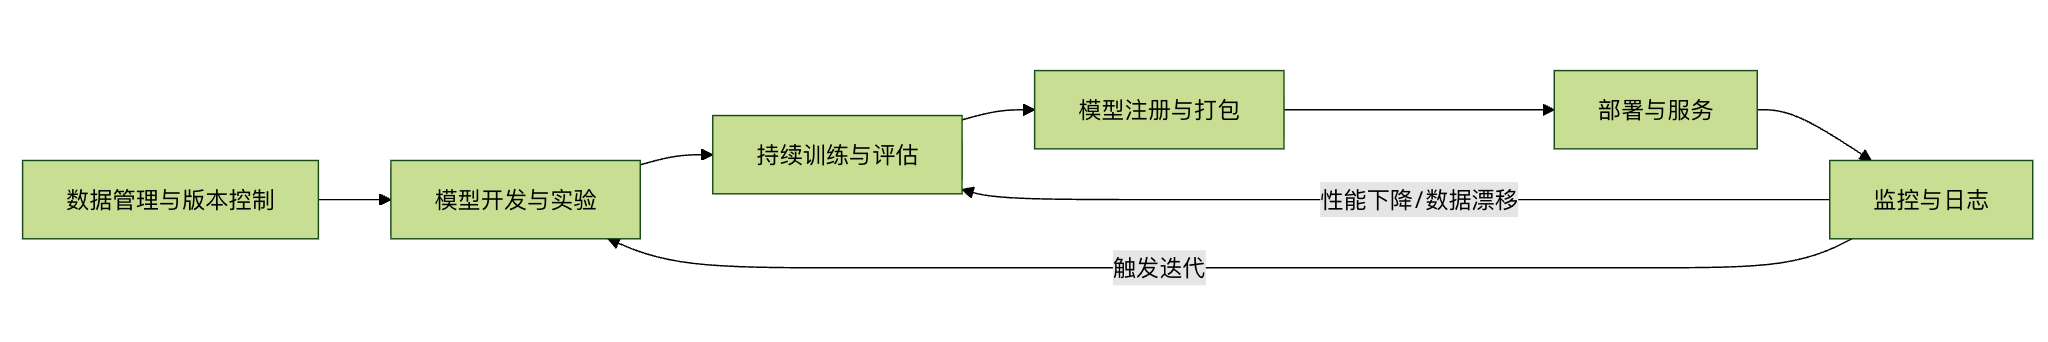
それでは、図の各重要な要素を分解してみましょう:
1. データ管理とバージョン管理
これは MLOps の基盤です。コードとは異なり、データファイルは通常非常に大きく、絶えず変化します。
- 実践方法例えばDVC (Data Version Control) 或 LakeFSなどのツールを使用して、Git がコードを管理するのと同じようにデータとモデルファイルを管理します。データのバージョンのメタ情報を保存し、実際のファイルはクラウドストレージに保存できます。
- 例:各実験を特定のデータスナップショットに関連付けることができ、結果の再現性を確保します。
2. モデル開発と実験
これはデータサイエンティストの主戦場ですが、エンジニアリング的な規律が必要です。
- 実践方法:実験コードを Notebook からモジュール化された Python スクリプトにリファクタリングします。次のものを使用して、MLflow Tracking 或 Weights & Biases各実験のハイパーパラメータ、指標、生成されたモデルを記録し、比較しやすくします。
3. 継続的なトレーニングと評価
新しいデータが到着したとき、または性能低下が監視されたとき、システムは自動的または半自動的にモデルを再トレーニングできる必要があります。
- 実践方法:自動化されたトレーニングパイプラインを構築します(例えば、Kubeflow Pipelines 或 Apache Airflowを使用)。パイプラインには、データ検証、特徴エンジニアリング、モデルトレーニング、評価(トレーニングセットとは異なる検証セット上で)などのステップが含まれます。評価基準を満たしたモデルだけが次の段階に進むことができます。
4. モデル登録とパッケージング
トレーニングされたモデルは適切に管理され、デプロイの準備が整えられる必要があります。
- 実践方法:使用するのはモデルレジストリ(例:MLflow Model Registry)。モデルをバージョン管理可能な資産として保存、注釈付け、管理します。モデルは通常、推論コードと一緒にDocker コンテナイメージにパッケージ化され、本番環境の一貫性を確保します。
5. デプロイとサービス提供
モデルをユーザーや他のシステムが利用できるようにします。
- パターン:
- バッチ予測:定期的に大量のデータに対して予測を行い、レポートを生成します。
- リアルタイム API サービス:モデルが REST API または gRPC サービスとして、リクエストにリアルタイムで応答します。一般的なツールにはFastAPI, TensorFlow Serving, TorchServeやクラウドプロバイダーのマネージドサービスがあります。
- 戦略:採用できるのはブルーグリーンデプロイ 或 カナリアリリースなどで、段階的にトラフィックを新しいモデルに切り替え、リスクを低減します。
6. モニタリングとログ
これは本番モデルの健全な稼働を確保するための「目」です。
- 監視内容:
- システム指標:API レイテンシ、スループット、エラー率、リソース使用率。
- モデル指標:予測結果の分布、重要な特徴量の変化(データドリフトの検出)。
- ビジネス指標:モデルの意思決定が最終的にもたらすビジネスへの影響(例:クリック率、コンバージョン率)。
- 実践方法:監視ツール(例:Prometheus, Grafana)とログシステム(例:ELK Stack)を統合し、重要な指標のアラートルールを設定します。
簡素化された MLOps の実践例
概念的なコードの流れを通して、人気のツールMLflowを使って実験トラッキング、モデル登録、パッケージングを実現する方法を見てみましょう。
具体例
import mlflow
import mlflow.sklearn
from sklearn.datasets import load_iris
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# 2. MLflow トラッキングサーバーを設定する(ローカルで実行中と仮定)
mlflow.set_tracking_uri("http://127.0.0.1:5000")
mlflow.set_experiment("Iris_Classification")
# 3. 実験ランを開始する
with mlflow.start_run():
# データを読み込んで分割する
data = load_iris()
X_train, X_test, y_train, y_test = train_test_split(data.data, data.target, test_size=0.2)
# モデルを定義してトレーニングする
n_estimators = 100
model = RandomForestClassifier(n_estimators=n_estimators, random_state=42)
model.fit(X_train, y_train)
# 予測と評価
y_pred = model.predict(X_test)
acc = accuracy_score(y_test, y_pred)
# 4. 実験情報をMLflow Tracking Serverに記録する
mlflow.log_param("n_estimators", n_estimators) # ハイパーパラメータを記録する
mlflow.log_metric("accuracy", acc) # 評価指標を記録する
# 5. モデル自体を記録する(依存環境を含む)
# mlflow.sklearn.log_model はモデルを記録し、conda.yaml 環境ファイルを生成します
mlflow.sklearn.log_model(model, "random_forest_model")
print(fモデルのトレーニングが完了しました。正解率:{acc:.4f})
print(f実験が記録されました。MLflow UI (http://127.0.0.1:5000) で確認できます。)
# 6. (後続ステップ)MLflow UIで、この記録済みモデルをModel Registryに「登録」できます。
# 7. その後、Registryからモデルを取得し、`mlflow models build-docker` コマンドを使用してDockerイメージにパッケージ化できます。
# 8. 最後に、このイメージをKubernetesやクラウドサーバーにデプロイしてサービスを提供します。
コードの説明:
- この例はMLOpsにおける実験トラッキングとモデル記録の中核となる部分を示しています。
mlflow.log_paramとmlflow.log_metric実験のトレーサビリティを確保します。mlflow.sklearn.log_modelモデルファイルを保存するだけでなく、そのモデルを作成したPythonライブラリのバージョン(環境)も自動的に記録します。これは再現性を実現するための重要なステップです。- 後続の登録、パッケージング、デプロイの手順は通常、UIまたはCI/CDパイプラインで実行されます。
MLOps の成熟度レベル
MLOpsの導入は一朝一夕にはできません。通常、3つの発展段階があると考えられています:
- MLOps基礎レベル(手動プロセス):デプロイとトレーニングのプロセスは手動でトリガーされ、監視は限られています。これは多くのチームの出発点です。
- MLOps中級レベル(自動化パイプライン):モデルのトレーニングとデプロイの継続的インテグレーション(CI)と継続的デリバリー(CD)を実現し、自動化の度合いが高くなっています。
- MLOps上級レベル(継続的トレーニングCT):システムは完全な自動監視とフィードバックループを備え、データ収集、再トレーニング、評価、デプロイを自動的にトリガーでき、真の継続的トレーニング(Continuous Training)。
まとめと展望
MLOpsは特定のツールではなく、文化、プロセス、技術を網羅する総合的なフレームワークです。それには、データサイエンティスト、機械学習エンジニア、運用エンジニアの緊密な連携が求められます。
初心者にとって、MLOpsの概念を理解することは、信頼性の高い機械学習システムを構築するための第一歩です。次のような実践から始めることができます:
- Gitを使用した厳格なコードバージョン管理。
- MLflowを使って実験とモデルを管理する。
- モデルをサービス化する例えば、FastAPIで簡単な予測APIを作成します。
- モデルの予測結果の監視方法を考える。
機械学習の産業応用がますます深まるにつれ、MLOpsは機械学習プロジェクトの成功、管理可能性、拡張性を確保するための重要なエンジニアリング能力となっています。MLOpsの考え方を身につけることで、手元のモデルを、実験室の輝く水晶から、ビジネス成長を支える安定したエンジンへと変えることができます。
その他の拡張