Visualización de datos
Antes de empezar a construir un modelo complejo de aprendizaje automático, lo primero que debemos hacer no es elegir un algoritmo, sinocomprender los datos。
Si comparamos el aprendizaje automático con la cocina, los datos son los ingredientes.
Un buen cocinero debe conocer las características de los ingredientes: si están frescos o en mal estado, si son dulces o ácidos, si son adecuados para estofar o saltear.
La visualización de datos es nuestra forma de observar y degustar el ingrediente de los datos:la lupayy las papilas gustativas。
La visualización de datos convierte los números aburridos en imágenes intuitivas mediante elementos visuales como gráficos y diagramas, lo que nos ayuda a:
- Descubrir patrones y tendencias en los datos(por ejemplo: ¿las ventas varían según la estación?)
- Identificar valores atípicos y datos erróneos(por ejemplo: un registro con una edad de 300 años)
- Comprender la relación entre características (variables)(por ejemplo: ¿el área de la casa y el precio están correlacionados positivamente?)
- Validar hipótesis, y proporcionar la base para la posterior ingeniería de características y la selección de modelos.
Este artículo utilizará las librerías de ciencia de datos más populares de Pythonpandasy las librerías de visualizaciónmatplotlib、seaborn, para que domines las habilidades fundamentales de la visualización de datos.
Preparación: entorno y datos
Antes de empezar a dibujar, debemos preparar el "lienzo" y la "pintura".
Instalar las librerías necesarias
Si usas Anaconda, estas librerías suelen estar preinstaladas. Si no, puedes instalarlas con los siguientes comandos:
pip install pandas matplotlib seaborn
Importar librerías y cargar datos
Usaremos un conjunto de datos público clásico: el conjunto de datos de pasajeros del Titanic. Contiene información como la supervivencia, la clase de cabina, la edad, el sexo, etc.
Ejemplo
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# Establecer el estilo del gráfico para que se vea mejor
sns.set_style("whitegrid")
# -------------------------- Configuración de fuente china inicio --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows primero
'SimHei', 'Microsoft YaHei',
# macOS primero
'PingFang SC', 'Heiti TC',
# Linux primero
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que los signos negativos se muestren como cuadrados
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Configuración de fuente china fin --------------------------
# Cargar datos
# Aquí cargamos directamente desde el conjunto de datos integrado de seaborn
df = sns.load_dataset('titanic')
# Ver las primeras filas y la información básica de los datos
print("Forma de los datos (filas, columnas):", df.shape)
print("\n"Primeras 5 filas de los datos:")
print(df.head())
print("\n"Información básica de los datos (tipos, cantidad de valores no nulos, etc.):")
print(df.info())
# Cargar datos
# Aquí cargamos directamente desde el conjunto de datos integrado de seaborn
df = sns.load_dataset('titanic')
# Ver las primeras filas y la información básica de los datos
print("Forma de los datos (filas, columnas):", df.shape)
print("\n"Primeras 5 filas de los datos:")
print(df.head())
print("\n"Información básica de los datos (tipos, cantidad de valores no nulos, etc.):")
print(df.info())
Al ejecutar el código anterior, verás que los datos tienen 891 filas (pasajeros) y 15 columnas (características).df.head()Esto te dará una primera impresión de cómo son los datos.
Análisis univariante: comprender la distribución de una única característica
El análisis univariante se centra en la distribución deunacaracterística (variable). Es el análisis más básico.
1. Características numéricas: histograma y diagrama de caja
Para características numéricas continuas comoage(edad),fare(tarifa), solemos usarhistogramaydiagrama de caja。
El histogramamuestra la frecuencia de los datos en diferentes intervalos ("bins").
Ejemplo
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# Establecer el estilo del gráfico para que se vea mejor
sns.set_style("whitegrid")
# -------------------------- Configuración de fuente china inicio --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows primero
'SimHei', 'Microsoft YaHei',
# macOS primero
'PingFang SC', 'Heiti TC',
# Linux primero
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que los signos negativos se muestren como cuadrados
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Configuración de fuente china fin --------------------------
# Cargar datos
# Aquí cargamos directamente desde el conjunto de datos integrado de seaborn
df = sns.load_dataset('titanic')
# Ver las primeras filas y la información básica de los datos
print("Forma de los datos (filas, columnas):", df.shape)
print("\n"Primeras 5 filas de los datos:")
print(df.head())
print("\n"Información básica de los datos (tipos, cantidad de valores no nulos, etc.):")
print(df.info())
# Dibujar el histograma de la edad
plt.figure(figsize=(10, 6)) # Establecer el tamaño del gráfico
plt.hist(df['age'].dropna(), bins=30, edgecolor='black', alpha=0.7) # dropna() ignora los valores faltantes
plt.title('Histograma de distribución de edad de los pasajeros')
plt.xlabel('Edad')
plt.ylabel('Frecuencia')
plt.show()
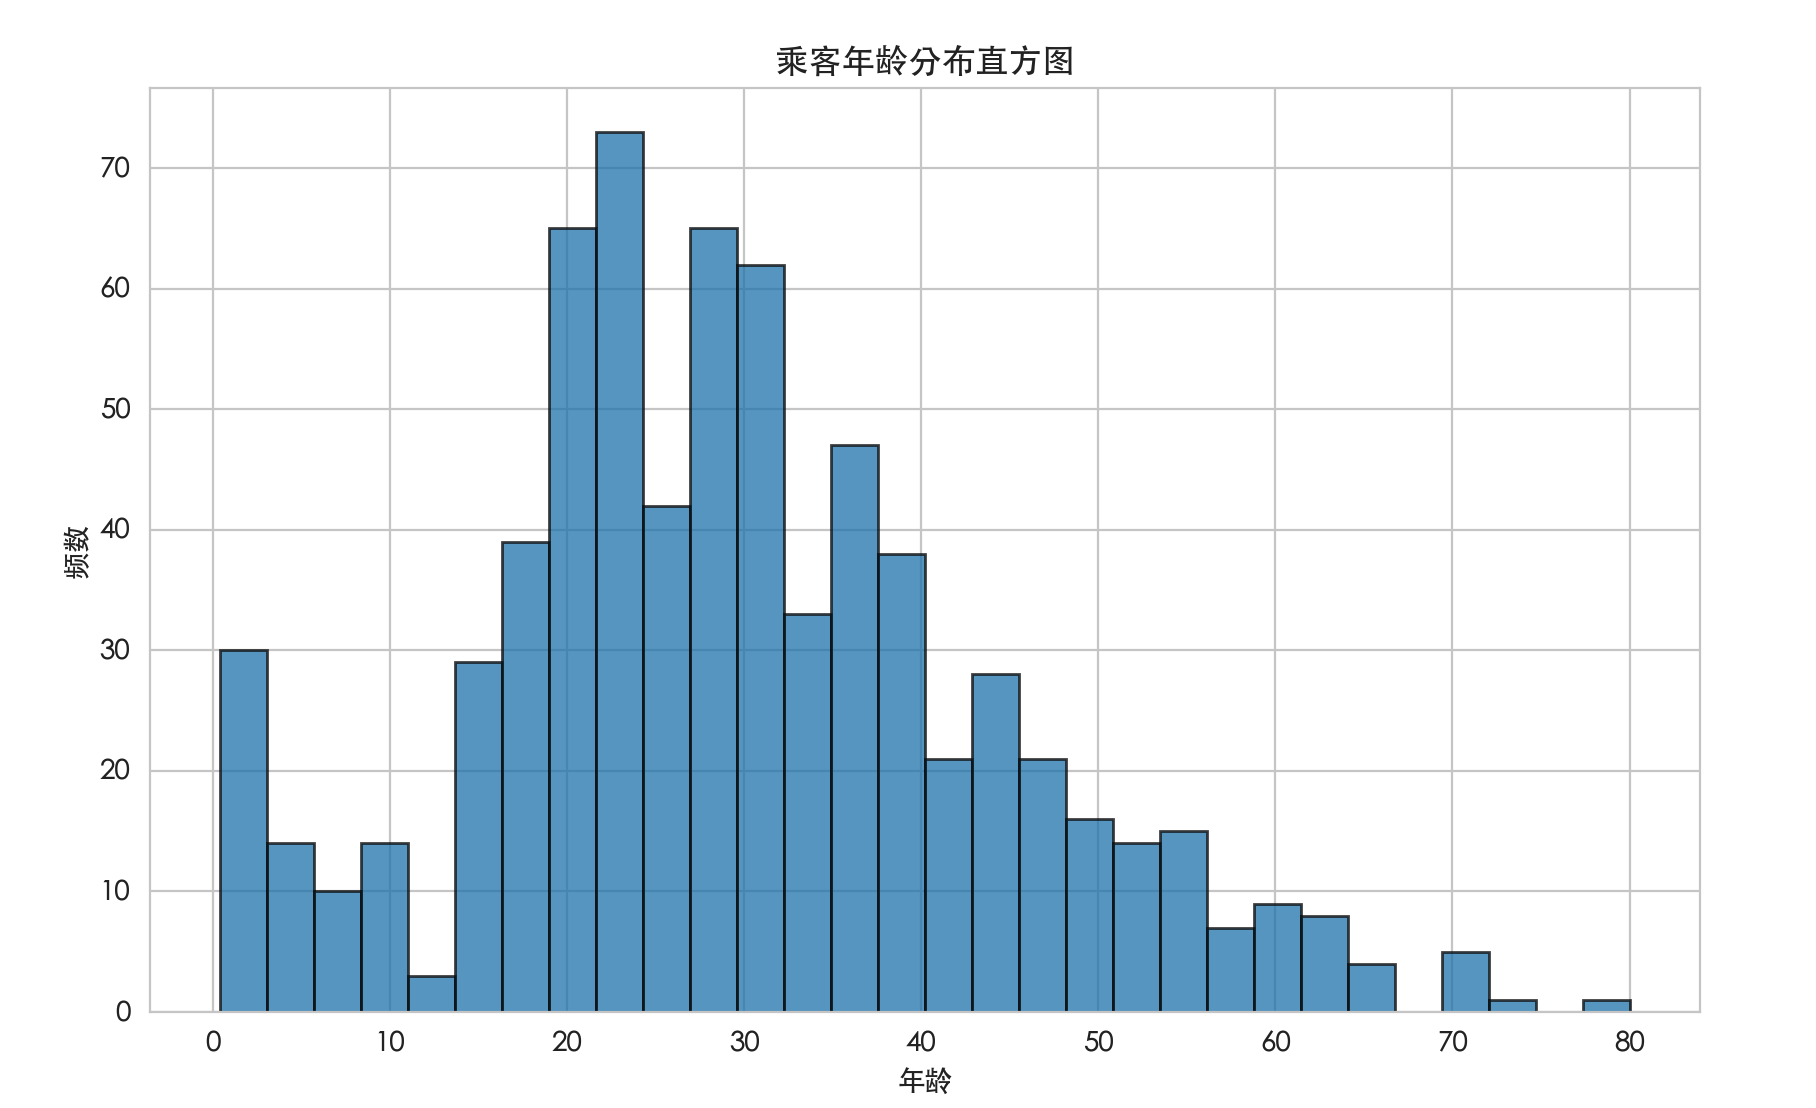
Interpretación: Este gráfico puede decirnos en qué intervalo se concentra principalmente la edad de los pasajeros (por ejemplo, 20-30 años), si la distribución es simétrica, si hay valores atípicos, etc.
El diagrama de cajapuede mostrar claramente lamediana, los cuartiles y los valores atípicos。
Ejemplo
plt.figure(figsize=(8, 5))
plt.boxplot(df['fare'].dropna())
plt.title('Diagrama de caja de la tarifa')
plt.ylabel('Tarifa')
plt.show()
Interpretación: La línea en el centro de la caja es la mediana. Los bordes superior e inferior de la caja son el cuartil superior (Q3) y el cuartil inferior (Q1). Los "bigotes" superior e inferior suelen extenderse hasta el punto de datos más lejano dentro de 1.5 veces el rango intercuartílico, y los puntos más allá se consideranvalores atípicos(los círculos superiores en el gráfico). Este gráfico nos dice inmediatamente que la tarifa tiene muchos valores atípicos extremadamente altos.
2. Características categóricas: gráfico de barras
Para características categóricas comosex(sexo),embarked(puerto de embarque),survived(si sobrevivió), usamosgráfico de barraspara contar el número de cada categoría.
Ejemplo
survival_counts = df['sex'].value_counts()
plt.figure(figsize=(8, 5))
plt.bar(survival_counts.index, survival_counts.values, color=['lightblue', 'lightcoral'])
plt.title('Distribución por sexo de los pasajeros')
plt.xlabel('Sexo')
plt.ylabel('Número de personas')
plt.show()
Análisis bivariante: explorar la relación entre características
El análisis bivariante explora la relación entredoscaracterísticas.
1. Numérico vs numérico: diagrama de dispersión
El diagrama de dispersión es una herramienta excelente para estudiar la correlación entre dos variables continuas.
Ejemplo
plt.figure(figsize=(10, 6))
plt.scatter(df['age'], df['fare'], alpha=0.5) # alpha establece la transparencia para facilitar la observación de la densidad de puntos
plt.title('Diagrama de dispersión de edad vs tarifa')
plt.xlabel('Edad')
plt.ylabel('Tarifa')
plt.show()
- Interpretación: El patrón de distribución de los puntos puede sugerir una correlación. Por ejemplo, si los puntos se distribuyen aproximadamente a lo largo de una línea diagonal, significa que están correlacionados. En este gráfico, la edad y la tarifa no muestran una relación lineal clara, pero se puede confirmar nuevamente la existencia de tarifas altas (valores atípicos).
2. Categórico vs numérico: diagrama de caja agrupado o diagrama de violín
A menudo queremos saber cómo difiere la distribución de una característica numérica entre diferentes categorías. Por ejemplo: "¿Cuál es la diferencia en la distribución de tarifas entre pasajeros de diferentes clases?"
Ejemplo
plt.figure(figsize=(10, 6))
sns.boxplot(x='pclass', y='fare', data=df)
plt.title('Distribución de tarifas por clase de cabina')
plt.show()
- Interpretación¡Muy claro! Cuanto mayor es la clase de cabina (primera clase), la mediana y el rango general de la tarifa son significativamente más altos. Esto coincide completamente con nuestro sentido común.
Diagrama de violínEs una versión avanzada del diagrama de caja; no solo muestra estadísticos, sino que también presenta la forma real de la distribución de los datos mediante la estimación de densidad kernel.
Ejemplo
plt.figure(figsize=(10, 6))
sns.violinplot(x='sex', y='age', data=df, inner='quartile') # El parámetro 'inner' muestra las líneas de cuartiles
plt.title('Distribución de edades por sexo (diagrama de violín)')
plt.show()
3. Categórico vs categórico: gráfico de barras apiladas o mapa de calor
Para dos variables categóricas, podemos usargráfico de barras apiladaspara observar la combinación. Por ejemplo: '¿Cuál es la proporción de supervivencia por sexo?'
Ejemplo
cross_tab = pd.crosstab(df['sex'], df['survived'], normalize='index') # normalize='index' calcula la proporción por fila
print(cross_tab)
# Dibujar el gráfico de barras apiladas
cross_tab.plot(kind='bar', stacked=True, figsize=(10, 6), color=['tomato', 'lightgreen'])
plt.title('Proporción de supervivencia por sexo')
plt.xlabel('Sexo')
plt.ylabel('Proporción')
plt.legend(['No sobrevivió', 'Sobrevivió'])
plt.show()
Interpretación: Se puede ver claramente en el gráfico y la tabla cruzada que la proporción de supervivencia de las mujeres es mucho mayor que la de los hombres. Esta es una señal muy fuerte que indica quesexla característica es crucial para predecir la supervivencia.
Análisis multivariante y visualización avanzada
A veces necesitamos considerar tres o incluso más variables al mismo tiempo.seabornLa librería hace que esto sea sencillo.
1. Diagrama de dispersión con agrupación
Podemos, sobre la base del diagrama de dispersión, usar colores o formas para distinguir una tercera variable (categórica).
Ejemplo
plt.figure(figsize=(12, 8))
sns.scatterplot(x='age', y='fare', hue='survived', style='survived', data=df, alpha=0.7)
plt.title('Edad vs tarifa (coloreado por estado de supervivencia)')
plt.show()
- Interpretación: Este gráfico nos permite percibir intuitivamente si la distribución de los sobrevivientes (naranja) y los no sobrevivientes (azul) en el espacio bidimensional 'edad-tarifa' presenta diferencias.
2. Mapa de calor de matriz de correlación
Cuando tenemos múltiples características numéricas, podemos calcular de una vez los coeficientes de correlación entre cada par y mostrarlos con un mapa de calor.
Ejemplo
numeric_df = df.select_dtypes(include=['float64', 'int64'])
# Calcular la matriz de coeficientes de correlación
corr_matrix = numeric_df.corr()
# Dibujar el mapa de calor
plt.figure(figsize=(12, 8))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', center=0, square=True)
plt.title('Mapa de calor de la matriz de correlación de características numéricas')
plt.show()
Interpretación: Cuanto más cálido es el color (rojo), más fuerte es la correlación positiva; cuanto más frío (azul), más fuerte es la correlación negativa.annot=TrueLos valores concretos se muestran dentro de las celdas. Por ejemplo,pclass(clase de cabina) yfare(tarifa) presentan una fuerte correlación negativa (-0.55), es decir, cuanto menor es el número de clase (mayor categoría), mayor es la tarifa, lo cual es consistente con nuestro análisis anterior.
Práctica: explora con tus propias manos
Ahora, intenta completar los siguientes ejercicios para consolidar lo aprendido:
- Verificación de datos: Usa
df.isnull().sum()para ver qué columnas del conjunto de datos tienen valores faltantes y cuántos faltan. - Dibujar la distribución: Para
agecolumna, dibuja undiagrama de violín, y agrúpalo segúnsurvived(estado de supervivencia) (usandosns.violinplot(x='survived', y='age', data=df)). Observa en qué se diferencia la distribución de edades entre sobrevivientes y no sobrevivientes. - Explorar relaciones: Usa
sns.countplot(x='pclass', hue='survived', data=df)para dibujar un gráfico de barras de conteo y observar la comparación del número de sobrevivientes por clase de cabina. ¿Qué conclusión puedes extraer? - (Desafío) Gráfico multivariable: Intenta dibujar unmatriz de diagramas de dispersión, para ver de una vez
age、fare、parch(número de padres/hijos) y las relaciones por pares entre estas variables numéricas. Sugerencia: puedes usarsns.pairplot(df[['age', 'fare', 'parch', 'survived']], hue='survived')。
Resumen
La visualización de datos es, en el flujo de trabajo de aprendizaje automático,un paso exploratorio indispensable.. A través de este artículo, has aprendido:
Herramientas principales: Usamatplotlibpara realizar gráficos básicos, usaseabornpara dibujar gráficos estadísticos más atractivos e informativos.
Enfoque de análisis:
- Análisis univariable: Usa histogramas/diagramas de caja para ver la distribución, y gráficos de barras para contar frecuencias.
- Análisis bivariable: Usa diagramas de dispersión para ver relaciones numéricas, diagramas de caja agrupados para ver el efecto de las categorías sobre los valores, y gráficos de barras apiladas para ver combinaciones de categorías.
- Análisis multivariable: Usa diagramas de dispersión coloreados y mapas de calor de correlación para revelar patrones más complejos.
Objetivo principal: Todos los gráficos tienen como propósitoplantear hipótesisydescubrir insights, por ejemplo, el sexo puede ser una característica predictiva importante, y hay muchos valores atípicos en los datos de tarifas que deben tratarse.
Recuerda: antes de alimentar los datos al modelo, asegúrate de dedicar tiempo a examinarlos bien. Un hallazgo claro de visualización a menudo puede guiarte en la dirección correcta antes que un algoritmo complejo.
Otras extensiones Referencia de comandos de Linux