Máquina de vectores de soporte
La máquina de vectores de soporte (Support Vector Machine, abreviado SVM) es un algoritmo de aprendizaje supervisado, utilizado principalmente para problemas de clasificación y regresión.
La idea central de SVM es encontrar un hiperplano óptimo que separe los datos de diferentes categorías. Este hiperplano no solo debe clasificar correctamente los datos, sino también maximizar el margen entre las dos categorías.
Hiperplano:
- En un espacio bidimensional, el hiperplano es una línea recta.
- En un espacio tridimensional, el hiperplano es un plano.
- En un espacio de mayor dimensión, el hiperplano es un hiperplano que divide el espacio.
Vectores de soporte:
- Los vectores de soporte son los puntos de muestra más cercanos al hiperplano. Estos vectores de soporte son cruciales para definir el hiperplano.
- La máquina de vectores de soporte selecciona el mejor hiperplano maximizando la distancia desde los vectores de soporte al hiperplano (es decir, maximizando el margen).
Margen máximo:
- El objetivo de SVM es maximizar el margen de clasificación, de modo que el límite de clasificación esté lo más lejos posible de los dos tipos de puntos de datos. Esto puede reducir eficazmente el error de generalización del modelo.
Truco del núcleo (Kernel Trick):
- Para datos no linealmente separables, SVM utiliza una función kernel para mapear los datos a un espacio de mayor dimensión, donde los datos pueden ser linealmente separables.
- Las funciones kernel comunes son: kernel lineal, kernel polinómico, kernel de función de base radial (RBF), etc.
Flujo de clasificación SVM
- Seleccionar un hiperplano: Encontrar un hiperplano que pueda maximizar el límite de clasificación.
- Entrenar vectores de soporte: A través del algoritmo de máquina de vectores de soporte, seleccionar los puntos de muestra más cercanos al hiperplano como vectores de soporte.
- Encontrar el hiperplano óptimo maximizando el margen: Seleccionar un hiperplano óptimo de modo que el margen se maximice.
- Usar funciones kernel para manejar problemas no lineales: Resolver problemas no linealmente separables mapeando los datos a un espacio de alta dimensión mediante la función kernel.
Implementación de SVM con Python
A continuación, usaremos la bibliotecascikit-learnpara implementar un clasificador SVM simple.
1. Instalar las bibliotecas necesarias
Primero, asegúrate de tener instaladascikit-learnla biblioteca. Si no está instalada, puedes usar el siguiente comando para instalarla:
pip install scikit-learn
2. Importar bibliotecas
Ejemplo
import matplotlib.pyplot as plt
from sklearn import svm, datasets
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
3. Cargar el conjunto de datos
Usaremosscikit-learnel conjunto de datos de Iris (Iris) incluido.
Ejemplo
iris = datasets.load_iris()
X = iris.data[:, :2] # Usar solo las dos primeras características
y = iris.target
4. Dividir el conjunto de entrenamiento y prueba
Ejemplo
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
5. Entrenar el modelo SVM
Ejemplo
clf = svm.SVC(kernel='linear') # Usar la función kernel lineal
# Entrenar el modelo
clf.fit(X_train, y_train)
6. Predicción y evaluación
Ejemplo
y_pred = clf.predict(X_test)
# Calcular la precisión
accuracy = accuracy_score(y_test, y_pred)
print(f"Precisión del modelo: {accuracy:.2f}")
7. Visualizar los resultados
Ejemplo
import matplotlib.pyplot as plt
from sklearn import svm, datasets
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Cargar el conjunto de datos de iris
iris = datasets.load_iris()
X = iris.data[:, :2] # Usar solo las dos primeras características
y = iris.target
# Dividir el conjunto de datos en conjunto de entrenamiento y prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Crear el clasificador SVM
clf = svm.SVC(kernel='linear') # Usar la función kernel lineal
# Entrenar el modelo
clf.fit(X_train, y_train)
# Realizar predicciones en el conjunto de prueba
y_pred = clf.predict(X_test)
# Calcular la precisión
accuracy = accuracy_score(y_test, y_pred)
print(f"Precisión del modelo: {accuracy:.2f}")
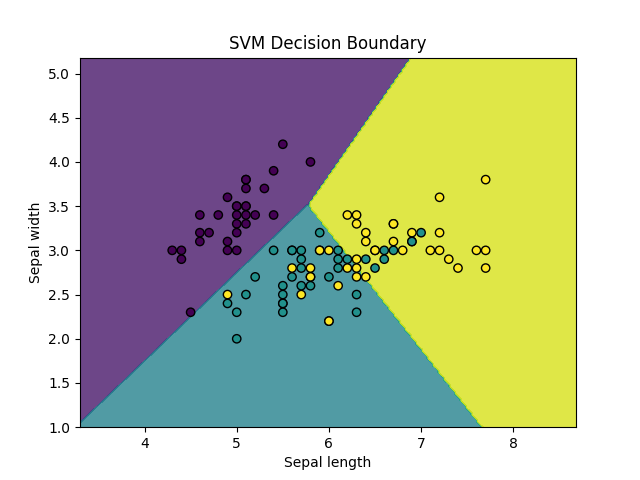
# Dibujar el límite de decisión
def plot_decision_boundary(X, y, model):
h = .02 # Tamaño de paso de la cuadrícula
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
np.arange(y_min, y_max, h))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.8)
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o')
plt.xlabel('Sepal length')
plt.ylabel('Sepal width')
plt.title('SVM Decision Boundary')
plt.show()
plot_decision_boundary(X_train, y_train, clf)
Ejecuta el código anterior, la salida es:
模型准确率: 0.80
La imagen se muestra como: