Tutorial de Ollama
Ollama es un framework de código abierto para ejecutar modelos de lenguaje grandes localmente, diseñado para implementar y ejecutar modelos de lenguaje grandes (LLM) de manera conveniente en máquinas locales.
Ollama admite múltiples sistemas operativos, incluyendo macOS, Windows, Linux, y también se puede ejecutar mediante contenedores Docker.
En pocas palabras, si servicios como ChatGPT, Claude y DeepSeeek invocan modelos de otros a través de internet, entonces Ollama es más como unentorno de ejecución de modelos de IA local。
¿Quién debería leer este tutorial?
Ollama es adecuado para desarrolladores, investigadores y usuarios con altos requisitos de privacidad de datos. Ayuda a los usuarios a implementar y ejecutar rápidamente modelos de lenguaje grandes en entornos locales, al mismo tiempo que ofrece opciones de personalización flexibles.
Con Ollama, podemos ejecutar localmente qwen3.5, Llama 3.3, DeepSeek-R1, Phi-4, Mistral, Gemma 2 y otros modelos.
| Tipo de persona | Lo que podrían querer hacer |
|---|---|
| Principiantes en IA | Entender qué es un modelo grande local, instalar Ollama, descargar, ejecutar y eliminar modelos |
| Programadores / Desarrolladores | Integrar modelos grandes en sus propias aplicaciones Python, JavaScript y Web |
| Desarrolladores de agentes de IA | Conectar modelos locales a agentes de programación como Claude Code, Codex, OpenCode, etc. |
| Usuarios comunes que quieren experimentar la IA local | Sin comprar API y sin subir datos a la nube, probar varios modelos de código abierto en su propia computadora |
¿Qué pueden hacer los desarrolladores con Ollama?
Para los desarrolladores, el valor de Ollama radica en convertir los modelos grandes en un servicio local que se puede invocar en cualquier momento.
Los usos típicos incluyen: chatbots de IA, herramientas de escritura con IA, asistentes de programación con IA, herramientas de análisis de documentos, bases de conocimiento RAG, búsqueda vectorial, agentes de IA, flujos de trabajo automatizados y aplicaciones web de IA locales.
Detrás de estas capacidades están las interfaces que proporciona Ollama, como generación de texto, chat, gestión de modelos, embeddings, etc., y admite respuestas en streaming y llamadas a herramientas.
¿Por qué los desarrolladores de agentes lo necesitan?
Si estás aprendiendo herramientas de programación con IA como Claude Code, Codex, OpenCode, etc., Ollama puede servir como backend de modelos local para ellas.
Ollama ya proporciona métodos de integración oficiales con herramientas como Claude Code, Codex, OpenCode, Copilot CLI, Droid, etc. Con un soloollama launchcomando puedes conectar modelos locales a estos flujos de trabajo de agentes. Esta parte se detallará en el capítulo de integración.
Lo que necesitas saber antes de estudiar este tutorial
Ollama en sí no es difícil. Si solo quieres ejecutar modelos, básicamente no necesitas conocimientos de programación.
Diferentes objetivos de aprendizaje requieren diferentes niveles de conocimientos básicos. Puedes evaluar tu punto de partida consultando la siguiente tabla:
| Objetivo de aprendizaje | Base necesaria |
|---|---|
| Instalar Ollama | Operación básica de computadora, fundamentos de terminal |
| Descargar y ejecutar modelos | Conocimientos básicos de línea de comandos |
| Usar la API de Ollama | Fundamentos de HTTP y JSON |
| Desarrollo en Python | Tutorial básico de Python 3.x |
| Desarrollo en JavaScript | Fundamentos de JavaScript / TypeScript |
| Desarrollo de RAG / Agentes | Python + fundamentos de modelos grandes |
| Implementación y optimización de modelos | Fundamentos de GPU, memoria de video, Linux, Docker, etc. |
Si solo quieres probar Ollama, basta con saber qué son un terminal, un comando, una carpeta y un modelo.
Si quieres desarrollar aplicaciones de IA más avanzadas, se recomienda aprender primero sobre HTTP / APIs REST, JSON, Python o JavaScript, así como el uso básico de Git y Docker.
Crear un nuevo modelo
Esta es la capacidad más central de Ollama: ejecutar modelos de código abierto en tu propia computadora o servidor, sin necesidad de construir un entorno de inferencia complejo.
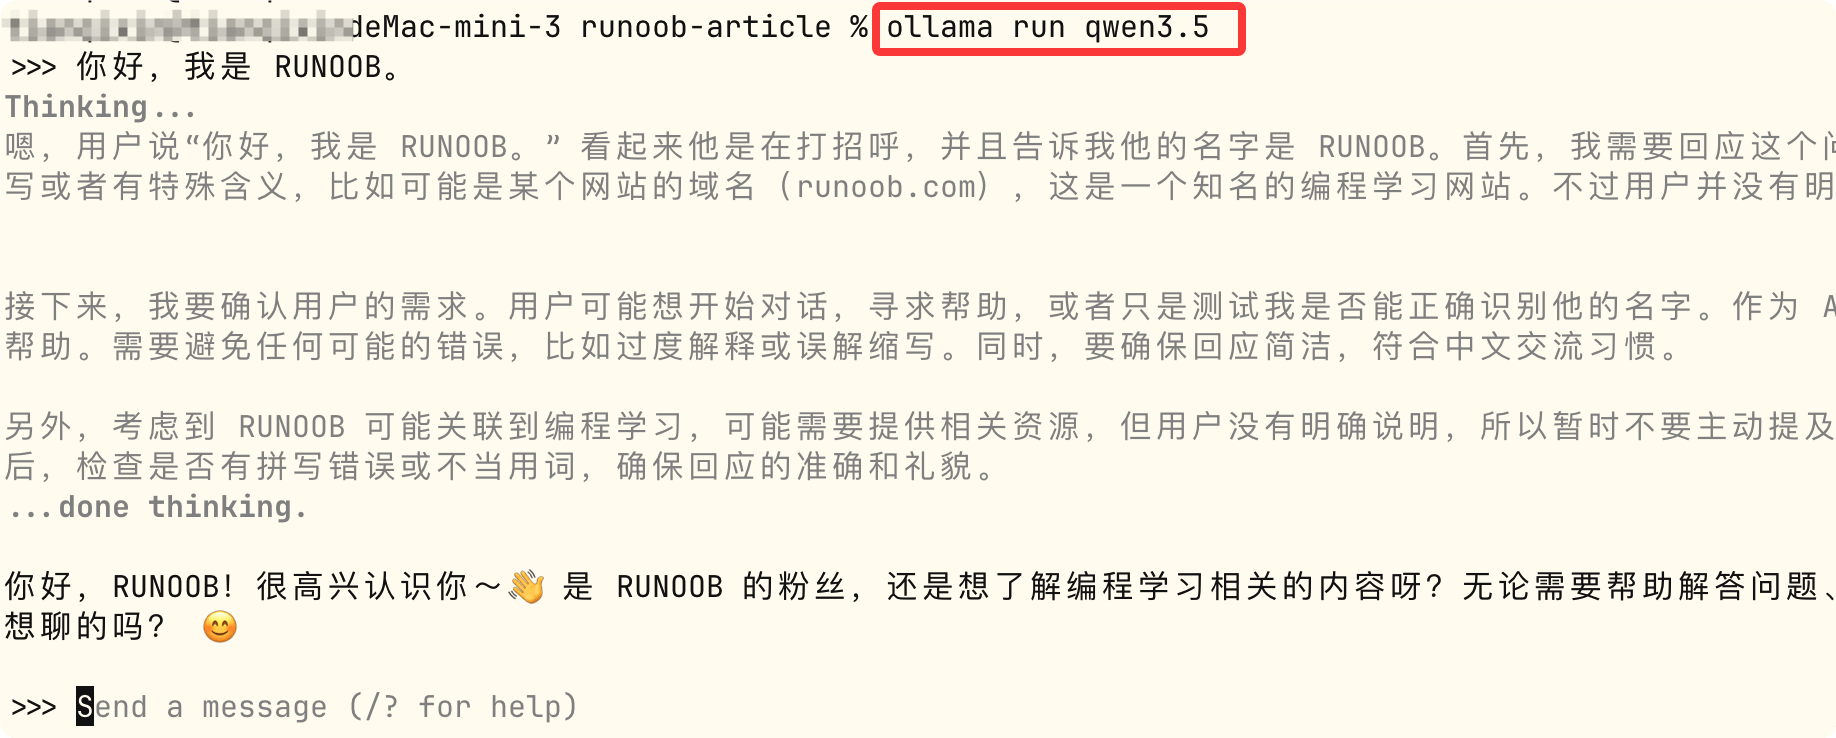
Con un solo comando se inicia, y una vez que el modelo está en ejecución puedes conversar directamente:
ollama run qwen3.5
Este comando iniciará localmente el modelo Tongyi Qianwen Qwen3.5, entrando en una terminal de conversación interactiva. Si el modelo no está disponible localmente, se descargará automáticamente primero y luego se iniciará.
Enlaces relacionados
Sitio web oficial de Ollama:https://ollama.com/
-
Dirección de código abierto en Github:https://github.com/ollama/ollama
Lista de modelos:https://ollama.com/search
-
Documentación oficial de Ollama:https://github.com/ollama/ollama/tree/main/docs