Aprendizaje automático - Ruta de aprendizaje
El aprendizaje automático es uno de los campos tecnológicos más populares en la actualidad; permite que las computadoras aprendan de los datos y hagan predicciones o tomen decisiones.
Para los principiantes, enfrentarse a una gran cantidad de algoritmos, teorías matemáticas y herramientas de programación puede resultar abrumador y no saber por dónde empezar.
Este artículo presenta una hoja de ruta de aprendizaje de aprendizaje automático que va desde cero hasta tener capacidad práctica.
| Aprendizaje automático - Lista de cursos | |
|---|---|
| Introducción básica | |
| Introducción básica | Tutorial de aprendizaje automático |
| Introducción básica | Introducción al aprendizaje automático |
| Introducción básica | Ciclo de vida del aprendizaje automático |
| Introducción básica | Cómo funciona el aprendizaje automático |
| Introducción básica | Terminología básica del aprendizaje automático |
| Introducción básica | Python para iniciarse en el aprendizaje automático |
| Introducción básica | Bibliotecas de Python para aprendizaje automático |
| Introducción básica | Tipos de datos comunes |
| Introducción básica | Aplicaciones del aprendizaje automático |
| Procesamiento de datos y estadística | |
| Procesamiento de datos y estadística | Comprensión de datos |
| Procesamiento de datos y estadística | Limpieza de datos |
| Procesamiento de datos y estadística | Ingeniería de características |
| Procesamiento de datos y estadística | Visualización de datos |
| Procesamiento de datos y estadística | División del conjunto de entrenamiento y prueba |
| Procesamiento de datos y estadística | Fundamentos de estadística |
| Procesamiento de datos y estadística | Pensamiento probabilístico |
| Procesamiento de datos y estadística | Función de pérdida y gradiente |
| Procesamiento de datos y estadística | Sobreajuste, subajuste, sesgo y varianza |
| Aprendizaje supervisado | |
| Aprendizaje supervisado | Algoritmos de aprendizaje automático |
| Aprendizaje supervisado | Regresión lineal |
| Aprendizaje supervisado | Regresión lineal múltiple |
| Aprendizaje supervisado | Regresión polinómica |
| Aprendizaje supervisado | Regresión logística |
| Aprendizaje supervisado | Evaluación de modelos de regresión |
| Aprendizaje supervisado | Árbol de decisión |
| Aprendizaje supervisado | Máquina de vectores de soporte |
| Aprendizaje supervisado | Algoritmo de K vecinos más cercanos |
| Aprendizaje supervisado | Aprendizaje conjunto |
| Aprendizaje supervisado | Naive Bayes |
| Aprendizaje supervisado | Bosque aleatorio |
| Aprendizaje supervisado | Métricas de clasificación |
| Aprendizaje no supervisado | |
| Aprendizaje no supervisado | Agrupamiento |
| Aprendizaje no supervisado | Reducción de dimensionalidad |
| Aprendizaje por refuerzo | |
| Aprendizaje por refuerzo | Marco básico del aprendizaje por refuerzo |
| Aprendizaje por refuerzo | Aprendizaje por refuerzo: exploración vs. explotación |
| Aprendizaje por refuerzo | Aprendizaje por refuerzo: Q-learning y SARSA |
| Aprendizaje por refuerzo | Aprendizaje por refuerzo profundo |
| Aprendizaje profundo | |
| Aprendizaje profundo | Estructura básica de las redes neuronales |
| Aprendizaje profundo | Propagación hacia adelante y retropropagación |
| Aprendizaje profundo | Aprendizaje profundo vs. aprendizaje automático tradicional |
| Aprendizaje profundo | Tipos de redes comunes |
| Optimización e ingeniería de modelos | |
| Optimización e ingeniería de modelos | Validación cruzada |
| Optimización e ingeniería de modelos | Regularización |
| Optimización e ingeniería de modelos | Fuga de datos |
| Optimización e ingeniería de modelos | Métodos de conjunto |
| Optimización e ingeniería de modelos | Búsqueda de hiperparámetros |
| Optimización e ingeniería de modelos | Conceptos de MLOps |
| Optimización e ingeniería de modelos | Solución de problemas comunes |
| Limitaciones y fronteras del aprendizaje automático | |
| Limitaciones y fronteras del aprendizaje automático | Problemas de interpretabilidad |
| Limitaciones y fronteras del aprendizaje automático | Limitaciones de supuestos |
| Limitaciones y fronteras del aprendizaje automático | Sesgo de datos |
| Limitaciones y fronteras del aprendizaje automático | Costo real de los modelos |
| Casos prácticos | |
| Casos prácticos | Predicción de supervivencia en el Titanic |
| Casos prácticos | Predicción de precios de viviendas |
| Casos prácticos | Segmentación de clientes |
| Casos prácticos | Visualización de PCA |
| Casos prácticos | Ejemplo de aprendizaje por refuerzo |
Etapa 1: Fundamentos - Construir una base sólida
Antes de abordar algoritmos complejos, primero necesitas construir los cimientos que sostienen el edificio del conocimiento. El objetivo de esta etapa es dominar las habilidades necesarias de matemáticas, programación y análisis de datos.
Habilidad clave 1: Lenguaje de programación (Python)
Python es el lenguaje más común en el ámbito del aprendizaje automático, muy apreciado por su sintaxis sencilla y su rico ecosistema de bibliotecas.
Objetivos de aprendizaje: Dominar la sintaxis básica de Python, estructuras de datos, funciones y programación orientada a objetos.
Bibliotecas clave:
NumPy: Se utiliza para el cálculo numérico eficiente y es la base de casi todas las bibliotecas de cálculo científico.Pandas: Es una herramienta poderosa para la limpieza, análisis y procesamiento de datos, y para manipular tablas de datos (DataFrame).Matplotlib/Seaborn: Se utiliza para la visualización de datos, convirtiendo los datos en gráficos intuitivos.
A continuación, podemos ver un ejemplo.
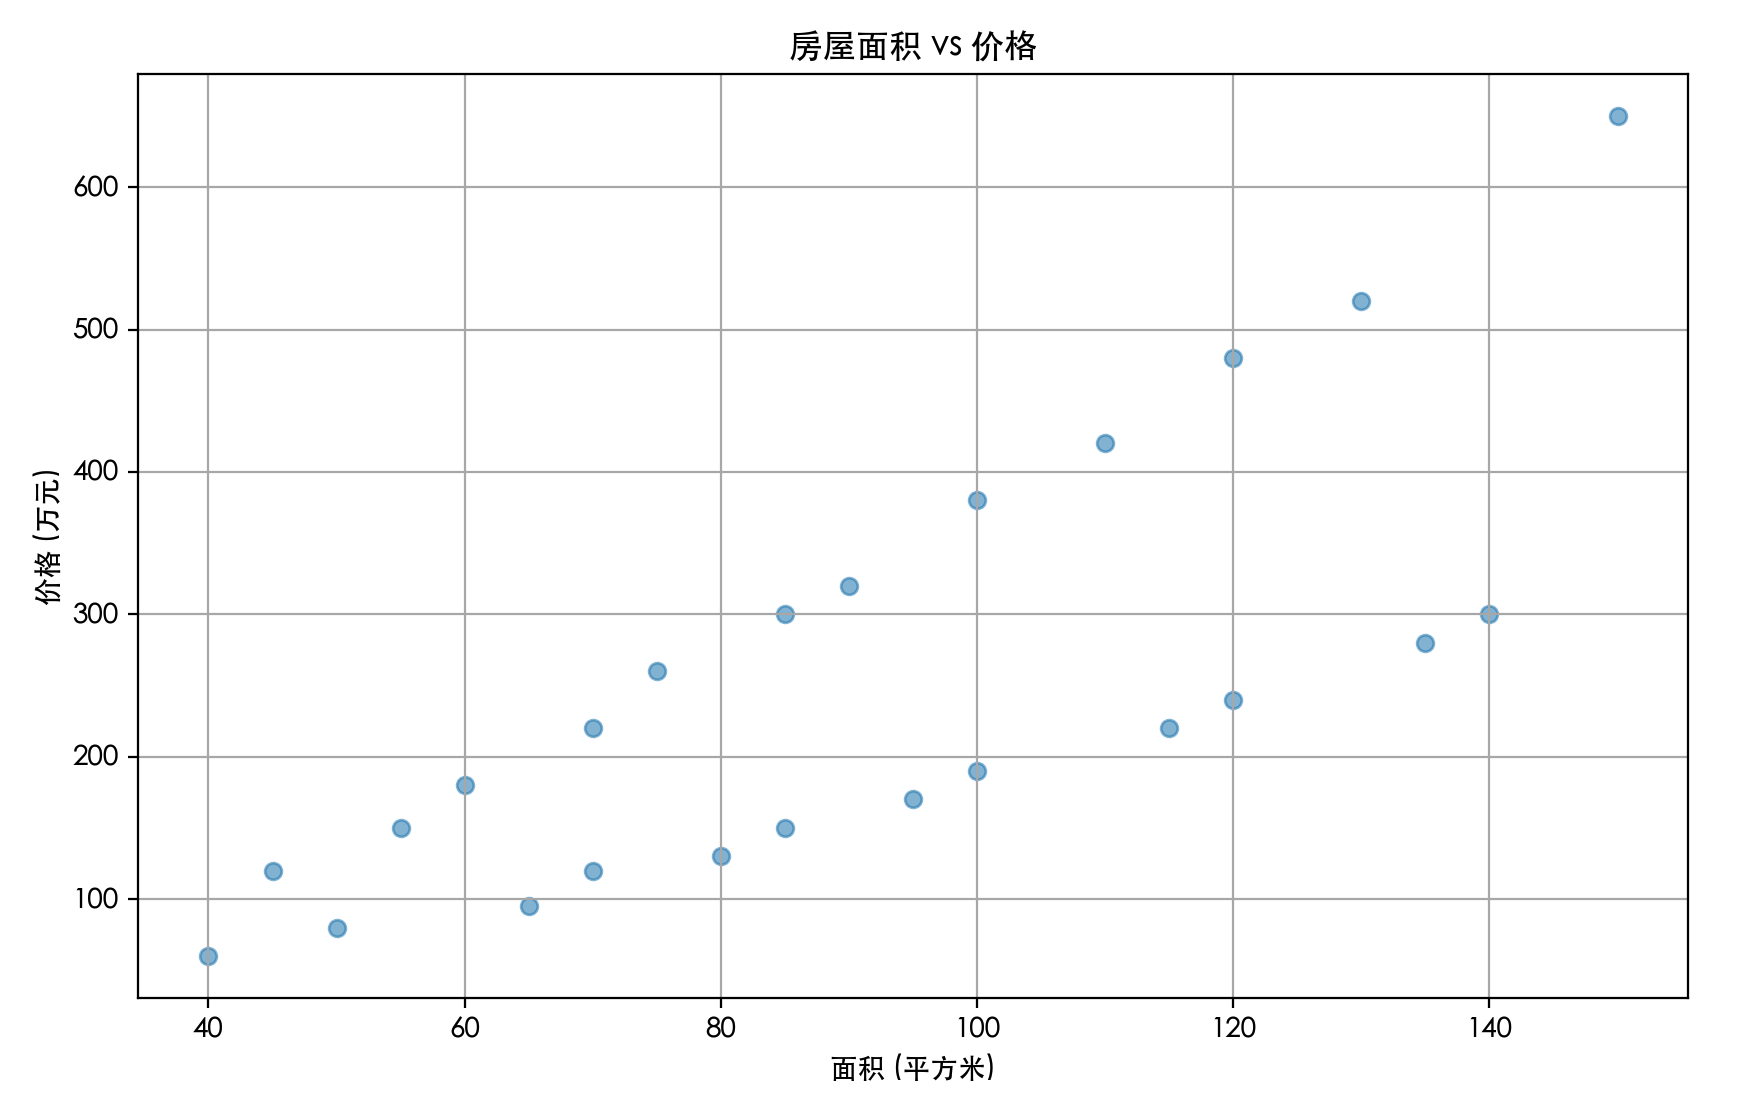
Contenido del archivo de datos de prueba house_prices.csv:
面积,价格,房龄,卧室数,城市
45,120,15,1,北京
60,180,12,2,北京
75,260,8,2,北京
90,320,6,3,北京
110,420,5,3,北京
130,520,3,4,北京
50,80,20,1,成都
70,120,15,2,成都
85,150,12,3,成都
100,190,10,3,成都
120,240,8,4,成都
140,300,5,4,成都
55,150,18,1,上海
70,220,14,2,上海
85,300,10,2,上海
100,380,8,3,上海
120,480,6,3,上海
150,650,4,4,上海
40,60,22,1,武汉
65,95,16,2,武汉
80,130,12,2,武汉
95,170,9,3,武汉
115,220,7,3,武汉
135,280,5,4,武汉
Ejemplo
import pandas as pd
import matplotlib.pyplot as plt
# -------------------------- Inicio de configuración de la fuente china --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows primero
'SimHei', 'Microsoft YaHei',
# macOS primero
'PingFang SC', 'Heiti TC',
# Linux primero
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que el signo negativo se muestra como un cuadro
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de configuración de la fuente china --------------------------
# 1. Leer los datos
data = pd.read_csv('house_prices.csv')
print("Las primeras 5 filas de datos:")
print(data.head())
# 2. Ver información básica de los datos
print("\n"Información de los datos:")
print(data.info())
# 3. Dibujar el diagrama de dispersión del área y el precio de la vivienda
plt.figure(figsize=(10, 6))
plt.scatter(data['Área'], data['Precio'], alpha=0.5)
plt.title('Área de la vivienda vs. Precio')
plt.xlabel('Área (metros cuadrados)')
plt.ylabel('Precio (10,000 yuanes)')
plt.grid(True)
plt.show()
Después de ejecutarlo, el gráfico de salida es el siguiente:
Habilidad clave 2: Conocimientos matemáticos necesarios
No necesitas ser matemático, pero debes entender la lógica básica detrás de los algoritmos.
- Álgebra lineal: Comprender vectores, matrices y multiplicación de matrices. Esto es la base para entender cómo se representan y transforman los datos en un espacio multidimensional.
- Cálculo: la clave es comprender los conceptos de derivada y derivada parcial. Son el núcleo de los algoritmos de optimización (como el descenso de gradiente), utilizados para encontrar los parámetros óptimos del modelo.
- Probabilidad y Estadística: comprender la media, la varianza, la desviación estándar, las distribuciones de probabilidad, la probabilidad condicional y el teorema de Bayes. Esto es fundamental para evaluar modelos y comprender la incertidumbre.
Metáfora: imagina el modelo de aprendizaje automático como una complejamesa de mezclas. El conocimiento matemático es el manual que te permite entender cómo cada perilla (parámetro) afecta el sonido final (resultado de la predicción). Sin el manual, solo puedes girar a ciegas.
Etapa 2: Introducción - Dominar algoritmos clásicos
Con una base sólida, puedes comenzar a explorar el núcleo del aprendizaje automático: los algoritmos. Se recomienda empezar por los algoritmos más clásicos e intuitivos.
Introducción al aprendizaje supervisado
El aprendizaje supervisado consiste en entrenar modelos con datos que ya tienen etiquetas.
- Regresión lineal: predice valores continuos (como el precio de la vivienda). Comprende su función de costo y el proceso de optimización por descenso de gradiente.
- Regresión logística: resuelve problemas de clasificación (como determinar si un correo es spam). Comprende la función Sigmoid y el límite de decisión.
- K-vecinos más cercanos (K-NN): un algoritmo simple de clasificación/regresión basado en instancias.
- Árbol de decisión: simula el proceso de decisión humano, es muy intuitivo y fácil de entender.
Introducción al aprendizaje no supervisado
El aprendizaje no supervisado se utiliza para descubrir la estructura y los patrones internos de los datos.
- Clustering K-medias: agrupa automáticamente los datos en K categorías.
- Análisis de componentes principales (PCA): se utiliza para reducir la dimensionalidad de los datos y visualizarlos, extrayendo las características más importantes.
Actualización de herramientas: en esta etapa, comienza a usar sistemáticamente lascikit-learnlibrería. Proporciona una API unificada que te permite implementar, comparar y evaluar rápidamente varios algoritmos.
Ejemplo
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, classification_report
# =========================
# 1. Crear datos de prueba ejecutables
# Escenario: aprobar o no el examen (1=aprobado, 0=no aprobado)
# Características: horas de estudio, tasa de asistencia, tasa de finalización de tareas
# =========================
X = np.array([
[2, 60, 50],
[3, 65, 55],
[4, 70, 65],
[5, 75, 70],
[6, 80, 75],
[7, 85, 80],
[8, 90, 85],
[9, 92, 88],
[10, 95, 90],
[11, 97, 92],
[1, 50, 40],
[2, 55, 45],
[3, 60, 50],
[4, 65, 55],
[5, 70, 60],
[6, 75, 65],
[7, 80, 70],
[8, 85, 75],
[9, 90, 80],
[10, 95, 85]
])
y = np.array([
0, 0, 0, 0, 1,
1, 1, 1, 1, 1,
0, 0, 0, 0, 0,
1, 1, 1, 1, 1
])
# =========================
# 2. Dividir el conjunto de entrenamiento y el conjunto de prueba
# =========================
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.3, random_state=42
)
# =========================
# 3. Crear y entrenar el modelo
# =========================
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)
# =========================
# 4. Hacer predicciones
# =========================
y_pred = model.predict(X_test)
# =========================
# 5. Evaluar el rendimiento del modelo
# =========================
print(f"Exactitud del modelo: {accuracy_score(y_test, y_pred):.2f}")
print("\nInforme de clasificación detallado:")
print(classification_report(y_test, y_pred))
Contenido de salida:
模型准确率:0.83

详细分类报告:
              precision    recall  f1-score   support

           0       0.67      1.00      0.80         2
           1       1.00      0.75      0.86         4

    accuracy                           0.83         6
   macro avg       0.83      0.88      0.83         6
weighted avg       0.89      0.83      0.84         6
Etapa 3: Avanzado - Profundizar en áreas centrales
Una vez dominados los algoritmos clásicos, puedes avanzar hacia áreas más modernas y potentes.
Profundizar en el aprendizaje automático tradicional
- Aprendizaje por conjuntos: aprende a combinar varios modelos débiles para construir un modelo fuerte.
- Bosque aleatorio: una integración de múltiples árboles de decisión, con fuerte resistencia al sobreajuste.
- Árboles de boosting de gradiente (como XGBoost, LightGBM): algoritmos de alto rendimiento extremadamente populares en competiciones y en la industria.
- Máquinas de vectores de soporte (SVM): comprende la idea central de maximizar el "margen".
- Evaluación y optimización de modelos: profundiza en la validación cruzada, el ajuste de hiperparámetros (como GridSearchCV) y los métodos para resolver el sobreajuste/subajuste.
Adentrarse en el aprendizaje profundo
Cuando los datos (especialmente imágenes, texto y voz) se vuelven complejos, el aprendizaje profundo comienza a mostrar su gran capacidad.
- Fundamentos de las redes neuronales: comprende las neuronas, las funciones de activación, la propagación hacia adelante, la retropropagación y la función de pérdida.
- Frameworks de aprendizaje profundo: elige
PyTorch(amigable para la investigación, flexible) oTensorFlow/Keras(maduro para producción, ecosistema completo), estudia uno de ellos en profundidad. - Red neuronal convolucional (CNN): es el estándar para procesar datos de imágenes; comprende el papel de las capas convolucionales y de pooling.
- Redes neuronales recurrentes (RNN) y redes de memoria a largo y corto plazo (LSTM): herramientas poderosas para procesar datos secuenciales (como texto, series temporales).
Ejemplo
from tensorflow import keras
from tensorflow.keras import layers
model = keras.Sequential([
layers.Dense(64, activation='relu', input_shape=(input_dim,)), # Capa oculta 1
layers.Dropout(0.2), # Capa de dropout, para evitar el sobreajuste
layers.Dense(32, activation='relu'), # Capa oculta 2
layers.Dense(1, activation='sigmoid') # Capa de salida, para clasificación binaria
])
model.compile(optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy'])
model.summary() # Imprimir la estructura del modelo
# Después se puede usar model.fit para entrenar
Etapa 4: Aplicación y expansión - Enfocar direcciones, resolver problemas reales
Hay muchas ramas en el aprendizaje automático; en este punto debes elegir una dirección para profundizar según tus intereses o plan profesional.
Elección de direcciones principales
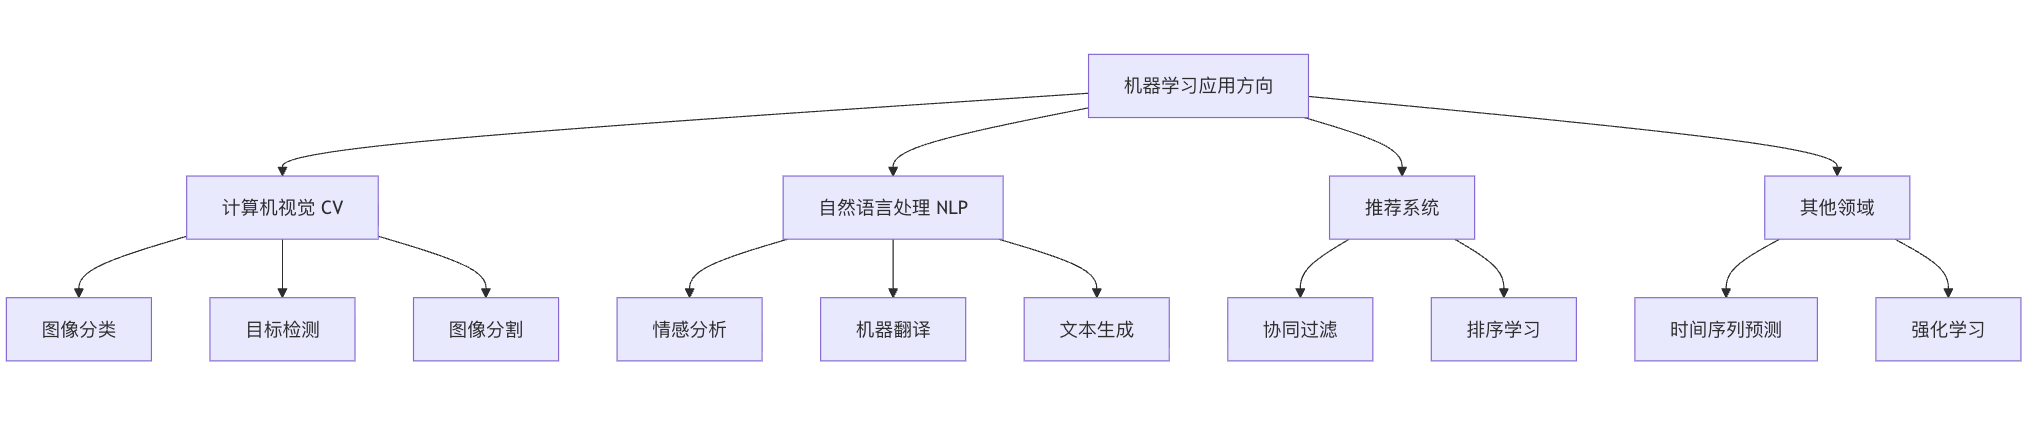
- Visión por computadora (CV): profundiza en las variantes de CNN (ResNet, YOLO), aprende segmentación de imágenes y detección de objetos.
- Procesamiento del lenguaje natural (NLP): desde incrustaciones de palabras (Word2Vec) hasta la arquitectura Transformer (BERT, GPT), domina la clasificación de texto, el análisis de sentimientos y la traducción automática.
- Sistemas de recomendación: aprende filtrado colaborativo, factorización de matrices y modelos de recomendación por aprendizaje profundo.
- Aprendizaje por refuerzo: hace que un agente aprenda la política óptima interactuando con el entorno; es el núcleo de la IA en juegos y el control robótico.
Ingeniería e implementación
Aprende a desplegar modelos entrenados en un entorno de producción para ofrecer un servicio real.
- Guardado y carga de modelos(
pickle,joblib,.h5archivo). - Construir un servicio API simple con Flask/FastAPI。
- Conocer la contenedorización con Dockery los conceptos básicos de los servicios en la nube (como AWS SageMaker, Google AI Platform).
Resumen y recursos recomendados
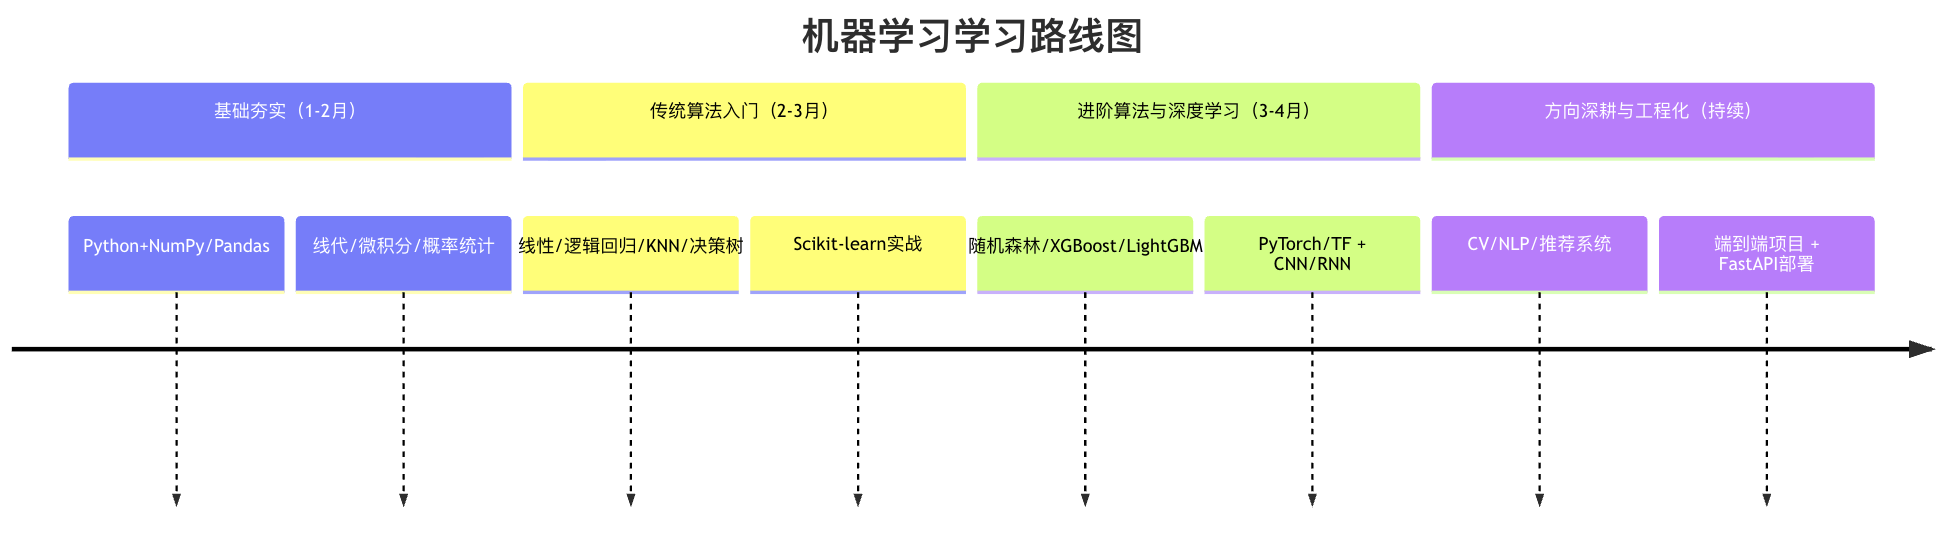
Visualización de la ruta de aprendizaje
La práctica es el único atajo
El consejo más importante:¡Aprende haciendo, impulsado por proyectos!
- Imitación: reproduce proyectos de tutoriales y artículos.
- Práctica: participa en competiciones de nivel inicial en plataformas como Kaggle, Tianchi.
- Creación: intenta resolver un pequeño problema que te interese personalmente con aprendizaje automático (como analizar tus datos de ejercicio, clasificar automáticamente tus colecciones de fotos).
Recomendación de recursos de calidad
- Cursos clásicos: 'Machine Learning' de Andrew Ng (Coursera), 'Aprendizaje profundo práctico' de Li Mu.
- Plataformas de práctica: Kaggle (competiciones y conjuntos de datos), Colab / Jupyter Notebook (entorno gratuito en la nube).
- Consolidación de conocimientos: leer la
scikit-learn、PyTorchdocumentación oficial, y participa en Stack Overflow y comunidades de foros relacionados.