Marco básico del aprendizaje por refuerzo
Imagina que le estás enseñando a un cachorro la orden de “sentarse”. No le dices directamente cómo debe mover cada músculo para sentarse, sino que haces lo siguiente:
- Emites la orden de sentarse.
- El cachorro intenta realizar alguna acción (puede ser sentarse, echarse o girar).
- Si se sienta, le das inmediatamente una golosina como recompensa.
- Si lo hace mal, no le das recompensa o emites una leve señal de que no es correcto.
- Después de muchos intentos, el cachorro va comprendiendo: al oír “sentarse” y realizar la acción de sentarse, obtiene una golosina. Así aprende la orden.
El aprendizaje por refuerzoconsiste en hacer que una computadora (o agente), como este cachorro, aprenda a tomar una serie de decisiones para lograr un objetivo a largo plazo mediante la interacción con el entorno y según las recompensas o castigos obtenidos.
Es fundamentalmente diferente delaprendizaje supervisado(con un “maestro” que tiene las respuestas estándar) y delaprendizaje no supervisado(que busca la estructura interna de los datos). El aprendizaje por refuerzo esaprender de la experiencia, cuyo núcleo esel ensayo y erroryla recompensa retrasada。
Elementos centrales del aprendizaje por refuerzo
Para formalizar este proceso de aprendizaje, introducimos varios conceptos centrales que, en conjunto, constituyen el marco básico del aprendizaje por refuerzo.
Agente y entorno
Esta es la relación de interacción más básica en el aprendizaje por refuerzo.
- Agente: Es el sujeto que aprende, la entidad que toma decisiones. En el ejemplo anterior, el cachorro es el agente. En una computadora, puede ser un algoritmo, un programa o un robot.
- Entorno: Es el mundo exterior en el que se encuentra el agente y con el cual interactúa. Para el cachorro, el entorno eres tú, las golosinas, el suelo y todo lo externo. El entorno recibe las acciones del agente y entrega un nuevo estado y una recompensa.
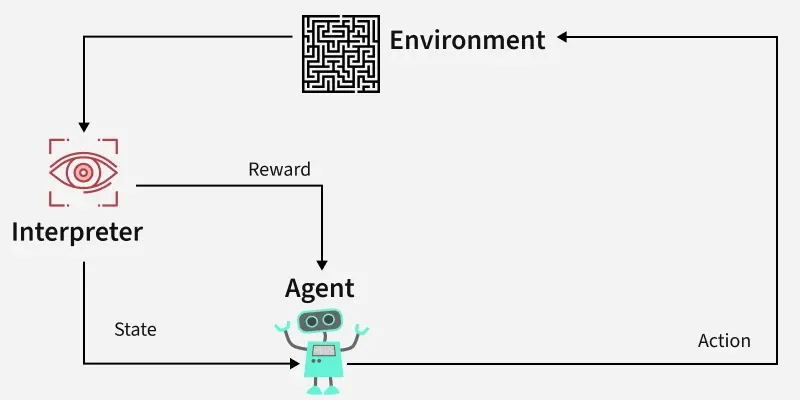
Su relación es un ciclo continuo:El agente observa el entorno -> realiza una acción -> el entorno devuelve un nuevo estado y recompensa -> el agente observa de nuevo...
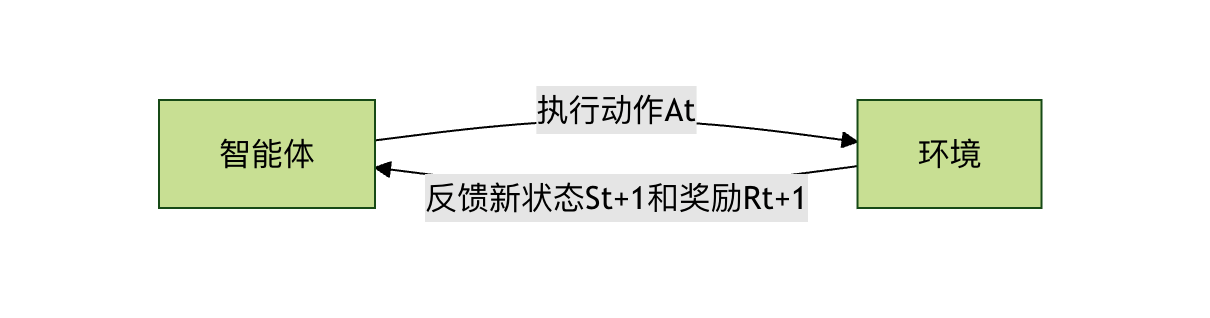
Estado, acción y recompensa
Estos son los tres datos clave que describen cada interacción.
- Estado: En un momento dado, es la descripción completa de la situación del entorno. Por ejemplo, en el caso de enseñar al cachorro, el estado puede incluir: el cachorro está de pie, tienes una golosina en la mano, acabas de decir “sentarse”. El estado es la base sobre la cual el agente toma decisiones.
- Acción: Es la elección que el agente puede tomar en un estado determinado. Para el cachorro, el conjunto de acciones podría ser {sentarse, echarse, ponerse de pie, girar...}.
- Recompensa: Es una señal escalar que el entorno devuelve al agente después de que este ejecuta una acción. Definequé es bueno y qué es malo.La recompensa es la única brújula del aprendizaje del agente. Dar una golosina al cachorro es una recompensa positiva (+1), y decirle “no es correcto” puede considerarse una recompensa negativa leve (-0.1).
Política
PolíticaEs el cerebro o la regla de comportamiento del agente. Define qué acción debe tomar el agente en cualquier estado dado.
Una política puede ser una simple función de búsqueda en tabla o una compleja red neuronal profunda. El objetivo final del aprendizaje por refuerzo es encontrar unapolítica óptima, de modo que la recompensa acumulada a largo plazo que el agente obtiene del entornosea maximizada.。
- Ejemplo: Una política simple podría ser: si el estado es “oír la orden de sentarse”, entonces elegir la acción de sentarse con un 90% de probabilidad y elegir otras acciones con un 10% de probabilidad.
Función de valor
La recompensa le dice al agentelo bueno o malo inmediato de laacción actual, pero el agente debe preocuparse más por elbeneficio a largoplazo.Función de valorEs la herramienta utilizada para medir ese beneficio a largo plazo.
La pregunta que responde es: desde el estado actual, siguiendo siempre una política determinada,¿cuánta recompensa total se esperapoder obtener?
- Función de valor de estado V(s): Mide, en el estado
ss, el valor a largo plazo de seguir la política actual. - Función de valor de acción Q(s, a): Mide, en el estado
ss,después de ejecutar una acción específicaay luego seguir la política actual, el valor a largo plazo. Es más utilizada que la función de valor de estado porque puede guiar directamente la selección de acciones.
¿Por qué se necesita la función de valor?Imagina un juego de ajedrez. Comer un peón del oponente da una pequeña recompensa inmediata, pero puede llevar a que diez movimientos después te den “jaque mate” y obtengas una gran recompensa negativa. La función de valor, mediante el cálculo y la estimación, ayuda al agente a evitar ese comportamiento de dejarse llevar por la pequeña ganancia y perder la partida.
Proceso central de interacción: Proceso de Decisión de Markov
Los problemas de aprendizaje por refuerzo suelen modelarse como unProceso de Decisión de Markov. Este nombre suena complejo, pero en realidad es solo un marco estándar que organiza matemáticamente los elementos mencionados anteriormente para describir la interacción entre el agente y el entorno.
La idea central del MDP es:El siguiente estado y la recompensa dependen solo del estado actual y de la acción tomada actualmente, sin relación con el historial anterior.(es decir, la propiedad de Markov).
Un ciclo de interacción MDP completo es el siguiente:
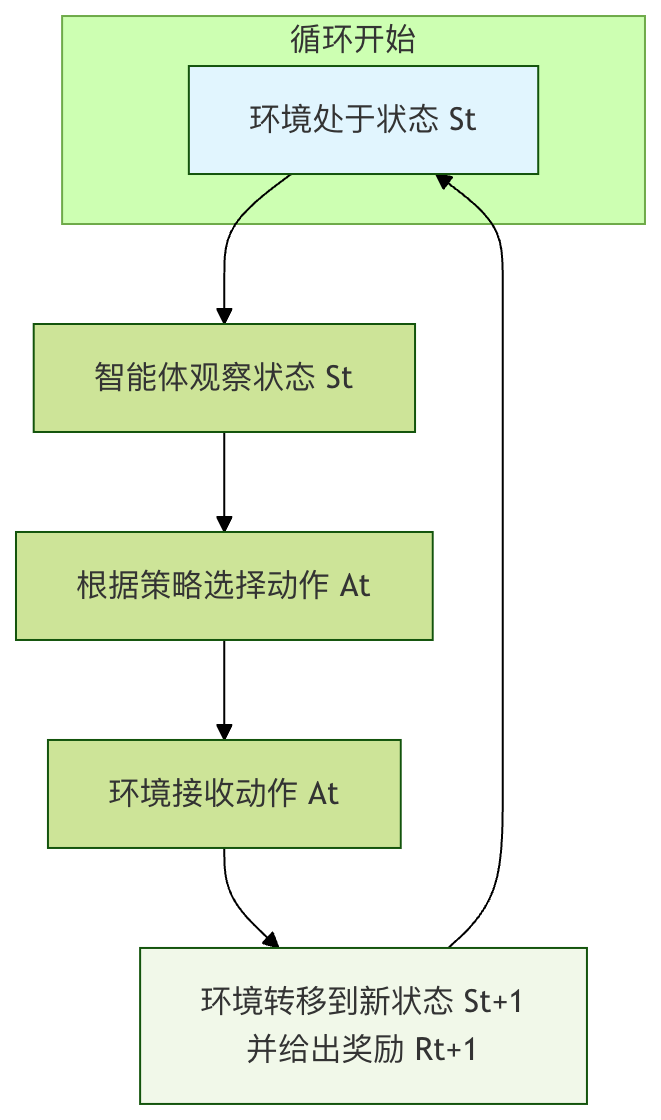
- En el instante t,
tel entorno se encuentra en el estado s,S_t。 - El agente observa este estado.
- El agente, según su política π,
πselecciona una acción a.A_t。 - El entorno recibe esta acción.
- El entorno, de acuerdo con su dinámica interna, transita al siguiente estado s',
S_{t+1}y genera una recompensa escalar r,R_{t+1}que retroalimenta al agente. - El paso de tiempo avanza (t ← t+1),
t = t+1y comienza un nuevo ciclo.
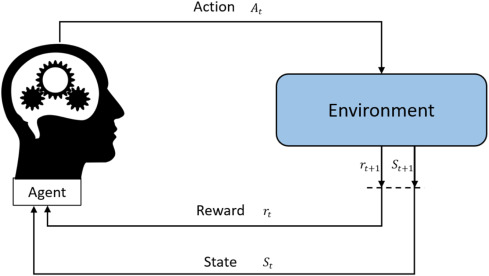
El objetivo del agente es, mediante la repetición continua de este ciclo, aprender una políticaπ*, tal que, comenzando desde cualquier estado inicial, laesperanza de la recompensa acumulada (es decir, el retorno) se maximice.。
Un ejemplo sencillo de código: el mundo de la cuadrícula (Grid World)
Usemos un ejemplo clásico de mundo de cuadrícula para concretar estos conceptos. Supongamos que hay una cuadrícula de 4x4; el agente parte desde el punto de inicioSy su objetivo es llegar al punto finalG. Si se encuentra con un obstáculo#falla, y cada paso tiene una pequeña penalización (para fomentar llegar lo antes posible).
S . . .
. # . .
. . # .
. . . G
- Estado: Las coordenadas de cada celda, como (0,0), (0,1)... (3,3). Hay 16 estados en total.
- Acción: {arriba, abajo, izquierda, derecha}.
- Recompensa:
- Llegar a la meta
G: +10 - Chocar con un obstáculo
#o salir del límite: -5 - Otros movimientos normales: -0.1 (fomenta rutas eficientes)
- Llegar a la meta
- Política: Necesitamos aprender una tabla que registre, en cada estado (celda), hacia qué dirección se debe ir.
A continuación se muestra una demostración en pseudocódigo de Q-learning (un algoritmo clásico de aprendizaje por refuerzo) muy simplificada, para aprender la ruta óptima en este mundo de cuadrícula.
Ejemplo
import random
from typing import Dict, List, Tuple
# ====================== 1. Simulación del entorno (mundo de cuadrícula) ======================
class GridWorldEnv:
"""Entorno simple de mundo de cuadrícula para demostrar Q-Learning"""
def __init__(self, grid_size: Tuple[int, int] = (5, 5),
start_pos: Tuple[int, int] = (0, 0),
goal_pos: Tuple[int, int] = (4, 4),
obstacle_pos: List[Tuple[int, int]] = [(1, 1), (2, 2), (3, 1)]):
self.grid_size = grid_size
self.start_pos = start_pos
self.goal_pos = goal_pos
self.obstacle_pos = obstacle_pos
self.current_pos = start_pos
# Definición de acciones: 0-arriba, 1-abajo, 2-izquierda, 3-derecha
self.actions = ['up', 'down', 'left', 'right']
self.num_actions = len(self.actions)
def reset(self) -> int:
"""Reinicia el entorno y devuelve el índice del estado inicial"""
self.current_pos = self.start_pos
return self.pos_to_state(self.current_pos)
def pos_to_state(self, pos: Tuple[int, int]) -> int:
"""Convierte la posición de coordenadas al índice de estado"""
return pos[0] * self.grid_size[1] + pos[1]
def state_to_pos(self, state: int) -> Tuple[int, int]:
"""Convierte el índice de estado a la posición de coordenadas"""
return (state // self.grid_size[1], state % self.grid_size[1])
def random_action(self) -> int:
"""Selecciona una acción aleatoria (exploración)"""
return random.randint(0, self.num_actions - 1)
def action_to_direction(self, action: int) -> str:
"""Convierte el índice de acción al nombre de la dirección"""
return self.actions[action]
def step(self, action: int) -> Tuple[int, float, bool]:
"""
Ejecuta la acción y devuelve (next_state, reward, done)
Punto de optimización: corregir el bug de que la recompensa por obstáculo no se activaba; simplificar la lógica de decisión.
"""
x, y = self.current_pos
# Actualiza la posición según la acción
if action == 0: # Arriba
x = max(0, x - 1)
elif action == 1: # Abajo
x = min(self.grid_size[0] - 1, x + 1)
elif action == 2: # Izquierda
y = max(0, y - 1)
elif action == 3: # Derecha
y = min(self.grid_size[1] - 1, y + 1)
# Comprueba si se ha chocado con un obstáculo (arreglo central: registrar primero si se ha chocado y luego procesar la posición)
new_pos = (x, y)
hit_obstacle = False # Marca si se ha chocado con un obstáculo
if new_pos in self.obstacle_pos:
hit_obstacle = True # Registra el estado de colisión con obstáculo
new_pos = self.current_pos # Si se choca con un obstáculo, la posición no cambia
self.current_pos = new_pos
next_state = self.pos_to_state(new_pos)
# Calcula la recompensa (basada en hit_obstacle registrado previamente; corrige la contradicción lógica original)
if new_pos == self.goal_pos:
reward = 100.0 # Llegar a la meta, gran recompensa
done = True
elif hit_obstacle: # Juicio basado en la marca, no en el new_pos modificado
reward = -50.0 # Chocar con obstáculo, penalización
done = False
else:
reward = -1.0 # Pequeña penalización por cada paso, anima a llegar a la meta lo antes posible
done = False
return next_state, reward, done
# ====================== 2. Programa principal de Q-Learning ======================
if __name__ == "__main__":
# Punto de optimización 1: fijar la semilla aleatoria para garantizar la reproducibilidad de los resultados experimentales
random_seed = 42
random.seed(random_seed)
np.random.seed(random_seed)
# Inicializar el entorno
env = GridWorldEnv(
grid_size=(5, 5), # Cuadrícula de 5x5
start_pos=(0, 0), # Punto de inicio
goal_pos=(4, 4), # Punto de meta
obstacle_pos=[(1,1), (2,2), (3,1)] # Posición de los obstáculos
)
# Calcular el número de estados
num_states = env.grid_size[0] * env.grid_size[1]
num_actions = env.num_actions
# Inicializar la tabla Q (función de valor de acción), con forma [número de estados, número de acciones]
Q_table = np.zeros([num_states, num_actions])
# Definir hiperparámetros
learning_rate = 0.1 # Tasa de aprendizaje
discount_factor = 0.9 # Factor de descuento
epsilon = 0.1 # Tasa de exploración
total_episodes = 1000 # Número de épocas de entrenamiento
# Proceso de entrenamiento
for episode in range(total_episodes):
state = env.reset() # Reiniciar el entorno al punto de inicio, obtener el estado inicial S
done = False # Marcar si el episodio actual ha terminado
total_reward = 0 # Registrar la recompensa total del episodio actual
while not done:
# 1. Selección de acción con política ε-greedy
if random.uniform(0, 1) < epsilon:
action = env.random_action() # Exploración: seleccionar acción aleatoria
else:
# Explotación: seleccionar la acción con mayor valor Q, manejar empates
q_values = Q_table[state]
max_q = np.max(q_values)
best_actions = np.where(q_values == max_q)[0]
action = random.choice(best_actions) # En caso de empate, seleccionar uno aleatoriamente
# 2. Ejecutar la acción e interactuar con el entorno
next_state, reward, done = env.step(action)
total_reward += reward
# 3. Actualizar la tabla Q (núcleo: fórmula de Q-Learning)
# Q(S, A) = Q(S, A) + α * [ R + γ * max(Q(S', a')) - Q(S, A) ]
old_value = Q_table[state, action]
next_max = np.max(Q_table[next_state]) # Valor Q máximo del siguiente estado
# Calcular el valor Q objetivo
target = reward + discount_factor * next_max
# Actualizar el valor Q
new_value = old_value + learning_rate * (target - old_value)
Q_table[state, action] = new_value
# 4. Pasar al siguiente estado
state = next_state
# Imprimir el progreso del entrenamiento cada 100 episodios
if (episode + 1) % 100 == 0:
print(f"Episode {episode + 1}/{total_episodes}, Total Reward: {total_reward:.1f}")
# ====================== 3. Extraer la política óptima (optimizar el formato de impresión, más intuitivo) ======================
policy: Dict[int, str] = {}
print("\n=== Política óptima tras el aprendizaje (dispuesta en cuadrícula) ===")
# Punto de optimización 2: imprimir en forma de cuadrícula para mostrar intuitivamente la política de toda la cuadrícula
grid_rows, grid_cols = env.grid_size
for row in range(grid_rows):
row_str = []
for col in range(grid_cols):
pos = (row, col)
state = env.pos_to_state(pos)
if pos in env.obstacle_pos:
row_str.append(" Obstáculo ")
elif pos == env.goal_pos:
row_str.append(" Meta ")
elif pos == env.start_pos:
# Marcar también el punto de inicio y su acción óptima
best_action_idx = np.argmax(Q_table[state])
best_action = env.action_to_direction(best_action_idx)
row_str.append(f" Inicio({best_action}) ")
else:
best_action_idx = np.argmax(Q_table[state])
best_action = env.action_to_direction(best_action_idx)
policy[state] = best_action
row_str.append(f" {best_action} ")
print("|".join(row_str))
# ====================== 4. Probar la política óptima ======================
print("\n=== Probar la política óptima ===")
state = env.reset()
done = False
steps = 0
path = [env.state_to_pos(state)]
while not done and steps < 50: # Máximo 50 pasos para evitar bucles infinitos
best_action_idx = np.argmax(Q_table[state])
next_state, reward, done = env.step(best_action_idx)
current_pos = env.state_to_pos(next_state)
path.append(current_pos)
state = next_state
steps += 1
print(f"Ruta: {path}")
print(f"Pasos para llegar a la meta: {steps}")
print(f"¿Llegó a la meta?: {env.current_pos == env.goal_pos}")
Análisis del código:
Q_tablees la función de valor de acción central, con forma de[número de estados, número de acciones](en el ejemplo es 25×4, correspondiente a los 25 estados de la cuadrícula de 5×5 y las 4 acciones: arriba, abajo, izquierda, derecha).Q_table[s, a]representa en el estados(índice de la posición en la cuadrícula) ejecutar la accióna(0-3 corresponden a arriba, abajo, izquierda, derecha) el valor a largo plazo, inicialmente todos en 0, se actualizan gradualmente mediante el entrenamiento.env.step(action)Simula la lógica de interacción central del Proceso de Decisión de Markov (MDP): tras introducir el índice de acción, primero actualiza la posición del agente en la cuadrícula (si choca con un obstáculo, la posición no cambia), y luego devuelve una tupla de tres elementos(next_state, reward, done)——next_statees el índice del nuevo estado,rewardes la recompensa diferenciada (meta +100, obstáculo -50, cada paso -1),donemarca si se ha llegado a la meta (fin del episodio actual).- La fórmula central de actualización de Q-Learning
Q(S,A) = Q(S,A) + α * [R + γ * max(Q(S', a')) - Q(S,A)]se implementa desglosada en el código: primero se obtiene el valor Q actualold_value, luego se calcula el valor Q máximo del siguiente estadonext_max, después se calcula el valor objetivotarget = 奖励 + 折扣因子 × 下一状态最大Q值, y finalmente con la tasa de aprendizajeαse combinan el valor anterior y el valor objetivo para obtener el valor Q actualizado, logrando la corrección iterativa del valor de las acciones. epsilon(tasa de exploración) equilibra "explotación" y "exploración" mediante la política ε-greedy: con probabilidadepsilonseleccionar una acción aleatoria (explorar lo desconocido), con probabilidad1-epsilonseleccionar la acción con mayor valor Q en el estado actual (explotar el óptimo conocido); el código también optimiza el caso de empate en valores Q: si varias acciones tienen el mismo valor Q, se elige una aleatoriamente para evitar la rigidez de la política causada por una selección única.- El código además implementa el mapeo bidireccional entre estados y posiciones de la cuadrícula (
pos_to_state/state_to_pos), la conversión entre acciones y nombres de direcciones (action_to_direction), así como la extracción y prueba de la política tras el entrenamiento: recorrer todos los estados, tomar la acción con mayor valor Q en cada estado como política óptima, y verificar la ruta y los pasos de dicha política desde el inicio hasta la meta.
Episode 100/1000, Total Reward: 93.0
Episode 200/1000, Total Reward: 90.0
Episode 300/1000, Total Reward: 92.0
Episode 400/1000, Total Reward: 90.0
Episode 500/1000, Total Reward: 93.0
Episode 600/1000, Total Reward: 93.0
Episode 700/1000, Total Reward: 91.0
Episode 800/1000, Total Reward: 93.0
Episode 900/1000, Total Reward: 93.0
Episode 1000/1000, Total Reward: 93.0

=== 学习完成后的最优策略 ===
位置 (0, 0): 最优动作 = right
位置 (0, 1): 最优动作 = right
位置 (0, 2): 最优动作 = down
位置 (0, 3): 最优动作 = down
位置 (0, 4): 最优动作 = down
位置 (1, 0): 最优动作 = up
位置 (1, 1): 最优动作 = 障碍物
位置 (1, 2): 最优动作 = right
位置 (1, 3): 最优动作 = down
位置 (1, 4): 最优动作 = left
位置 (2, 0): 最优动作 = down
位置 (2, 1): 最优动作 = down
位置 (2, 2): 最优动作 = 障碍物
位置 (2, 3): 最优动作 = down
位置 (2, 4): 最优动作 = down
位置 (3, 0): 最优动作 = down
位置 (3, 1): 最优动作 = 障碍物
位置 (3, 2): 最优动作 = right
位置 (3, 3): 最优动作 = right
位置 (3, 4): 最优动作 = down
位置 (4, 0): 最优动作 = right
位置 (4, 1): 最优动作 = right
位置 (4, 2): 最优动作 = right
位置 (4, 3): 最优动作 = right
位置 (4, 4): 最优动作 = 终点

=== 测试最优策略 ===
路径: [(0, 0), (0, 1), (0, 2), (1, 2), (1, 3), (2, 3), (3, 3), (3, 4), (4, 4)]
到达终点步数: 8
是否到达终点: True
Resumen y reflexión práctica
El marco básico del aprendizaje por refuerzo se puede resumir como:El agente interactúa con el entorno mediante un proceso de decisión de Markov, y según las señales de recompensa obtenidas, optimiza continuamente su política (generalmente aprendiendo y actualizando funciones de valor), con el objetivo final de maximizar la recompensa acumulada a largo plazo.
| Concepto | Analogía | Función en el aprendizaje por refuerzo |
|---|---|---|
| Agente | Perrito que aprende / IA que juega al ajedrez | Sujeto de decisión, ejecuta el algoritmo de aprendizaje |
| Entorno | Entrenador / reglas del tablero | Sistema externo que proporciona estados y retroalimentación de recompensas |
| Estado | Postura del perrito / situación del tablero | Base de información actual del agente para tomar decisiones |
| Acción | Sentarse / mover una pieza | Elecciones que el agente puede tomar |
| Recompensa | Golosina / resultado de ganar o perder | Señal inmediata que evalúa la calidad de las acciones, brújula del aprendizaje |
| Política | Reacción a órdenes que el perrito ha aprendido | Regla de mapeo de estados a acciones, objetivo del aprendizaje |
| Función de valor | Juicio a largo plazo sobre la situación | Evalúa el valor a largo plazo de estados o acciones, es la base de la optimización de políticas |