Regresión Lineal (Linear Regression)
La regresión lineal (Linear Regression) es uno de los algoritmos más básicos y ampliamente utilizados en el aprendizaje automático.
La regresión lineal (Linear Regression) es el algoritmo de aprendizaje automático más básico para predecir valores continuos. Supone que entre la variable objetivoyy la variable de característicasxexiste una relación lineal, e intenta encontrar la línea de mejor ajuste para describir esta relación.
y = w * x + b
Donde:
yes el valor predichoxes la variable de característicaswes el peso (pendiente)bes el sesgo (intersección)
El objetivo de la regresión lineal es encontrar los mejoreswyb, de modo que el valor predichoytenga un error mínimo con el valor real. La función de error más común es el error cuadrático medio (MSE):
MSE = 1/n * Σ(y_i - y_pred_i)^2
Donde:
- y_i es el valor real.
- y_pred_i es el valor predicho.
- n es el número de puntos de datos.
Nuestro objetivo es minimizar el MSE ajustando w y b.
¿Cómo resolver la regresión lineal?
1. Método de mínimos cuadrados
El método de mínimos cuadrados es un método común para resolver la regresión lineal. Encuentra los mejores (w) y (b) resolviendo la siguiente ecuación.
El objetivo del método de mínimos cuadrados es minimizar la suma de cuadrados de los residuos (RSS), cuya fórmula es:
\[ \text{RSS} = \sum_{i=1}^n (y_i - \hat{y}_i)^2 \]
Donde:
\( y_i \)es el valor real.\( \hat{y}_i \)es el valor predicho, calculado mediante el modelo de regresión lineal\( \hat{y}_i = w x_i + b \).
Al minimizar la RSS, se puede obtener la siguiente ecuación normal:
\[ \begin{cases} w \sum_{i=1}^n x_i^2 + b \sum_{i=1}^n x_i = \sum_{i=1}^n x_i y_i \\ w \sum_{i=1}^n x_i + b n = \sum_{i=1}^n y_i \end{cases} \]
Forma matricial
Escribiendo la ecuación normal en forma matricial:
\[ \begin{bmatrix} \sum_{i=1}^n x_i^2 & \sum_{i=1}^n x_i \\ \sum_{i=1}^n x_i & n \end{bmatrix} \begin{bmatrix} w \\ b \end{bmatrix} = \begin{bmatrix} \sum_{i=1}^n x_i y_i \\ \sum_{i=1}^n y_i \end{bmatrix} \]
Método de solución
Resolviendo la ecuación matricial anterior, se pueden obtener los mejores\( w \)y\( b \):
\[ \begin{bmatrix} w \\ b \end{bmatrix} = \begin{bmatrix} \sum_{i=1}^n x_i^2 & \sum_{i=1}^n x_i \\ \sum_{i=1}^n x_i & n \end{bmatrix}^{-1} \begin{bmatrix} \sum_{i=1}^n x_i y_i \\ \sum_{i=1}^n y_i \end{bmatrix} \]
2. Método de descenso de gradiente
El objetivo del método de descenso de gradiente es minimizar la función de pérdida\( J(w, b) \) . Para el problema de regresión lineal, se suele usar el error cuadrático medio (MSE) como función de pérdida:
\[ J(w, b) = \frac{1}{2m} \sum_{i=1}^m (y_i - \hat{y}_i)^2 \]
Donde:
\( m \)es el número de muestras.\( y_i \)es el valor real.\( \hat{y}_i \)es el valor predicho, calculado mediante el modelo de regresión lineal\( \hat{y}_i = w x_i + b \).
El gradiente es la derivada parcial de la función de pérdida con respecto a los parámetros, e indica la dirección de cambio de la función de pérdida en el espacio de parámetros. Para la regresión lineal, el gradiente se calcula de la siguiente manera:
\[ \frac{\partial J}{\partial w} = -\frac{1}{m} \sum_{i=1}^m x_i (y_i - \hat{y}_i) \]
\[ \frac{\partial J}{\partial b} = -\frac{1}{m} \sum_{i=1}^m (y_i - \hat{y}_i) \]
Regla de actualización de parámetros
El método de descenso de gradiente actualiza los parámetros mediante la siguiente regla\( w \)y\( b \):
\[ w := w - \alpha \frac{\partial J}{\partial w} \]
\[ b := b - \alpha \frac{\partial J}{\partial b} \]
Donde:
\( \alpha \)es la tasa de aprendizaje (learning rate), que controla el tamaño del paso en cada actualización.
Pasos del método de descenso de gradiente
- Inicializar parámetros: Inicializar el valor de
\( w \)y\( b \)(generalmente establecido en 0 o un valor aleatorio). - Calcular la función de pérdida: Calcular el valor de la función de pérdida con los parámetros actuales
\( J(w, b) \)。 - Calcular el gradiente: Calcular la derivada parcial de la función de pérdida con respecto a
\( w \)y\( b \). - Actualizar parámetros: Actualizar según el gradiente
\( w \)y\( b \)。 - Repetir la iteración: Repetir los pasos 2 a 4 hasta que la función de pérdida converja o se alcance el número máximo de iteraciones.
Implementar regresión lineal con Python
A continuación, demostramos cómo implementar la regresión lineal con Python mediante un ejemplo sencillo.
1. Importar las bibliotecas necesarias
Ejemplo
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
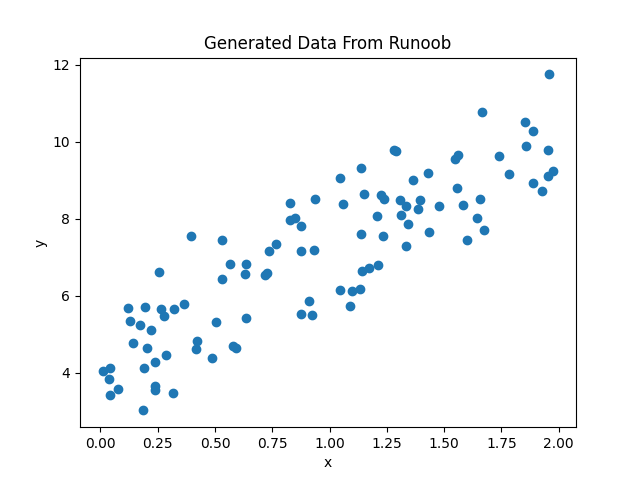
2. Generar datos simulados
Ejemplo
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
# Generar algunos datos aleatorios
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Visualizar los datos
plt.scatter(x, y)
plt.xlabel('x')
plt.ylabel('y')
plt.title('Generated Data From Ejemplo')
plt.show()
Se muestra de la siguiente manera:
3. Usar Scikit-learn para regresión lineal
Ejemplo
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
# Generar algunos datos aleatorios
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Crear el modelo de regresión lineal
model = LinearRegression()
# Ajustar el modelo
model.fit(x, y)
# Mostrar los parámetros del modelo
print(f"Pendiente (w): {model.coef_)
print(f"Intersección (b): {model.intercept_)
# Predecir
y_pred = model.predict(x)
# Visualizar el resultado del ajuste
plt.scatter(x, y)
plt.plot(x, y_pred, color='red')
plt.xlabel('x')
plt.ylabel('y')
plt.title('Linear Regression Fit')
plt.show()
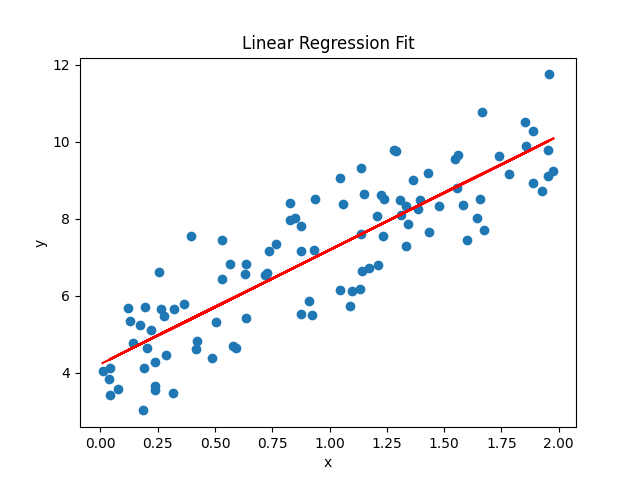
Resultado de salida:
斜率 (w): 2.968467510701019
截距 (b): 4.222151077447231
Se muestra de la siguiente manera:
Podemos usar el métodoscore()para evaluar el rendimiento del modelo, que devuelve el valor R^2.
Ejemplo
from sklearn.linear_model import LinearRegression
# Generar algunos datos aleatorios
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Crear el modelo de regresión lineal
model = LinearRegression()
# Ajustar el modelo
model.fit(x, y)
# Calcular la puntuación del modelo
score = model.score(x, y)
print("Puntuación del modelo:", score)
El resultado de salida es:
模型得分: 0.7469629925504755
4. Implementar manualmente el descenso de gradiente
Ejemplo
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
# Generar algunos datos aleatorios
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Inicializar parámetros
w = 0
b = 0
learning_rate = 0.1
n_iterations = 1000
# Descenso de gradiente
for i in range(n_iterations):
y_pred = w * x + b
dw = -(2/len(x)) * np.sum(x * (y - y_pred))
db = -(2/len(x)) * np.sum(y - y_pred)
w = w - learning_rate * dw
b = b - learning_rate * db
# Mostrar los parámetros finales
print(f"Pendiente (w) calculada manualmente: {w}")
print(f"Intersección (b) calculada manualmente: {b}")
# Visualizar el resultado del ajuste implementado manualmente
y_pred_manual = w * x + b
plt.scatter(x, y)
plt.plot(x, y_pred_manual, color='green')
plt.xlabel('x')
plt.ylabel('y')
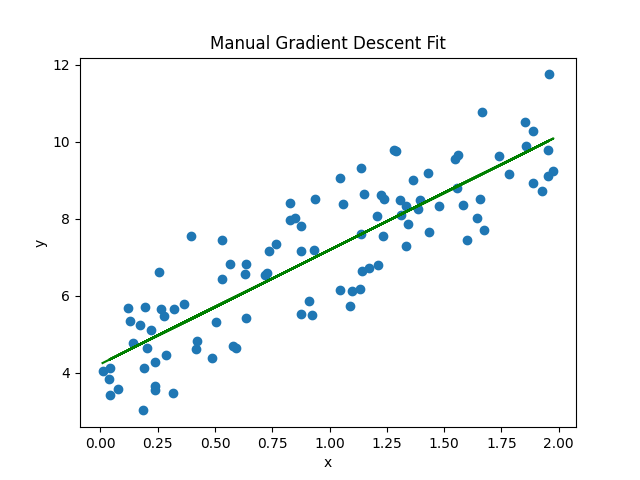
plt.title('Manual Gradient Descent Fit')
plt.show()
Resultado de salida:
手动实现的斜率 (w): 2.968467510701028
手动实现的截距 (b): 4.222151077447219
Se muestra de la siguiente manera: