Aprendizaje no supervisado - Clustering
Imagina que entras en una biblioteca enorme, con todos los libros amontonados desordenadamente en el suelo. Tu tarea no es leer cada libro (eso llevaría demasiado tiempo), sino agruparlos en montones según su tema, por ejemplo: ciencia ficción, biografías históricas, recetas de cocina. En este proceso, no tienes una lista de clasificación predefinida que te diga a qué categoría pertenece cada libro; te basas completamente en características como el contenido, la portada, el grosor,espontáneamentedescubres estos grupos.
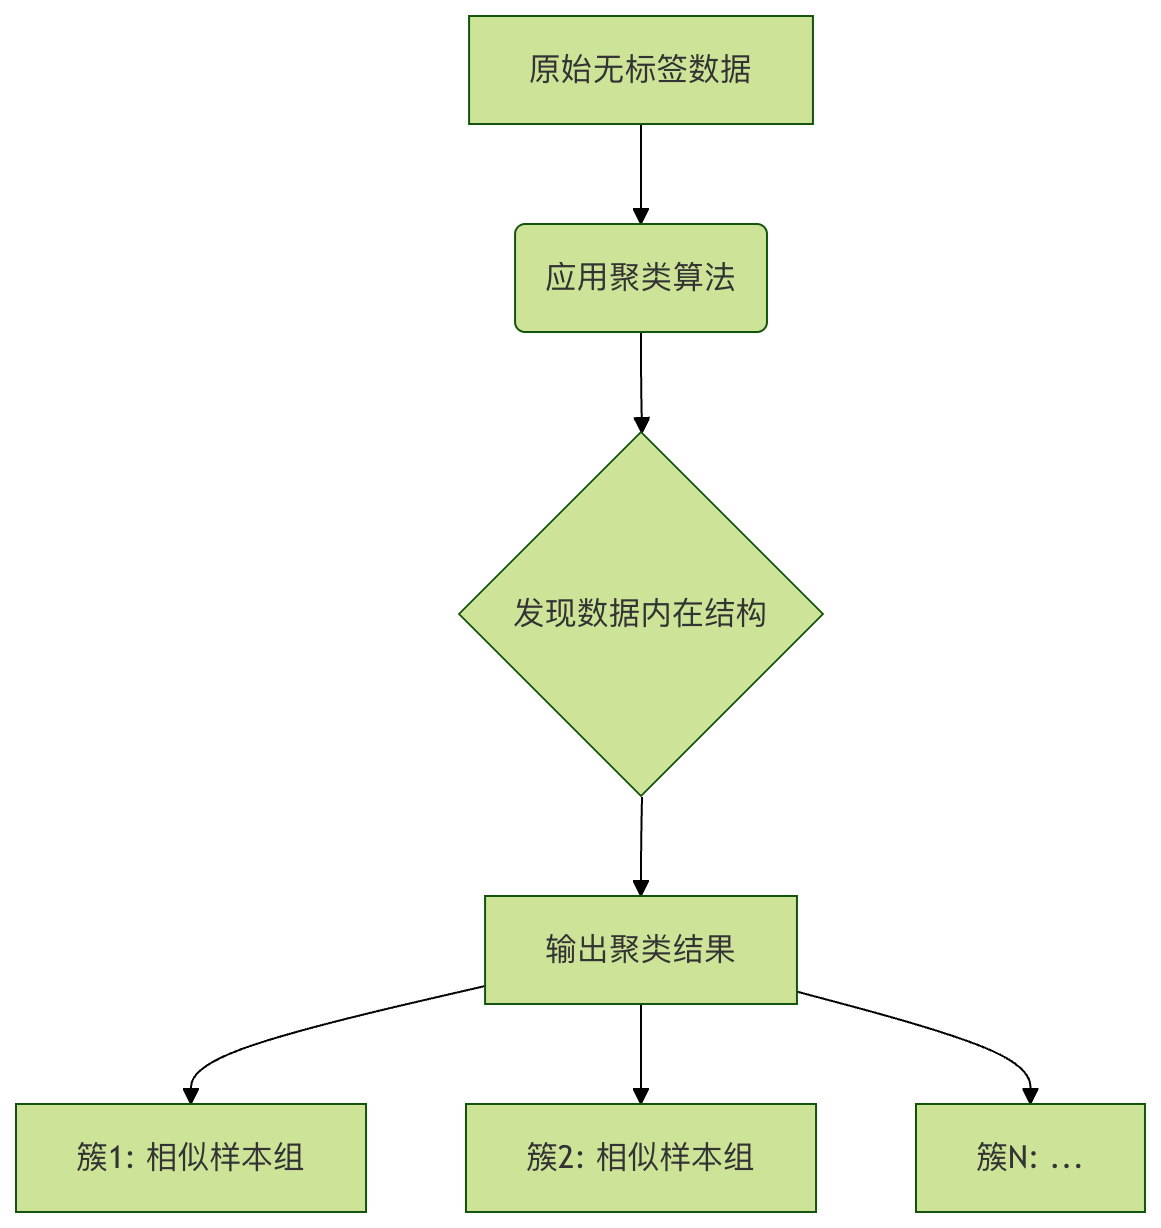
En el aprendizaje automático,el clusteringhace exactamente eso. Es un método deaprendizaje no supervisadocuyo objetivo es descubrir la estructura interna y los grupos en datos sin respuestas previamente etiquetadas (es decir, sin "etiquetas").
¿Qué es el aprendizaje no supervisado y el clustering?
Antes de comenzar, distingamos rápidamente los dos paradigmas principales del aprendizaje automático:
- Aprendizaje supervisado: es como un aprendizaje con un maestro. Proporcionamos al algoritmo una gran cantidad de preguntas (datos de características) y las respuestas correctas correspondientes (etiquetas), y hacemos que aprenda la relación de mapeo de pregunta a respuesta. Por ejemplo, mostramos al algoritmo muchas imágenes de gatos y perros (características) y le decimos si cada imagen es un gato o un perro (etiqueta); después del entrenamiento, puede reconocer imágenes nuevas.
- Aprendizaje no supervisado: es como dejar que la máquina explore y descubra por sí misma. Solo proporcionamos preguntas (datos de características),sin proporcionar respuestas (etiquetas)El objetivo del algoritmo es encontrar patrones, estructuras o relaciones en los datos por sí mismo. El clustering es una de las técnicas más fundamentales.
La idea central del clustering: dividir las muestras del conjunto de datos en varios subconjuntosdisjuntos(llamados clústeres o clases), de modo que las muestras dentro del mismo clúster seansimilares, mientras que las muestras en diferentes clústeres seandisímiles。
La similitud aquí generalmente se mide mediantedistanciasmatemáticas (como la distancia euclidiana).
Cuanto menor es la distancia, mayor es la similitud.
Algoritmo clásico de clustering: K-Means
K-MeansEs uno de los algoritmos de clustering más famosos y utilizados; su idea es intuitiva y su implementación relativamente simple.
Principio del algoritmo y pasos
Podemos imaginar el proceso de K-Means como elegir representantes y redibujar distritos:
- Determinar el número de clústeres K: Primero, debes decidir en cuántas clases quieres dividir los datos. Este valor de K debe especificarse de antemano; es un parámetro clave de K-Means.
- Inicializar representantes (centroides): Seleccionar aleatoriamente K puntos en el espacio de datos como los "puntos centrales" iniciales de cada clúster, los llamamoscentroides。
- Asignar residentes (muestras): Calcular la distancia desde cada punto de muestra del conjunto de datos hasta los K centroides. Siguiendo el principio de "cada uno va a su clase más cercana", asignar cada muestra al clúster cuyo centroide estémás cercade ella. Así, todas las muestras quedan divididas en K clústeres.
- Reelegir nuevos representantes (actualizar centroides): Ahora, cada clúster tiene un conjunto de muestras. Recalculamos el centroide de cada clúster; el nuevo centroide es elpromedio(punto medio) de todas las muestras del clúster.
- Repetir y converger: Repetir los pasos 3 (asignación) y 4 (actualización) hasta que la posición de los centroides ya no cambie significativamente (es decir, el algoritmo converge). En ese momento, el clúster al que pertenece cada muestra tampoco cambia.
Ejemplo de código y práctica
Usemos la libreríascikit-learnde Python y un conjunto de datos simple para demostrar K-Means.
Ejemplo
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans
# -------------------------- Configurar fuente china start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows primero
'SimHei', 'Microsoft YaHei',
# macOS primero
'PingFang SC', 'Heiti TC',
# Linux primero
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que el signo negativo se muestra como un cuadrado
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Configurar fuente china end --------------------------
# 1. Crear un conjunto de datos artificial
# Generamos 300 puntos de muestra que se distribuyen naturalmente alrededor de 4 centros (para facilitar la observación)
X, y_true = make_blobs(n_samples=300, centers=4, cluster_std=0.60, random_state=0)
# X son los datos de características, y_true son las etiquetas de clase reales (solo para comparación final; el algoritmo de clustering no las usa)
# 2. Visualizar los datos originales
plt.scatter(X[:, 0], X[:, 1], s=50) # s es el tamaño del punto
plt.title("Datos originales sin etiquetar")
plt.show()
# 3. Aplicar el clustering K-Means
# Especificar que se agrupe en 4 clases
kmeans = KMeans(n_clusters=4, random_state=0, n_init='auto')
# Ajustar el modelo y predecir la etiqueta de clúster para cada muestra
y_kmeans = kmeans.fit_predict(X)
# 4. Obtener las coordenadas de los centroides
centroids = kmeans.cluster_centers_
# 5. Visualizar los resultados del clustering
plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
# Marcar los puntos de muestra de diferentes clústeres con diferentes colores
plt.scatter(centroids[:, 0], centroids[:, 1], c='red', s=200, alpha=0.8, marker='X')
# Marcar la posición de los centroides con una cruz roja grande; alpha es la transparencia
plt.title("Resultado del clustering K-Means (K=4)")
plt.show()
# Imprimir las etiquetas de clúster predichas para los primeros 10 muestras
print("Etiquetas de clúster de los primeros 10 muestras:", y_kmeans[:10])
# Imprimir las coordenadas de los centroides
print("Coordenadas de los centroides de los cuatro clústeres:\n", centroids)
Análisis del código:
make_blobs: Genera el conjunto de datos simulado para el clustering,centers=4indica que los datos se generan alrededor de 4 centros.KMeans(n_clusters=4): Crea una instancia del modelo K-Means, especificando el número de clústeres K = 4.n_init='auto'es el número de veces que se ejecuta el algoritmo, tomando el mejor resultado.fit_predict(X): El método principal, ajusta el modelo sobre los datosXy devuelve el índice de clúster de cada muestra (0, 1, 2, 3).cluster_centers_: Atributo que almacena las coordenadas de los K centroides obtenidos tras el entrenamiento.
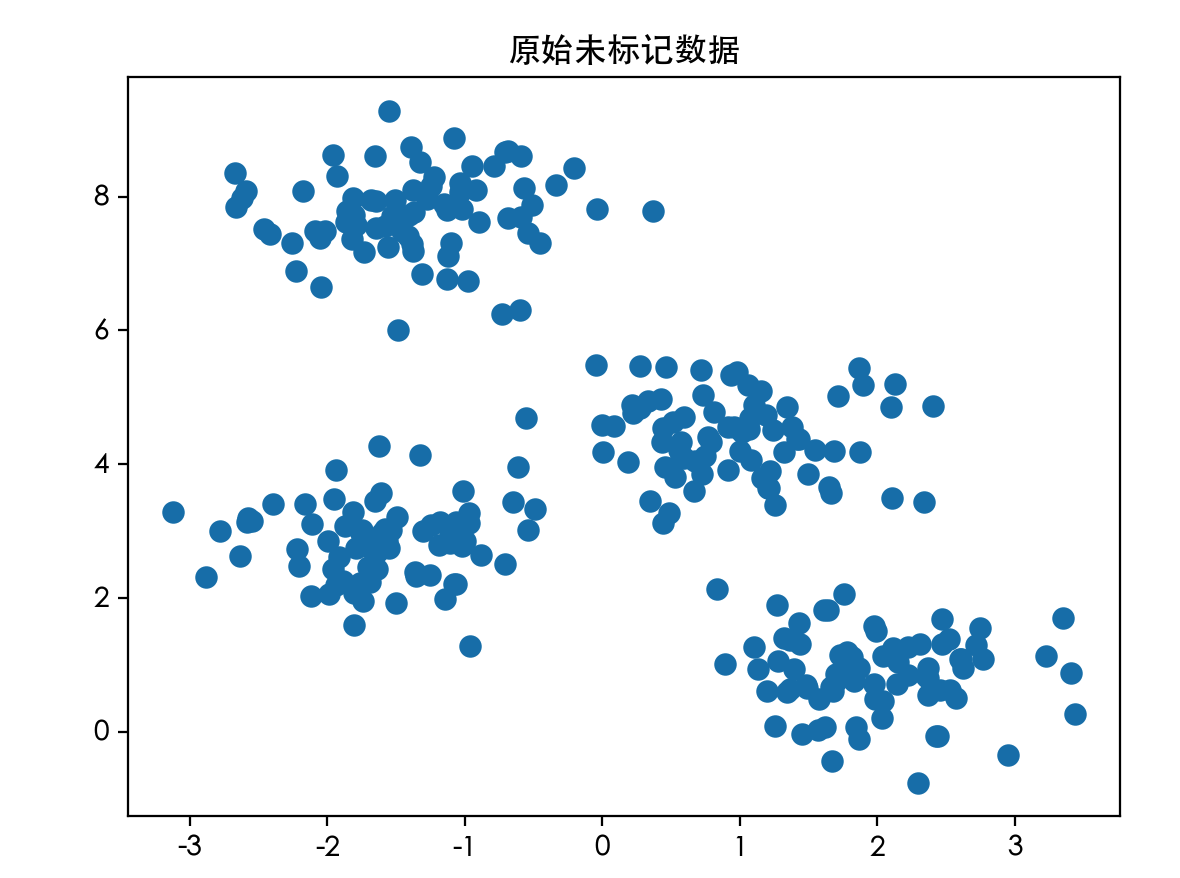
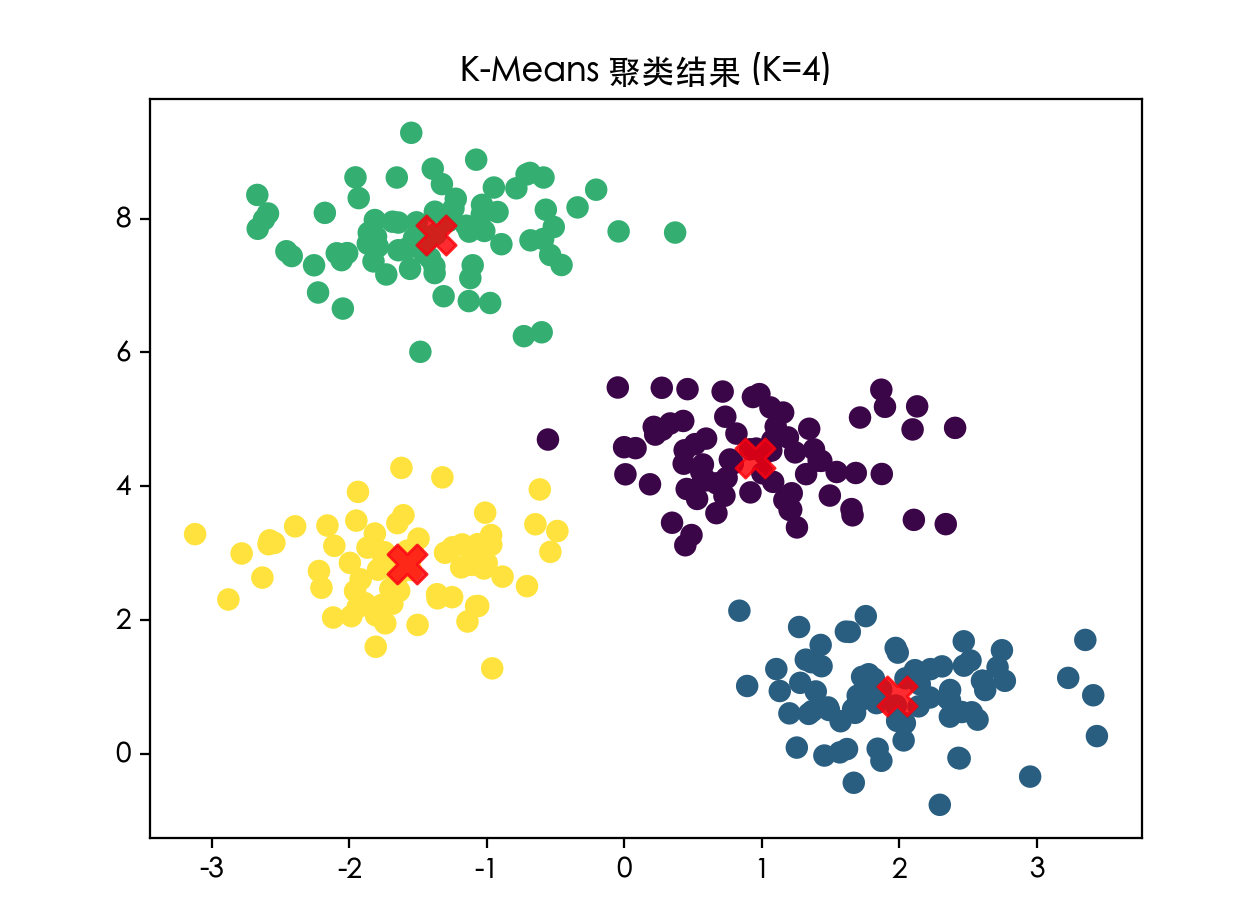
Al ejecutar este código, verás dos gráficos. El primero muestra puntos desordenados; el segundo está claramente dividido en cuatro grupos de colores, con un centro rojoXmarcado. ¡Esa es la magia de K-Means!
前10个样本的簇标签: [1 2 0 2 1 1 3 0 2 2]
四个簇的质心坐标:
 [[ 0.94973532  4.41906906]
 [ 1.98258281  0.86771314]
 [-1.37324398  7.75368871]
 [-1.58438467  2.83081263]]
Datos originales sin etiquetar:
Resultado del clustering K-Means:
¿Cómo elegir el mejor valor de K?
En el ejemplo anterior, como sabíamos que los datos se generaron alrededor de 4 centros, establecimos fácilmenteK=4. Pero en el mundo real, a menudo no sabemos en cuántas clases deberían dividirse los datos. ¿Cómo elegir K?
Un método común esla "regla del codo". Su idea es: a medida que aumenta el número de clústeres K, la distancia promedio de los puntos de muestra al centroide de su clúster (llamadadistorsiónoinertia) disminuye. Cuando K es menor que el número real de clústeres, aumentar K reduce en gran medida esta distancia; cuando K alcanza el número real, aumentar K reduce la distancia solo ligeramente. Este punto de inflexión es como la articulación del codo, y el valor de K correspondiente es una buena elección.
Ejemplo
inertias = []
K_range = range(1, 11) # Probar K de 1 a 10
for k in K_range:
kmeans = KMeans(n_clusters=k, random_state=0, n_init='auto')
kmeans.fit(X)
inertias.append(kmeans.inertia_) # El atributo inertia_ es la SSE
# Dibujar la curva del codo
plt.plot(K_range, inertias, 'bo-')
plt.xlabel('Número de clústeres K')
plt.ylabel('Inertia (SSE)')
plt.title('Regla del codo para encontrar el mejor valor de K')
plt.axvline(x=4, color='r', linestyle='--', alpha=0.5) # Marcar el K=4 que ya conocemos
plt.show()
Al observar la curva generada, notarás que cerca de K=4 la velocidad de descenso se reduce notablemente, formando un "codo", lo que sugiere que K=4 es una elección razonable.
Escenarios de aplicación del clustering
El clustering es una poderosa herramienta de análisis exploratorio de datos, con aplicaciones muy amplias:
- Segmentación de clientes: En el comercio electrónico o el marketing, se realiza clustering según el comportamiento de compra y los datos demográficos de los clientes, para dividirlos en grupos como "clientes de alto valor", "clientes sensibles al precio", etc., con el fin de implementar marketing de precisión.
- Segmentación de imágenes: Agrupar los píxeles de una imagen según color y textura puede usarse para simplificar la imagen, identificar el primer plano y el fondo.
- Detección de anomalías: Los puntos de datos normales suelen formar clústeres densos, mientras que los puntos anómalos están lejos del centro de cualquier clúster. Mediante el clustering se pueden detectar estos valores atípicos.
- Clasificación de documentos: Agrupar artículos de noticias o documentos de investigación para descubrir automáticamente temas candentes o áreas de investigación.
- Análisis de redes sociales: En las redes sociales, agrupando las relaciones e interacciones de los usuarios se pueden descubrir comunidades o círculos.
Ejercicios prácticos y resumen
Ejercicio 1: Prueba diferentes valores de KEn el código de ejemplo de K-Means anterior, modifica eln_clustersparámetro, configúralo en 2, 3, 5 y 8 respectivamente. Observa el gráfico de resultados del agrupamiento y percibe el impacto de la elección del valor de K en los resultados.
Ejercicio 2: Uso de un conjunto de datos realIntenta usarscikit-learnel conjunto de datos integradoirisde iris para agrupamiento. Aunque este conjunto de datos se utiliza normalmente para clasificación, puedes ignorar sus etiquetas y usar solo los datos de características (largo y ancho de sépalos y pétalos) para el agrupamiento con K-Means, y luego comparar los resultados del agrupamiento con las etiquetas reales para ver cómo funciona.
Ejemplo
iris = datasets.load_iris()
X_iris = iris.data # Usar solo los datos de características