Problema de explicabilidad
Imagina que vas al médico y te dice: "Según mi sistema de diagnóstico avanzado, necesitas esta cirugía, pero no puedo explicar por qué". ¿Aceptarías? La mayoría dudaría, porque queremos entender las razones detrás de la decisión.
En el campo del aprendizaje automático, nos enfrentamos a un dilema similar. Muchos modelos avanzados de aprendizaje automático, especialmente los modelos de aprendizaje profundo, son como cajas negras: podemos ver las entradas y salidas, pero es difícil entender cómo toman decisiones internamente. Esto esel problema de explicabilidad del aprendizaje automático, que se ha convertido en uno de los principales obstáculos que limitan la aplicación generalizada de la tecnología de IA en áreas críticas como la medicina, las finanzas y la justicia.
Este artículo te ayudará a comprender qué es la explicabilidad, por qué es tan importante, así como los desafíos actuales y las soluciones.
¿Qué es la explicabilidad en el aprendizaje automático?
Conceptos básicos
La explicabilidad del aprendizaje automáticose refiere a nuestra capacidad para comprender, confiar y gestionar eficazmente el proceso de toma de decisiones de la inteligencia artificial.
En términos simples, es la capacidad de responder por qué el modelo hizo tal predicción.
Dos niveles de explicabilidad
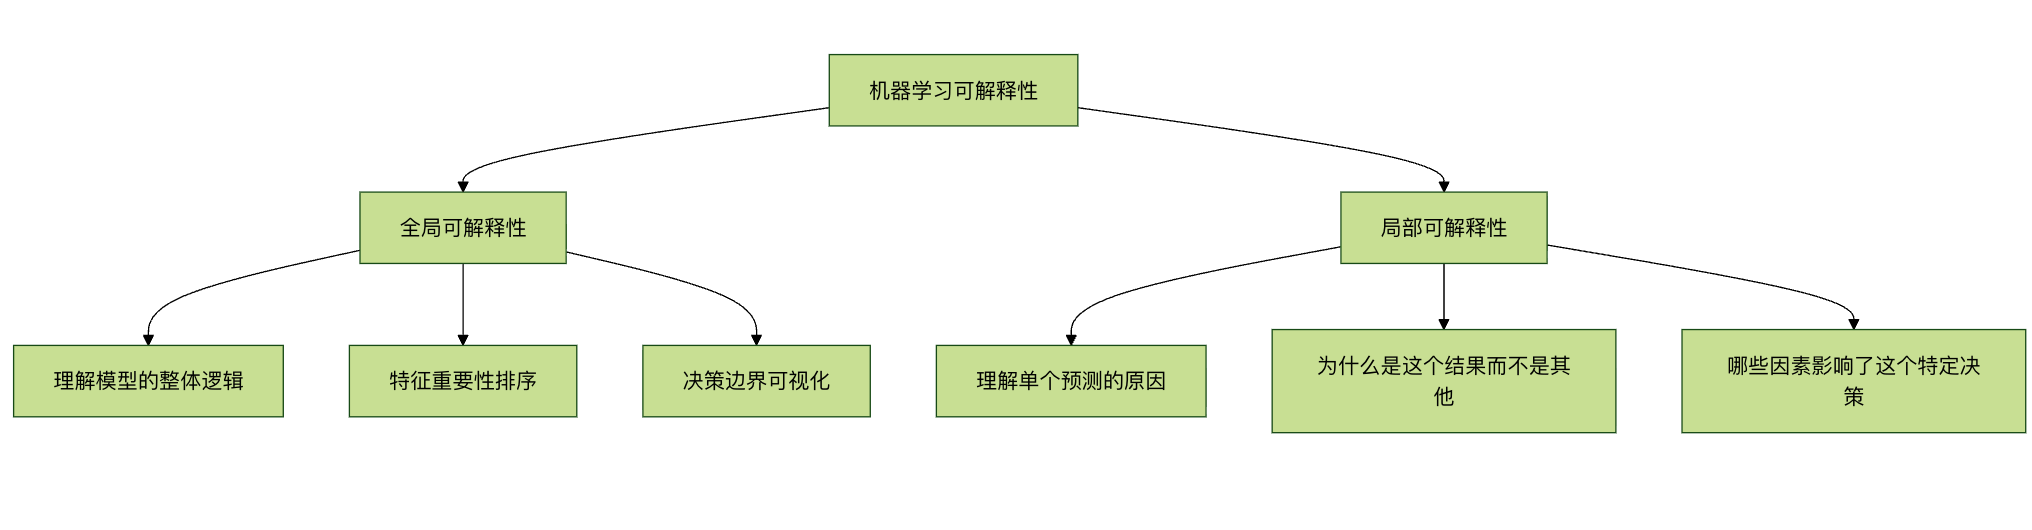
Explicabilidad globalSe centra en el comportamiento general del modelo:
- ¿Qué patrones ha aprendido el modelo?
- ¿Qué características son más importantes para la predicción?
- ¿Qué forma tiene la frontera de decisión del modelo?
Explicabilidad localSe centra en predicciones individuales:
- ¿Por qué esta muestra se predijo como clase A y no como clase B?
- ¿Cómo cambiaría la predicción si el valor de una característica se modifica ligeramente?
- ¿Qué características contribuyen más a esta predicción específica?
¿Por qué es tan importante la explicabilidad?
1. Generar confianza y transparencia
En áreas de alto riesgo como la medicina, la conducción autónoma y el control de riesgos financieros, las personas necesitan conocer la base de las decisiones de la IA. Si un modelo rechaza una solicitud de préstamo o diagnostica una enfermedad, debemos poder explicar el motivo.
2. Cumplir con los requisitos normativos
El GDPR de la Unión Europea (Reglamento General de Protección de Datos) establece claramente que los usuarios tienen derecho a recibir "información significativa sobre la lógica". Muchas regulaciones de la industria exigen transparencia en los procesos de decisión.
3. Depurar y mejorar los modelos
Al comprender cómo funciona el modelo, podemos:
- Descubrir y corregir sesgos en el modelo
- Identificar correlaciones espurias aprendidas por el modelo
- Mejorar la arquitectura del modelo y la ingeniería de características
4. Descubrimiento de conocimiento y perspectivas científicas
A veces, el modelo puede descubrir patrones que los expertos humanos no habían notado; estas perspectivas pueden impulsar el avance científico.
5. Seguridad y ataques adversarios
Comprender las debilidades del modelo ayuda a defenderse de ataques adversarios (entradas diseñadas cuidadosamente que provocan clasificaciones erróneas del modelo).
Diferentes tipos de modelos y explicabilidad
Espectro de transparencia de los modelos
| Tipo de modelo | Explicabilidad | Representantes típicos | Escenarios de aplicación |
|---|---|---|---|
| Modelos de alta explicabilidad | Alto | Regresión lineal, árboles de decisión, regresión logística | Áreas que requieren una fuerte explicabilidad, como el crédito financiero |
| Modelos de explicabilidad media | Medio | Bosques aleatorios, árboles de potenciación de gradiente | Escenarios que equilibran rendimiento y explicabilidad |
| Modelos de baja explicabilidad | bajo | Aprendizaje profundo, modelos de ensamblaje complejos | Priorizan el rendimiento, como el reconocimiento de imágenes y el procesamiento del lenguaje natural |
Comparación de ejemplo: árbol de decisión vs red neuronal
Ejemplo de árbol de decisión (alta explicabilidad):
Ejemplo
from sklearn.tree import DecisionTreeClassifier, plot_tree
import matplotlib.pyplot as plt
# Crear y entrenar el modelo
model = DecisionTreeClassifier(max_depth=3, random_state=42)
model.fit(X_train, y_train)
# Visualizar el árbol de decisión
plt.figure(figsize=(12, 8))
plot_tree(model, feature_names=feature_names,
class_names=['Not Approved', 'Approved'],
filled=True, rounded=True)
plt.title("Árbol de decisión para aprobación de préstamos - totalmente explicable")
plt.show()
La ventaja del árbol de decisión es que podemos rastrear directamente la ruta desde el nodo raíz hasta las hojas, comprendiendo completamente cómo se toma cada decisión.
Ejemplo de red neuronal (baja explicabilidad):
Ejemplo
import tensorflow as tf
from tensorflow import keras
# Crear una red neuronal simple
model = keras.Sequential([
keras.layers.Dense(128, activation='relu', input_shape=(10,)),
keras.layers.Dense(64, activation='relu'),
keras.layers.Dense(32, activation='relu'),
keras.layers.Dense(1, activation='sigmoid') # salida de clasificación binaria
])
model.compile(optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy'])
# Entrenar modelo
history = model.fit(X_train, y_train,
epochs=50,
validation_split=0.2,
verbose=0)
Las redes neuronales se componen de cientos o incluso millones de neuronas interconectadas, cada conexión tiene un peso, y estos pesos se ajustan automáticamente mediante el entrenamiento. Aunque podemos ver todos los valores de los pesos, es casi imposible entender cómo estos números producen conjuntamente una predicción específica.
Desafíos de la explicabilidad
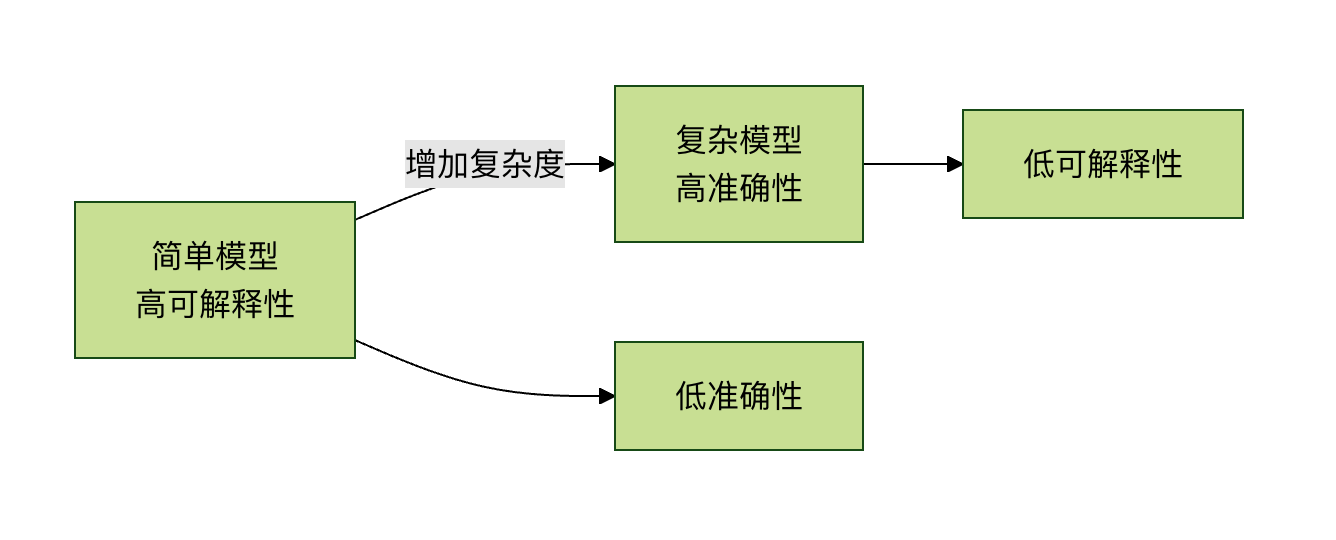
1. Equilibrio entre precisión y explicabilidad
Generalmente, cuanto más complejo es el modelo y mejor su rendimiento, peor es su explicabilidad. Esto se conoce comoel equilibrio precisión-explicabilidad。
2. Complejidad técnica
Los modelos de aprendizaje profundo pueden tener:
- Millones de parámetros
- Complejas transformaciones no lineales
- Representaciones abstractas de múltiples capas
3. Limitaciones cognitivas humanas
Incluso si obtenemos una explicación técnica, puede superar la capacidad de comprensión humana. Por ejemplo, una explicación de interacciones complejas con 1000 características es difícil de procesar para el cerebro humano.
4. Falta de estándares de evaluación
¿Cómo medir la "calidad" de una explicación? Actualmente faltan estándares de evaluación unificados y objetivos.
Técnicas actuales de explicabilidad
1. Análisis de importancia de características
Ejemplo
import shap
import xgboost as xgb
import matplotlib.pyplot as plt
# Entrenar un modelo XGBoost
model = xgb.XGBClassifier()
model.fit(X_train, y_train)
# Crear el explicador SHAP
explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X_test)
# Visualizar la importancia de las características
shap.summary_plot(shap_values, X_test, plot_type="bar")
plt.title("Orden de importancia de características")
plt.show()
# Interpretación de una predicción individual
shap.force_plot(explainer.expected_value, shap_values[0,:], X_test.iloc[0,:])
SHAP (SHapley Additive exPlanations) se basa en la teoría de juegos y asigna a cada característica un valor de importancia que muestra su contribución a la predicción.
2. LIME (Explicaciones locales independientes del modelo)
Ejemplo
import lime
from lime import lime_image
from skimage.segmentation import mark_boundaries
# Crear el explicador LIME
explainer = lime_image.LimeImageExplainer()
# Explicar la predicción de una sola imagen
explanation = explainer.explain_instance(
image_array,
model.predict,
top_labels=3,
hide_color=0,
num_samples=1000
)
# Mostrar qué regiones admiten predicción
temp, mask = explanation.get_image_and_mask(
explanation.top_labels[0],
positive_only=True,
num_features=5,
hide_rest=False
)
plt.imshow(mark_boundaries(temp, mask))
plt.title("Regiones de la imagen que apoyan la predicción")
plt.axis('off')
plt.show()
La idea central de LIME es crear un modelo simple e interpretable (como un modelo lineal) cerca del punto de predicción individual para aproximar el comportamiento del modelo complejo.
3. Mecanismo de atención
En el procesamiento del lenguaje natural, el mecanismo de atención puede mostrar en qué partes del texto de entrada se "enfoca" el modelo al hacer una predicción:
Ejemplo
import numpy as np
import matplotlib.pyplot as plt
def visualize_attention(text, attention_weights):
"""
Visualizar los pesos de atención
Parámetros:
text: lista de texto tokenizado
attention_weights: pesos de atención para cada palabra
"""
fig, ax = plt.subplots(figsize=(10, 2))
# Crear mapa de calor
im = ax.imshow([attention_weights], cmap='YlOrRd', aspect='auto')
# configurar ejes
ax.set_xticks(range(len(text)))
ax.set_xticklabels(text, rotation=45, ha='right')
# agregar barra de color
plt.colorbar(im)
plt.title("Visualización de pesos de atención")
plt.tight_layout()
plt.show()
# Ejemplo de uso
sample_text = ["Yo", "Me gusta", "el aprendizaje automático", "de", "la explicabilidad", "investigación"]
sample_attention = [0.1, 0.15, 0.4, 0.05, 0.25, 0.05]
visualize_attention(sample_text, sample_attention)
4. Visualización de fronteras de decisión
Para datos de baja dimensión, podemos visualizar directamente el límite de decisión del modelo:
Ejemplo
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
def plot_decision_boundary(model, X, y):
"""
Dibujar el límite de decisión de datos bidimensionales
Parámetros:
model: clasificador entrenado
X: datos de características (bidimensionales)
y: etiquetas
"""
# Crear la cuadrícula
x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.02),
np.arange(y_min, y_max, 0.02))
# Predecir toda la cuadrícula
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
# Dibujar el límite de decisión y el diagrama de dispersión
plt.figure(figsize=(10, 8))
plt.contourf(xx, yy, Z, alpha=0.4, cmap=plt.cm.RdYlBu)
plt.scatter(X[:, 0], X[:, 1], c=y, s=50,
edgecolor='k', cmap=plt.cm.RdYlBu)
plt.xlabel('Característica 1')
plt.ylabel('Característica 2')
plt.title('Visualización del límite de decisión')
plt.show()
# Generar datos de ejemplo y entrenar el modelo
np.random.seed(42)
X = np.random.randn(200, 2)
y = (X[:, 0] + X[:, 1] > 0).astype(int) # Límite de decisión lineal simple
model = LogisticRegression()
model.fit(X, y)
plot_decision_boundary(model, X, y)
Recomendaciones prácticas: cómo abordar la explicabilidad en proyectos
1. Elegir la estrategia según el escenario de aplicación
| Escenario de aplicación | Requisito de explicabilidad | Método recomendado |
|---|---|---|
| Diagnóstico médico | Muy alto | Usar modelos altamente explicables, o añadir explicaciones posteriores para modelos complejos |
| Control de riesgo financiero | Alto | Análisis de importancia de características, extracción de reglas de decisión |
| Sistema de recomendación | Medio | Mecanismo de atención, generación de razones de recomendación |
| Reconocimiento de imágenes | Bajo | Mapas de prominencia, visualización de activaciones |
| Exploración de investigación | Variable | Elegir según el problema de investigación específico |
2. Pasos para implementar la explicabilidad
Ejemplo
class ExplainableMLPipeline:
def __init__(self, model, feature_names):
self.model = model
self.feature_names = feature_names
self.explanations = {}
def add_global_explanation(self, method='shap'):
"""Añadir explicación global"""
if method == 'shap':
explainer = shap.TreeExplainer(self.model)
shap_values = explainer.shap_values(self.X)
self.explanations['global_shap'] = shap_values
# Generar gráfico de importancia de características
shap.summary_plot(shap_values, self.X,
feature_names=self.feature_names)
def add_local_explanation(self, instance_index, method='lime'):
"""Añadir explicación local"""
if method == 'lime':
# Aquí se simplifica; en la práctica, se debe elegir el intérprete según el tipo de modelo
print(f"Explicación de la predicción para la instancia {instance_index}:")
print(f"Valor predicho: {self.model.predict([self.X[instance_index]]))
print("Factores principales que influyen:")
# Mostrar las características más importantes y sus contribuciones
def generate_report(self):
"""Generar informe de explicabilidad"""
report = {
'model_type': type(self.model).__name__,
'global_importance': self.get_feature_importance(),
'sample_explanations': self.get_sample_explanations(3),
'fairness_metrics': self.check_fairness()
}
return report
def get_feature_importance(self):
"""Obtener importancia de características"""
# Implementar cálculo de importancia de características
pass
def check_fairness(self):
"""Verificar la equidad del modelo"""
# Implementar verificación de equidad
pass
3. Lista de verificación práctica
Antes de implementar un modelo de aprendizaje automático, pregúntese lo siguiente:
Nivel técnico
- ¿Podemos explicar la lógica general del modelo?
- ¿Podemos explicar cada predicción individual?
- ¿Qué características tienen mayor impacto en las predicciones?
- ¿Depende el modelo de correlaciones espurias?
Nivel ético y de cumplimiento
- ¿Tiene el modelo sesgos? ¿Hacia qué grupos?
- ¿Cumple con los requisitos normativos pertinentes?
- ¿Pueden los usuarios obtener explicaciones significativas?
- ¿Existe un mecanismo para corregir predicciones erróneas?
Nivel práctico
- ¿Pueden los expertos del dominio entender las explicaciones?
- ¿Ayudan las explicaciones a mejorar el modelo?
- ¿Apoyan las explicaciones la toma de decisiones?
- ¿Se documentan las explicaciones de las decisiones clave?
Perspectivas futuras y direcciones de investigación
1. Desarrollo de modelos intrínsecamente explicables
Los investigadores están desarrollando nuevas arquitecturas de modelos que son a la vez potentes e explicables, como:
- Sistemas neuro-simbólicos: que combinan redes neuronales y reglas de aprendizaje
- Redes neuronales explicables: redes diseñadas con estructuras transparentes
- Redes de cápsulas: proporcionan mejores representaciones jerárquicas
2. Estandarización y marcos de evaluación
La industria necesita:
- Métricas estandarizadas para la evaluación de la explicabilidad
- Métodos objetivos para medir la calidad de las explicaciones
- Validación de la consistencia entre diferentes métodos de explicación
3. Sistemas de explicación colaborativa humano-máquina
Los sistemas futuros podrían:
- Proporcionar explicaciones de diferentes niveles según el contexto del usuario
- Permitir exploración interactiva y preguntas
- Generar explicaciones más significativas combinando conocimiento del dominio
4. Automatización de la explicabilidad
Direcciones de desarrollo de herramientas:
- Seleccionar automáticamente el método de explicación más adecuado
- Generar explicaciones en tiempo real sin afectar demasiado el rendimiento
- Adaptación personalizada de las explicaciones
Resumen y puntos clave
La explicabilidad no es opcional: en entornos de alto riesgo, la explicabilidad es un requisito indispensable para implementar sistemas de IA.
La compensación es real: es necesario hacer una compensación inteligente entre precisión y explicabilidad según el escenario de aplicación.
El kit de herramientas es amplio: desde SHAP y LIME hasta los mecanismos de atención, existen diversas técnicas para mejorar la explicabilidad de los modelos.
El proceso es sistemático: la explicabilidad debe estar presente en todo el ciclo de vida del aprendizaje automático, desde la recopilación de datos hasta el despliegue del modelo.
El futuro es prometedor: a medida que avanza la investigación, estamos desarrollando nuevos métodos que son a la vez potentes e explicables.
Consejos para principiantes
Si eres un principiante en aprendizaje automático:
- Comienza con modelos explicables: primero domina modelos explicables como regresión lineal, regresión logística y árboles de decisión
- Comprende los fundamentos antes de avanzar: después de entender cómo funcionan los modelos simples, aprende modelos más complejos
- Practica técnicas de explicación: usa herramientas como SHAP y LIME para explicar tus modelos
- Desarrolla pensamiento crítico: pregúntate siempre "¿por qué el modelo predice esto?"
La explicabilidad del aprendizaje automático no es solo un problema técnico, sino también un puente que conecta la inteligencia artificial con la confianza humana. Con el avance de la tecnología, nos dirigimos hacia sistemas de IA más transparentes y confiables, lo que permitirá que el aprendizaje automático desempeñe un papel importante en más áreas críticas.
Ejercicios prácticos
Ejercicio 1: Comparar la explicabilidad de diferentes modelos
Usando el conjunto de datos de iris, compara la explicabilidad de diferentes modelos:
Ejemplo
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier
import shap
# Cargar datos
iris = load_iris()
X_train, X_test, y_train, y_test = train_test_split(
iris.data, iris.target, test_size=0.2, random_state=42
)
# Entrenar diferentes modelos
models = {
'Regresión logística': LogisticRegression(max_iter=1000),
'Árbol de decisión': DecisionTreeClassifier(max_depth=3),
'Bosque aleatorio': RandomForestClassifier(n_estimators=100)
}
# Generar explicaciones para cada modelo y compararlas
for name, model in models.items():
model.fit(X_train, y_train)
accuracy = model.score(X_test, y_test)
print(f"{name} - Precisión: {accuracy:.3f}")
# Intentar explicar (aquí con importancia de características como ejemplo)
if hasattr(model, 'feature_importances_'):
print(f" Importancia de características: {model.feature_importances_}")
elif hasattr(model, 'coef_'):
print(f" Coeficientes: {model.coef_}")
Ejercicio 2: Usar SHAP para explicar un modelo de predicción de precios de vivienda
Ejemplo
from sklearn.datasets import fetch_california_housing
from sklearn.ensemble import RandomForestRegressor
import shap
import matplotlib.pyplot as plt
# Cargar el conjunto de datos de precios de vivienda de California
housing = fetch_california_housing()
X = pd.DataFrame(housing.data, columns=housing.feature_names)
y = housing.target
# Entrenar el modelo
model = RandomForestRegressor(n_estimators=100, random_state=42)
model.fit(X, y)
# Explicar usando SHAP
explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X)
# 1. Resumen de importancia de características
plt.figure(figsize=(10, 6))
shap.summary_plot(shap_values, X, plot_type="bar")
plt.title("Importancia de características para la predicción del precio de vivienda en California")
plt.tight_layout()
plt.show()
# 2. Explicación de una predicción individual
sample_idx = 10 # Seleccionar una muestra
print(f"Precio real de la vivienda para la muestra {sample_idx}: ${y[sample_idx]:.2f} mil")
print(f"Precio predicho de la vivienda para la muestra {sample_idx}: ${model.predict([X.iloc[sample_idx]]))
shap.force_plot(explainer.expected_value,
shap_values[sample_idx,:],
X.iloc[sample_idx,:],
matplotlib=True)