Aprendizaje conjunto
En el campo del aprendizaje automático, el aprendizaje conjunto (Ensemble Learning) es una técnica que mejora el rendimiento general combinando los resultados de predicción de múltiples modelos.
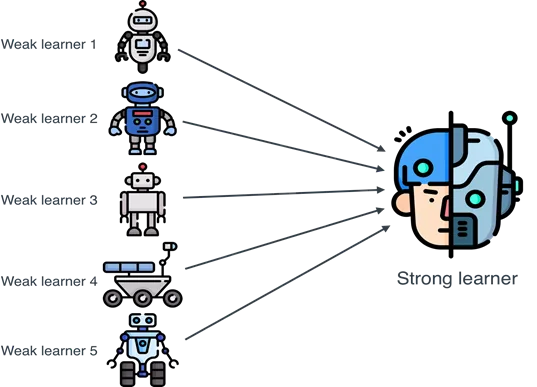
La idea central del aprendizaje conjunto es "tres simples zapateros igualan a Zhuge Liang", es decir, mediante la combinación de múltiples aprendices débiles se puede construir un aprendiz fuerte.
El objetivo principal del aprendizaje conjunto es mejorar la precisión y la robustez de las predicciones combinando múltiples modelos.
Los métodos comunes de aprendizaje conjunto incluyen:
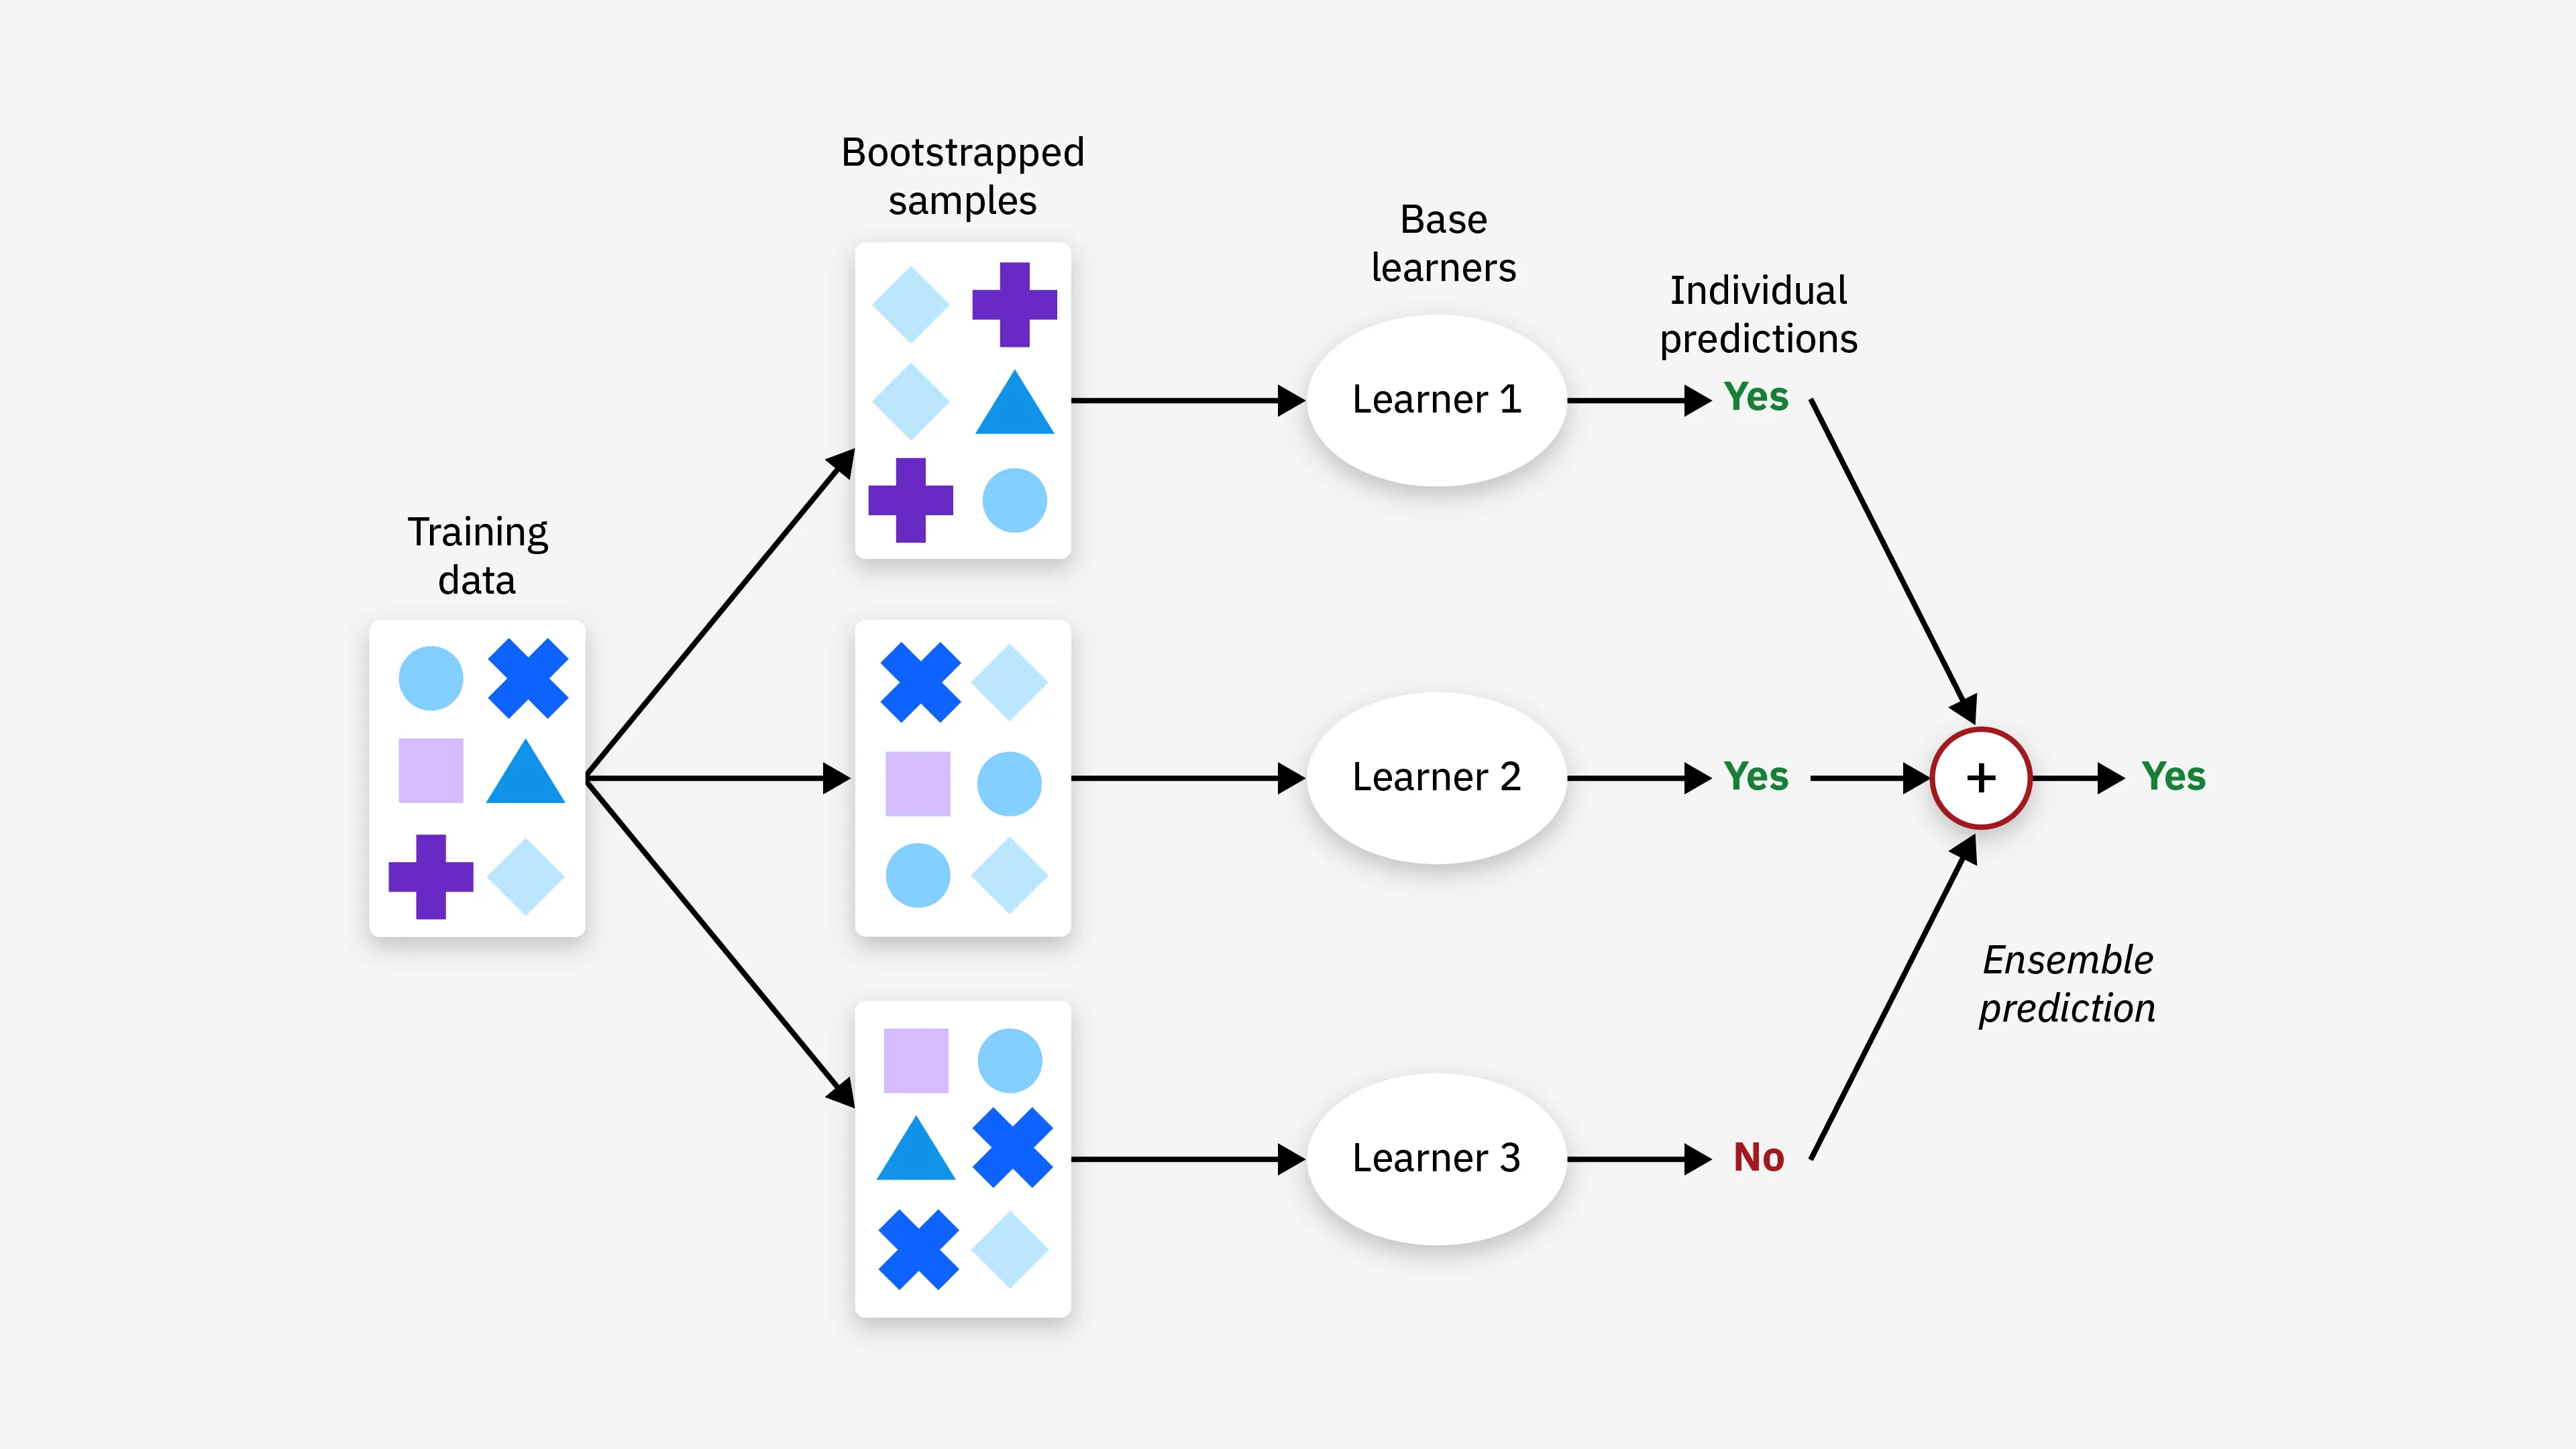
- Bagging: Mediante el método de muestreo de arranque (Bootstrap Sampling) se generan múltiples conjuntos de entrenamiento, luego se entrenan por separado múltiples modelos y finalmente se obtiene el resultado final por votación o promediado.
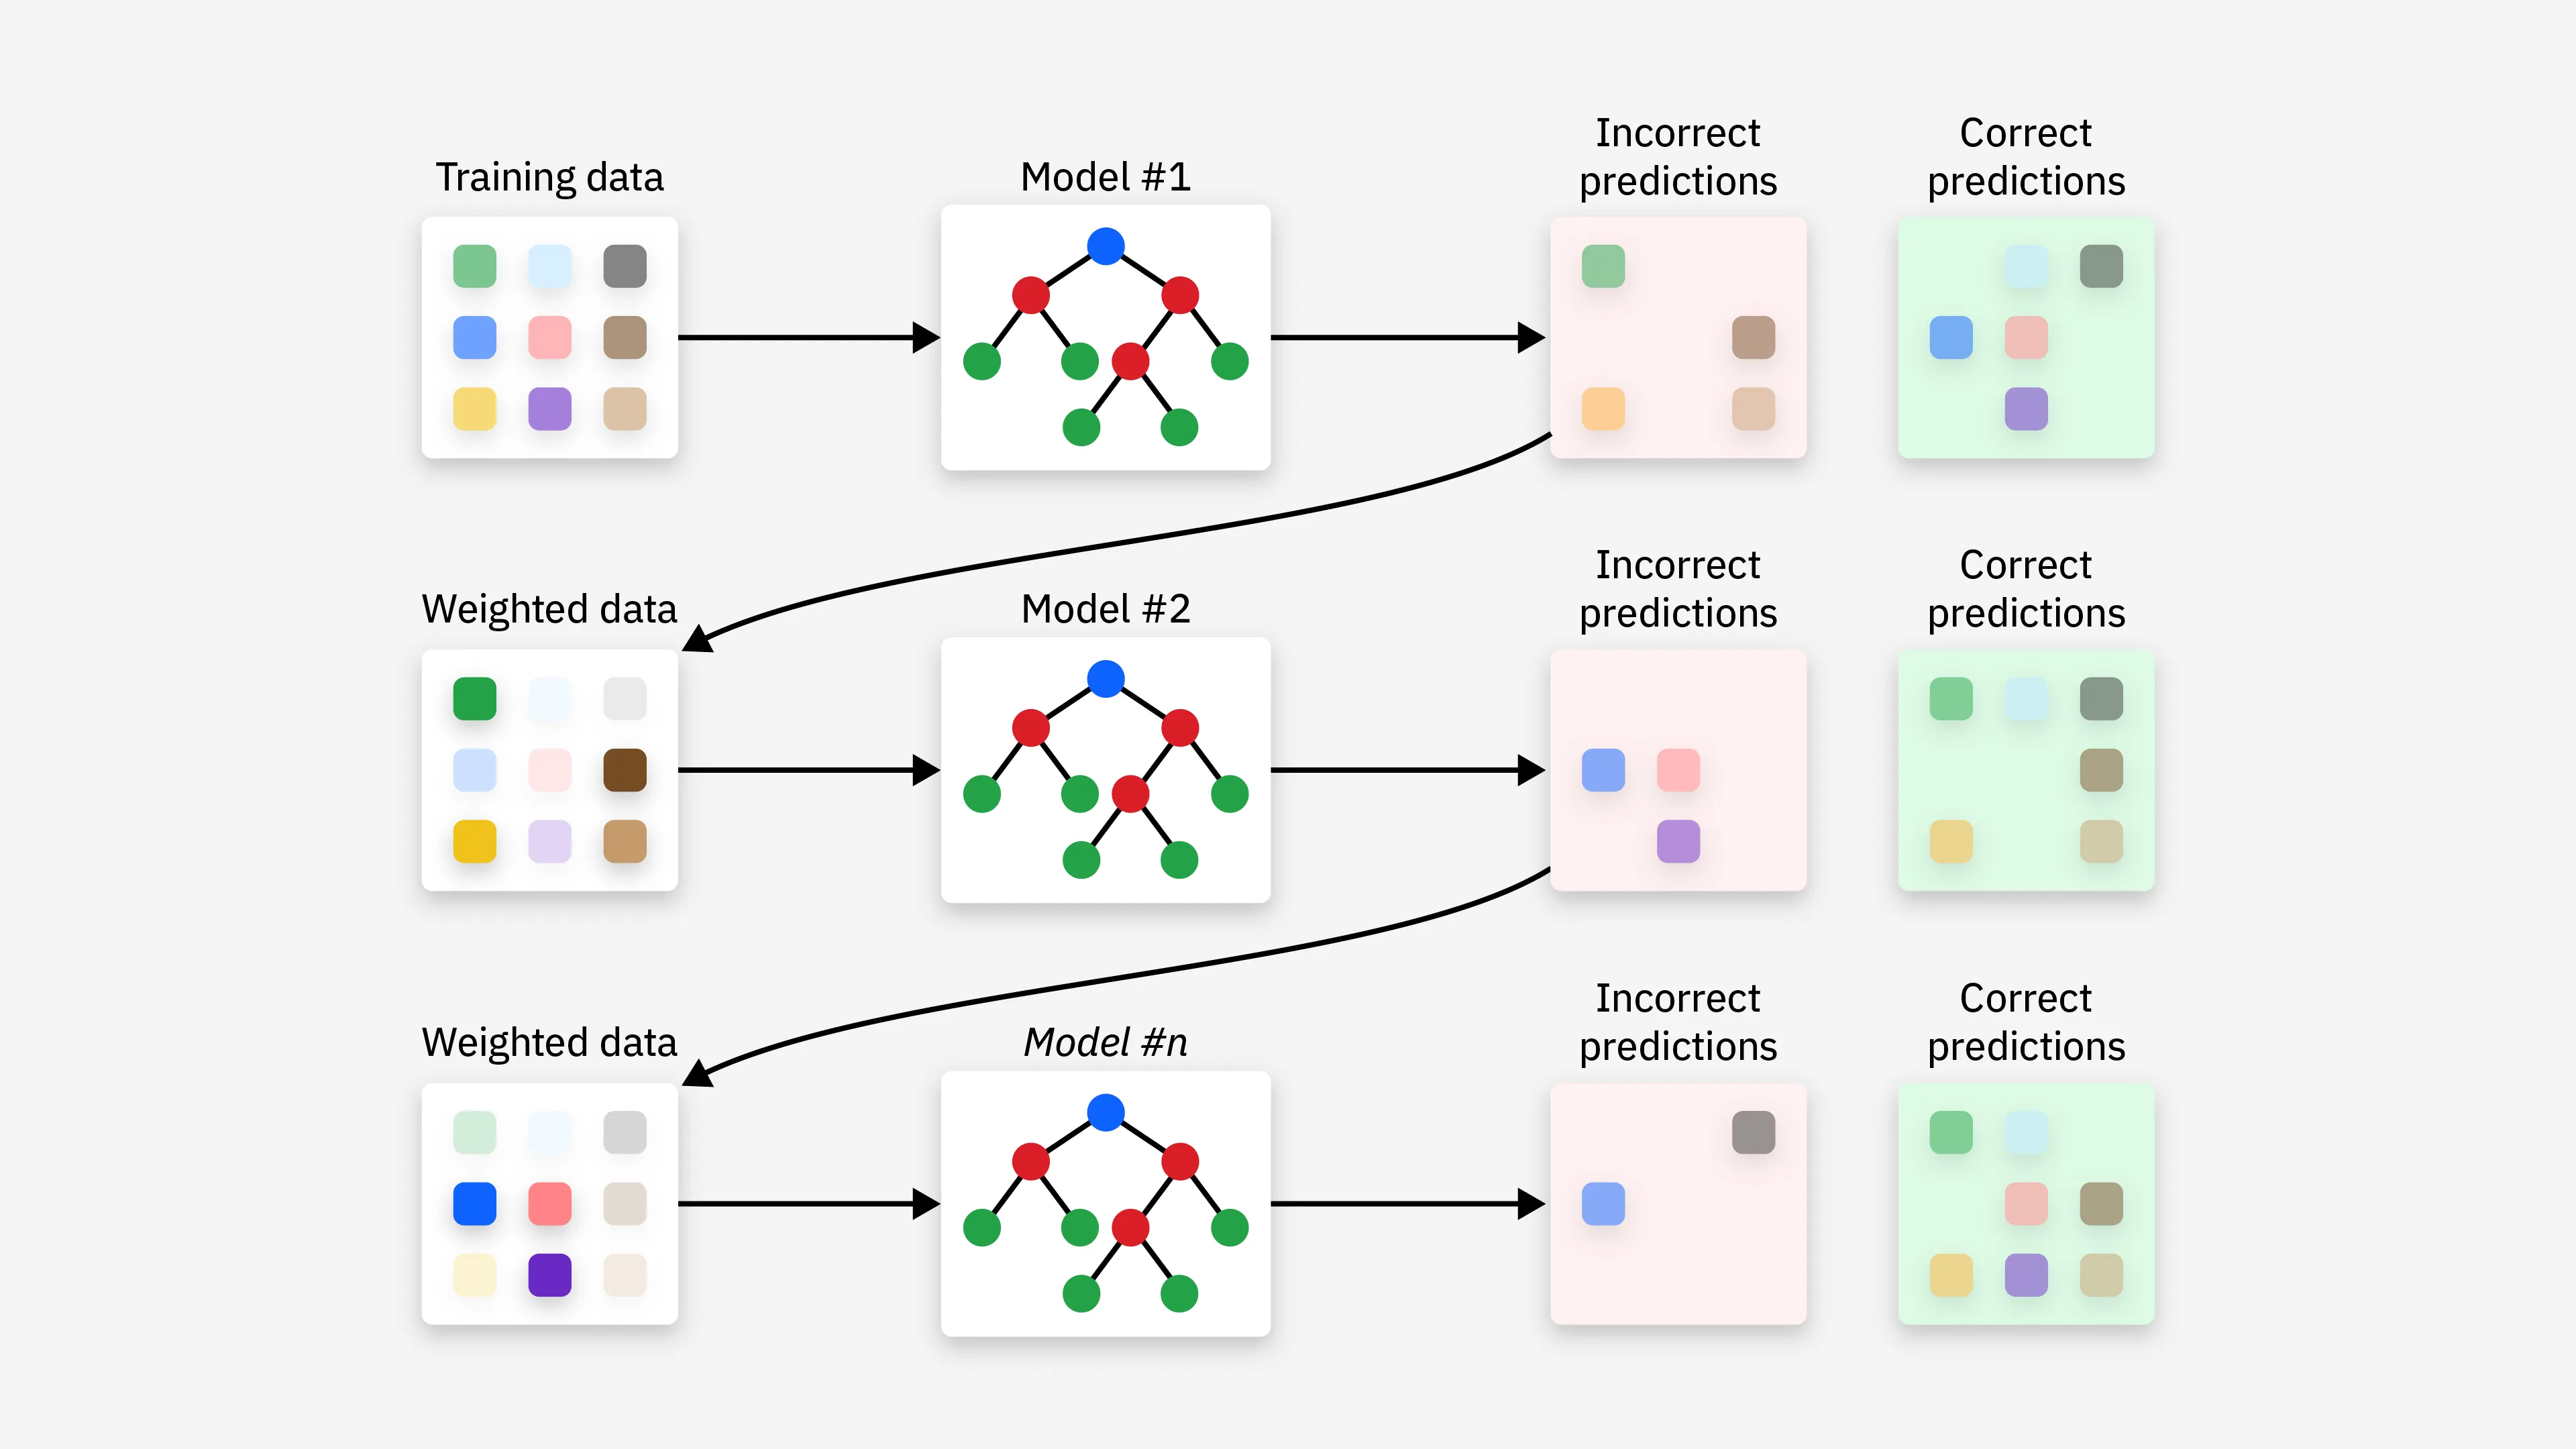
- Boosting: Mediante un entrenamiento iterativo de múltiples modelos, cada modelo intenta corregir los errores del anterior, y finalmente el resultado se obtiene mediante votación ponderada.
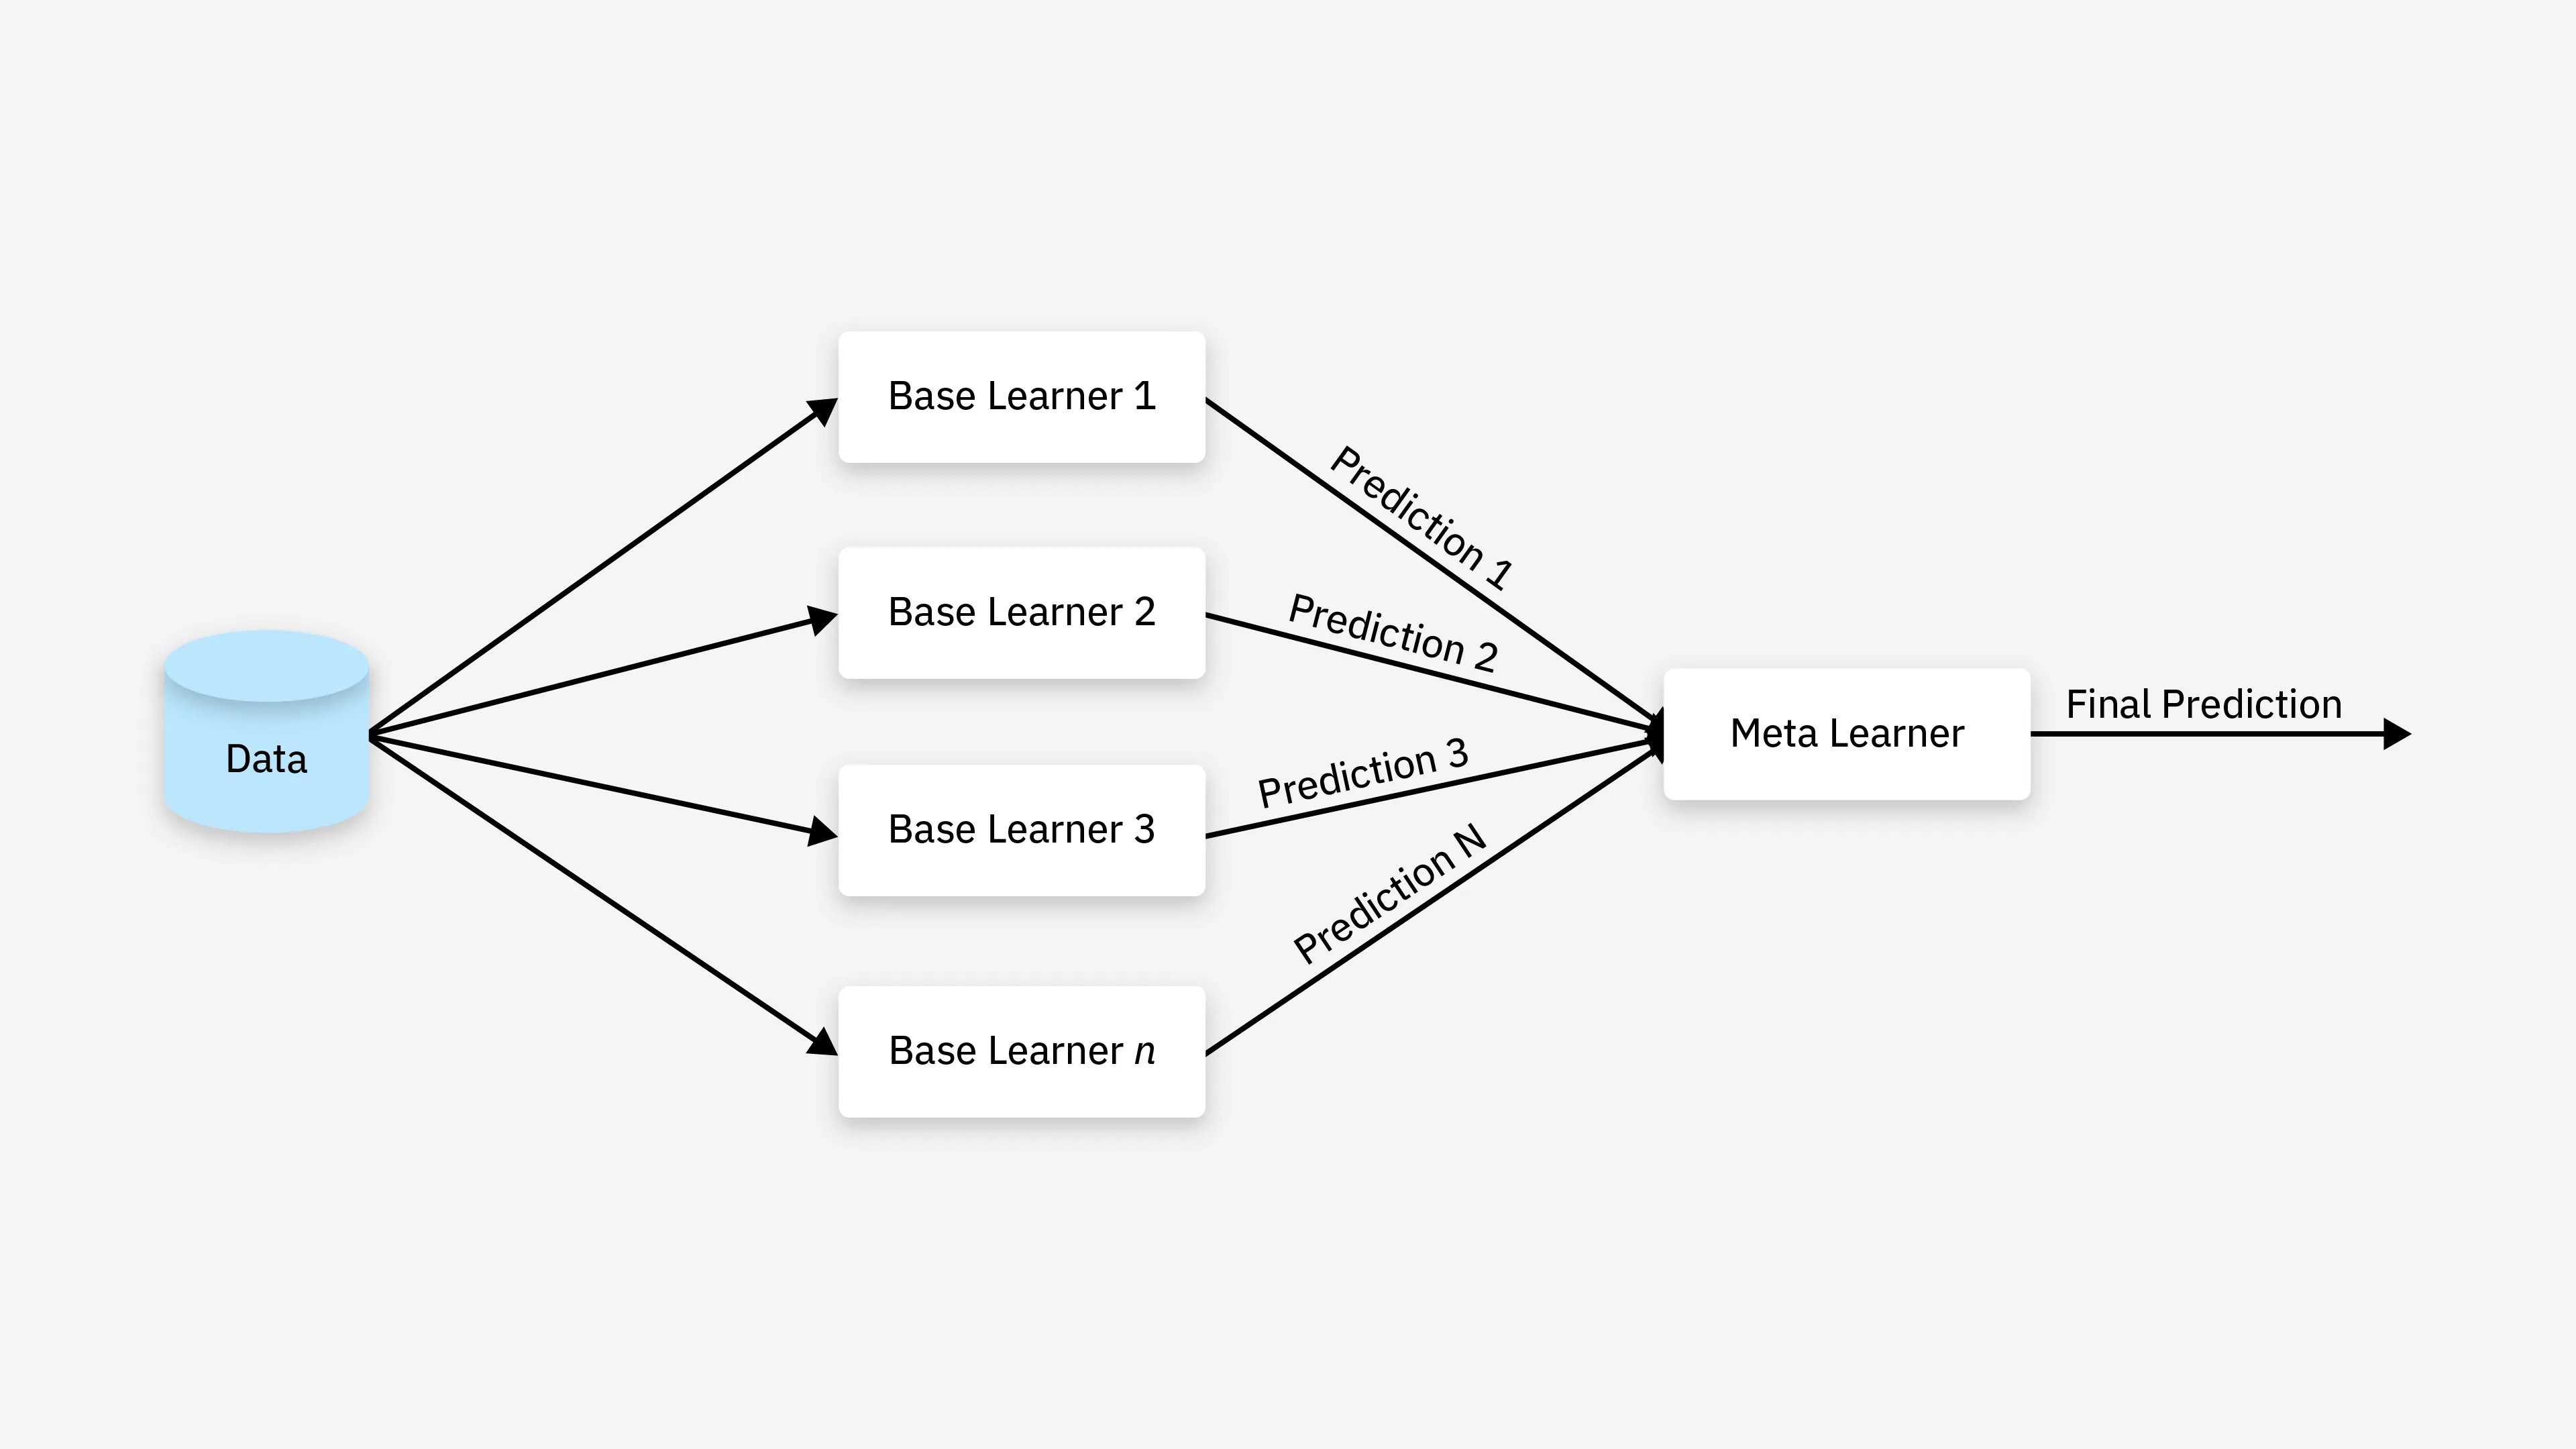
- Stacking: Entrenando múltiples modelos diferentes, luego utilizando las salidas de estos modelos como nuevas características, y entrenando un metamodelo (Meta-Model) para realizar la predicción final.
1. Bagging(Bootstrap Aggregating)
El objetivo de Bagging es mejorar el rendimiento reduciendo la varianza del modelo; es adecuado para modelos de alta varianza y propensos a sobreajuste. Se implementa mediante los siguientes pasos:
- Remuestreo del conjunto de datos: Realizar múltiples muestreos aleatorios con reemplazo (bootstrap) sobre el conjunto de entrenamiento, obteniendo un subconjunto de datos en cada muestreo.
- Entrenar múltiples modelos: Entrenar un aprendiz base (generalmente del mismo tipo de modelo) en cada subconjunto de datos.
- Combinación de resultados: Combinar los resultados de varios aprendices base, normalmente mediante votación (problemas de clasificación) o promediado (problemas de regresión).
Algoritmos típicos:
- Bosque aleatorio (Random Forest): El bosque aleatorio es una implementación clásica de Bagging; construye múltiples árboles de decisión y cada árbol selecciona características aleatoriamente durante el entrenamiento, reduciendo así el riesgo de sobreajuste.
Ventajas:
- Puede reducir eficazmente la varianza y mejorar la estabilidad del modelo.
- Es adecuado para modelos de alta varianza, como los árboles de decisión.
Desventajas:
- El proceso de entrenamiento requiere bastante tiempo, ya que es necesario entrenar múltiples modelos.
- Los resultados son difíciles de interpretar porque no hay un único modelo.
2. Boosting
El objetivo de Boosting es mejorar el rendimiento reduciendo el sesgo del modelo; es adecuado para aprendices débiles. La idea central de Boosting es ajustar progresivamente los pesos de cada modelo, enfatizando las muestras que fueron clasificadas incorrectamente por el modelo de la ronda anterior. Boosting se implementa mediante los siguientes pasos:
- Entrenamiento secuencial: Los modelos se entrenan uno tras otro, y cada ronda de entrenamiento se ajusta según los errores de la ronda anterior.
- Votación ponderada: La predicción final es la suma ponderada de las predicciones de todos los aprendices débiles, donde las muestras mal clasificadas reciben un peso mayor.
- Combinación de modelos: El peso de cada modelo se determina según su desempeño durante el proceso de entrenamiento.
Algoritmos típicos:
- AdaBoost(Adaptive Boosting): AdaBoost cambia los pesos de las muestras para que cada clasificador posterior preste más atención a las muestras mal clasificadas en la ronda anterior.
- Árboles de potenciación de gradiente (Gradient Boosting Trees, GBT): GBT optimiza iterativamente la función objetivo, reduciendo gradualmente el sesgo.
- XGBoost(Extreme Gradient Boosting): XGBoost es un algoritmo de potenciación de gradiente eficiente, ampliamente utilizado en competiciones de ciencia de datos, con un rendimiento y optimización sólidos.
- LightGBM(Light Gradient Boosting Machine): LightGBM es un marco basado en árboles de potenciación de gradiente que, en comparación con XGBoost, ofrece una velocidad de entrenamiento más rápida y un menor uso de memoria.
Ventajas:
- Es adecuado para modelos con sesgo alto y puede mejorar eficazmente la precisión de las predicciones.
- Rendimiento potente; se desempeña excelentemente en muchas aplicaciones prácticas.
Desventajas:
- Es sensible a los datos ruidosos y puede provocar fácilmente sobreajuste.
- El proceso de entrenamiento es lento, especialmente con grandes volúmenes de datos.
3. Stacking(Stacked Generalization)
Stacking es un método que mejora la precisión general de las predicciones entrenando diferentes tipos de modelos y combinando sus predicciones. Su idea central es:
- Primera capa (aprendices base): Entrenar múltiples aprendices base de diferentes tipos (por ejemplo, árboles de decisión, SVM, KNN, etc.) para predecir los datos.
- Segunda capa (metaprendiz): Usar los resultados de predicción de los aprendices de la primera capa como entrada para entrenar un metaprendiz (generalmente regresión logística, regresión lineal, etc.) y realizar la predicción final.
Ventajas:
- Puede usar diferentes tipos de aprendices base para capturar distintos patrones en los datos.
- En teoría, puede combinar las ventajas de múltiples modelos para alcanzar una mayor capacidad de predicción.
Desventajas:
- El proceso de entrenamiento es complejo, se requiere entrenar múltiples modelos y la forma de combinación entre los modelos también necesita un diseño cuidadoso.
- Es más complejo que otros métodos de conjunto como Bagging y Boosting, y es propenso al sobreajuste.
Demostración de ejemplo
Ejemplo
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Cargar el conjunto de datos
iris = load_iris()
X, y = iris.data, iris.target
# Dividir el conjunto de entrenamiento y el de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Crear el clasificador de bosque aleatorio
rf = RandomForestClassifier(n_estimators=100, random_state=42)
# Entrenar el modelo
rf.fit(X_train, y_train)
# Predecir
y_pred = rf.predict(X_test)
# Calcular la precisión
accuracy = accuracy_score(y_test, y_pred)
print(f"Precisión del bosque aleatorio: {accuracy:.2f}")
El resultado de salida es el siguiente:
随机森林的准确率: 1.00
Explicación del código:
- Cargar el conjunto de datos: Usamos
load_iris()la función para cargar el clásico conjunto de datos Iris. - Dividir el conjunto de entrenamiento y el de prueba: Usar
train_test_split()la función para dividir el conjunto de datos en entrenamiento y prueba. - Crear el clasificador de bosque aleatorio: Usar
RandomForestClassifierla clase para crear un clasificador de bosque aleatorio,n_estimators=100indica que se utilizan 100 árboles de decisión. - Entrenar el modelo: Usar
fit()el método para entrenar el modelo. - Predecir: Usar
predict()el método para realizar predicciones sobre el conjunto de prueba. - Calcular la precisión: Usar
accuracy_score()la función para calcular la precisión del modelo.
Boosting:AdaBoost
Principio del algoritmo:La idea central de Boosting es entrenar múltiples modelos de forma iterativa, donde cada modelo intenta corregir los errores del modelo anterior. AdaBoost (Adaptive Boosting) es uno de los algoritmos Boosting más clásicos.
Ejemplo
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.tree import DecisionTreeClassifier
# Cargar el conjunto de datos
iris = load_iris()
X, y = iris.data, iris.target
# Dividir el conjunto de entrenamiento y el de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Usar el aprendiz débil predeterminado (árbol de decisión) y especificar el algoritmo SAMME
ada = AdaBoostClassifier(DecisionTreeClassifier(max_depth=1),
n_estimators=50,
random_state=42,
algorithm='SAMME')
# Entrenar el modelo
ada.fit(X_train, y_train)
# Predecir
y_pred = ada.predict(X_test)
# Calcular la precisión
accuracy = accuracy_score(y_test, y_pred)
print(f"Precisión de AdaBoost: {accuracy:.2f}")
El resultado de salida es el siguiente:
AdaBoost的准确率: 1.00
Explicación del código:
- Cargar el conjunto de datos: Usar
load_iris()la función para cargar el conjunto de datos Iris, que contiene los datos de característicasXy los datos de etiquetasy。 - Dividir el conjunto de entrenamiento y el de prueba: Usar
train_test_split()la función para dividir el conjunto de datos en entrenamiento y prueba, donde el conjunto de prueba representa el 30% y el de entrenamiento el 70%. - Crear el clasificador de árbol de decisión: Usar
DecisionTreeClassifier(max_depth=1)crear un clasificador de árbol de decisión con profundidad 1, utilizado como aprendiz base de AdaBoost. - Crear el clasificador AdaBoost: Usar
AdaBoostClassifier()la clase para crear el clasificador AdaBoost,n_estimators=50indica que se utilizan 50 aprendices débiles,algorithm='SAMME'especifica el uso del algoritmo SAMME. - Entrenar el modelo: Usar
fit()el método para entrenar el modelo AdaBoost sobre los datos de entrenamiento. - Predecir: Usar
predict()el método para realizar predicciones sobre el conjunto de prueba, generando las etiquetas predichasy_pred。 - Calcular la precisión: Usar
accuracy_score()la función para calcular y mostrar la precisión de las predicciones del modelo.
Stacking: Apilamiento de modelos
Principio del algoritmo:La idea central de Stacking es entrenar múltiples modelos diferentes y luego usar las salidas de estos modelos como nuevas características, para entrenar un metamodelo (Meta-Model) que realice la predicción final.
Ejemplo
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.svm import SVC
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Cargar el conjunto de datos
iris = load_iris()
X, y = iris.data, iris.target
# Dividir el conjunto de entrenamiento y el de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Definir los aprendices base
estimators = [
('dt', DecisionTreeClassifier(max_depth=1)),
('svc', SVC(kernel='linear', probability=True))
]
# Crear el clasificador de Stacking
stacking = StackingClassifier(estimators=estimators, final_estimator=LogisticRegression())
# Entrenar el modelo
stacking.fit(X_train, y_train)
# Predecir
y_pred = stacking.predict(X_test)
# Calcular la precisión
accuracy = accuracy_score(y_test, y_pred)
print(f"Precisión de Stacking: {accuracy:.2f}")
El resultado de salida es el siguiente:
tacking的准确率: 1.00
Explicación del código:
- Cargar el conjunto de datos: Del mismo modo, usar
load_iris()La función carga el conjunto de datos Iris. - Dividir el conjunto de entrenamiento y el conjunto de prueba: usar
train_test_split()la función divide el conjunto de datos en conjunto de entrenamiento y conjunto de prueba. - Definir el aprendiz base: usar
DecisionTreeClassifierySVCcomo aprendiz base. - Crear el clasificador Stacking: usar
StackingClassifierla clase crea un clasificador Stacking,final_estimator=LogisticRegression()indica usar regresión logística como metamodelo. - Entrenar el modelo: usar
fit()el método entrena el modelo. - Predecir: usar
predict()el método realiza predicciones sobre el conjunto de prueba. - Calcular la precisión: usar
accuracy_score()la función calcula la precisión del modelo.