Aprendizaje profundo vs Aprendizaje automático tradicional
Imagina que estás enseñando a un niño a reconocer gatos y perros. El método tradicional podría ser: sacas un libro ilustrado, señalas la imagen y dices que esto es un gato, tiene orejas puntiagudas, bigotes y una cola larga; esto es un perro, sus orejas pueden estar caídas y su nariz es más larga. Le estás diciendo explícitamente al niño lasreglas y características para distinguir entre ambos。
El otro método sería: le muestras al niño miles de imágenes de gatos y perros, simplemente le dices si cada imagen es un gato o un perro. Después de suficientes observaciones, el cerebro del niño resumirá por sí mismo esas características distintivas complejas e indescriptibles entre gatos y perros, como la textura del pelaje, la expresión de los ojos, el contorno del cuerpo. Este método se acerca más adejar que los datos hablen por sí mismos。
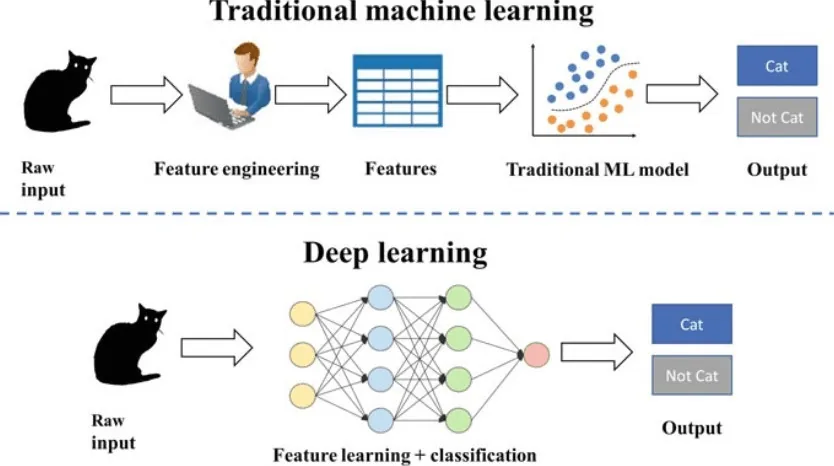
Estos dos métodos de enseñanza corresponden precisamente a los dos paradigmas importantes en el campo del aprendizaje automático:aprendizaje automático tradicionalyaprendizaje profundo. Este artículo explicará claramente para principiantes las ideas centrales, los principios de funcionamiento, las ventajas, las desventajas y los escenarios de aplicación de ambos, lo que te ayudará a establecer una comprensión macro y a elegir la dirección para tu aprendizaje posterior.
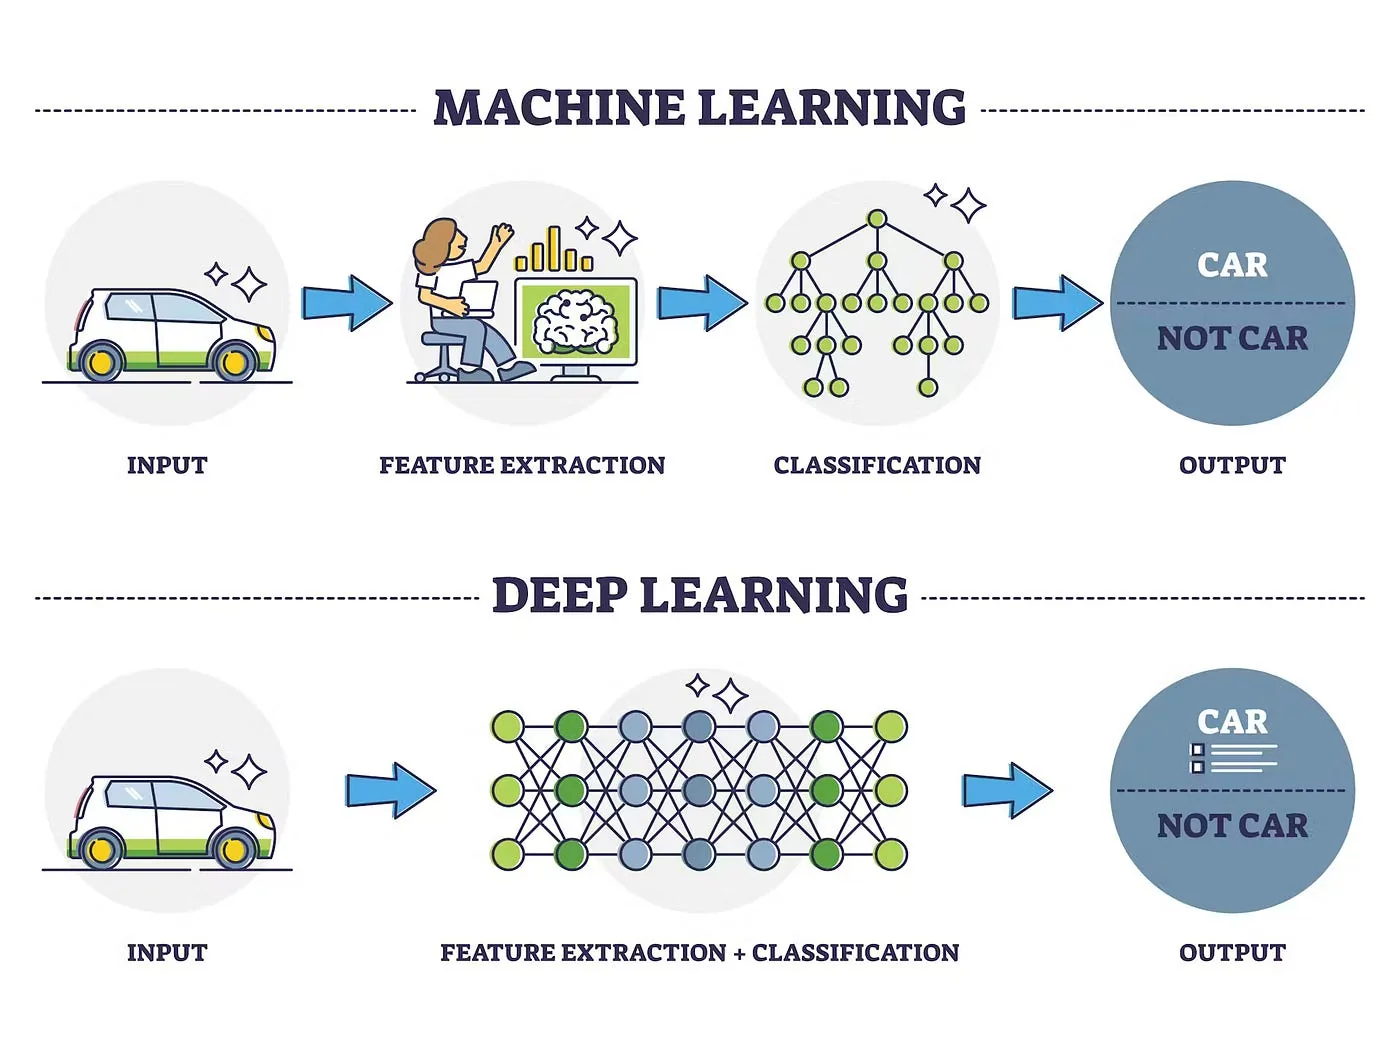
Parte 1: Aprendizaje automático tradicional — El analista basado en reglas y características
El aprendizaje automático tradicional puede considerarse como un analista que necesita instrucciones claras y datos estructurados.
¿Qué es el aprendizaje automático tradicional?
El aprendizaje automático tradicional es un conjunto de algoritmos cuya idea central es:aprender patrones (modelos) a partir de los datos, y utilizar estos patrones para predecir o tomar decisiones sobre datos nuevos. Su éxito depende en gran medida de un paso previo y crucial:la ingeniería de características。
Flujo de trabajo principal
Entendamos visualmente el proceso de trabajo del aprendizaje automático tradicional a través de un diagrama de flujo:
Análisis del flujo:
- Ingeniería de características: Es el paso más central y el que más depende de la inteligencia humana. Debes extraer de los datos brutos (como los píxeles de una imagen, las palabras de un texto) características cuantificables que ayuden a resolver el problema. Por ejemplo, en la detección de correo no deseado, las características podrían ser si contiene la palabra "gratis", si la dirección del remitente está en la libreta de contactos, etc.
- Selección y entrenamiento del algoritmo: Introduce los datos de características procesados en el algoritmo seleccionado (como Máquinas de Vectores de Soporte (SVM), árboles de decisión). El algoritmo intentará encontrar una función o regla que pueda predecir mejor el resultado basándose en estas características (como si es correo no deseado o no).
- Predicción: Cuando llega un nuevo correo, el sistema primero extrae las mismas características y luego se las entrega al modelo entrenado para que tome la decisión.
Características principales, ventajas y desventajas
| Característica | Descripción | Ventajas | Desventajas |
|---|---|---|---|
| Fuerte dependencia de la ingeniería de características | El límite superior del rendimiento del modelo está determinado por la calidad de las características. | Alta interpretabilidad; el conocimiento de los expertos humanos puede integrarse en él. | Requiere una gran cantidad de conocimiento del dominio y tiempo para el diseño y la extracción de características; el costo es alto. |
| Modelo relativamente simple | Generalmente se utilizan modelos lineales, modelos de árbol, etc. | La velocidad de entrenamiento es rápida y requiere menos recursos computacionales. | Capacidad limitada para el manejo dedatos no estructurados(imágenes, audio, lenguaje natural); es difícil capturar sus patrones complejos y profundos. |
| Buena interpretabilidad | Se puede entender cómo el modelo toma decisiones (por ejemplo, las rutas de reglas de los árboles de decisión). | Es crucial en campos que requieren explicación de las decisiones, como finanzas y medicina. | En busca de la interpretabilidad, a veces se sacrifica parte de la precisión de la predicción. |
Analogía simple: El aprendizaje automático tradicional es como unanalista que posee poderosas fórmulas y herramientas estadísticas, pero que debe preparar personalmente todos los materiales de análisis。
Parte 2: Aprendizaje profundo — El perceptor que aprende automáticamente
El aprendizaje profundo es un subcampo del aprendizaje automático que intenta imitar la forma de trabajo de las neuronas del cerebro humano, permitiendo que las máquinas aprendan automáticamente representaciones de características de múltiples niveles a partir de datos brutos.
¿Qué es el aprendizaje profundo?
El núcleo del aprendizaje profundo son lasredes neuronales artificiales, especialmente las redes neuronales profundas con muchas capas. Su mayor característica es poderaprender de extremo a extremo: introduces los datos más brutos (como los píxeles originales de una imagen) y la red puede generar el resultado final (como la categoría de la imagen); el complejo proceso de extracción de características intermedio se completa automáticamente mediante la red.
Arquitectura de trabajo principal
El aprendizaje profundo, especialmente las redes neuronales convolucionales utilizadas para el reconocimiento de imágenes, tiene un proceso de aprendizaje jerárquico y progresivo, de lo simple a lo profundo:

Análisis de la arquitectura:
- Aprendizaje jerárquico de características: La primera capa de la red puede aprender solo a reconocerbordes y esquinas. La segunda capa combina estos bordes y aprende a reconocertexturas y formas simples(como círculos, rayas). Las capas más profundas combinan estas formas simples para formarpartes y objetos complejos(como ojos, puertas de automóviles). Las últimas capas combinan estas partes para formarconceptos de objetos completos(como gatos, automóviles).
- Aprendizaje de extremo a extremo: No necesitas decirle a la red qué es un borde o una textura. Solo necesitas proporcionar una gran cantidad de datos brutos etiquetados (imágenes y las etiquetas correspondientes de gato/perro); mediante el algoritmo deretropropagación, la red ajusta automáticamente sus millones o incluso miles de millones de parámetros internos, aprendiendo por sí misma qué combinaciones de patrones de píxeles corresponden a gatos y cuáles a perros.
Características principales, ventajas y desventajas
| Característica | Descripción | Ventajas | Desventajas |
|---|---|---|---|
| Ingeniería automática de características | Puede aprender automáticamente características abstractas de múltiples niveles a partir de datos brutos. | Elimina la tediosa ingeniería manual de características, y destaca especialmente en el procesamiento de imágenes, voz y texto. | Es como una "caja negra"; el proceso interno de toma de decisiones es difícil de explicar. |
| Fuerte capacidad para procesar datos no estructurados | Naturalmente adecuado para procesar datos complejos como píxeles, ondas de sonido y secuencias de palabras. | Alcanza e incluso supera el nivel humano en campos como la visión por computadora, el procesamiento del lenguaje natural y el reconocimiento de voz. | Requieregrandes volúmenes de datospara entrenarse; cuando los datos son insuficientes, tiende a tener un rendimiento deficiente. |
| Modelo complejo, con muchos parámetros | La red tiene capas profundas y contiene una gran cantidad de neuronas y conexiones. | Capaz de modelar relaciones extremadamente complejas y no lineales, con un gran potencial. | El entrenamiento consume muchísimo tiempo y requiere potentes recursos computacionales (como GPU); además, el despliegue del modelo necesita cierta capacidad de cómputo. |
| Mala interpretabilidad | Es difícil entender por qué el modelo emite un juicio específico. | - | Su aplicación es limitada en campos que requieren una explicación estricta (como la aprobación de créditos y el diagnóstico de enfermedades). |
Analogía simple: El aprendizaje profundo es como unperceptor que posee una red de procesamiento de información de múltiples capas y que puede crecer por sí mismo a través de numerosas observaciones, pero el proceso de cómo llega a conclusiones no es muy transparente.
Parte 3: Comparación clave y cómo elegir
Ahora, pongamos ambos uno al lado del otro para una comparación directa y ofrezcamos sugerencias para elegir.
Tabla comparativa de diferencias clave
| Dimensión de comparación | Aprendizaje automático tradicional | Aprendizaje profundo |
|---|---|---|
| Dependencia de datos | Los requisitos de cantidad de datos son relativamente bajos; adecuado para conjuntos de datos de pequeña y mediana escala. | Depende en gran medida de grandes datos; cuantos más datos, mejor suele ser el rendimiento. |
| Procesamiento de características | ManualLa ingeniería de características es la clave y la carga principal. | AutomáticoRealiza la extracción y abstracción de características. |
| Recursos computacionales | Generalmente puede ejecutarse de manera eficiente en CPU; los requisitos son bajos. | Requiere GPU potentes para el entrenamiento; el costo computacional es alto. |
| Interpretabilidad del modelo | Buena; el proceso de decisión es relativamente transparente. | Mala; a menudo se considera un "modelo de caja negra". |
| Dominio de problemas | Adecuado para manejardatos estructurados(datos tabulares, escenarios con características claramente definidas). | Adecuado para manejardatos no estructurados(imágenes, audio, texto, video). |
| Tiempo de entrenamiento | Relativamente corto, de minutos a horas. | Generalmente largo, de horas a semanas o incluso más. |
| Barrera de entrada | Relativamente baja; fácil de entender e implementar prototipos. | Barrera relativamente alta; se requiere comprender conocimientos complejos como redes neuronales, ajuste de parámetros, etc. |
Guía práctica de selección: ¿Cuál debería usar?
Puedes seguir este proceso de decisión:
¿Qué tipo de datos tienes?
- Si sondatos tabulares estructurados(como tablas de Excel que contienen columnas como edad, ingresos, historial de compras), prioriza el aprendizaje automático tradicional (como XGBoost de árboles de gradiente potenciado, Random Forest).
- Si sonimágenes, voz, texto o datos secuenciales, el aprendizaje profundo (CNN, RNN, Transformer) suele ser la mejor opción.
¿Cuántos datos tienes?
- Cuando la cantidad de datos es limitada (de miles a decenas de miles), el aprendizaje automático tradicional suele ser más robusto.
- Cuando tienes datos masivos (cientos de miles o más), el poder del aprendizaje profundo puede desplegarse por completo.
¿Tienes requisitos de interpretabilidad del modelo?
- En escenarios como el control de riesgo financiero o el diagnóstico médico auxiliar, donde es necesario poder explicar por qué se rechaza un préstamo o por qué se sospecha de una enfermedad, el aprendizaje automático tradicional es la opción más segura.
- En escenarios como clasificación de imágenes, asistentes de voz o sistemas de recomendación, donde se prioriza el rendimiento y se acepta la caja negra, el aprendizaje profundo tiene ventaja.
¿Cómo son tus recursos computacionales?
- Si no tienes una GPU potente y tiempo suficiente, empezar con el aprendizaje automático tradicional es una opción más pragmática.
Resumen en una frase:El aprendizaje automático tradicional es el arte del análisis de datos, mientras que el aprendizaje profundo es la ciencia de la percepción y la representación.No son una relación de reemplazo, sino un conjunto de herramientas complementarias. Un buen profesional de la IA debe elegir la herramienta más adecuada del conjunto según el problema específico.
Otras extensiones