Regresión Logística (Logistic Regression)
La regresión logística (Logistic Regression) es un método de aprendizaje estadístico ampliamente utilizado en problemas de clasificación. Aunque su nombre incluye "regresión", en realidad es un algoritmo para problemas de clasificación binaria o multiclase.
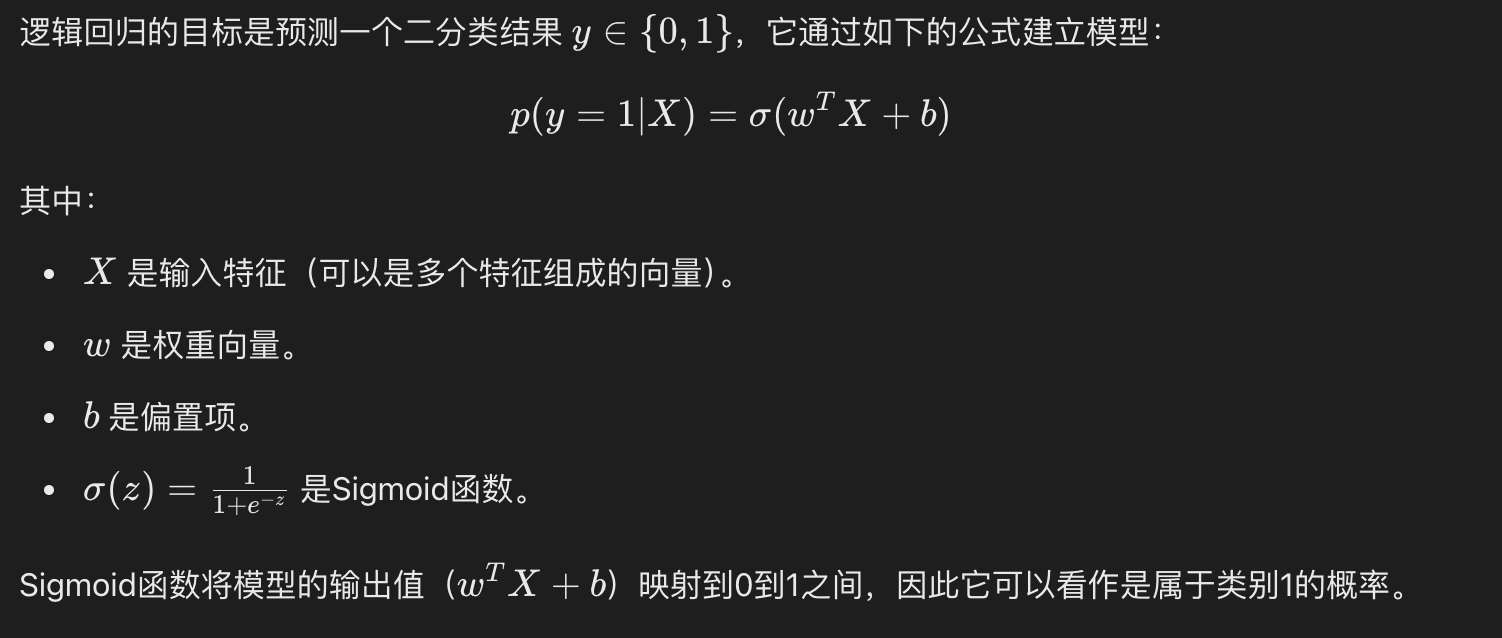
La regresión logística utiliza la función logística (también llamada función Sigmoid) para mapear la salida de la regresión lineal entre 0 y 1, prediciendo así la probabilidad de que ocurra un evento.
La regresión logística se utiliza ampliamente en diversos problemas de clasificación, por ejemplo:
- Detección de correo no deseado (spam / no spam)
- Predicción de enfermedades (enfermo / no enfermo)
- Predicción de abandono de clientes (abandona / no abandona)
Modelo de regresión logística
Función de pérdida
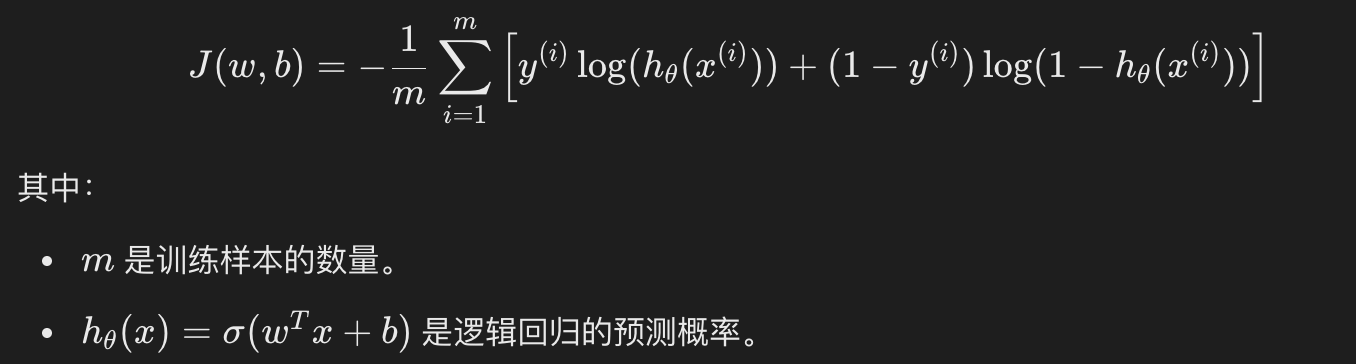
La función de pérdida de la regresión logística es la función de pérdida logarítmica (Log Loss), cuya forma es la siguiente:
Solución mediante descenso de gradiente
Al igual que la regresión lineal, la regresión logística también suele utilizar el descenso de gradiente para optimizar la función de pérdida y resolver los parámetros w y b. Las reglas de actualización del gradiente para la regresión logística son las siguientes:
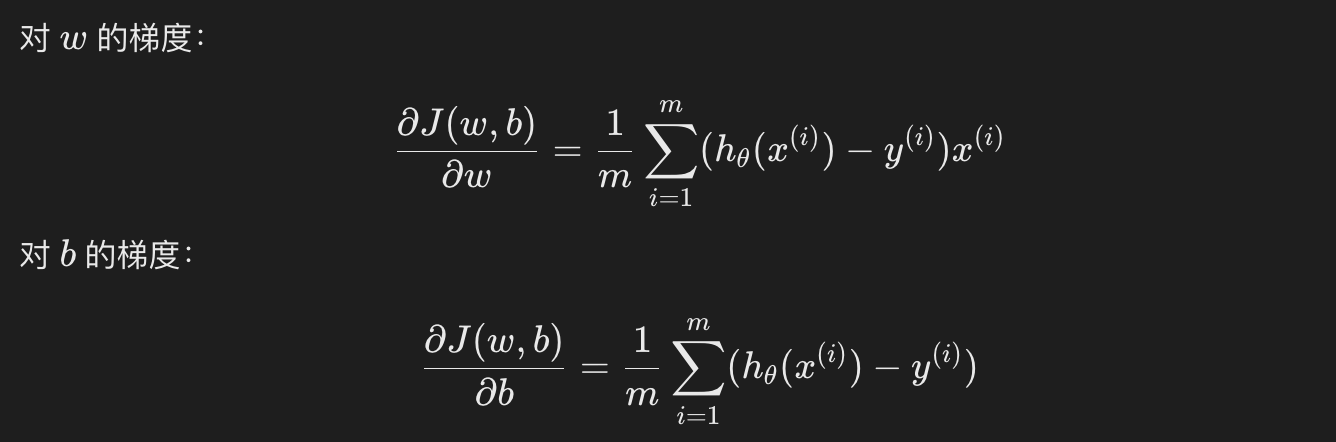
Actualizando continuamente w y b hasta que la función de pérdida converja.
Implementar regresión logística con Python
A continuación, usaremos Python y la biblioteca Scikit-learn para implementar un modelo simple de regresión logística.
1. Importar las bibliotecas necesarias
Ejemplo
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
2. Cargar el conjunto de datos
Usaremos el conjunto de datos Iris incluido en Scikit-learn. El conjunto de datos Iris contiene 150 muestras, cada muestra tiene 4 características y el objetivo es clasificar las muestras en 3 clases. Para simplificar el problema, solo utilizaremos las dos primeras características y lo convertiremos en un problema de clasificación binaria.
Ejemplo
iris = load_iris()
X = iris.data[:, :2] # Usar solo las dos primeras características
y = (iris.target != 0) * 1 # Convertir el objetivo en un problema de clasificación binaria
# Dividir en conjunto de entrenamiento y de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
3. Entrenar el modelo de regresión logística
Ejemplo
model = LogisticRegression()
# Entrenar el modelo
model.fit(X_train, y_train)
4. Evaluación del modelo
Ejemplo
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# Cargar el conjunto de datos
iris = load_iris()
X = iris.data[:, :2] # Usar solo las dos primeras características
y = (iris.target != 0) * 1 # Convertir el objetivo en un problema de clasificación binaria
# Dividir en conjunto de entrenamiento y de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Crear el modelo de regresión logística
model = LogisticRegression()
# Entrenar el modelo
model.fit(X_train, y_train)
# Predecir el conjunto de prueba
y_pred = model.predict(X_test)
# Calcular la exactitud (accuracy)
accuracy = accuracy_score(y_test, y_pred)
print(fExactitud del modelo: {accuracy:.2f})
# Matriz de confusión
conf_matrix = confusion_matrix(y_test, y_pred)
print(Matriz de confusión:)
print(conf_matrix)
# Informe de clasificación
class_report = classification_report(y_test, y_pred)
print(Informe de clasificación:)
print(class_report)
El resultado de salida es:
模型准确率: 1.00
混淆矩阵:
[[19  0]
 [ 0 26]]
分类报告:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00        19
           1       1.00      1.00      1.00        26

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45
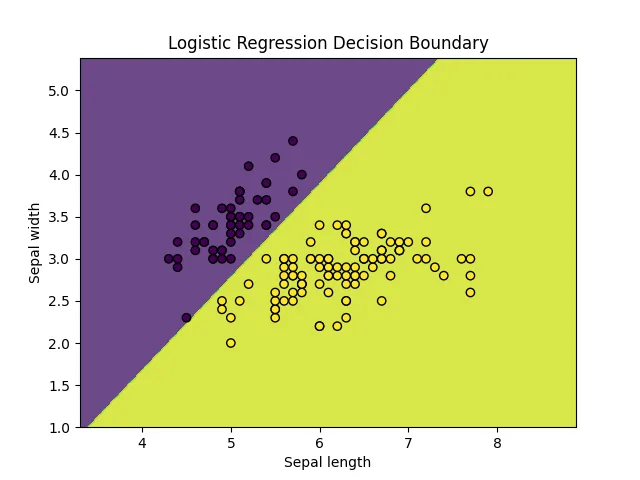
5. Visualizar la frontera de decisión
Ejemplo
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# Cargar el conjunto de datos
iris = load_iris()
X = iris.data[:, :2] # Usar solo las dos primeras características
y = (iris.target != 0) * 1 # Convertir el objetivo en un problema de clasificación binaria
# Dividir en conjunto de entrenamiento y de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Crear el modelo de regresión logística
model = LogisticRegression()
# Entrenar el modelo
model.fit(X_train, y_train)
# Predecir el conjunto de prueba
y_pred = model.predict(X_test)
# Visualizar la frontera de decisión
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.01),
np.arange(y_min, y_max, 0.01))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.8)
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o')
plt.xlabel('Sepal length')
plt.ylabel('Sepal width')
plt.title('Logistic Regression Decision Boundary')
plt.show()
Se muestra a continuación:
Resumen
- La regresión logística convierte la salida de la regresión lineal en valores de probabilidad mediante la función Sigmoid, y se utiliza para resolver problemas de clasificación binaria.
- El proceso de entrenamiento de la regresión logística optimiza los parámetros del modelo minimizando la función de pérdida logarítmica.
- El descenso de gradiente es un método de optimización común utilizado para actualizar los parámetros del modelo.y。
- La biblioteca Scikit-learn de Python
scikit-learnproporciona una interfaz simple y fácil de usar para implementar la regresión logística, y permite realizar fácilmente el entrenamiento, la evaluación y la visualización del modelo.