Ingeniería de características
Imagina que eres un chef y quieres preparar un delicioso plato. El modelo de aprendizaje automático es como tu 'algoritmo de cocina', y los datos brutos son los diversos ingredientes que compras en el mercado: verduras, carne, condimentos, pero algunos pueden estar sucios, otros enteros, y algunos con un sabor fuerte.Ingeniería de característicasEs el proceso de limpiar, cortar, marinar y combinar estos 'ingredientes' brutos, transformándolos en 'productos semielaborados' listos para cocinar. Es el puente que conecta los datos brutos con el modelo de aprendizaje automático y el paso clave que determina el límite superior del rendimiento del modelo.
En pocas palabras,Ingeniería de característicases el proceso de utilizar conocimiento del dominio, mediante una serie de técnicas, para extraer, construir y seleccionar características (variables) que sean más valiosas y más fáciles de aprender para el modelo de aprendizaje automático.
1. ¿Por qué es tan importante la ingeniería de características?
En un proyecto de aprendizaje automático, la calidad de los datos y las características determina directamente el límite superior del rendimiento del modelo, mientras que el modelo y los algoritmos solo se acercan a ese límite. Una buena ingeniería de características puede:
- Mejorar el rendimiento del modelo: Las buenas características facilitan que el modelo descubra patrones en los datos.
- Acelerar el entrenamiento del modelo: Reducir características irrelevantes o redundantes puede disminuir la complejidad computacional.
- Mejorar la capacidad de generalización del modelo: Evitar que el modelo se sobreajuste al ruido en los datos de entrenamiento.
- Adaptarse a los requisitos del modelo: Diferentes modelos tienen diferentes supuestos sobre los datos (por ejemplo, los modelos lineales asumen relaciones lineales); la ingeniería de características puede hacer que los datos cumplan estos supuestos.
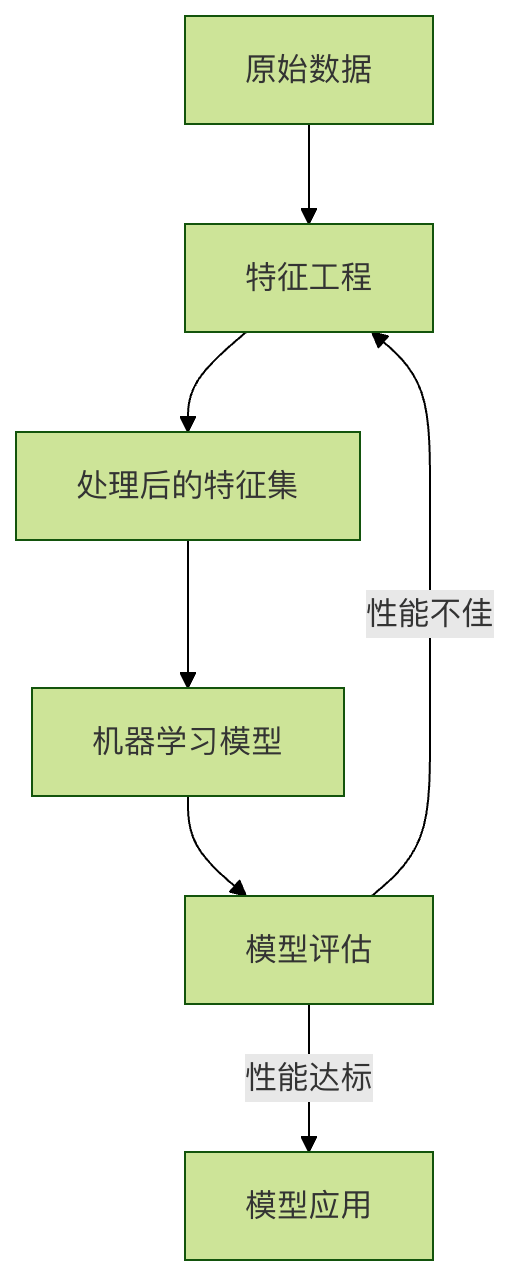
Podemos utilizar el siguiente diagrama de flujo para comprender intuitivamente la posición de la ingeniería de características en todo el proceso de aprendizaje automático:
2. Operaciones principales de la ingeniería de características
La ingeniería de características incluye principalmente tres tipos de operaciones:Procesamiento de características、Construcción de característicasySelección de características。
1. Procesamiento de características
Este es el paso más básico, cuyo objetivo es 'limpiar' los datos brutos en un formato limpio y ordenado.
a) Manejo de valores faltantes
Los datos a menudo contienen valores faltantes (por ejemplo,NaN, NULL), que deben procesarse adecuadamente.
| Método de procesamiento | Descripción | Escenario de aplicación |
|---|---|---|
| Eliminar | Eliminar directamente las filas o columnas que contienen valores faltantes | Cuando los datos faltantes son muy pocos, o cuando la característica no es importante |
| Rellenar | Rellenar con un valor, como la media, la mediana, la moda o un valor especial (por ejemplo, -1) | El método más común, aplicable a diversas situaciones |
| Interpolación | Realizar interpolación mediante series temporales o puntos de datos adyacentes | Datos de series temporales |
Ejemplo de código (usando la biblioteca pandas de Python):
Ejemplo
import numpy as np
# Crear un DataFrame de ejemplo con valores faltantes
data = {'Edad': [25, np.nan, 30, 35, np.nan],
'Salario': [50000, 54000, np.nan, 62000, 58000],
'Ciudad': ['Pekín', Shanghái, 'Guangzhou', np.nan, 'Pekín']}
df = pd.DataFrame(data)
print("datos originales:")
print(df)
# 1. Eliminar los valores faltantes (eliminar cualquier fila que contenga NaN)
df_dropped = df.dropna()
print("\nDespués de eliminar los valores faltantes:")
print(df_dropped)
# 2. Rellenar valores faltantes
# Rellenar columnas numéricas con la media
df_filled = df.copy()
df_filled['Edad'].fillna(df_filled['Edad'].mean(), inplace=True)
df_filled['Salario'].fillna(df_filled['Salario'].mean(), inplace=True)
# Rellenar columnas categóricas con la moda
df_filled['Ciudad'].fillna(df_filled['Ciudad'].mode()[0], inplace=True)
print("\nDespués de imputar los valores faltantes:")
print(df_filled)
b) Manejo de valores atípicos
Los valores atípicos son valores que difieren notablemente de la mayoría de los datos y pueden interferir con el modelo. Los métodos de detección comunes incluyen:
- Método de desviación estándar: considera que los valores fuera del rango de la media ± 3 veces la desviación estándar son atípicos.
- Método de diagrama de caja: considera que los valores menores que
Q1 - 1.5*IQRo mayores queQ3 + 1.5*IQRes un valor atípico (IQR = Q3 - Q1)。
El manejo puede ser eliminar, reemplazar con el valor límite o tratar como valor faltante.
c) Estandarización/Normalización de datos
Muchos modelos (como SVM, KNN, redes neuronales) son sensibles a la escala de las características. Necesitamos transformar características de diferentes escalas a una misma escala.
| Método | Fórmula | Descripción | Escenario de aplicación |
|---|---|---|---|
| Estandarización | (x - 均值) / 标准差 |
Después del procesamiento, la media de los datos es 0 y la desviación estándar es 1 | Cuando la distribución de los datos se aproxima a una distribución normal |
| Normalización | (x - min) / (max - min) |
Escalar los datos al intervalo [0, 1] | Cuando los límites de los datos son claros y se necesita un cálculo rápido |
Ejemplo de código (usando la biblioteca scikit-learn):
Ejemplo
import numpy as np
# Datos de ejemplo
data = np.array([[1000, 25],
[1500, 30],
[800, 20],
[1200, 28]])
# Estandarización
scaler_standard = StandardScaler()
data_standardized = scaler_standard.fit_transform(data)
print("Datos estandarizados (media ~0, desviación estándar ~1):")
print(data_standardized)
print(fMedia: {data_standardized.mean(axis=0)})
print(fDesviación estándar: {data_standardized.std(axis=0)})
# normalización
scaler_minmax = MinMaxScaler()
data_normalized = scaler_minmax.fit_transform(data)
print("\nDatos normalizados (rango [0,1]):)
print(data_normalized)
2. Construcción de características
Al combinar o transformar características existentes, se crean características nuevas con mayor poder predictivo.
a) Transformación de características numéricas
- Características polinómicas: crear cuadrados, cubos, etc., de características para ayudar a los modelos lineales a aprender relaciones no lineales.
- Discretización: dividir la edad continua en intervalos como 'joven', 'mediana edad', 'anciano', discretizando datos continuos.
- Transformación matemática: utilizar transformaciones como logaritmos, exponenciales, etc., para cambiar la distribución de los datos.
b) Codificación de características categóricas
Los modelos de aprendizaje automático no pueden procesar directamente texto como 'Beijing', 'Shanghái'. Es necesario convertirlos a números.
| Método | Descripción | Particularidad |
|---|---|---|
| Codificación de etiquetas | Asigna un entero único a cada categoría, por ejemplo,北京:0, 上海:1 |
Simple, pero puede introducir una relación de orden errónea (el modelo podría pensar que 1>0) |
| Codificación one-hot | Crea una nueva característica binaria (0 o 1) para cada categoría | Puede eliminar la confusión de orden, pero si hay muchas categorías, puede provocar una explosión de dimensionalidad. |
Ejemplo de código:
Ejemplo
from sklearn.preprocessing import LabelEncoder, OneHotEncoder
# Datos de ejemplo
df_cat = pd.DataFrame({'Ciudad': ['Pekín', Shanghái, 'Guangzhou', 'Pekín', 'Shenzhen']})
# Codificación de etiquetas
le = LabelEncoder()
df_cat['codificación_etiqueta_ciudad'] = le.fit_transform(df_cat['Ciudad'])
print("Resultado de codificación de etiquetas:")
print(df_cat)
# Codificación one-hot
# Método 1: Usar get_dummies de pandas
df_onehot_pd = pd.get_dummies(df_cat['Ciudad'], prefix='Ciudad')
print("\nCodificación one-hot con pandas:)
print(df_onehot_pd)
# Método 2: usar OneHotEncoder de sklearn (más común en pipelines)
ohe = OneHotEncoder(sparse_output=False) # sparse_output=False devuelve un array en lugar de una matriz dispersa
encoded_array = ohe.fit_transform(df_cat[['Ciudad']]) # Nota: la entrada es bidimensional
print("\nCodificación one-hot con sklearn (en forma de array):)
print(encoded_array)
print("Nombre de la nueva característica:", ohe.get_feature_names_out())
3. Selección de características
Seleccionar el subconjunto más importante de todas las características para reducir la dimensionalidad y disminuir el riesgo de sobreajuste.
| Método | Descripción |
|---|---|
| Método de filtrado | Clasificar y filtrar según la correlación estadística entre las características y la variable objetivo (como varianza, prueba de chi-cuadrado, información mutua). Independiente de cualquier modelo. |
| Método envolvente | Considera la selección de características como un problema de búsqueda, utilizando el rendimiento del modelo como criterio de evaluación (por ejemplo, eliminación recursiva de características RFE). Produce buenos resultados, pero con un alto costo computacional. |
| Método embebido | Realiza la selección de características automáticamente durante el entrenamiento del modelo (por ejemplo, regularización L1 en regresión LASSO, importancia de características en modelos de árboles). |
Ejemplo de código (selección basada en la importancia de las características):
Ejemplo
from sklearn.ensemble import RandomForestClassifier
import pandas as pd
import matplotlib.pyplot as plt
# cargar el conjunto de datos
data = load_breast_cancer()
X = pd.DataFrame(data.data, columns=data.feature_names)
y = data.target
# Entrenar un modelo de bosque aleatorio, que calculará la importancia de las características
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X, y)
# Obtener importancia de características
importances = model.feature_importances_
feature_importance_df = pd.DataFrame({
'Característica': data.feature_names,
'Importancia': importances
}).sort_values('Importancia', ascending=False)
print("Orden de importancia de características:")
print(feature_importance_df.head(10)) # Ver las 10 características más importantes
# Visualización
plt.figure(figsize=(10, 6))
plt.barh(feature_importance_df['Característica'][:10], feature_importance_df['Importancia'][:10])
plt.xlabel('Importancia de características')
plt.title('Top 10 Importancia de características')
plt.gca().invert_yaxis() # Poner las más importantes en la parte superior
plt.show()
# Supongamos que seleccionamos características con importancia mayor a 0.03
selected_features = feature_importance_df[feature_importance_df['Importancia'] > 0.03]['Característica'].tolist()
print(f"\nCaracterísticas seleccionadas: {selected_features}")
3. Práctica: Procesar manualmente un conjunto de datos simple
Tarea: Realizar una ingeniería de características básica sobre el famoso conjunto de datos de pasajeros del Titanic, para preparar la predicción de si los pasajeros sobreviven.
Sugerencias de pasos:
- Cargar los datos (puedes usar
seabornde la bibliotecaload_dataset('titanic'))。 - Observar los datos: revisar los tipos de características y la situación de los valores faltantes.
- Procesamiento de características:
- Manejar valores faltantes (por ejemplo, rellenar con la mediana
age, rellenar con la modaembarked)。 - va a
sexcaracterística (Sexo) medianteCodificación de etiquetasoCodificación one-hot。 - Sobre
age(Edad) realizarBinningy crear una nueva característica de rango de edad.
- Manejar valores faltantes (por ejemplo, rellenar con la mediana
- Construcción de características:
- Combinar
sibsp(número de hermanos/cónyuge) yparch(número de padres/hijos), para construir una nuevafamily_sizecaracterística de (tamaño familiar).
- Combinar
- Selección de características:
- Eliminar características que consideres claramente irrelevantes (por ejemplo,
passenger_id,name,ticket)。 - Intenta calcular la correlación entre las características numéricas y la variable objetivo de supervivencia, y filtra las características.
- Eliminar características que consideres claramente irrelevantes (por ejemplo,
Con este ejercicio, experimentarás de primera mano cómo los datos brutos se vuelven más "amigables" para los modelos de aprendizaje automático mediante la ingeniería de características paso a paso.
Resumen
La ingeniería de características es un oficio en el aprendizaje automático que combinaarte(conocimiento del dominio, experiencia, intuición) conciencia(métodos estadísticos, algoritmos). No tiene reglas fijas; requiere intentos e iteraciones constantes según los datos, el problema y el modelo específicos. Para principiantes, dominar los métodos básicos presentados en este artículo y practicar con frecuencia ya te permite sentar la base más sólida para construir modelos de aprendizaje automático eficaces. Recuerda,Los buenos modelos a menudo provienen de buenas características.。
Otras extensiones