Aplicaciones de aprendizaje automático
Las aplicaciones de aprendizaje automático se pueden dividir en varias áreas principales, cada una con sus propios escenarios de aplicación y desafíos:
- Visión por computadora: hacer que las máquinas "vean" el mundo
- Procesamiento de lenguaje natural: hacer que las máquinas "entiendan" el lenguaje humano
- Sistemas de recomendación: recomendar contenido personalizado
- Análisis predictivo: predecir tendencias y resultados futuros
- Detección de anomalías: descubrir patrones inusuales
¿Por qué estas aplicaciones necesitan aprendizaje automático?
Imagina si usáramos métodos de programación tradicionales para resolver estos problemas:
- Reconocimiento facial: necesitaríamos escribir innumerables reglas para describir las variaciones del rostro humano (ángulo, iluminación, expresiones, etc.)
- Traducción de idiomas: necesitaríamos escribir enormes diccionarios y reglas gramaticales para cada combinación de idiomas
- Sistemas de recomendación: necesitaríamos analizar manualmente las preferencias de cada usuario y las características de cada producto
El aprendizaje automático permite que las computadoras aprendan automáticamente estos patrones complejos a partir de grandes cantidades de datos, simplificando enormemente el proceso de resolución de problemas.
Aplicaciones de visión por computadora
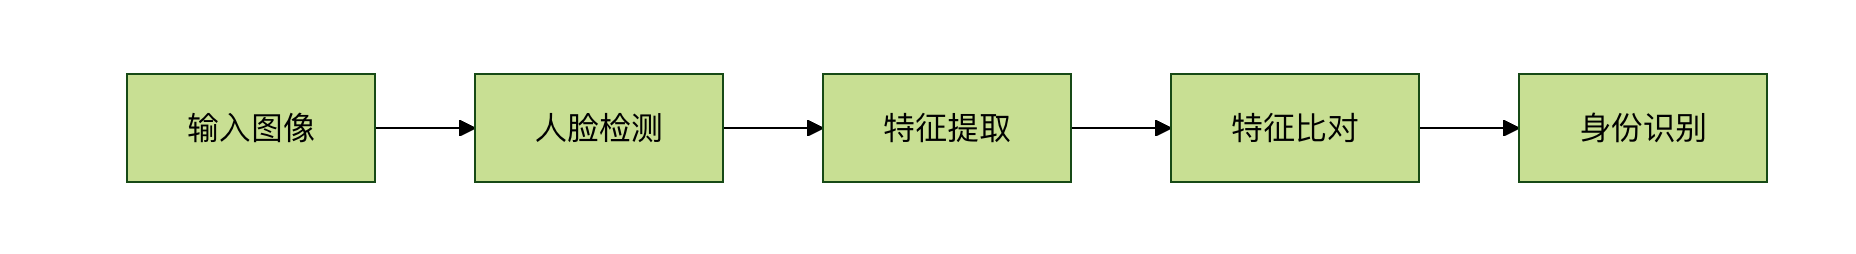
Reconocimiento facial
Escenarios de aplicación: desbloqueo de teléfonos, sistemas de control de acceso, verificación de identidad
Principio de funcionamiento:
- Detectar la posición del rostro en la imagen
- Extraer características faciales (separación de los ojos, forma de la nariz, etc.)
- Comparar con las características faciales en la base de datos
Conducción autónoma
Escenarios de aplicación: Tesla Autopilot, Baidu Apollo, Google Waymo
Tareas principales:
- Detección de objetos: identificar vehículos, peatones, señales de tráfico
- Detección de carriles: determinar los límites del carril
- Planificación de rutas: decidir la ruta de conducción
Ejemplo
import cv2
import numpy as np
def detect_objects(image):
"""
Detectar objetos en la imagen (vehículos, peatones, señales de tráfico, etc.)
"""
# 1. Preprocesar la imagen
processed_image = preprocess_image(image)
# 2. Usar un modelo de aprendizaje profundo entrenado para detectar objetos
# Aquí se usa el modelo YOLO preentrenado como ejemplo
boxes, classes, scores = yolo_model.detect(processed_image)
# 3. Filtrar los resultados de detección con baja confianza
valid_detections = filter_detections(boxes, classes, scores)
# 4. Dibujar los resultados de detección en la imagen
result_image = draw_detections(image, valid_detections)
return result_image, valid_detections
# En la práctica, esto es solo un componente de todo el sistema de conducción autónoma
# También es necesario combinar múltiples módulos como fusión de sensores, planificación de rutas, etc.
Diagnóstico por imágenes médicas
Escenarios de aplicación: análisis de radiografías, tomografías computarizadas, análisis de muestras patológicas
Ventajas:
- Menos fatiga que los médicos humanos
- Puede detectar cambios sutiles difíciles de percibir para el ojo humano
- Puede procesar rápidamente grandes volúmenes de imágenes
Aplicaciones de procesamiento de lenguaje natural
Asistentes inteligentes
Escenarios de aplicación: Siri, Xiao Ai, Tmall Genie
Funciones principales:
- Reconocimiento de voz: convertir voz en texto
- Comprensión de intenciones: entender qué quiere el usuario
- Gestión de diálogo: mantener una conversación coherente
Ejemplo
import speech_recognition as sr
from textblob import TextBlob
class SmartAssistant:
def __init__(self):
self.recognizer = sr.Recognizer()
def listen_and_respond(self):
"""Escuchar la voz del usuario y responder"""
with sr.Microphone() as source:
print("Escuchando...")
audio = self.recognizer.listen(source)
try:
# 1. Reconocimiento de voz
text = self.recognizer.recognize_google(audio, language='zh-CN')
print(f"El usuario dice: {text}")
# 2. Comprensión de intenciones
intent = self.understand_intent(text)
# 3. Generar respuesta
response = self.generate_response(intent, text)
print(f"El asistente responde: {response}")
return response
except sr.UnknownValueError:
return "Lo siento, no te escuché bien, por favor repite"
def understand_intent(self, text):
"""Entender la intención del usuario"""
# Reconocimiento de intención simplificado
if "clima" in text:
return "weather"
elif "hora" in text:
return "time"
elif "chiste" in text:
return "joke"
else:
return "unknown"
def generate_response(self, intent, text):
"""Generar respuesta según la intención"""
if intent == "weather":
return "Hoy está soleado, temperatura 25 grados"
elif intent == "time":
from datetime import datetime
return f"La hora actual es {datetime.now().strftime('%H:%M')}"
elif intent == "joke":
return "¿Por qué a los programadores les gusta la noche? ¡Porque no hay bugs!"
else:
return "Lo siento, todavía estoy aprendiendo, no puedo entender esta pregunta"
# Ejemplo de uso
assistant = SmartAssistant()
# assistant.listen_and_respond() # Descomentar al ejecutar realmente
Traducción automática
Escenarios de aplicación: Google Translate, Baidu Translate, Youdao Translate
Principio de funcionamiento:
- Codificar el texto en el idioma de origen en una representación numérica
- Aprender la relación de mapeo entre idiomas mediante redes neuronales
- Decodificar al texto del idioma de destino
Análisis de sentimientos
Escenarios de aplicación: análisis de reseñas de productos, monitoreo de redes sociales, procesamiento de comentarios de clientes
Ejemplo
from textblob import TextBlob
import jieba
def analyze_sentiment_chinese(text):
"""
Ejemplo de análisis de sentimientos en chino
"""
# Usar jieba para la segmentación de palabras
words = jieba.cut(text)
word_list = " ".join(words)
# Aquí se simplifica; en aplicaciones reales se necesita un modelo específico de análisis de sentimientos para chino
# Se pueden usar librerías como SnowNLP, BERT-Chinese, etc.
# Simular los resultados del análisis de sentimientos
positive_words = ["bueno", "excelente", "me gusta", "satisfecho", "recomendar"]
negative_words = ["malo", "mal", "odiar", "decepcionado", "no recomendar"]
pos_count = sum(1 for word in positive_words if word in text)
neg_count = sum(1 for word in negative_words if word in text)
if pos_count > neg_count:
return "sentimiento positivo"
elif neg_count > pos_count:
return "sentimiento negativo"
else:
return "sentimiento neutral"
# Ejemplo de prueba
reviews = [
"¡Este producto es realmente excelente, me gusta mucho!",
"La calidad es muy mala, realmente no vale la pena comprarlo.",
"Está bien, nada especial."
]
for review in reviews:
sentiment = analyze_sentiment_chinese(review)
print(f"Comentario: {review}")
print(f"Sentimiento: {sentiment}")
print("---")
Aplicaciones de sistemas de recomendación
Recomendación en comercio electrónico
Escenarios de aplicación: recomendación de productos en Taobao, recomendación de Amazon
Estrategias de recomendación:
- Filtrado colaborativo: recomendación basada en la similitud de comportamiento de los usuarios
- Recomendación por contenido: recomendación basada en la similitud de características de los productos
- Recomendación híbrida: combinar múltiples estrategias
Ejemplo
import numpy as np
# Matriz de calificaciones usuario-producto (filas son usuarios, columnas son productos)
ratings = np.array([
[5, 3, 0, 1], # Calificaciones del usuario 1 para los productos 1, 2, 4
[4, 0, 0, 1], # Calificaciones del usuario 2 para los productos 1, 4
[1, 1, 0, 5], # Calificaciones del usuario 3 para los productos 1, 2, 4
[1, 0, 0, 4], # Calificaciones del usuario 4 para los productos 1, 4
[0, 1, 5, 4], # Calificaciones del usuario 5 para los productos 2, 3, 4
])
def user_similarity(user1, user2):
"""Calcular la similitud entre dos usuarios (similitud coseno)"""
# Encontrar los productos que ambos usuarios han calificado
common_items = np.where((user1 > 0) & (user2 > 0))[0]
if len(common_items) == 0:
return 0
# Calcular la similitud coseno
user1_ratings = user1[common_items]
user2_ratings = user2[common_items]
dot_product = np.dot(user1_ratings, user2_ratings)
norm1 = np.linalg.norm(user1_ratings)
norm2 = np.linalg.norm(user2_ratings)
if norm1 == 0 or norm2 == 0:
return 0
return dot_product / (norm1 * norm2)
def recommend_items(user_id, ratings_matrix, k=2):
"""Recomendar productos para un usuario específico"""
user_ratings = ratings_matrix[user_id]
# Calcular la similitud entre este usuario y los demás
similarities = []
for i, other_user in enumerate(ratings_matrix):
if i != user_id:
sim = user_similarity(user_ratings, other_user)
similarities.append((i, sim))
# Ordenar por similitud
similarities.sort(key=lambda x: x[1], reverse=True)
# Encontrar productos que el usuario no ha calificado
unrated_items = np.where(user_ratings == 0)[0]
# Predecir la calificación del usuario para productos no calificados
predictions = []
for item_id in unrated_items:
weighted_sum = 0
similarity_sum = 0
for similar_user_id, similarity in similarities[:k]:
if similarity > 0 and ratings_matrix[similar_user_id][item_id] > 0:
weighted_sum += similarity * ratings_matrix[similar_user_id][item_id]
similarity_sum += similarity
if similarity_sum > 0:
predicted_rating = weighted_sum / similarity_sum
predictions.append((item_id, predicted_rating))
# Ordenar por calificación predicha
predictions.sort(key=lambda x: x[1], reverse=True)
return predictions[:3] # Devolver las 3 primeras recomendaciones
# Recomendar productos para el usuario 0
user_id = 0
recommendations = recommend_items(user_id, ratings)
print(f"Productos recomendados para el usuario {user_id}:")
for item_id, predicted_rating in recommendations:
print(f"Producto {item_id + 1}, calificación predicha: {predicted_rating:.2f}")
Recomendación de videos
Escenarios de aplicación: Douyin, YouTube, Netflix
Características:
- Recomendación en tiempo real (ajustada según el comportamiento actual del usuario)
- Datos multimodales (contenido de video, comportamiento del usuario, tiempo, etc.)
- Manejo del problema de arranque en frío
Aplicaciones de análisis predictivo
Control de riesgo financiero
Escenarios de aplicación: Detección de fraude con tarjetas de crédito, aprobación de préstamos
Ejemplo
import numpy as np
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
# Simular datos de transacciones
# Características: monto de la transacción, hora de la transacción, tipo de comerciante, ubicación, etc.
# Etiqueta: 0 = normal, 1 = fraude
np.random.seed(42)
# Generar datos simulados
n_samples = 1000
n_features = 4
# Transacciones normales
normal_transactions = np.random.normal(loc=[100, 14, 2, 3], scale=[50, 4, 1, 1],
size=(int(n_samples * 0.95), n_features))
# Transacciones fraudulentas (generalmente montos anormales, horarios anormales, etc.)
fraud_transactions = np.random.normal(loc=[500, 3, 4, 1], scale=[200, 2, 1, 0.5],
size=(int(n_samples * 0.05), n_features))
# Combinar datos y agregar etiquetas
X = np.vstack([normal_transactions, fraud_transactions])
y = np.hstack([np.zeros(len(normal_transactions)), np.ones(len(fraud_transactions))])
# Dividir el conjunto de entrenamiento y el conjunto de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Entrenar el modelo de bosque aleatorio
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X_train, y_train)
# Evaluar el modelo
accuracy = model.score(X_test, y_test)
print(f"Precisión del modelo: {accuracy:.2f}")
# Predecir nuevas transacciones
new_transaction = np.array([[450, 2, 4, 1]]) # Transacción anómala
fraud_probability = model.predict_proba(new_transaction)[0][1]
print(f"Probabilidad de que la nueva transacción sea fraude: {fraud_probability:.2f}")
if fraud_probability > 0.5:
print("Advertencia: ¡Se ha detectado una transacción sospechosa!")
else:
print("Transacción normal.")
Predicción de precios de acciones
Escenarios de aplicación: Comercio cuantitativo, decisiones de inversión
Desafíos:
- Alto ruido del mercado
- Series temporales no estacionarias
- Afectado por múltiples factores
Aplicaciones de detección de anomalías
Ciberseguridad
Escenarios de aplicación: Detección de intrusiones, identificación de malware
Principio de funcionamiento:
- Aprender patrones de tráfico de red normal
- Detectar comportamientos que se desvían de los patrones normales
- Activar alertas o bloquear
Inspección de calidad industrial
Escenarios de aplicación: Detección de defectos en productos, predicción de fallas de equipos
Ejemplo
import numpy as np
from sklearn.ensemble import IsolationForest
import matplotlib.pyplot as plt
# Simular datos de sensores (datos normales + algunas anomalías)
np.random.seed(42)
# Datos normales: lecturas de sensores cuando el equipo funciona correctamente
normal_data = np.random.normal(loc=10, scale=1, size=(200, 2))
# Datos anómalos: lecturas de sensores cuando el equipo falla
anomaly_data = np.random.normal(loc=[15, 5], scale=[1, 1], size=(10, 2))
# Combinar datos
all_data = np.vstack([normal_data, anomaly_data])
# Usar bosque de aislamiento para detección de anomalías
model = IsolationForest(contamination=0.05, random_state=42)
predictions = model.fit_predict(all_data)
# Visualizar resultados
plt.figure(figsize=(10, 6))
normal_points = all_data[predictions == 1]
anomaly_points = all_data[predictions == -1]
plt.scatter(normal_points[:, 0], normal_points[:, 1],
c='blue', label='Datos normales')
plt.scatter(anomaly_points[:, 0], anomaly_points[:, 1],
c='red', label='Datos anómalos')
plt.xlabel('Lectura del sensor 1')
plt.ylabel('Lectura del sensor 2')
plt.title('Detección de estado anormal de funcionamiento del equipo')
plt.legend()
plt.grid(True)
plt.show()
print(f"Se detectaron {len(anomaly_points)} puntos anómalos")