Концепции MLOps
Представьте, что вы — специалист по данным. После недель упорной работы вы наконец обучили модель машинного обучения, которая отлично показывает себя на тестовом наборе. С радостью вы передаёте этотmodel.pklфайл вашему коллеге-инженеру-программисту. Однако проблемы следуют одна за другой: как эта модель может стабильно работать на серверах, обрабатывающих миллионы запросов в день? Как отслеживать, не снижается ли её производительность на реальных данных? Когда поступают новые данные, как автоматически переобучить и обновить модель?
Этот сценарий раскрывает ключевую проблему проектов машинного обучения:как превратить экспериментальный код модели в надёжную производственную систему, которая непрерывно создаёт ценность для бизнеса.MLOps — это именно набор философий и практик, созданных, чтобы устранить этот разрыв.
Проще говоря, MLOps — этоMachine LearningиDevOpsв сочетании. Он заимствует идеи автоматизации, сотрудничества и мониторинга из DevOps в разработке программного обеспечения и применяет их к управлению жизненным циклом систем машинного обучения, стремясь достичьэффективной разработки, надёжного развёртывания и непрерывной работы ML-моделей.。
Что такое MLOps?
Основное определение
MLOps — это набор инженерных практик, используемых длястандартизации и автоматизацииразличных этапов жизненного цикла систем машинного обучения, включая:
- Разработка моделей и экспериментирование
- Непрерывное обучение и оценка моделей
- Развёртывание и обслуживание моделей
- Мониторинг, сопровождение и итерации в производственных средах
Его конечная цель —создавать воспроизводимые, масштабируемые, проверяемые и совместные рабочие процессы машинного обучения, чтобы модели могли быстро и безопасно переходить из лаборатории в производство и непрерывно поддерживать свою ценность.
Простая аналогия: сравнение с DevOps
Для лучшего понимания мы можем сравнить MLOps с более знакомым DevOps:
| Аспект | DevOps (традиционная разработка программного обеспечения) | MLOps (разработка систем машинного обучения) |
|---|---|---|
| Основной результат | Приложение/Сервис | Модель машинного обучения + её среда выполнения |
| Объект итерации | Code | Код + Данные + Модель |
| Фокус тестирования | Функциональное тестирование, интеграционное тестирование | Тестирование качества работы модели, валидация данных, обнаружение дрейфа концепции |
| Единица развёртывания | Исполняемый файл/образ контейнера | Файл модели + код инференса + специфическое окружение зависимостей |
| Метрики мониторинга | Использование CPU/памяти, задержка запросов, частота ошибок | Качество предсказаний модели (например, accuracy), распределение входных данных, бизнес-метрики |
Это сравнение раскрывает уникальную сложность MLOps: MLOps управляет не только кодом, но иданными, имоделямиЭти два динамически изменяющихся элемента.
Почему MLOps?
Проекты машинного обучения без MLOps часто попадают в "чистилище прототипов" — модели навсегда застревают на экспериментальной стадии и не могут оказать реального влияния. MLOps разрушает этот тупик, решая следующие ключевые проблемы:
1. Проблемы совместной работы и воспроизводимости
- Проблема: Дата-сайентисты экспериментируют в Jupyter Notebooks, зависимости окружения запутаны, а шаги экспериментов невозможно воспроизвести.
- Решение MLOps: Используйте контроль версий (например, Git) для управления кодом, версиями данных (например, DVC) и версиями моделей; используйте контейнеризацию (например, Docker) для фиксации окружений, гарантируя, что любой эксперимент можно точно воспроизвести.
2. Сложность развёртывания и эксплуатации
- Проблема: Ручное развёртывание моделей утомительно и подвержено ошибкам; обслуживание моделей трудно масштабировать, а мониторинг отсутствует.
- Решение MLOps: Автоматизируйте конвейеры CI/CD для развёртывания моделей как API-сервисов в один клик; используйте облачные технологии для эластичного масштабирования; создайте комплексные панели мониторинга.
3. Деградация производительности модели
- Проблема: Распределение данных в продакшене со временем меняется (концептуальный дрейф), из-за чего производительность модели незаметно ухудшается, и никто этого не замечает.
- Решение MLOps: Непрерывно отслеживайте производительность прогнозов и распределение входных данных, настройте автоматические оповещения и запускайте рабочие процессы переобучения моделей.
4. Требования к управлению и комплаенсу
- Проблема: Невозможно отследить, какая версия модели и какие данные создали данный прогноз, что затрудняет выполнение требований аудита и регулирования.
- Решение MLOps: Сквозное отслеживание версий, журналирование экспериментов и прослеживаемость результатов прогнозирования.
Основные компоненты и рабочий процесс MLOps
Типичная система MLOps содержит несколько взаимодействующих компонентов, а её рабочий процесс можно визуализировать в виде цикла:
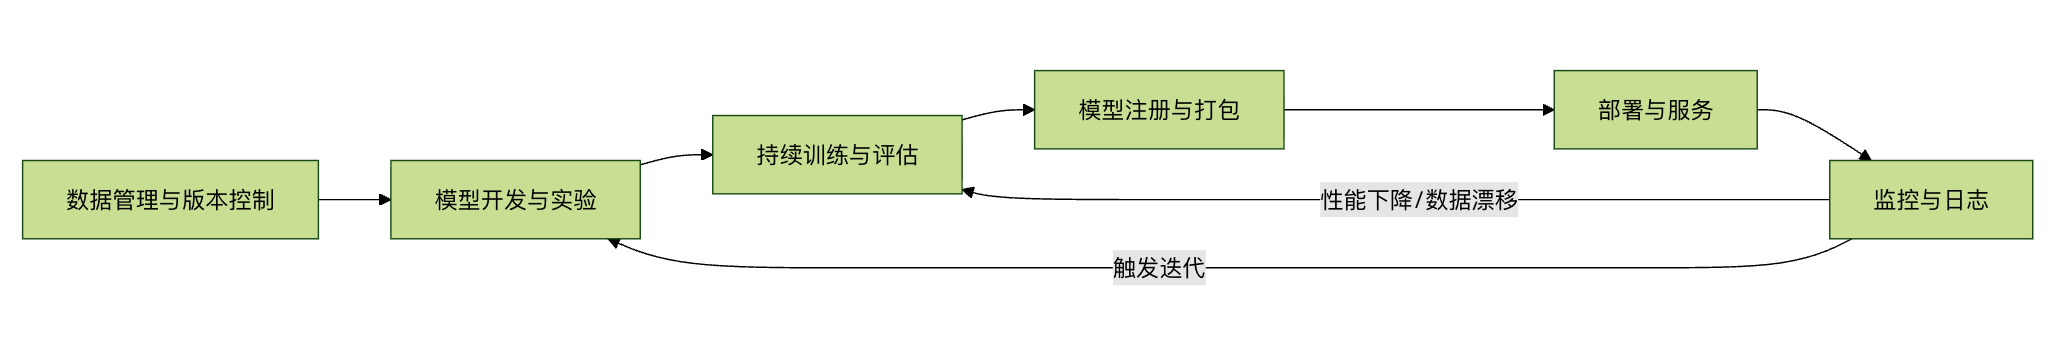
Давайте разберём каждый ключевой шаг на диаграмме ниже:
1. Управление данными и контроль версий
Это краеугольный камень MLOps. В отличие от кода, файлы данных часто большие и постоянно меняются.
- Практика: используйте такие инструменты, какDVC (Data Version Control)илиLakeFS, чтобы управлять файлами данных и моделей так же, как Git управляет кодом. Они хранят метаданные версий данных, а сами файлы можно размещать в облачном хранилище.
- Пример: каждый эксперимент можно связать с определённым снимком данных, что обеспечивает воспроизводимые результаты.
2. Разработка моделей и экспериментирование
Это главное поле битвы для дата-сайентистов, но оно требует инженерной дисциплины.
- Практика: рефакторите экспериментальный код из ноутбуков в модульные Python-скрипты; используйтеMLflow TrackingилиWeights & Biases, чтобы записывать гиперпараметры, метрики и выходные модели для каждого эксперимента для удобного сравнения.
3. Непрерывное обучение и оценка
Когда поступают новые данные или обнаруживается снижение производительности, система должна иметь возможность переобучать модель автоматически или полуавтоматически.
- Практика: создавайте автоматизированные конвейеры обучения (например, с помощьюKubeflow PipelinesилиApache Airflow). Конвейер включает валидацию данных, проектирование признаков, обучение модели и оценку (нанабор для валидации, отличный от обучающего набора) и другие этапы. Только модели, прошедшие оценку, могут перейти на следующий этап.
4. Регистрация и упаковка моделей
Обученными моделями нужно правильно управлять и готовить их к развертыванию.
- Практика: Используйтереестр моделей(например, MLflow Model Registry). Он хранит, аннотирует и управляет моделями как версионируемыми активами. Модели обычно упаковываются вместе с кодом инференса вобразы Docker-контейнеровчтобы обеспечить согласованность с производственной средой.
5. Развертывание и обслуживание
Предоставьте модель пользователям или другим системам.
- Режимы:
- Пакетное предсказание: Периодически выполнять предсказания на больших объемах данных и генерировать отчеты.
- Обслуживание API в реальном времени: Модель выступает в роли REST API или сервиса gRPC, отвечая на запросы в реальном времени. Распространенные инструменты включаютFastAPI,, TensorFlow Serving,, TorchServe,или управляемые сервисы от облачных провайдеров.
- Стратегии: Вы можете применятьсине-зеленое развертываниеилиили канареечные релизычтобы постепенно переводить трафик на новую модель и снижать риск.
6. Мониторинг и логирование
Это "глаза", которые обеспечивают здоровую работу продакшен-модели.
- Содержание мониторинга:
- Системные метрики: задержка API, пропускная способность, частота ошибок, использование ресурсов.
- Метрики модели: распределение результатов предсказаний, изменения важных признаков (обнаружение дрейфа данных).
- Бизнес-метрики: конечное влияние решений модели на бизнес (например, кликабельность, коэффициент конверсии).
- Практика: интегрируйте инструменты мониторинга (например,Prometheus, Grafana) и системы логирования (например,ELK Stack), и настройте правила оповещений для ключевых метрик.
Упрощённый пример практики MLOps
Давайте рассмотрим концептуальный поток кода, чтобы увидеть, как реализовать отслеживание экспериментов, регистрацию моделей и упаковку с помощью MLflow — популярного инструмента.
Пример
import mlflow
import mlflow.sklearn
from sklearn.datasets import load_iris
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# 2. Настройка сервера отслеживания MLflow (при условии, что он уже запущен локально)
mlflow.set_tracking_uri("http://127.0.0.1:5000")
mlflow.set_experiment("Iris_Classification")
# 3. Начать запуск эксперимента
with mlflow.start_run():
# Загрузить данные и разделить их
data = load_iris()
X_train, X_test, y_train, y_test = train_test_split(data.data, data.target, test_size=0.2)
# Определить и обучить модель
n_estimators = 100
model = RandomForestClassifier(n_estimators=n_estimators, random_state=42)
model.fit(X_train, y_train)
# Прогнозирование и оценка
y_pred = model.predict(X_test)
acc = accuracy_score(y_test, y_pred)
# 4. Логировать информацию об эксперименте на сервер отслеживания MLflow
mlflow.log_param("n_estimators", n_estimators) # Логировать гиперпараметры
mlflow.log_metric("accuracy", acc) # Логировать метрики оценки
# 5. Логирование самой модели (включая её окружение зависимостей)
# mlflow.sklearn.log_model логирует модель и создаёт файл окружения conda.yaml
mlflow.sklearn.log_model(model, "random_forest_model")
print(f"Обучение модели завершено, точность: {acc:.4f}")
print(f"Эксперимент залогирован. Вы можете просмотреть его в MLflow UI (http://127.0.0.1:5000).")
# 6. (Следующий шаг) В MLflow UI вы можете "зарегистрировать" эту залогированную модель в Model Registry.
# 7. Затем вы можете извлечь модель из Model Registry и упаковать её в Docker-образ с помощью команды `mlflow models build-docker`.
# 8. Наконец, разверните этот образ в Kubernetes или на облачном сервере, чтобы обслуживать модель.
Пояснение кода:
- Этот пример демонстрирует ключевые аспекты MLOps:Отслеживание экспериментовиЛогирование моделейОни необходимы.
mlflow.log_paramиmlflow.log_metricЭто обеспечивает прослеживаемость экспериментов.mlflow.sklearn.log_modelЭто не только сохраняет файл модели, но и автоматически записывает версии библиотек Python (окружение), использованных для создания модели, что является ключевым шагом к воспроизводимости.- Последующие шаги регистрации, упаковки и развертывания обычно выполняются в UI или через CI/CD-конвейеры.
Уровни зрелости MLOps
Внедрение MLOps — это не разовое усилие; обычно считается, что существует три эволюционных этапа:
- Базовый MLOps (ручной процесс): Процессы развертывания и обучения запускаются вручную, с ограниченным мониторингом. Это отправная точка для многих команд.
- Промежуточный MLOps (автоматизированные конвейеры): Реализует непрерывную интеграцию (CI)Непрерывная интеграция (CI)иНепрерывная доставка (CD)для обучения и развертывания моделей с высокой степенью автоматизации.
- Продвинутый MLOps (непрерывное обучение, CT): Система имеет полные автоматизированные циклы мониторинга и обратной связи, способна автоматически запускать сбор данных, переобучение, оценку и развертывание, достигая истинногонепрерывного обучения。
Итоги и перспективы
MLOps — это не конкретный инструмент, акомплексная структура, охватывающая культуру, процессы и технологии. Она требует тесного сотрудничества между специалистами по данным, инженерами по машинному обучению и инженерами по эксплуатации.
Для начинающих понимание концепций MLOps — это первый шаг к построению надежных систем машинного обучения. Вы можете начать со следующих практик:
- Используйте Git для строгого контроля версий кода。
- Попробуйте MLflow для управления вашими экспериментами и моделями。
- Запустите вашу моделькак сервис, например, напишите простой API для предсказаний с помощью FastAPI.
- Подумайте о том, как отслеживать результаты предсказаний вашей модели。
Поскольку машинное обучение все чаще применяется в промышленности, MLOps стала ключевой инженерной компетенцией для обеспечения успеха, управляемости и масштабируемости ML-проектов. Освоение мышления MLOps может помочь вам превратить модели в ваших руках из блистательных кристаллов в лаборатории в стабильный двигатель, движущий рост бизнеса.
Другие расширения