Bosque aleatorio
Imagina que estás participando en una importante competición de conocimientos. Ante una pregunta difícil, ¿confiarías más en el juicio de un experto de primer nivel o en el resultado de una votación de 100 concursantes de buen nivel? En la mayoría de los casos, la inteligencia colectiva suele compensar los prejuicios y las limitaciones individuales, tomando así decisiones más estables y precisas.
En el mundo del aprendizaje automático,el bosque aleatorio (Random Forest)es precisamente el destacado representante de estaidea de inteligencia colectiva.Al construir una gran cantidad de árboles de decisión y hacer que voten juntos para realizar predicciones, se convierte en uno de los algoritmos de aprendizaje automático más potentes y populares.
¿Qué es un bosque aleatorio?
El bosque aleatorioes un algoritmo de aprendizaje automático basado en el aprendizaje por conjuntos (Ensemble Learning). Su idea central es muy simple:La unión hace la fuerza.。
- Bosque:se refiere a un conjunto formado por múltiplesárboles de decisión (Decision Tree).
- Aleatoriedad: se refiere a que, al construir cada árbol de decisión, el algoritmo introduce dos tipos de aleatoriedad para garantizar que cada árbol sea único.
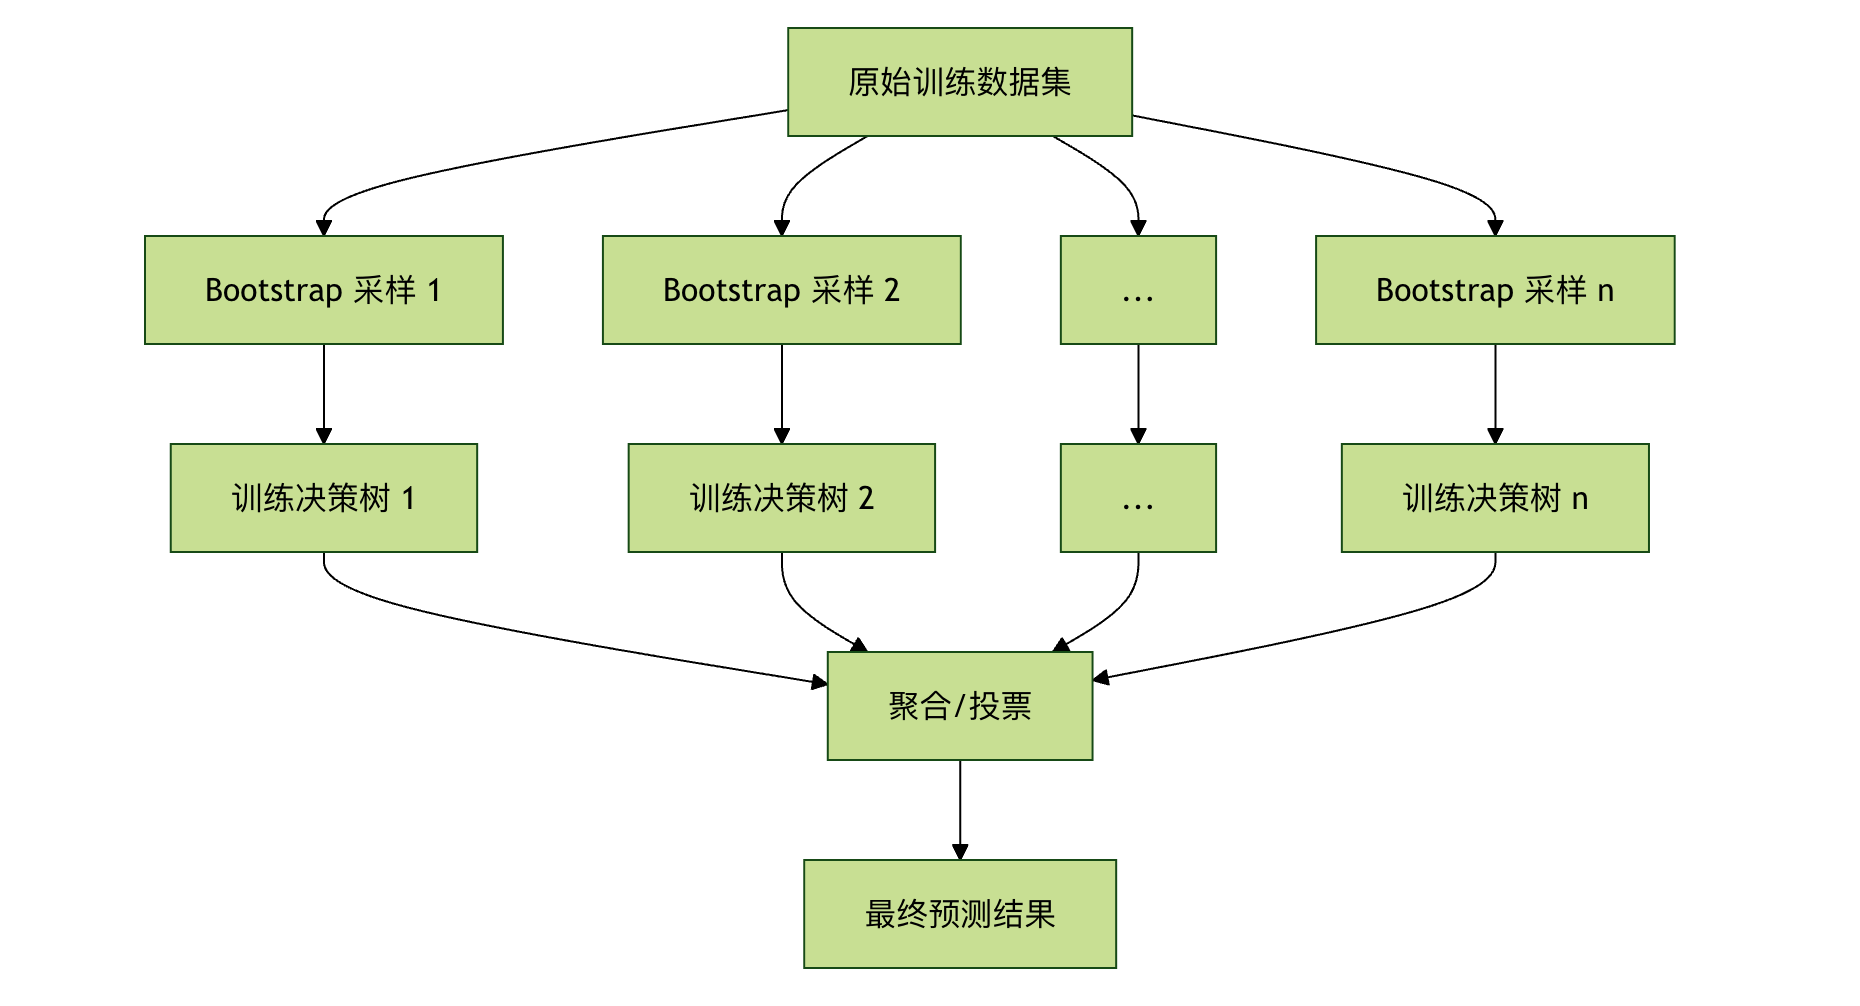
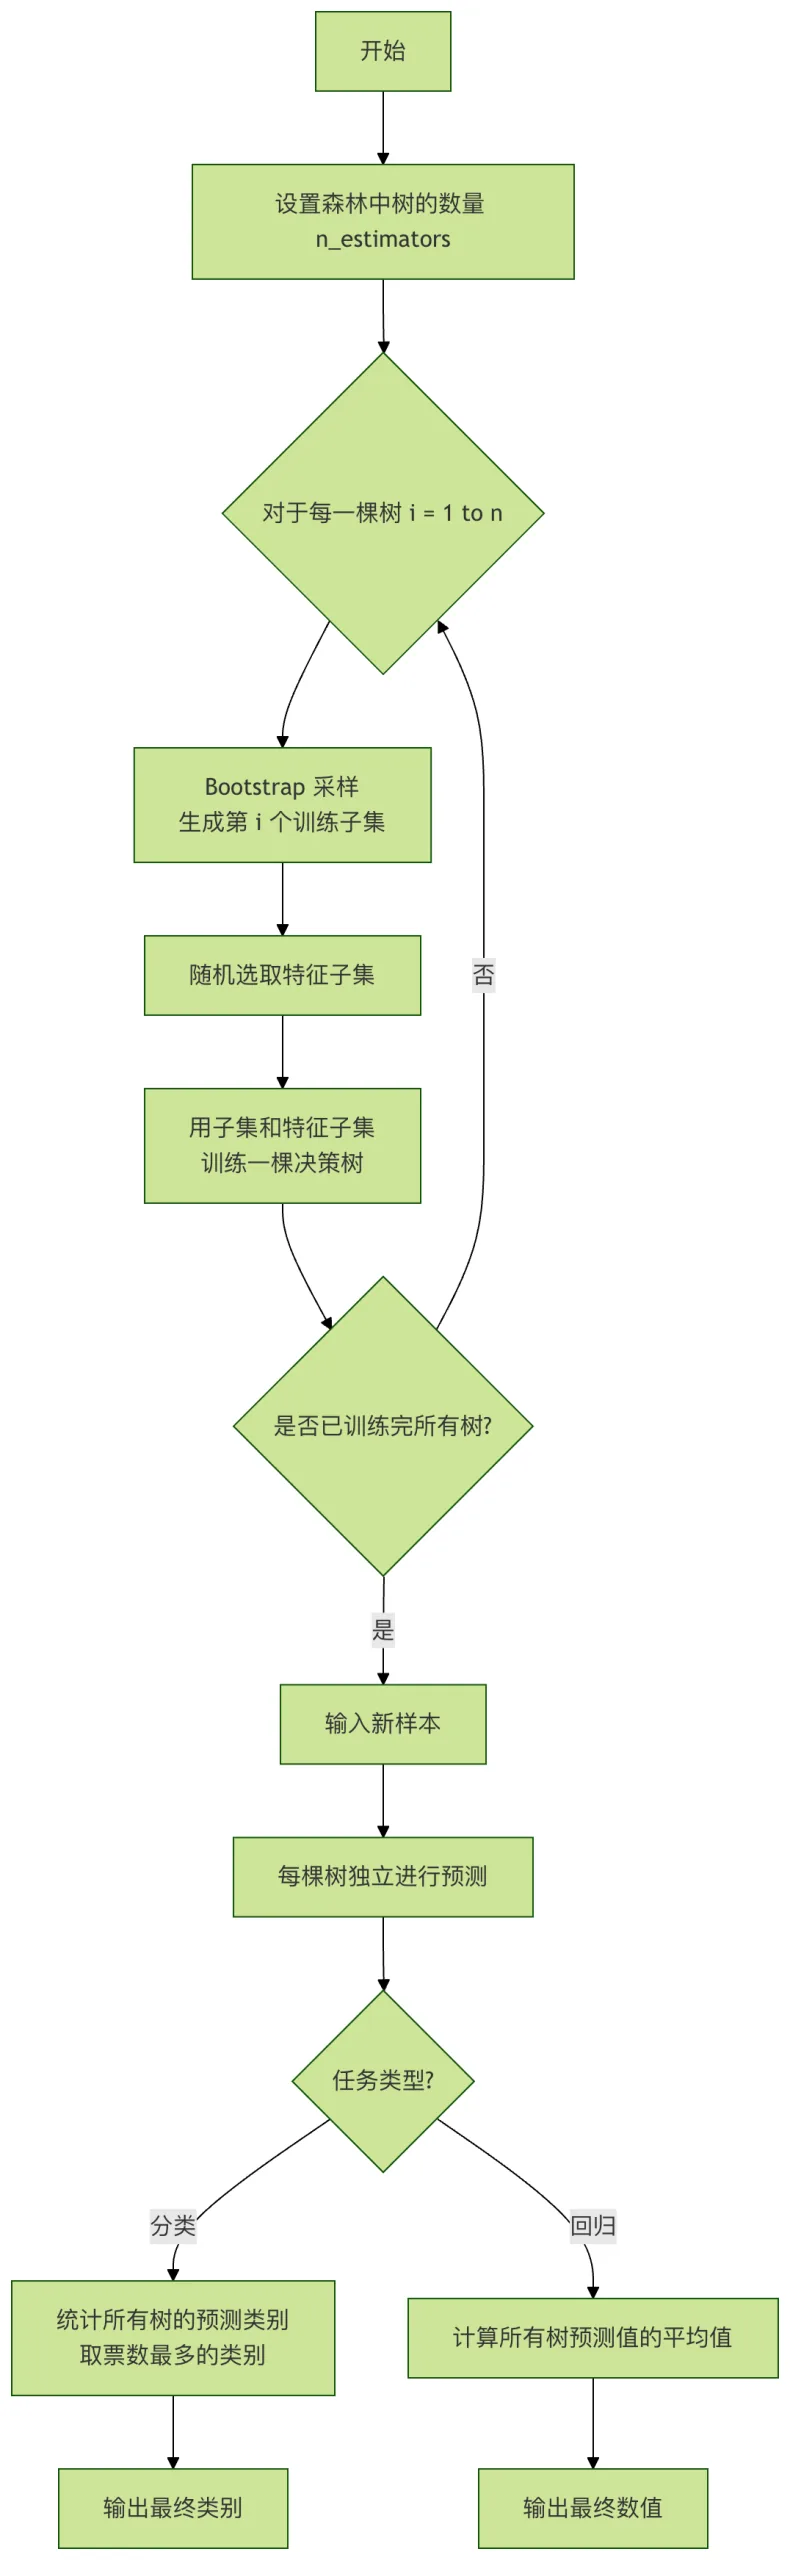
Finalmente, para las tareas de clasificación, el bosque mediantevotación (decisión por mayoría)da el resultado; para las tareas de regresión, medianteel promedioda el resultado.
Idea clave: Bagging y aleatoriedad
El éxito del bosque aleatorio se basa en dos pilares fundamentales:
Bagging(Bootstrap Aggregating):
- Bootstrap (muestreo con reemplazo): del conjunto de datos de entrenamiento original,con reemplazo,se extraen muestras aleatoriamente para generar múltiples subconjuntos de entrenamiento diferentes. Esto significa que una misma muestra puede aparecer varias veces en un subconjunto, mientras que otra puede no aparecer ninguna vez.
- Aggregating (agregación): se entrena de forma independiente un árbol de decisión con cada subconjunto de entrenamiento y, finalmente, se agregan los resultados de todos los árboles (votación o promedio).
Aleatoriedad de características:
- Al dividir cada nodo de cada árbol, el algoritmo no considera todas las características, sino queselecciona aleatoriamente un subconjunto de todas las características, y luego elige la mejor característica de división de este subconjunto.
- Esto aumenta aún más la diferencia entre los árboles, permitiendo que el bosque observe diferentes aspectos del problema.
En resumen, el bosque aleatorio, al entrenar cada árbol con datos y perspectivas de características ligeramente diferentes, crea uncomité de expertos diversificado.。Incluso si algunos árboles cometen errores, los otros árboles correctos pueden corregirlos mediante la votación, obteniendo así un rendimiento más estable y potente que el de un solo árbol de decisión.
Flujo del algoritmo y parámetros clave
Pasos de funcionamiento del bosque aleatorio
Veamos claramente su proceso de trabajo a través de un diagrama de flujo:
Explicación detallada de los hiperparámetros clave
Al utilizarscikit-learnla biblioteca, es fundamental comprender los siguientes parámetros clave:
| Nombre del parámetro | Significado | Valor típico / efecto | Explicación sencilla |
|---|---|---|---|
n_estimators |
Número de árboles de decisión en el bosque. | Predeterminado: 100. Cuanto mayor sea el valor, normalmente más estable y de mejor rendimiento será el modelo, pero también mayor será el costo computacional. | "El número de personas del comité". Cuantas más personas, normalmente más fiable es la decisión, pero la reunión también dura más. |
max_depth |
Profundidad máxima de un solo árbol de decisión. | Predeterminado:NoneNone (sin límite). Limitar la profundidad puede evitar el sobreajuste y hacer que el modelo sea más simple. |
"Limitar el tiempo de intervención de cada persona". Evita que un experto (árbol) se obsesione y preste demasiada atención a los detalles de los datos de entrenamiento. |
max_features |
Número de características consideradas al buscar la mejor división. | Puede ser un número entero, un número flotante o'auto'/'sqrt'None. Este es el parámetro clave para introducir la «aleatoriedad de características». |
"En cada discusión solo se observan aleatoriamente algunos aspectos". Garantiza que cada árbol analice el problema desde diferentes ángulos, aumentando la diversidad. |
min_samples_split |
Número mínimo de muestras requerido para dividir un nodo. | Predeterminado: 2. Cuanto mayor sea el valor, más conservador será el crecimiento del árbol y menos propenso al sobreajuste. | "Un grupo necesita al menos un número mínimo de personas para continuar la discusión en subgrupos". Evita crear una nueva regla debido a una o dos muestras. |
min_samples_leaf |
Número mínimo de muestras requerido en un nodo hoja. | Predeterminado: 1. Cuanto mayor sea el valor, más suave será el modelo. | "La conclusión final debe basarse al menos en varios casos". Garantiza que cada conclusión tenga cierto respaldo de datos. |
bootstrap |
Si se utiliza el muestreo Bootstrap. | Predeterminado:TrueTrue. Si se establece enFalseFalse, se usará el conjunto de datos completo para entrenar cada árbol, pero se perderá parte de la aleatoriedad. |
"Si se permite que una persona hable repetidamente". Activarlo es la esencia del Bagging. |
Práctica dirigida - Ejemplos de código
Vamos a practicar con el clásico conjunto de datos de clasificación Iris.
Ejemplo 1: Tarea básica de clasificación
Ejemplo
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report
# 1. Cargar los datos
iris = load_iris()
X = iris.data # Características: largo del sépalo, ancho del sépalo, largo del pétalo, ancho del pétalo
y = iris.target # Etiquetas: tres especies de Iris
# 2. Dividir el conjunto de entrenamiento y el de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. Crear el clasificador de bosque aleatorio
# Aquí configuramos 100 árboles y limitamos la profundidad máxima a 5
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# 4. Entrenar el modelo
rf_clf.fit(X_train, y_train)
# 5. Realizar predicciones en el conjunto de prueba
y_pred = rf_clf.predict(X_test)
# 6. Evaluar el rendimiento del modelo
print("Precisión en el conjunto de prueba:", accuracy_score(y_test, y_pred))
print("\n"Informe de clasificación:")
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Análisis del código:
- Importar bibliotecas:
RandomForestClassifieres el clasificador de bosque aleatorio. - Cargar los datos: el conjunto de datos Iris tiene 150 muestras, 4 características y 3 clases.
- División de datos: se usa el 70% de los datos para entrenar y el 30% para probar, verificando la capacidad de generalización del modelo ante nuevos datos.
- Instanciar el modelo:
random_state=42asegura que los resultados sean reproducibles en cada ejecución. - Entrenar el modelo:
fitEl método construirá 100 árboles de decisión. - Predicción y evaluación: se utiliza el bosque entrenado para predecir sobre el conjunto de prueba y se calculan métricas como la precisión.
Salida:
      setosa       1.00      1.00      1.00        19
  versicolor       1.00      1.00      1.00        13
   virginica       1.00      1.00      1.00        13

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45
Ejemplo 2: Ver la importancia de las características
El bosque aleatorio también tiene una función potente: evaluar el grado de contribución de cada característica a la predicción.
Ejemplo
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report
import pandas as pd
import matplotlib.pyplot as plt
# -------------------------- Configurar la fuente china start --------------------------
plt.rcParams['font.sans-serif'] = [
# Prioridad para Windows
'SimHei', 'Microsoft YaHei',
# Prioridad para macOS
'PingFang SC', 'Heiti TC',
# Prioridad para Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que el signo negativo se muestre como un cuadrado
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Configurar la fuente china end --------------------------
# 1. Cargar los datos
iris = load_iris()
X = iris.data # Características: largo del sépalo, ancho del sépalo, largo del pétalo, ancho del pétalo
y = iris.target # Etiquetas: tres especies de Iris
# 2. Dividir el conjunto de entrenamiento y el de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. Crear el clasificador de bosque aleatorio
# Aquí configuramos 100 árboles y limitamos la profundidad máxima a 5
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# 4. Entrenar el modelo
rf_clf.fit(X_train, y_train)
# 5. Realizar predicciones en el conjunto de prueba
y_pred = rf_clf.predict(X_test)
# 6. Evaluar el rendimiento del modelo
print("Precisión en el conjunto de prueba:", accuracy_score(y_test, y_pred))
print("\n"Informe de clasificación:")
# Obtener la importancia de las características
feature_importances = rf_clf.feature_importances_
features = iris.feature_names
# Crear un DataFrame para una visualización más fácil
importance_df = pd.DataFrame({
'Característica': features,
'Importancia': feature_importances
}).sort_values('Importancia', ascending=False)
print("Ordenación de la importancia de las características:")
print(importance_df)
# Visualización
plt.figure(figsize=(8, 5))
plt.barh(importance_df['Característica'], importance_df['Importancia'])
plt.xlabel('Importancia de las características')
plt.title('Bosque aleatorio - Importancia de las características')
plt.gca().invert_yaxis() # Muestra las características más importantes en la parte superior
plt.show()
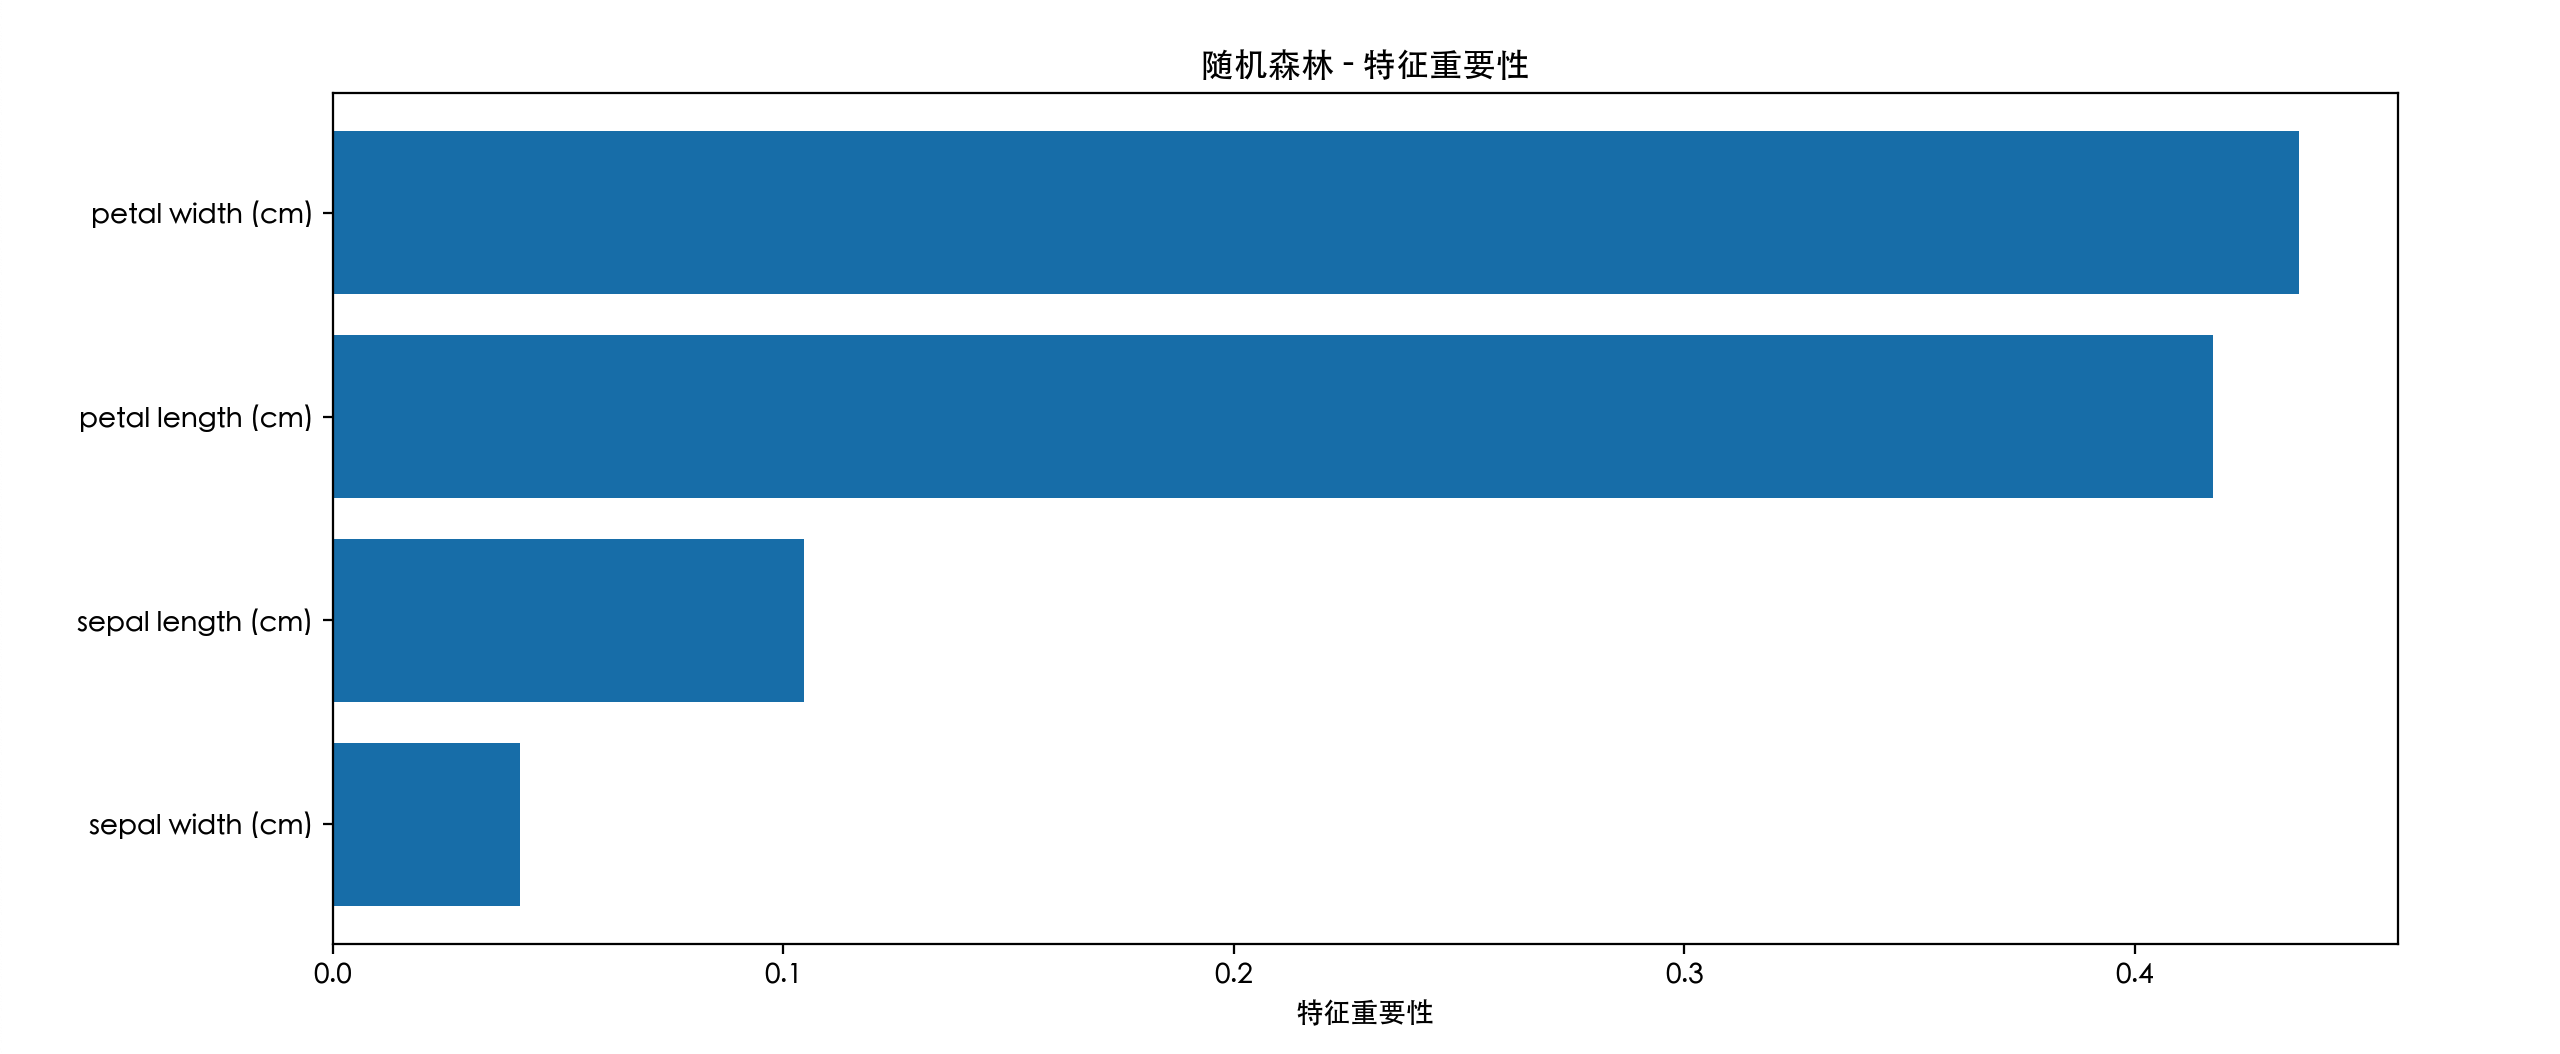
Análisis de salida: Probablemente notes que la importancia de la longitud y el ancho de los pétalos es mucho mayor que la de las dimensiones del cáliz. Esto es muy coherente con el sentido común botánico; de hecho, las características de los pétalos son la clave para distinguir las diferentes flores de iris.Esta funcionalidad es de gran valor para la selección de características y la comprensión de los datos.
Cuarta parte: Ventajas, desventajas y escenarios de aplicación
Ventajas
- Alta precisión: El aprendizaje por conjuntos (ensemble learning) suele alcanzar el mejor rendimiento posible con los datos actuales.
- Fuerte capacidad para resistir el sobreajuste: Gracias a Bagging y a la selección aleatoria de características, es difícil que se sobreajuste incluso sin poda.
- Poco exigente con los datos: Puede manejar características numéricas y categóricas, y no requiere escalado de características (como la normalización).
- Proporciona importancia de características: La evaluación de características integrada es un valioso subproducto.
- Fácil de paralelizar: El entrenamiento de cada árbol es independiente, por lo que se puede acelerar fácilmente en paralelo.
Desventajas
- Mala interpretabilidad del modelo: La "caja negra" formada por cientos o miles de árboles es mucho más difícil de interpretar que un solo árbol de decisión.
- Entrenamiento y predicción relativamente lentos: Cuando el número de árboles es grande, se necesitan más recursos computacionales y tiempo.
- Gran uso de memoria: Es necesario almacenar la estructura de todos los árboles del bosque completo.
Escenarios de aplicación típicos
- Problemas de clasificación: Por ejemplo, detección de correo no deseado, diagnóstico de enfermedades y clasificación de imágenes.
- Problemas de regresión: Por ejemplo, predicción de precios de viviendas y predicción de ventas.
- Selección de características: Utiliza la importancia de las características que genera para realizar el filtrado de características.
- Manejo de valores faltantes: El bosque aleatorio tiene una capacidad natural bastante buena para manejar valores faltantes.