Búsqueda de hiperparámetros
En la práctica del aprendizaje automático, a menudo nos encontramos con esta confusión: ¿por qué con el mismo algoritmo, el modelo de otros puede alcanzar una precisión del 95%, mientras que el mío solo tiene el 85%? Además de las diferencias en la calidad de los datos y la ingeniería de características, un factor clave suele serlos hiperparámetrosy su configuración.
Si el algoritmo del modelo es el motor del automóvil, entonces los hiperparámetros son las perillas de ajuste fino como el tiempo de encendido y la cantidad de inyección de combustible del motor. Si se ajustan bien, el motor tiene una potencia exuberante; si se ajustan mal, puede haber falta de potencia o un desgaste grave.
Este artículo te llevará a comprender sistemáticamente la búsqueda de hiperparámetros, que es un eslabón crucial en la optimización e ingeniería de modelos.
¿Qué son los hiperparámetros?
Antes de profundizar en los métodos de búsqueda, primero debemos aclarar un concepto central:hiperparámetrosyparámetros del modelola diferencia entre ambos.
Parámetros del modelo vs hiperparámetros
| Característica | Parámetros del modelo | Hiperparámetros |
|---|---|---|
| Definición | El modelo, a partir de los datos de entrenamiento,aprendelas variables internas obtenidas. | En el entrenamiento del modelo,antes de comenzar,variables de configuración establecidas manualmente por el desarrollador o seleccionadas mediante algoritmos. |
| Método de aprendizaje | Se ajustan automáticamente mediante algoritmos de optimización (como el descenso de gradiente). | No se aprenden de los datos de entrenamiento; requieren configuración externa. |
| Ejemplo | Los pesos en la regresión linealwy el sesgob; los pesos y sesgos en las redes neuronales. |
La tasa de aprendizaje, la profundidad máxima del árbol de decisión, el número de árboles en el bosque aleatorio, el valor K en KNN. |
| Impacto | Determina la capacidad del modelo para ajustarse a los datos específicos. | Determina elproceso de aprendizaje, la capacidad y la estructura, lo que afecta el rendimiento final. |
Una analogía vívida: imagina que estás aprendiendo a cocinar un plato nuevo (entrenando un modelo).
- Los parámetros del modeloson como las cantidades específicas de "un poco de sal, media cucharada de azúcar" que descubres durante el proceso de cocción según los ingredientes y el fuego. Esta cantidad se obtiene mediante la práctica (entrenamiento).
- Los hiperparámetrosse deciden antes de comenzar a cocinar: si usarsalteado a fuego altoococción lenta a fuego bajo(¿tasa de aprendizaje?) ¿Cuántas veceshay que remover y saltear(¿número de épocas de entrenamiento?) Estas elecciones afectan fundamentalmente el proceso de cocción y el sabor final.
Ejemplos de hiperparámetros comunes
Diferentes algoritmos de aprendizaje automático tienen sus propios hiperparámetros únicos:
Hiperparámetros generales:
learning_rate: la tasa de aprendizaje, que controla el tamaño del paso de actualización de los parámetros del modelo. Si es demasiado grande, es fácil "saltarse" el punto óptimo; si es demasiado pequeña, el aprendizaje es demasiado lento.n_estimators: el número de aprendices débiles (como árboles) en modelos de conjunto.max_iter/epochs: el número máximo de iteraciones o épocas de entrenamiento.
Modelos lineales / redes neuronales:
alpha/lambda: la intensidad del término de regularización, utilizada para evitar el sobreajuste.batch_size: el número de muestras utilizadas en cada actualización de parámetros.hidden_layer_sizes: el tamaño de las capas ocultas de la red neuronal.
Modelos de árbol:
max_depth: la profundidad máxima del árbol, que controla la complejidad del modelo.min_samples_split: el número mínimo de muestras requerido para dividir un nodo interno.min_samples_leaf: el número mínimo de muestras requerido en un nodo hoja.
¿Por qué se necesita la búsqueda de hiperparámetros?
Dado que los hiperparámetros son tan importantes, ¿podemos configurarlos arbitrariamente según la experiencia o la intuición? La respuesta es no. Las razones son las siguientes:
- Gran impacto en el rendimiento: para el mismo modelo, diferentes combinaciones de hiperparámetros pueden causar diferencias abismales en el rendimiento (como precisión, puntuación F1).
- No existe un valor óptimo universal: los hiperparámetros óptimos dependen en gran medida del conjunto de datos, la tarea y el modelo específicos; no existe un "parámetro mágico por defecto" que sea válido en todas partes.
- Espacio de combinaciones enorme: múltiples hiperparámetros se influyen mutuamente, formando un espacio de búsqueda de alta dimensionalidad. El ensayo y error manual es muy ineficiente y es fácil caer en un pensamiento local.
Por lo tanto, necesitamos métodos sistemáticos y automatizados para explorar este enorme espacio de parámetros y encontrar configuraciones con mejor rendimiento. Este proceso se llamabúsqueda de hiperparámetrosooptimización de hiperparámetros.。
Su objetivo principal es encontrar, dentro de un costo computacional aceptable, un conjunto de hiperparámetros que haga que el modelo tengaen datos no vistos(conjunto de validación) un rendimiento óptimo en las métricas.
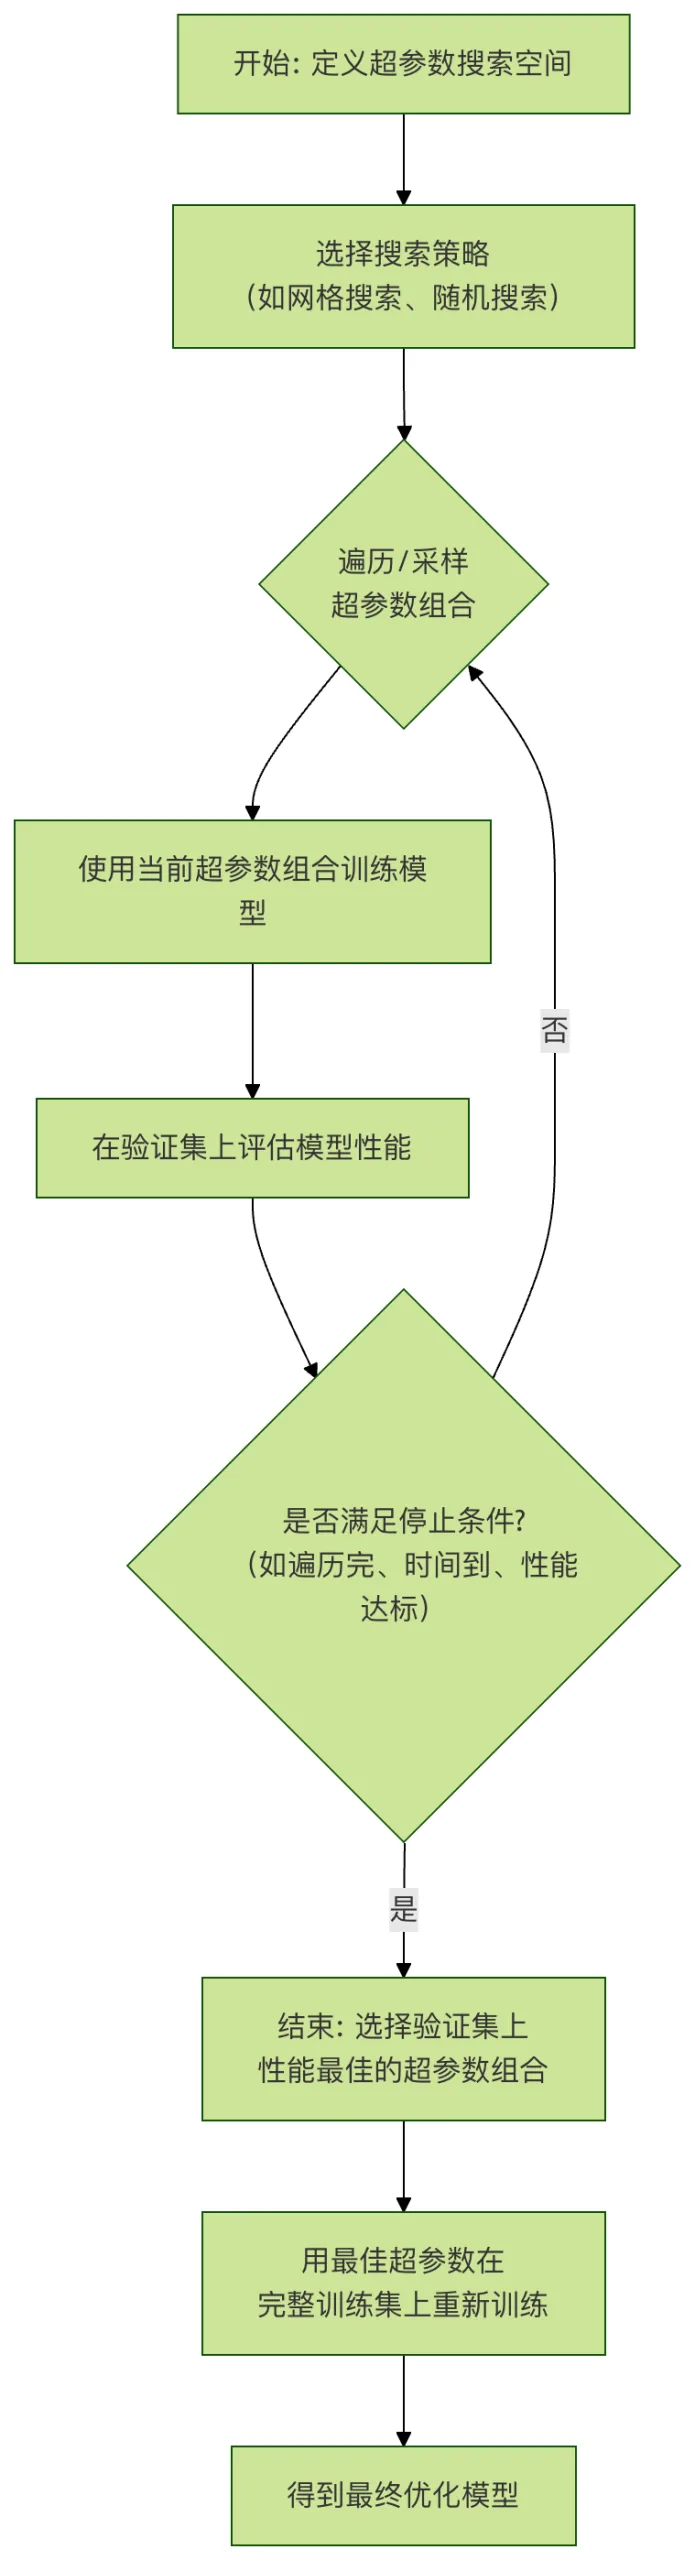
Estrategias principales de búsqueda de hiperparámetros
1. Búsqueda en cuadrícula
La búsqueda en cuadrícula es el método de búsqueda más básico e intuitivo.
Principio de funcionamiento:
- Se define una lista de valores candidatos para cada hiperparámetro a buscar.
- El algoritmo de búsqueda generará elproducto cartesiano, es decir, todas las combinaciones posibles.
- Recorre cada combinación, entrena el modelo y evalúa.
- Selecciona la combinación con mejor rendimiento en el conjunto de validación.
Ejemplo: búsqueda de dos hiperparámetros de la máquina de vectores de soporte (SVM).
Ejemplo
param_grid = {
'C': [0.1, 1, 10, 100], # Fuerza de regularización, 4 valores candidatos
'gamma': [0.001, 0.01, 0.1, 1] # Coeficiente del núcleo, 4 valores candidatos
}
# La búsqueda en cuadrícula probará 4 * 4 = 16 combinaciones diferentes
Ventajas:
- Simple y confiable: siempre que la cuadrícula sea lo suficientemente fina, se puede encontrar la solución óptima dentro del rango dado.
- Fácil de paralelizar: el entrenamiento y la evaluación de cada combinación de parámetros son independientes entre sí, muy adecuados para el cálculo en paralelo.
Desventajas:
- Maldición de la dimensionalidad: si el número de hiperparámetros es un poco mayor o los valores candidatos son más densos, el número de combinaciones crece exponencialmente y el costo computacional se vuelve inaceptable. Por ejemplo, con 5 parámetros, cada uno con 10 valores, ¡se necesitan entrenar y evaluar 10^5 = 100,000 modelos!
- Baja eficiencia: se puede desperdiciar una gran cantidad de recursos computacionales en parámetros "poco importantes".
2. Búsqueda aleatoria
La búsqueda aleatoria es una mejora efectiva frente a las desventajas de la búsqueda en cuadrícula.
Principio de funcionamiento:
- Se define unadistribución de probabilidad(como distribución uniforme, distribución uniforme logarítmica).
- Dentro del número total de pruebas especificado (
n_iter),se muestrean aleatoriamenteun conjunto de valores de hiperparámetros. - Se entrena y evalúa cada conjunto de parámetros muestreados.
- Se selecciona la combinación con mejor rendimiento.
Ejemplo: uso de la búsqueda aleatoria para optimizar un bosque aleatorio.
Ejemplo
from scipy.stats import randint, uniform
param_dist = {
'n_estimators': randint(100, 500), # Distribución uniforme entera, de 100 a 500
'max_depth': randint(5, 30), # Distribución uniforme entera, de 5 a 30
'min_samples_split': uniform(0.01, 0.2) # Distribución uniforme continua, de 0.01 a 0.21
}
# Realizar aleatoriamente 50 pruebas
random_search = RandomizedSearchCV(estimator=rf_model,
param_distributions=param_dist,
n_iter=50,
cv=5,
verbose=2)
random_search.fit(X_train, y_train)
¿Por qué la búsqueda aleatoria es más eficiente?La investigación (Bergstra & Bengio, 2012) muestra que, para la mayoría de los problemas, el rendimiento del modelo generalmente es sensible solo a unos pocos hiperparámetros. La búsqueda aleatoria nos permite explorar más veces encada dimensióny así tener una mayor probabilidad de encontrar la mejor región de los parámetros importantes, sin verse limitado por la cuadrícula fija de parámetros poco importantes como ocurre en la búsqueda en cuadrícula.
Ventajas:
- Alta eficiencia computacional: con el mismo presupuesto computacional, tiene una mayor probabilidad de encontrar una solución mejor que la búsqueda en cuadrícula.
- Flexible: se puede especificar convenientemente la distribución de probabilidad de los parámetros (como buscar la tasa de aprendizaje en escala logarítmica).
Desventajas:
- Aleatoriedad: los resultados pueden variar según la semilla aleatoria y se pueden pasar por alto algunas regiones.
- Sin memoria: cada prueba es independiente y no utiliza la información de pruebas anteriores para guiar la búsqueda posterior.
3. Optimización bayesiana
La optimización bayesiana es un método de búsqueda más inteligente, adecuado para la optimización de funciones cuyo costo de evaluación es muy alto (como entrenar un gran modelo de aprendizaje profundo que requiere varios días).
Idea central:
- modelo sustituto: Utilizar un modelo probabilístico de bajo costo computacional (como un proceso gaussiano) para "simular" la función objetivo real, de alto costo computacional (es decir, la relación entre el rendimiento del modelo y los hiperparámetros).
- Función de adquisición: Según la incertidumbre del modelo sustituto, selecciona la combinación de hiperparámetros "más prometedora" para la siguiente evaluación. Equilibra laexploración(muestreo en regiones de alta incertidumbre) y laexplotación(muestreo cerca de regiones con rendimiento conocido bueno).
Flujo de trabajo:
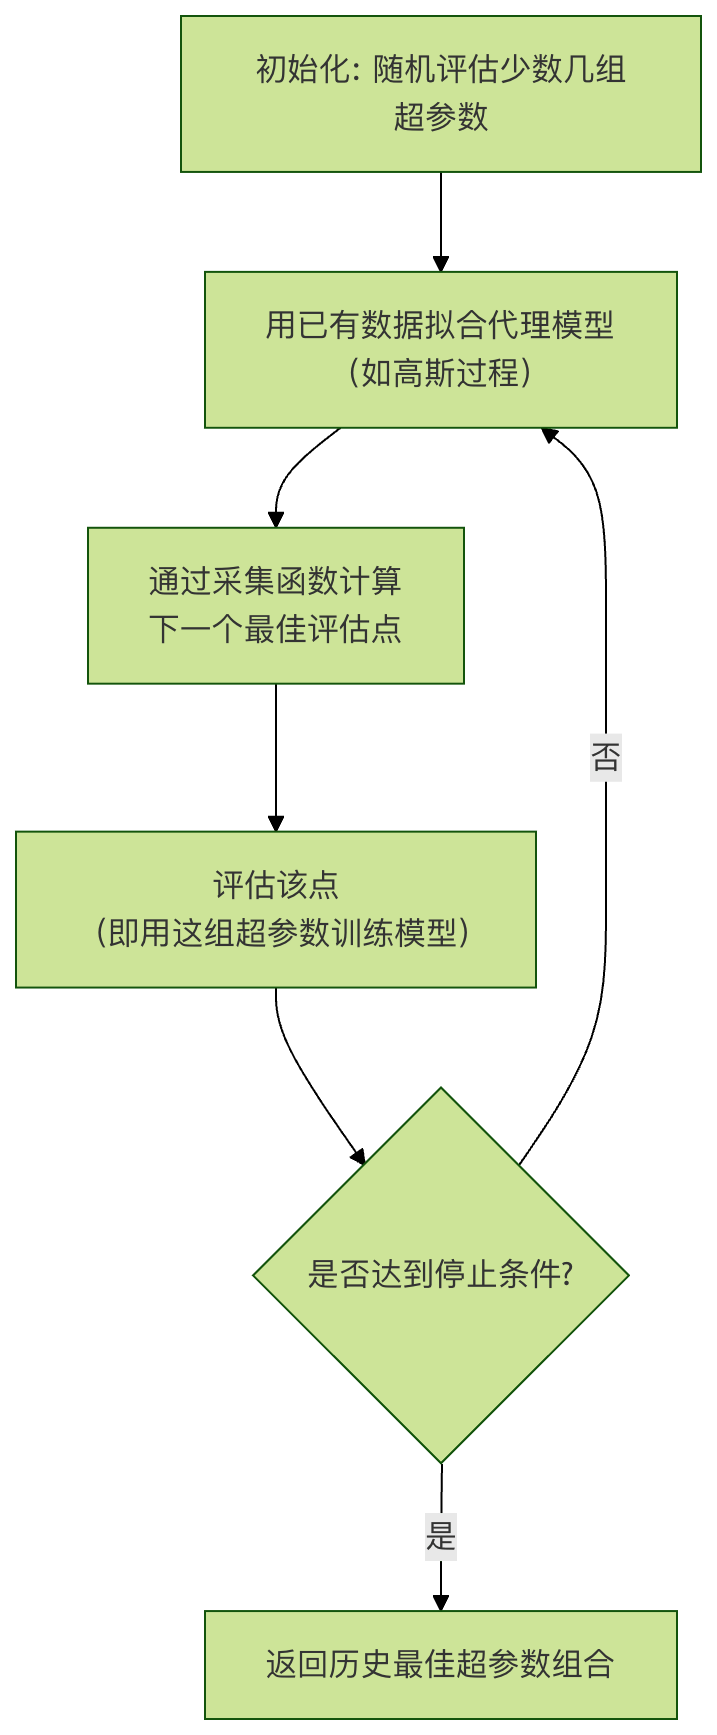
Ventajas:
- Extremadamente eficiente: Puede encontrar soluciones cercanas a la óptima con el menor número de pruebas; especialmente adecuado para modelos costosos.
- Adaptabilidad: Utiliza información histórica para guiar la dirección de búsqueda de forma inteligente.
Desventajas:
- Implementación compleja: Es más complejo que los dos anteriores.
- Dificultad de paralelización: La optimización bayesiana estándar es secuencial y difícil de paralelizar directamente (aunque existen métodos mejorados).
- Para espacios de alta dimensión: A medida que aumenta la dimensionalidad de los hiperparámetros, el ajuste y la optimización del modelo sustituto se vuelven más difíciles.
Herramientas comunes: scikit-optimize, BayesianOptimization, Optuna, Hyperopt。
Prácticas de ingeniería y consideraciones
1. Estrategia de validación: ¡no contamines tu conjunto de prueba!
Al buscar hiperparámetros,nunca se debeutilizar el conjunto de prueba para guiar el proceso de búsqueda; de lo contrario, se producirá fuga de información y una estimación demasiado optimista del rendimiento de generalización.
Enfoque correcto:
- Divida los datos en:Conjunto de entrenamiento、Conjunto de validación、Conjunto de prueba。
- La búsqueda de hiperparámetros se realiza en el «conjunto de entrenamiento + conjunto de validación» (por ejemplo, usando validación cruzada).
- Después de seleccionar los mejores hiperparámetros, use este conjunto de parámetros en elconjunto de entrenamiento completo(o en el conjunto de entrenamiento + validación combinados) para volver a entrenar el modelo final.
- Finalmente, use los datos que nunca han participado en ningún proceso de entrenamiento o ajuste:el conjunto de pruebapara evaluar de manera justa la capacidad de generalización del modelo final.
2. Usar validación cruzada
Para evaluar el rendimiento de los hiperparámetros de manera más robusta y evitar la casualidad debida a una única división de datos, se debe utilizar la validación cruzada.
Ejemplo
# Usar validación cruzada de 5 pliegues para la búsqueda en cuadrícula
grid_search = GridSearchCV(estimator=model,
param_grid=param_grid,
cv=5, # Validación cruzada de 5 pliegues
scoring='accuracy',
return_train_score=True)
grid_search.fit(X_train_val, y_train_val) # Aquí se usan datos de entrenamiento + validación
print(f"Mejores parámetros: {grid_search.best_params_}")
print(f"Mejor puntuación de validación cruzada: {grid_search.best_score_:.4f}")
# Obtener el mejor modelo (ya reajustado con los mejores parámetros en todos los datos)
best_model = grid_search.best_estimator_
3. Técnicas de diseño del espacio de hiperparámetros
- Parámetros sensibles a la escala: Para parámetros como la tasa de aprendizaje y la intensidad de regularización, surango efectivo a menudo abarca múltiples órdenes de magnitud. La búsqueda debe realizarse en una escala logarítmica (por ejemplo,
[0.001, 0.01, 0.1, 1]), no en una escala lineal (como[0.1, 0.2, ..., 1.0])。 - De grueso a fino: Primero se puede realizar una búsqueda aleatoria de amplio alcance o una búsqueda de cuadrícula dispersa para localizar regiones con buen rendimiento, y luego realizar una búsqueda más fina en esa región.
- Aprovechar el conocimiento previo: Según los principios del algoritmo y la literatura empírica, establezca rangos y distribuciones iniciales razonables.
4. Automatización y cadena de herramientas
En la ingeniería real, la búsqueda de hiperparámetros a menudo se integra en los pipelines de MLOps.
- Los frameworks:
Scikit-learnproporcionanGridSearchCVyRandomizedSearchCV。 - librerías avanzadas:
Optuna,Ray Tune,Keras Tunerofrecen capacidades de búsqueda más potentes y amigables con la distribución, y admiten características avanzadas como detención temprana y poda. - Servicios en la nube: Plataformas como AWS SageMaker, Google Vertex AI, etc. ofrecen servicios gestionados de optimización de hiperparámetros.
Ejercicio práctico
Ahora, usemos elScikit-learnyBosque aleatorioconjunto de datos para completar un ejercicio completo de búsqueda de hiperparámetros.
Tarea: Utilice el conjunto de datos de vinos para optimizar un clasificador de bosque aleatorio mediante búsqueda aleatoria.
Ejemplo
import numpy as np
from sklearn.datasets import load_wine
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split, RandomizedSearchCV
from sklearn.metrics import classification_report
from scipy.stats import randint
# 2. Cargar los datos y dividirlos
data = load_wine()
X, y = data.data, data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
X_train_val, X_val, y_train_val, y_val = train_test_split(X_train, y_train, test_size=0.25, random_state=42) # 0.25 * 0.8 = 0.2
# 3. Definir el modelo y la distribución de parámetros
rf = RandomForestClassifier(random_state=42)
param_dist = {
'n_estimators': randint(50, 300), # Número de árboles
'max_depth': randint(3, 20), # Profundidad máxima del árbol
'min_samples_split': randint(2, 10), # Número mínimo de muestras requeridas para dividir un nodo interno
'min_samples_leaf': randint(1, 5), # Número mínimo de muestras en el nodo hoja
'max_features': ['sqrt', 'log2'] # Número de características a considerar al buscar la mejor división
}
# 4. Ejecutar la búsqueda aleatoria (con validación cruzada de 3 pliegues)
random_search = RandomizedSearchCV(estimator=rf,
param_distributions=param_dist,
n_iter=30, # Probar aleatoriamente 30 conjuntos de parámetros
cv=3, # Validación cruzada de 3 pliegues
scoring='accuracy',
random_state=42,
verbose=1,
n_jobs=-1) # Usar todos los núcleos de la CPU en paralelo
random_search.fit(X_train_val, y_train_val)
# 5. Mostrar los resultados de la búsqueda
print("="*50)
print("Mejores parámetros de la búsqueda aleatoria:")
print(random_search.best_params_)
print(f"\n"Mejor precisión de validación cruzada: {random_search.best_score_:.4f}")
# 6. Evaluar el mejor modelo en el conjunto de validación independiente
best_model = random_search.best_estimator_
y_val_pred = best_model.predict(X_val)
print("\n"Informe de rendimiento en el conjunto de validación:")
print(classification_report(y_val, y_val_pred, target_names=data.target_names))
# 7. (Paso final) Volver a entrenar con los mejores parámetros en todo el conjunto de entrenamiento y evaluar en el conjunto de prueba
final_model = RandomForestClassifier(**random_search.best_params_, random_state=42)
final_model.fit(X_train, y_train) # Usar todos los datos de entrenamiento
y_test_pred = final_model.predict(X_test)
print("="*50)
print("Informe de rendimiento del modelo final en el conjunto de prueba (datos completamente nuevos):")
print(classification_report(y_test, y_test_pred, target_names=data.target_names))
Salida:
Fitting 3 folds for each of 30 candidates, totalling 90 fits
==================================================
随机搜索最佳参数:
{'max_depth': 9, 'max_features': 'log2', 'min_samples_leaf': 1, 'min_samples_split': 8, 'n_estimators': 156}

最佳交叉验证准确率:0.9812

在验证集上的性能报告:
              precision    recall  f1-score   support

     class_0       1.00      1.00      1.00        11
     class_1       1.00      0.94      0.97        16
     class_2       0.90      1.00      0.95         9

    accuracy                           0.97        36
   macro avg       0.97      0.98      0.97        36
weighted avg       0.98      0.97      0.97        36

==================================================
最终模型在测试集(全新数据)上的性能报告:
              precision    recall  f1-score   support

     class_0       1.00      1.00      1.00        14
     class_1       1.00      1.00      1.00        14
     class_2       1.00      1.00      1.00         8

    accuracy                           1.00        36
   macro avg       1.00      1.00      1.00        36
weighted avg       1.00      1.00      1.00        36
Otras extensiones