Solución de problemas comunes
Los proyectos de aprendizaje automático a menudo enfrentan una serie de desafíos inesperados al pasar de un prototipo de laboratorio a un entorno de producción.
El modelo se desempeña excelentemente en el conjunto de entrenamiento, pero después del despliegue real su rendimiento es pobre, e incluso falla por completo. Esta es una dificultad que muchos ingenieros de aprendizaje automático y principiantes experimentan.
Este artículo revisa sistemáticamente los tipos de problemas más comunes en la optimización e ingeniería de modelos de aprendizaje automático, y proporciona ideas claras de solución de problemas y soluciones para ayudarte a construir sistemas de aprendizaje automático más robustos y confiables.
I. Problemas de rendimiento del modelo: buen entrenamiento, mal rendimiento en producción
Este es el problema más clásico y frustrante. Tu modelo alcanza una precisión del 95% en Jupyter Notebook, pero una vez implementado en producción, su rendimiento cae en picada.
1. Distribución de datos inconsistente
Esta es la "principal causa" de la degradación del rendimiento. Existen diferencias en la distribución estadística entre los datos de entrenamiento y los datos en tiempo real en producción.
Escenarios comunes y puntos de verificación:
Inconsistencia en la ingeniería de características: el código de procesamiento de características fuera de línea (como normalización, división en buckets, relleno de valores faltantes) no es completamente consistente con el código del servicio en línea.
- Verificación: compara los datos de muestra después del preprocesamiento fuera de línea y el preprocesamiento en línea. Asegúrate de que el Scaler utilizado (como
StandardScaler) utilice en línea los parámetros ajustados fuera de línea (scaler.mean_,scaler.scale_), en lugar de reajustarlos.
Sesgo temporal en la recopilación de datos: Los datos de entrenamiento son de los últimos tres meses, mientras que los datos en línea son actuales; el comportamiento del usuario y el entorno del mercado pueden haber cambiado (deriva conceptual).
- Verificación: Monitorea los cambios en la distribución de las características de entrada del modelo a lo largo del tiempo. Puedes calcular periódicamente la media, la varianza y los cuantiles de las características y compararlas con el conjunto de entrenamiento.
Sesgo de selección de muestra: Los datos de entrenamiento no representan a todos los usuarios. Por ejemplo, entrenar un modelo de recomendación solo con datos de usuarios activos no funcionará para usuarios nuevos o inactivos.
- Verificación: Analiza la distribución del perfil de usuario entre el conjunto de entrenamiento y las solicitudes en línea (por ejemplo, proporción de usuarios nuevos y antiguos, distribución geográfica, etc.).
Soluciones:Establecer un sólidomonitoreo de datosymonitoreo de modelossistema. No solo se debe monitorear la salida del modelo (como AUC, precisión), sino también la distribución de las características de entrada. Una vez detectada la deriva, se deben activar alertas y considerar actualizar los datos de entrenamiento o reentrenar el modelo.
Ejemplo
import numpy as np
import pandas as pd
# Supongamos que este es el valor de la característica 'feature_a' recibido en tiempo real en línea
online_feature_values = [0.1, 0.5, 1.2, 0.8, 1.5, 2.0, 2.5]
training_mean = 0.5 # Media de 'feature_a' en el conjunto de entrenamiento
training_std = 0.3 # Desviación estándar de 'feature_a' en el conjunto de entrenamiento
current_online_mean = np.mean(online_feature_values[-100:]) # Media de los últimos 100 puntos
# Calcular el puntaje Z para determinar simplemente si hay una deriva significativa
z_score = (current_online_mean - training_mean) / training_std
print(f"Media actual de la característica en línea: {current_online_mean:.3f}")
print(f"Puntaje Z con respecto a la media del conjunto de entrenamiento: {z_score:.3f}")
if abs(z_score) > 3: # Umbral, por ejemplo, 3 desviaciones estándar
print("Advertencia: ¡se detectó que la característica 'feature_a' puede tener deriva de distribución!")
2. Fuga de datos
El modelo "espía" información que solo debería conocerse en el momento de la predicción, lo que infla los resultados de evaluación.
Escenarios comunes:
- Al dividir el conjunto de entrenamiento/pruebaantesse realizó una normalización global o el relleno de valores faltantes (se utilizó información del conjunto de prueba).
- En problemas de series temporales, se usa datos futuros para predecir el pasado.
- Las características incluyen "información futura" fuertemente correlacionada con la variable objetivo (por ejemplo, usar "si se recibió una queja hoy" para predecir "si se cancelará el pedido hoy").
Verificación y solución:Siga estrictamente el flujo de trabajo de aprendizaje automático.Cualquier operación que aprenda parámetros de los datos (como ajustar un Scaler, rellenar valores faltantes, selección de características) debe realizarse en el conjunto de entrenamiento, y luego usar solo esos parámetros para transformar los conjuntos de validación y prueba.UsarsklearndePipelinepuede evitar bien este problema.
Ejemplo
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
# X, y son los datos originales y las etiquetas
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X) # ¡Error! Aquí se usaron todos los datos para ajustar el scaler
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2)
# En este momento, la información de X_test ya se ha "filtrado" al scaler, lo que afecta la transformación de X_train
# Ejemplo correcto: dividir primero y luego procesar por separado
X_train_raw, X_test_raw, y_train, y_test = train_test_split(X, y, test_size=0.2)
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train_raw) # Ajustar solo con el conjunto de entrenamiento
X_test = scaler.transform(X_test_raw) # Transformar el conjunto de prueba con los parámetros ajustados con el conjunto de entrenamiento
II. Problemas de ingeniería e implementación
Convertir un modelo de un archivo a una API de alta disponibilidad que sirva de manera estable está lleno de trampas.
1. Conflictos de dependencias y versiones del entorno
"¡En mi máquina funciona!" — un clásico. Las versiones de Python y de las librerías difieren entre el entorno de entrenamiento y el entorno de inferencia en línea.
Lista de verificación:
- Versión principal de Python (3.7 vs 3.9)
- Versiones de librerías principales (
tensorflow==2.8vstensorflow==2.12) - Dependencias del sistema (como ciertas librerías que dependen de bibliotecas de tiempo de ejecución de C++ específicas)
- Formato de serialización del modelo (usando
picklemodelos guardados con, si hay una gran diferencia de versión de Python, es posible que no se puedan cargar)
Soluciones:
- Contenerización: Usa Docker para empaquetar el modelo y todas sus dependencias en una imagen. Este es el estándar de oro para garantizar la consistencia del entorno.
- Gestión de dependencias: Usa
requirements.txtoenvironment.ymlpara registrar con precisión todos los paquetes y sus versiones. - Formato del modelo: Considera usar un formato de modelo multiplataforma y multilenguaje, comoONNXoPMML, o un formato nativo seguro del framework (como
TensorFlow SavedModel,PyTorch TorchScript)。
2. Rendimiento de inferencia en línea deficiente
El tiempo de respuesta de la interfaz es demasiado largo, el rendimiento (TPS) no aumenta y no puede satisfacer las necesidades del negocio.
Cuellos de botella comunes y optimizaciones:
- Alto costo de predicción individual: El modelo en sí es complejo (como modelos grandes de aprendizaje profundo).
- Optimización: Poda de modelos, cuantización, destilación de conocimiento, o reescritura con una arquitectura de modelo más eficiente.
- E/S frecuentes o llamadas de red: Cada predicción requiere obtener características de una base de datos o un servicio remoto.
- Optimización: Implementa caché de características, precomputación, o convierte las características en un servicio para reducir la latencia.
- Falta de aceleración de hardware: Ejecutar en CPU modelos adecuados para GPU.
- Optimización: Selecciona el hardware de inferencia correcto (CPU/GPU/chips de IA dedicados) y el framework de inferencia (como
TensorRT,OpenVINO)。
- Optimización: Selecciona el hardware de inferencia correcto (CPU/GPU/chips de IA dedicados) y el framework de inferencia (como
- Baja eficiencia del framework de servicio: Usar Flask para cargar el modelo directamente tiene una capacidad débil de manejo de concurrencia.
- Optimización: Usa frameworks de servicio de ML de alto rendimiento, comoTensorFlow Serving, TorchServe, oTriton Inference Server. Soportan funciones avanzadas como actualización en caliente de modelos, procesamiento por lotes dinámico y alojamiento de múltiples modelos.
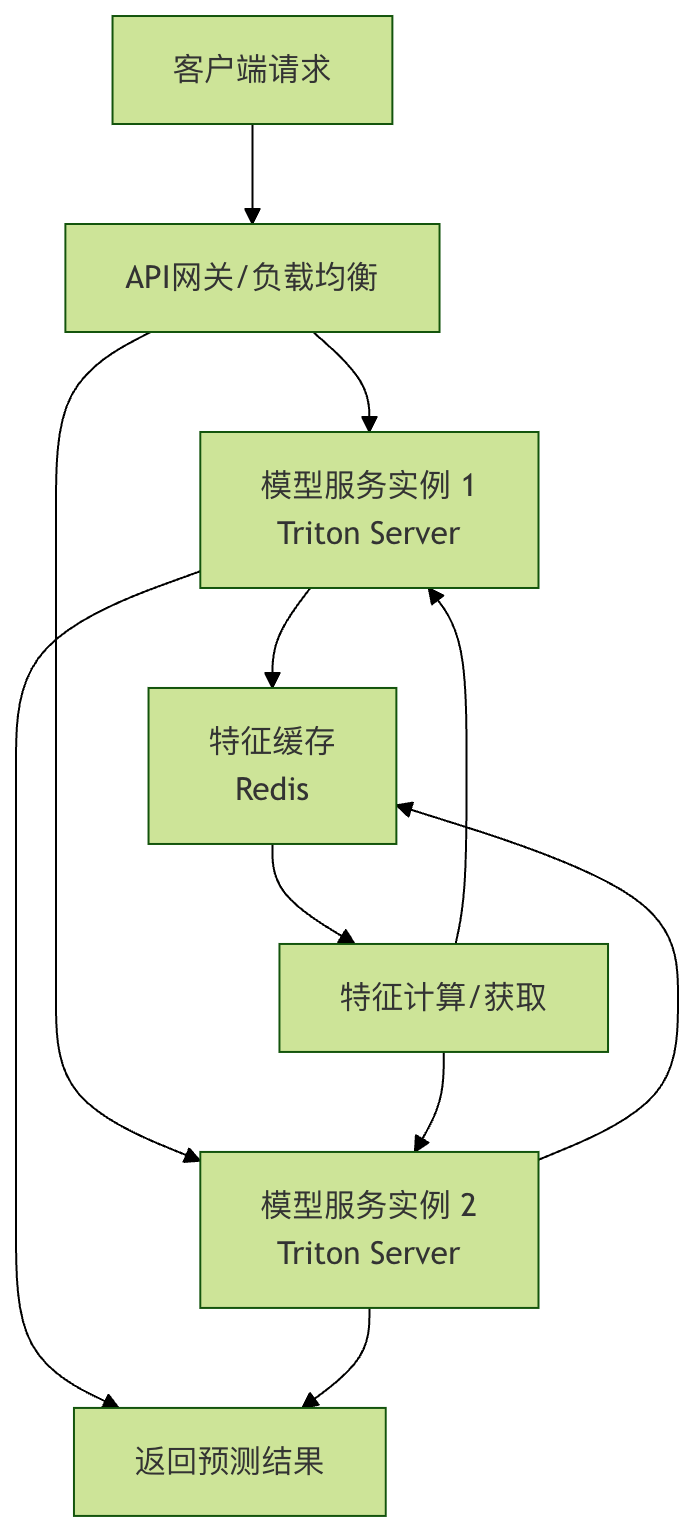
Figura: un ejemplo de arquitectura de servicio de modelos de alto rendimiento, que incluye balanceo de carga, caché de características y servidores de modelos dedicados.
3. Gestión inadecuada de recursos
El servicio de modelos tiene fugas de memoria, o con el tiempo consume cada vez más memoria, hasta que el servicio colapsa.
Verificación:
- Método de carga del modelo: ¿Se recarga el modelo en cada solicitud? Lo correcto es cargarlo en memoria una vez al iniciar el servicio y compartirlo en las solicitudes posteriores.
- Acumulación de variables globales: ¿Hay Listas o Diccionarios globales en el código del servicio que acumulan datos sin limpiarse?
- Resultados de predicción grandes: ¿Los resultados de predicción devueltos (como imágenes, textos grandes) ocupan mucha memoria y no se liberan a tiempo?
Solución:
- Usar
gunicorn、uvicornal usar servidores multiproceso/asíncronos, comprender su modelo de Worker. - Reiniciar periódicamente el proceso del servicio (mediante herramientas de gestión de procesos como
systemdosupervisor)。 - Usar herramientas profesionales de análisis de memoria (como
memory_profiler) para localizar el punto de fuga.
III. Problemas del modelo y del algoritmo
1. Sobreajuste y subajuste
Este es un problema fundamental de la capacidad del modelo.
| Problema | Fenómeno | Causas posibles | Solución |
|---|---|---|---|
| Subajuste | Rendimiento del conjunto de entrenamiento y validaciónambos son deficientes | El modelo es demasiado simple (baja complejidad), características insuficientes, épocas de entrenamiento insuficientes | Aumentar la complejidad del modelo, agregar más características efectivas, aumentar las épocas de entrenamiento |
| Sobreajuste | Rendimiento del conjunto de entrenamientomuy bueno, rendimiento del conjunto de validaciónmuy malo | El modelo es demasiado complejo, hay muy pocos datos de entrenamiento, demasiado ruido | Aumentar los datos de entrenamiento, usar regularización (L1/L2/Dropout), reducir la complejidad del modelo, detención temprana |
Diagnóstico:Trazar la curva de aprendizaje es la mejor manera de evaluar el ajuste.
2. Desaparición/explotación del gradiente
Es común al entrenar redes neuronales profundas, lo que provoca que el modelo no converja o que el entrenamiento sea inestable.
Síntomas:
- La pérdida del modelo se vuelve
NaN。 - Los valores de los pesos se vuelven extremadamente grandes o pequeños.
- En las primeras etapas del entrenamiento, el valor de pérdida deja de cambiar.
Soluciones:
- Inicialización de pesos: usar
He初始化(función de activación ReLU) oXavier初始化(Tanh/Sigmoid)。 - Recorte de gradiente: establecer un umbral, y cuando el gradiente lo supere, recortarlo.
- Normalización por lotes: agregar antes de la función de activación una
BatchNormcapa, lo que estabiliza el entrenamiento y permite usar una tasa de aprendizaje más alta. - Ajustar la estructura de la red: usar estructuras como las conexiones residuales en ResNet.
IV. Establecer un proceso sistemático de resolución de problemas
Cuando el modelo en producción presenta problemas, un proceso de diagnóstico sistemático te ayuda a localizar rápidamente el problema.
- Confirmar el problema: ¿Son errores de predicción en general, o son para grupos/escenarios específicos? ¿Cuál es la tasa de error?
- Verificar las entradas: obtener un lote de datos de solicitudes con errores en producción, verificar si las características de entrada están completas, si el formato es correcto, si los valores están en un rango razonable (como la aparición de
NaN,Info valores extremos). - Reproducción local: usar los datos de entrada con errores de producción, en el entorno de desarrollo local con elmismo modelo y códigopara hacer predicciones y ver si se puede reproducir el problema.
- Comparar datos: comparar la distribución de datos de las solicitudes en producción con la distribución de los datos de entrenamiento, verificar si existe deriva.
- Verificar código y configuración: comprobar si la versión del código del servicio en producción, la versión del archivo del modelo y los archivos de configuración son consistentes con el entorno que pasó las pruebas.
- Verificar registros y monitoreo: revisar si los registros del servicio tienen errores anómalos, y si las métricas de CPU, memoria y tiempo de respuesta del sistema de monitoreo son anómalas.
- Simplificar y localizar: si es posible, intentar procesar las entradas con error usando un modelo minimalista o un sistema de reglas, para determinar si es un problema de datos o un problema del modelo.