Algoritmos de aprendizaje automático
Los algoritmos de aprendizaje automático se pueden dividir en categorías como aprendizaje supervisado, aprendizaje no supervisado y aprendizaje por refuerzo.
Algoritmos de aprendizaje supervisado:
- Regresión lineal(Linear Regression): se utiliza para tareas de regresión, predice valores numéricos continuos.
- Regresión logística(Logistic Regression): se utiliza para tareas de clasificación binaria, predice categorías.
- Máquina de vectores de soporte(SVM): se utiliza para tareas de clasificación, construye hiperplanos para clasificar.
- Árbol de decisión(Decision Tree): método de clasificación o regresión que toma decisiones basadas en una estructura de árbol.
Algoritmos de aprendizaje no supervisado:
- Agrupamiento K-means: agrupa los datos mediante centros de agrupamiento.
- Análisis de componentes principales (PCA): se utiliza para reducir la dimensionalidad, extrae los componentes principales de los datos.
Cada algoritmo tiene sus escenarios de aplicación. En la práctica, se puede elegir el algoritmo de aprendizaje automático más adecuado según las características de los datos (como si tienen etiquetas, la dimensionalidad de los datos, etc.).
| Dimensión de clasificación | Categoría | Definición principal | Algoritmos típicos | Principales ventajas y desventajas | Escenarios de aplicación |
|---|---|---|---|---|---|
| Método de aprendizaje | Aprendizaje supervisado | Aprende la asignación de entrada a salida usando datos etiquetados | Regresión logística, SVM, árboles de decisión, CNN, LSTM | Ventajas: alta precisión de predicción; Desventajas: depende de datos etiquetados de alta calidad | Clasificación, regresión, reconocimiento de imágenes, traducción de textos |
| Aprendizaje no supervisado | Descubre patrones internos de los datos utilizando datos no etiquetados | K-Means, PCA, DBSCAN, autoencoders | Ventajas: no requiere etiquetado; Desventajas: interpretabilidad débil de los resultados | Agrupamiento de datos, reducción de dimensionalidad, detección de anomalías, segmentación de usuarios | |
| Aprendizaje semisupervisado | Entrena combinando una pequeña cantidad de datos etiquetados y una gran cantidad de datos no etiquetados | SVM semisupervisado, algoritmo de propagación de etiquetas | Ventajas: reduce el costo de etiquetado; Desventajas: diseño del modelo complejo | Análisis de imágenes médicas, PLN para idiomas minoritarios | |
| Aprendizaje por refuerzo | El modelo optimiza su política interactuando con el entorno mediante señales de recompensa | Q-Learning、DQN、PPO | Ventajas: se adapta a decisiones dinámicas; Desventajas: ciclo de entrenamiento largo | IA para juegos, control de robots, optimización de estrategias de recomendación | |
| Objetivo de la tarea | Algoritmos de clasificación | Predicen etiquetas de clases discretas | Regresión logística, Random Forest, CNN | Ventajas: adecuado para escenarios de clasificación; Desventajas: sensible al desequilibrio de clases | Detección de spam, clasificación de imágenes, diagnóstico de enfermedades |
| Algoritmos de regresión | Predicen salidas numéricas continuas | Regresión lineal, regresión ridge, XGBoost | Ventajas: genera valores continuos; Desventajas: sensible a valores atípicos | Predicción de precios de viviendas, predicción de ventas, predicción de temperatura | |
| Algoritmos de agrupamiento | Agrupan datos similares en una misma clase sin etiquetas | K-Means, agrupamiento jerárquico, DBSCAN | Ventajas: agrupación automática; Desventajas: el efecto del agrupamiento depende de la métrica de distancia | Segmentación de mercado, perfiles de usuario, detección de anomalías | |
| Algoritmos de reducción de dimensionalidad | Reducen la dimensión de las características, conservando la información esencial | PCA、t-SNE、LDA | Ventajas: reduce el costo computacional; Desventajas: puede perder parte de la información | Visualización de datos de alta dimensión, preprocesamiento de características | |
| Estructura del modelo | Modelo lineal | Asume una relación lineal entre entrada y salida | Regresión lineal, regresión logística, regresión ridge | Ventajas: alta interpretabilidad, entrenamiento rápido; Desventajas: difícil de ajustar relaciones no lineales | Regresión y clasificación simples, construcción de modelos base |
| Modelo de árbol | Construido sobre árboles de decisión, maneja relaciones no lineales | Árboles de decisión, Random Forest, XGBoost, LightGBM | Ventajas: no requiere normalización de características; Desventajas: árboles demasiado profundos tienden a sobreajustarse | Clasificación y regresión a nivel industrial, tareas de nivel competitivo | |
| Modelo de red neuronal | Estructura de neuronas multicapa, extrae automáticamente características complejas | ANN、CNN、RNN、Transformer | Ventajas: ajusta relaciones complejas; Desventajas: requiere grandes cantidades de datos y potencia computacional | Reconocimiento de imágenes, PLN, síntesis de voz | |
| Modelo probabilístico | Basado en teoría estadística de probabilidad, calcula distribuciones de probabilidad | Naive Bayes, modelos ocultos de Markov | Ventajas: base teórica sólida; Desventajas: depende de supuestos fuertes | Clasificación de textos, reconocimiento de voz, etiquetado de secuencias |
Algoritmos de aprendizaje supervisado
Regresión lineal (Linear Regression)
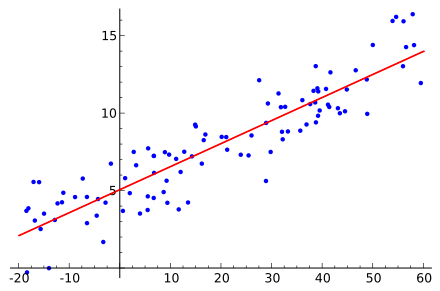
La regresión lineal es un algoritmo para problemas de regresión que predice una salida continua aprendiendo la relación lineal entre las características de entrada y el valor objetivo.
Escenarios de aplicación:Predecir precios de viviendas, precios de acciones, etc.
El objetivo de la regresión lineal es encontrar la mejor ecuación lineal:
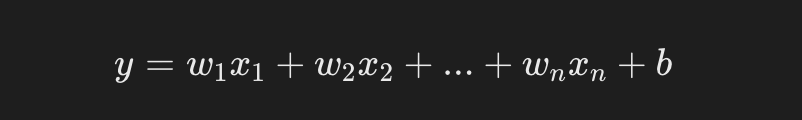
- y es el valor predicho (valor objetivo).
- x1,x2,xnes la característica de entrada.
- w1,w2,wnes el peso a aprender (parámetro del modelo).
- b es el término de sesgo.
A continuación utilizamos sklearn para realizar una predicción simple del precio de la vivienda:
Ejemplo
from sklearn.model_selection import train_test_split
import pandas as pd
# Supongamos que tenemos un conjunto de datos simple de precios de viviendas
data = {
'Superficie': [50, 60, 80, 100, 120],
'Precio': [150, 180, 240, 300, 350]
}
df = pd.DataFrame(data)
# Características y etiquetas
X = df[['Superficie']]
y = df['Precio']
# División de datos
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Entrenar el modelo de regresión lineal
model = LinearRegression()
model.fit(X_train, y_train)
# Predecir
y_pred = model.predict(X_test)
print(f"Precio de vivienda predicho: {y_pred}")
El resultado es:
预测的房价: [180.8411215]
Regresión logística (Logistic Regression)
La regresión logística es un algoritmo para problemas de clasificación. Aunque su nombre contiene 'regresión', se utiliza para problemas de clasificación binaria.
La regresión logística predice una etiqueta de clase aprendiendo la relación entre las características de entrada y la categoría.
Escenarios de aplicación:Clasificación de spam, diagnóstico de enfermedades (enfermo o no).
La salida de la regresión logística es un valor de probabilidad que indica la probabilidad de que una muestra pertenezca a una categoría.
Normalmente se utiliza la función Sigmoid:
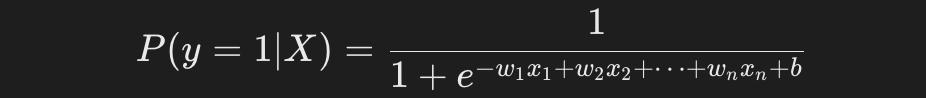
Uso de la regresión logística para una tarea de clasificación binaria:
Ejemplo
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Cargar el conjunto de datos Iris
iris = load_iris()
X = iris.data
y = iris.target
# Tomar solo las dos primeras clases para la tarea de clasificación binaria
X = X[y != 2]
y = y[y != 2]
# División de datos
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Entrenar el modelo de regresión logística
model = LogisticRegression()
model.fit(X_train, y_train)
# Predecir
y_pred = model.predict(X_test)
# Evaluar el modelo
print(f"Precisión de clasificación: {accuracy_score(y_test, y_pred):.2f}")
El resultado es:
分类准确率: 1.00
Máquina de vectores de soporte (SVM)
La máquina de vectores de soporte es un algoritmo de clasificación común que construye hiperplanos para maximizar el margen entre clases, minimizando así el error de clasificación.
Escenarios de aplicación:Clasificación de textos, reconocimiento facial, etc.
Uso de SVM para la tarea de clasificación de Iris:
Ejemplo
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Cargar el conjunto de datos Iris
iris = load_iris()
X = iris.data
y = iris.target
# División de datos
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Entrenar el modelo SVM
model = SVC(kernel='linear')
model.fit(X_train, y_train)
# Predecir
y_pred = model.predict(X_test)
# Evaluar el modelo
print(f"Precisión de clasificación SVM: {accuracy_score(y_test, y_pred):.2f}")
El resultado es:
SVM 分类准确率: 1.00
Árbol de decisión (Decision Tree)
El árbol de decisión es un método de clasificación y regresión que toma decisiones basándose en una estructura de árbol. Decide a qué categoría pertenece una muestra mediante una serie de 'condiciones de decisión'.
Escenarios de aplicación:Clasificación de clientes, puntuación de crédito, etc.
Uso de un árbol de decisión para la tarea de clasificación:
Ejemplo
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Cargar el conjunto de datos Iris
iris = load_iris()
X = iris.data
y = iris.target
# División de datos
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Entrenar el modelo de árbol de decisión
model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)
# Predicción
y_pred = model.predict(X_test)
# Evaluar el modelo
print(f"Precisión de clasificación del árbol de decisión: {accuracy_score(y_test, y_pred):.2f}")
El resultado de salida es:
决策树分类准确率: 1.00
Algoritmos de aprendizaje no supervisado
Agrupamiento K-means (K-means Clustering)
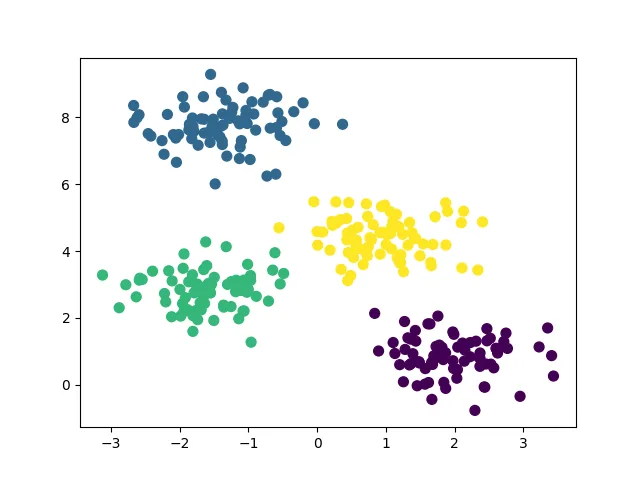
K-means es un algoritmo de agrupamiento basado en centroides que, al ajustar continuamente el centroide de cada grupo, hace que los puntos de datos de cada grupo estén lo más cerca posible del centro del grupo.
Escenarios de aplicación:Segmentación de clientes, análisis de mercado, compresión de imágenes.
Uso de K-means para la segmentación de clientes:
Ejemplo
from sklearn.datasets import make_blobs
import matplotlib.pyplot as plt
# Generar un conjunto de datos bidimensional simple
X, _ = make_blobs(n_samples=300, centers=4, cluster_std=0.60, random_state=0)
# Entrenar el modelo K-means
model = KMeans(n_clusters=4)
model.fit(X)
# Predecir los resultados de agrupamiento
y_kmeans = model.predict(X)
# Visualizar los resultados de agrupamiento
plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.show()
El gráfico de salida se muestra a continuación:
Análisis de componentes principales (PCA)
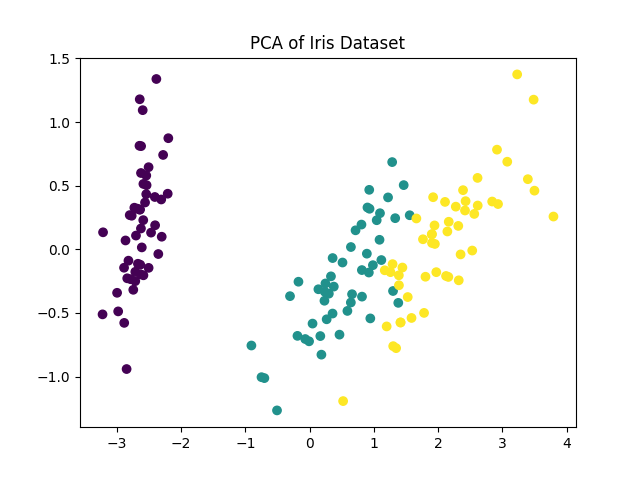
PCA es una técnica de reducción de dimensionalidad que transforma los datos a un nuevo sistema de coordenadas mediante una transformación lineal, de modo que la mayor parte de la varianza se concentra en los primeros componentes principales.
Escenarios de aplicación:Reducción de dimensionalidad de imágenes, selección de características, visualización de datos.
Uso de PCA para reducir la dimensionalidad y visualizar datos de alta dimensión:
Ejemplo
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt
# Cargar el conjunto de datos Iris
iris = load_iris()
X = iris.data
y = iris.target
# Reducir a 2 dimensiones
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)
# Visualizar el resultado
plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, cmap='viridis')
plt.title('PCA of Iris Dataset')
plt.show()
El gráfico de salida se muestra a continuación:
Algoritmos de aprendizaje automático
| Nombre completo en chino | Nombre completo en inglés | Abreviatura | Escenarios de aplicación principales |
|---|---|---|---|
| Algoritmos tradicionales de aprendizaje automático | |||
| Árbol de decisión | Decision Tree | DT | Clasificación, regresión, análisis de importancia de características |
| Bosque aleatorio | Random Forest | RF | Clasificación, regresión, detección de anomalías, selección de características |
| Regresión logística | Logistic Regression | LR | Tareas de clasificación binaria, predicción de probabilidades, puntuación de crédito |
| Máquina de vectores de soporte | Support Vector Machine | SVM | Clasificación, datos de alta dimensión con muestras pequeñas, clasificación de texto |
| Naive Bayes | Naive Bayes | NB | Clasificación de texto, detección de spam, análisis de sentimientos |
| Árbol de impulso de gradiente | Gradient Boosting Decision Tree | GBDT | Clasificación, regresión, tareas de ranking |
| Extreme Gradient Boosting | Extreme Gradient Boosting | XGBoost | Clasificación y regresión de alta precisión, tareas de nivel de competición, predicción de tasa de clics |
| Light Gradient Boosting Machine (LightGBM) | Light Gradient Boosting Machine | LightGBM | Clasificación y regresión con datos a gran escala, predicción en tiempo real, sistemas de recomendación |
| K vecinos más cercanos | K-Nearest Neighbor | KNN | Clasificación y regresión simples, sistemas de recomendación, detección de anomalías |
| Agrupamiento K-means | K-Means Clustering | K-Means | Agrupamiento de datos, segmentación de usuarios, segmentación de imágenes |
| Análisis de Componentes Principales | Principal Component Analysis | PCA | Reducción de dimensionalidad de datos, visualización de datos de alta dimensión, eliminación de ruido de características |
| Algoritmos de aprendizaje profundo | |||
| Red neuronal artificial | Artificial Neural Network | ANN | Clasificación y regresión simples, validación de modelos de referencia |
| Red neuronal convolucional | Convolutional Neural Network | CNN | Reconocimiento de imágenes, detección de objetos, análisis de video, diagnóstico de imágenes médicas |
| Red neuronal recurrente | Recurrent Neural Network | RNN | Procesamiento de datos secuenciales, generación de texto, reconocimiento de voz |
| Red de memoria a largo y corto plazo (LSTM) | Long Short-Term Memory | LSTM | Traducción de textos de secuencias largas, síntesis de voz, predicción de series temporales |
| Unidad recurrente con compuertas (GRU) | Gated Recurrent Unit | GRU | Clasificación de secuencias, análisis de sentimientos, sistemas de diálogo |
| Red generativa adversarial (GAN) | Generative Adversarial Network | GAN | Generación de imágenes, transferencia de estilo, aumento de datos, reconstrucción de superresolución |
| Transformador (Transformer) | Transformer | Transformer | Traducción de lenguaje natural, resumen de texto, tareas multimodales, arquitectura base de modelos grandes |
| Autoencoder | Autoencoder | AE | Compresión de datos, detección de anomalías, extracción de características |
| Autoencoder variacional (VAE) | Variational Autoencoder | VAE | Tareas generativas, reducción de ruido de datos, generación de imágenes |
| Red neuronal de grafos (GNN) | Graph Neural Network | GNN | Análisis de redes sociales, predicción de estructuras moleculares, razonamiento sobre grafos de conocimiento |