Support-Vektor-Maschine
Support Vector Machine (SVM) ist ein überwachter Lernalgorithmus, der hauptsächlich für Klassifikations- und Regressionsprobleme verwendet wird.
Die Kernidee von SVM ist, eine optimale Hyperebene zu finden, die Daten verschiedener Klassen trennt. Diese Hyperebene muss die Daten nicht nur korrekt klassifizieren, sondern auch den Abstand zwischen den beiden Klassen maximieren.
Hyperebene:
- Im zweidimensionalen Raum ist die Hyperebene eine Gerade.
- Im dreidimensionalen Raum ist die Hyperebene eine Ebene.
- In höherdimensionalen Räumen ist die Hyperebene eine Hyperebene, die den Raum teilt.
Stützvektoren:
- Stützvektoren sind die Stichprobenpunkte, die der Hyperebene am nächsten liegen. Diese Stützvektoren sind entscheidend für die Definition der Hyperebene.
- SVM wählt die optimale Hyperebene aus, indem der Abstand der Stützvektoren zur Hyperebene maximiert wird (d. h. der Margin maximiert wird).
Maximaler Margin:
- Das Ziel von SVM ist, den Klassifikations-Margin zu maximieren und die Entscheidungsgrenze so weit wie möglich von den beiden Klassen von Datenpunkten entfernt zu halten. Dadurch kann der Generalisierungsfehler des Modells effektiv reduziert werden.
Kernel-Trick:
- Für nicht linear trennbare Daten verwendet SVM Kernel-Funktionen, um die Daten in einen höherdimensionalen Raum abzubilden, in dem die Daten möglicherweise linear trennbar sind.
- Häufig verwendete Kernel-Funktionen umfassen: linearen Kernel, polynomialen Kernel, Radial-Basis-Funktion-(RBF)-Kernel usw.
SVM-Klassifikationsprozess
- Wählen Sie eine Hyperebene aus: Finden Sie eine Hyperebene, die den Klassifikationsrand maximiert.
- Trainieren Sie Stützvektoren: Wählen Sie mithilfe des SVM-Algorithmus die Beispielpunkte aus, die der Hyperebene am nächsten liegen, als Stützvektoren.
- Finden Sie die optimale Hyperebene durch Maximierung des Randes: Wählen Sie eine optimale Hyperebene aus, die den Rand maximiert.
- Verwenden Sie Kernel-Funktionen, um nichtlineare Probleme zu behandeln: Bilden Sie Daten mithilfe von Kernel-Funktionen in einen hochdimensionalen Raum ab, um Probleme der nichtlinearen Trennbarkeit zu lösen.
SVM mit Python implementieren
Als Nächstes verwenden wir Pythonsscikit-learnBibliothek zur Implementierung eines einfachen SVM-Klassifikators.
1. Erforderliche Bibliotheken installieren
Stellen Sie zunächst sicher, dass Sie die ... installiert habenscikit-learnBibliothek. Wenn sie nicht installiert ist, können Sie den folgenden Befehl verwenden, um sie zu installieren:
pip install scikit-learn
2. Bibliotheken importieren
Beispiel
import matplotlib.pyplot as plt
from sklearn import svm, datasets
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
3. Datensatz laden
Wir werden denscikit-learnintegrierten Iris-Datensatz.
Beispiel
iris = datasets.load_iris()
X = iris.data[:, :2] # Nur die ersten beiden Merkmale verwenden
y = iris.target
4. Trainings- und Testsets aufteilen
Beispiel
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
5. SVM-Modell trainieren
Beispiel
clf = svm.SVC(kernel='linear') # Lineare Kernel-Funktion verwenden
# Modell trainieren
clf.fit(X_train, y_train)
6. Vorhersage und Bewertung
Beispiel
y_pred = clf.predict(X_test)
# Genauigkeit berechnen
accuracy = accuracy_score(y_test, y_pred)
print(f"Modellgenauigkeit: {accuracy:.2f}")
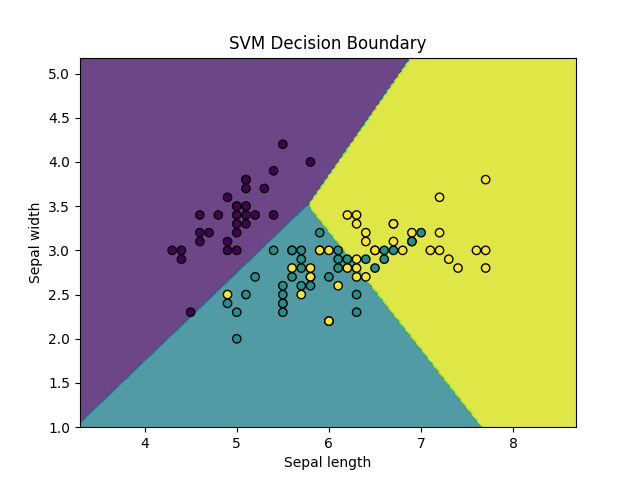
7. Ergebnisse visualisieren
Beispiel
import matplotlib.pyplot as plt
from sklearn import svm, datasets
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Laden des Iris-Datensatzes
iris = datasets.load_iris()
X = iris.data[:, :2] # Nur die ersten beiden Merkmale verwenden
y = iris.target
# Teile den Datensatz in Trainings- und Testsets auf
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# SVM-Klassifikator erstellen
clf = svm.SVC(kernel='linear') # Lineare Kernel-Funktion verwenden
# Modell trainieren
clf.fit(X_train, y_train)
# Vorhersagen auf dem Testset treffen
y_pred = clf.predict(X_test)
# Genauigkeit berechnen
accuracy = accuracy_score(y_test, y_pred)
print(f"Modellgenauigkeit: {accuracy:.2f}")
# Entscheidungsgrenze plotten
def plot_decision_boundary(X, y, model):
h = .02 # Gitter-Schrittweite
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
np.arange(y_min, y_max, h))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.8)
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o')
plt.xlabel('Kelchblattlänge')
plt.ylabel('Kelchblattbreite')
plt.title('SVM-Entscheidungsgrenze')
plt.show()
plot_decision_boundary(X_train, y_train, clf)
Führen Sie den obigen Code aus, die Ausgabe ist:
模型准确率: 0.80
Das Bild wird angezeigt als: