サポートベクターマシン
サポートベクターマシン(Support Vector Machine、略称SVM)は、主に分類と回帰問題に使用される教師あり学習アルゴリズムです。
SVMの核となる考え方は、異なるカテゴリのデータを分離する最適な超平面を見つけることです。この超平面はデータを正確に分類できるだけでなく、2つのクラス間のマージン(margin)を最大化する必要もあります。
超平面:
- 2次元空間では、超平面は直線です。
- 3次元空間では、超平面は平面です。
- より高次元の空間では、超平面は空間を分割する超平面です。
サポートベクター:
- サポートベクターは超平面に最も近いサンプル点です。これらのサポートベクターは超平面を定義するために非常に重要です。
- サポートベクターマシンは、サポートベクターから超平面までの距離を最大化(つまりマージンを最大化)することによって、最適な超平面を選択します。
最大マージン:
- SVMの目標は分類マージンを最大化し、分類境界を2つのクラスのデータ点からできるだけ遠ざけることです。これによりモデルの汎化誤差を効果的に減らすことができます。
カーネルトリック(Kernel Trick):
- 非線形分離可能なデータに対して、SVMはカーネル関数を使用してデータをより高次元の空間にマッピングします。この空間では、データは線形分離可能になる場合があります。
- 一般的に使用されるカーネル関数には、線形カーネル、多項式カーネル、動径基底関数(RBF)カーネルなどがあります。
SVM分類の流れ
- 超平面を選択する:分類境界を最大化できる超平面を見つけます。
- サポートベクターを訓練する:サポートベクターマシンアルゴリズムによって、超平面に最も近いサンプル点をサポートベクターとして選択します。
- マージンを最大化して最適な超平面を見つける:マージンが最大化されるように最適な超平面を選択します。
- カーネル関数を使用して非線形問題を処理する:カーネル関数によってデータを高次元空間にマッピングし、非線形分離問題を解決します。
PythonでSVMを実装する
次に、Pythonのscikit-learnライブラリを使用して、簡単なSVM分類器を実装します。
1. 必要なライブラリをインストールする
まず、あなたがインストールしていることを確認してくださいscikit-learnライブラリ。インストールされていない場合は、次のコマンドでインストールできます:
pip install scikit-learn
2. ライブラリをインポートする
例
import numpy as np
import matplotlib.pyplot as plt
from sklearn import svm, datasets
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
import matplotlib.pyplot as plt
from sklearn import svm, datasets
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
3. データセットを読み込む
使用するのはscikit-learn組み込みのアヤメ(Iris)データセットです。
例
# アヤメのデータセットを読み込む
iris = datasets.load_iris()
X = iris.data[:, :2] # 最初の2つの特徴量のみを使用
y = iris.target
iris = datasets.load_iris()
X = iris.data[:, :2] # 最初の2つの特徴量のみを使用
y = iris.target
4. トレーニングセットとテストセットに分割する
例
# データセットをトレーニングセットとテストセットに分割する
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
5. SVMモデルを訓練する
例
# SVM分類器を作成
clf = svm.SVC(kernel='linear') # 線形カーネル関数を使用
# モデルを訓練
clf.fit(X_train, y_train)
clf = svm.SVC(kernel='linear') # 線形カーネル関数を使用
# モデルを訓練
clf.fit(X_train, y_train)
6. 予測と評価
例
# テストセットで予測を実行
y_pred = clf.predict(X_test)
# 正解率を計算
accuracy = accuracy_score(y_test, y_pred)
print(f"モデル正解率: {accuracy:.2f}")
y_pred = clf.predict(X_test)
# 正解率を計算
accuracy = accuracy_score(y_test, y_pred)
print(f"モデル正解率: {accuracy:.2f}")
7. 結果の可視化
例
import numpy as np
import matplotlib.pyplot as plt
from sklearn import svm, datasets
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# アヤメのデータセットを読み込む
iris = datasets.load_iris()
X = iris.data[:, :2] # 最初の2つの特徴量のみを使用
y = iris.target
# データセットをトレーニングセットとテストセットに分割する
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# SVM分類器を作成
clf = svm.SVC(kernel='linear') # 線形カーネル関数を使用
# モデルを訓練
clf.fit(X_train, y_train)
# テストセットで予測を実行
y_pred = clf.predict(X_test)
# 正解率を計算
accuracy = accuracy_score(y_test, y_pred)
print(f"モデル正解率: {accuracy:.2f}")
# 決定境界を描画
def plot_decision_boundary(X, y, model):
h = .02 # グリッドのステップ幅
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
np.arange(y_min, y_max, h))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.8)
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o')
plt.xlabel('Sepal length')
plt.ylabel('Sepal width')
plt.title('SVM Decision Boundary')
plt.show()
plot_decision_boundary(X_train, y_train, clf)
import matplotlib.pyplot as plt
from sklearn import svm, datasets
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# アヤメのデータセットを読み込む
iris = datasets.load_iris()
X = iris.data[:, :2] # 最初の2つの特徴量のみを使用
y = iris.target
# データセットをトレーニングセットとテストセットに分割する
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# SVM分類器を作成
clf = svm.SVC(kernel='linear') # 線形カーネル関数を使用
# モデルを訓練
clf.fit(X_train, y_train)
# テストセットで予測を実行
y_pred = clf.predict(X_test)
# 正解率を計算
accuracy = accuracy_score(y_test, y_pred)
print(f"モデル正解率: {accuracy:.2f}")
# 決定境界を描画
def plot_decision_boundary(X, y, model):
h = .02 # グリッドのステップ幅
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
np.arange(y_min, y_max, h))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.8)
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o')
plt.xlabel('Sepal length')
plt.ylabel('Sepal width')
plt.title('SVM Decision Boundary')
plt.show()
plot_decision_boundary(X_train, y_train, clf)
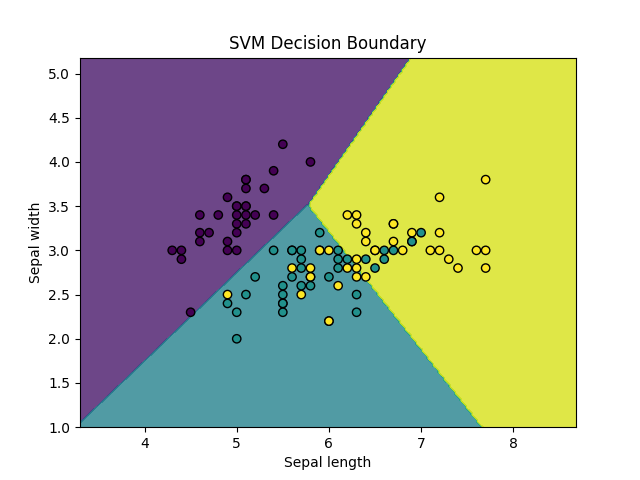
上記のコードを実行すると、出力は次のようになります:
模型准确率: 0.80
画像は次のように表示されます: