Машинное обучение — Путь обучения
Машинное обучение — одна из самых актуальных технических областей сегодня; оно позволяет компьютерам учиться на данных и делать прогнозы или принимать решения.
Начинающие, сталкиваясь с огромным множеством алгоритмов, математических теорий и инструментов программирования, легко могут растеряться и не знать, с чего начать.
В этой статье будет представлена дорожная карта машинного обучения от нулевого уровня до практических навыков.
| Машинное обучение — список курсов | |
|---|---|
| Базовое введение | |
| Базовое введение | Учебник по машинному обучению |
| Базовое введение | Введение в машинное обучение |
| Базовое введение | Жизненный цикл машинного обучения |
| Базовое введение | Как работает машинное обучение |
| Базовое введение | Основные термины машинного обучения |
| Базовое введение | Введение в машинное обучение с Python |
| Базовое введение | Библиотеки машинного обучения Python |
| Базовое введение | Распространённые типы данных |
| Базовое введение | Применения машинного обучения |
| Обработка данных и статистика | |
| Обработка данных и статистика | Понимание данных |
| Обработка данных и статистика | Очистка данных |
| Обработка данных и статистика | Инженерия признаков |
| Обработка данных и статистика | Визуализация данных |
| Обработка данных и статистика | Разделение на обучающую и тестовую выборки |
| Обработка данных и статистика | Основы статистики |
| Обработка данных и статистика | Вероятностное мышление |
| Обработка данных и статистика | Функции потерь и градиенты |
| Обработка данных и статистика | Переобучение, недообучение, смещение и дисперсия |
| Обучение с учителем | |
| Обучение с учителем | Алгоритмы машинного обучения |
| Обучение с учителем | Линейная регрессия |
| Обучение с учителем | Множественная линейная регрессия |
| Обучение с учителем | Полиномиальная регрессия |
| Обучение с учителем | Логистическая регрессия |
| Обучение с учителем | Оценка регрессионной модели |
| Обучение с учителем | Дерево решений |
| Обучение с учителем | Машина опорных векторов (SVM) |
| Обучение с учителем | K-ближайших соседей (KNN) |
| Обучение с учителем | Ансамблевое обучение |
| Обучение с учителем | Наивный Байес |
| Обучение с учителем | Случайный лес |
| Обучение с учителем | Метрики классификации |
| Обучение без учителя | |
| Обучение без учителя | Кластеризация |
| Обучение без учителя | Снижение размерности |
| Обучение с подкреплением | |
| Обучение с подкреплением | Базовые основы обучения с подкреплением |
| Обучение с подкреплением | Обучение с подкреплением: исследование против использования |
| Обучение с подкреплением | Обучение с подкреплением: Q-Learning и SARSA |
| Обучение с подкреплением | Глубокое обучение с подкреплением |
| Глубокое обучение | |
| Глубокое обучение | Базовая структура нейронных сетей |
| Глубокое обучение | Прямое и обратное распространение |
| Глубокое обучение | Глубокое обучение против традиционного машинного обучения |
| Глубокое обучение | Распространённые типы сетей |
| Оптимизация и инжиниринг моделей | |
| Оптимизация и инжиниринг моделей | Кросс-валидация |
| Оптимизация и инжиниринг моделей | Регуляризация |
| Оптимизация и инжиниринг моделей | Утечка данных |
| Оптимизация и инжиниринг моделей | Ансамблевые методы |
| Оптимизация и инжиниринг моделей | Поиск гиперпараметров |
| Оптимизация и инжиниринг моделей | Концепции MLOps |
| Оптимизация и инжиниринг моделей | Общие советы по устранению неполадок |
| Ограничения и границы машинного обучения | |
| Ограничения и границы машинного обучения | Проблемы интерпретируемости |
| Ограничения и границы машинного обучения | Ограничения предположений |
| Ограничения и границы машинного обучения | Смещение данных |
| Ограничения и границы машинного обучения | Реальная стоимость моделей |
| Практические примеры | |
| Практические примеры | Прогнозирование выживания на Титанике |
| Практические примеры | Прогнозирование цен на дома |
| Практические примеры | Сегментация клиентов |
| Практические примеры | Визуализация PCA |
| Практические примеры | Пример обучения с подкреплением |
Этап 1: Основы — построение прочной базы
Прежде чем погружаться в сложные алгоритмы, нужно сначала заложить фундамент, на котором держится здание знаний. Цель этого этапа — освоить необходимые навыки в математике, программировании и анализе данных.
Ключевой навык 1: язык программирования (Python)
Python — общепринятый язык машинного обучения, его выбирают за чистый синтаксис и богатую экосистему библиотек.
Цели обучения: освоить базовый синтаксис Python, структуры данных, функции и объектно-ориентированное программирование.
Ключевые библиотеки:
NumPy: используется для эффективных численных вычислений; это основа почти всех библиотек научных вычислений.Pandas: используется для очистки, анализа и обработки данных; мощный инструмент для работы с таблицами данных (DataFrames).Matplotlib/Seaborn: Используется для визуализации данных, чтобы преобразовывать данные в наглядные диаграммы.
Далее мы можем рассмотреть пример.
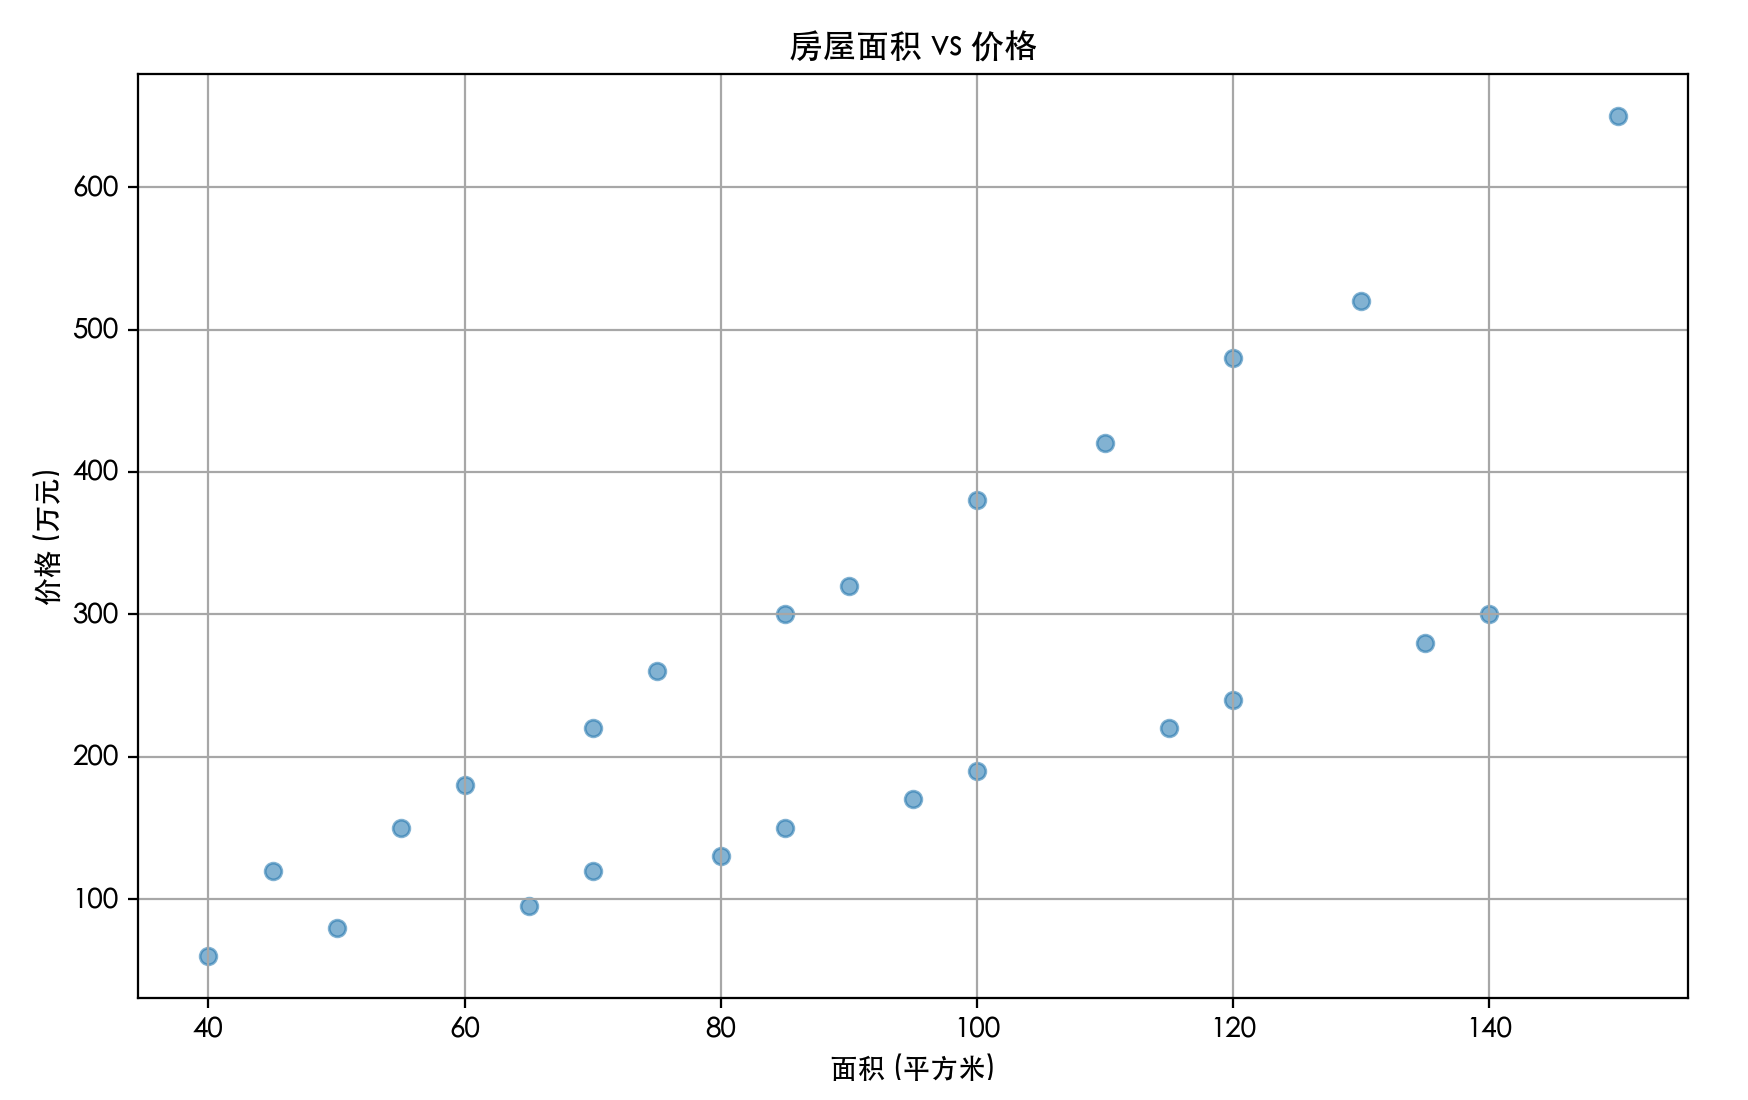
Содержимое файла тестовых данных house_prices.csv:
面积,价格,房龄,卧室数,城市
45,120,15,1,北京
60,180,12,2,北京
75,260,8,2,北京
90,320,6,3,北京
110,420,5,3,北京
130,520,3,4,北京
50,80,20,1,成都
70,120,15,2,成都
85,150,12,3,成都
100,190,10,3,成都
120,240,8,4,成都
140,300,5,4,成都
55,150,18,1,上海
70,220,14,2,上海
85,300,10,2,上海
100,380,8,3,上海
120,480,6,3,上海
150,650,4,4,上海
40,60,22,1,武汉
65,95,16,2,武汉
80,130,12,2,武汉
95,170,9,3,武汉
115,220,7,3,武汉
135,280,5,4,武汉
Пример
import pandas as pd
import matplotlib.pyplot as plt
# -------------------------- Начало настройки китайского шрифта --------------------------
plt.rcParams['font.sans-serif'] = [
# Сначала Windows
'SimHei', 'Microsoft YaHei',
# Сначала macOS
'PingFang SC', 'Heiti TC',
# Сначала Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Исправить проблему отображения отрицательных знаков в виде квадратов
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Конец настройки китайского шрифта --------------------------
# 1. Чтение данных
data = pd.read_csv('house_prices.csv')
print("Первые 5 строк данных:")
print(data.head())
# 2. Просмотр базовой информации о данных
print("\nИнформация о данных:")
print(data.info())
# 3. Построение диаграммы рассеяния площади дома и цены
plt.figure(figsize=(10, 6))
plt.scatter(data['Area'], data['Price'], альфа=0.5)
plt.title('Площадь дома и цена')
plt.xlabel('Площадь (square meters)')
plt.ylabel('Цена (10,000 yuan)')
plt.grid(True)
plt.show()
"После выполнения итоговый график выглядит следующим образом:"
Ключевой навык 2: Основные математические знания
Вам не нужно становиться математиком, но нужно понимать базовую логику, лежащую в основе алгоритмов.
- Линейная алгебра: Понимание векторов, матриц и умножения матриц. Это основа для понимания того, как данные представляются и преобразуются в многомерном пространстве.
- Математический анализ: Основное внимание уделяется пониманию понятий производных и частных производных. Они являются ядром алгоритмов оптимизации (таких как градиентный спуск), используемых для поиска наилучших параметров модели.
- Теория вероятностей и статистика: Понимание среднего, дисперсии, стандартного отклонения, распределений вероятностей, условной вероятности и теоремы Байеса. Это критически важно для оценки моделей и понимания неопределённости.
Аналогия: Представьте модель машинного обучения как сложныймикшерный пульт. Математические знания — это руководство, которое помогает понять, как каждая ручка (параметр) влияет на конечный звук (результат прогноза). Без руководства вы можете только слепо крутить ручки.
Этап 2: Начало работы — освойте классические алгоритмы
Имея прочную основу, вы можете начать исследовать ядро машинного обучения — алгоритмы. Рекомендуется начать с самых классических и интуитивно понятных алгоритмов.
Введение в обучение с учителем
Обучение с учителем означает обучение моделей на данных с существующими метками.
- Линейная регрессия: Прогнозирует непрерывные значения (например, цены на дома). Разберитесь с её функцией стоимости и процессом оптимизации методом градиентного спуска.
- Логистическая регрессия: Решает задачи классификации (например, определение, является ли письмо спамом). Разберитесь с сигмоидной функцией и решающей границей.
- Метод K ближайших соседей (K-NN): Простой алгоритм классификации/регрессии на основе экземпляров.
- Дерево решений: Моделирует процесс принятия решений человеком, очень интуитивно и легко для понимания.
Введение в обучение без учителя
Обучение без учителя используется для обнаружения внутренних структур и закономерностей в данных.
- Кластеризация методом K-средних: Автоматически группирует данные в K кластеров.
- Метод главных компонент (PCA): Используется для снижения размерности и визуализации, извлекая наиболее важные признаки.
Обновление инструментов: На этом этапе начните систематически использоватьscikit-learnбиблиотеку. Она предоставляет унифицированный API, позволяющий быстро реализовывать, сравнивать и оценивать различные алгоритмы.
Пример
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, classification_report
# =========================
# 1. Создайте запускаемые тестовые данные
#: сдадите ли вы экзамен (1=сдал, 0=не сдал)
# Признаки: время учёбы, посещаемость, процент выполнения домашних заданий
# =========================
X = np.array([
[2, 60, 50],
[3, 65, 55],
[4, 70, 65],
[5, 75, 70],
[6, 80, 75],
[7, 85, 80],
[8, 90, 85],
[9, 92, 88],
[10, 95, 90],
[11, 97, 92],
[1, 50, 40],
[2, 55, 45],
[3, 60, 50],
[4, 65, 55],
[5, 70, 60],
[6, 75, 65],
[7, 80, 70],
[8, 85, 75],
[9, 90, 80],
[10, 95, 85]
])
y = np.array([
0, 0, 0, 0, 1,
1, 1, 1, 1, 1,
0, 0, 0, 0, 0,
1, 1, 1, 1, 1
])
# =========================
# 2. Разделите данные на обучающую и тестовую выборки
# =========================
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.3, random_state=42
)
# =========================
# 3. Создайте и обучите модель
# =========================
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)
# =========================
# 4. Сделайте прогнозы
# =========================
y_pred = model.predict(X_test)
# =========================
# 5. Оцените качество модели
# =========================
print(f"Точность модели: {accuracy_score(y_test, y_pred):.2f}")
print("\nПодробный отчёт о классификации:")
print(classification_report(y_test, y_pred))
Вывод:
模型准确率:0.83

详细分类报告:
              precision    recall  f1-score   support

           0       0.67      1.00      0.80         2
           1       1.00      0.75      0.86         4

    accuracy                           0.83         6
   macro avg       0.83      0.88      0.83         6
weighted avg       0.89      0.83      0.84         6
Этап 3: Продвинутый уровень - Погружение в ключевые области
Освоив классические алгоритмы, вы можете перейти к более современным и мощным областям.
Глубокое погружение в традиционное машинное обучение
- Ансамблевое обучение: Узнайте, как объединять несколько слабых моделей для создания сильной модели.
- Случайный лес: Ансамбль из множества решающих деревьев, обладающий высокой устойчивостью к переобучению.
- Градиентный бустинг над деревьями (например, XGBoost, LightGBM): Высокопроизводительные алгоритмы, чрезвычайно популярные в соревнованиях и индустрии.
- Машина опорных векторов (SVM): Поймите её основную идею максимизации «зазора».
- Оценка и оптимизация модели: Глубоко изучите кросс-валидацию, настройку гиперпараметров (например, GridSearchCV) и методы решения проблем переобучения/недообучения.
Шаг в глубокое обучение
Когда данные (особенно изображения, текст и речь) становятся сложными, глубокое обучение начинает демонстрировать свои мощные возможности.
- Основы нейронных сетей: Поймите нейроны, функции активации, прямое распространение, обратное распространение и функции потерь.
- Фреймворки глубокого обучения: Выберите
PyTorch(удобный для исследований, гибкий) илиTensorFlow/Keras(зрелая производственная среда, полная экосистема), и глубоко изучите один из них. - Свёрточная нейронная сеть (CNN): стандарт для обработки изображений; понимание ролей свёрточных слоёв и слоёв пулинга.
- Рекуррентная нейронная сеть (RNN) и сеть долгой краткосрочной памяти (LSTM): мощные инструменты для обработки последовательных данных (например, текста, временных рядов).
Пример
from tensorflow import keras
from tensorflow.keras import layers
model = keras.Sequential([
layers.Dense(64, activation='relu', input_shape=(input_dim,)), # Скрытый слой 1
layers.Dropout(0.2), # Слой Dropout для предотвращения переобучения
layers.Dense(32, activation='relu'), # Скрытый слой 2
layers.Dense(1, activation='sigmoid') # Выходной слой для бинарной классификации
])
model.compile(optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy'])
model.summary() # Вывести структуру модели
# После этого вы можете использовать model.fit для обучения
Этап 4: Применение и расширение — фокус на направлениях, решение реальных задач
Машинное обучение имеет много ветвей; на этом этапе вам нужно выбрать направление для углублённого изучения, исходя из ваших интересов или карьерных планов.
Выбор основного направления
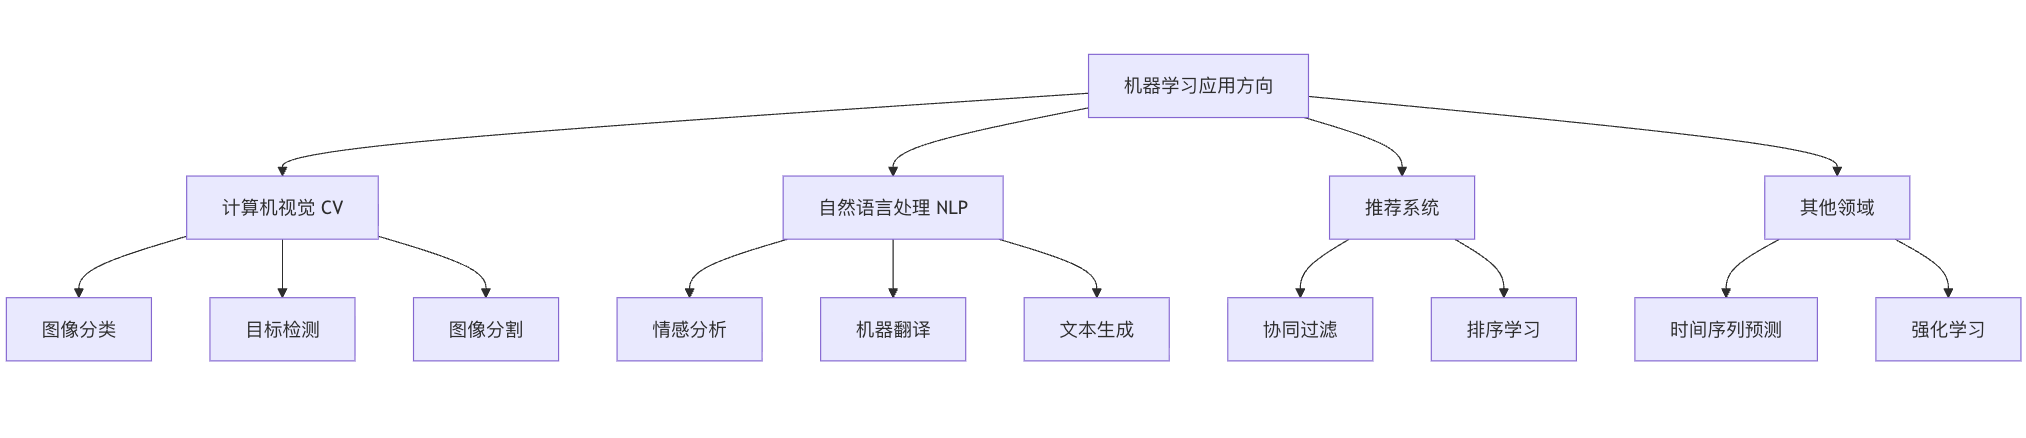
- Компьютерное зрение (CV): углублённое изучение вариантов CNN (ResNet, YOLO), изучение сегментации изображений и обнаружения объектов.
- Обработка естественного языка (NLP): от word embeddings (Word2Vec) до архитектуры Transformer (BERT, GPT), освоение классификации текста, анализа тональности и машинного перевода.
- Рекомендательные системы: изучите коллаборативную фильтрацию, матричную факторизацию и рекомендательные модели на основе глубокого обучения.
- Обучение с подкреплением: позволяет агенту изучать оптимальные стратегии путём взаимодействия со средой; это основа игрового ИИ и управления роботами.
Инженерия и развёртывание
Научитесь развёртывать обученные модели в продуктивных средах и предоставлять реальные сервисы.
- Сохранение и загрузка модели(
pickle,joblib,.h5файл). - Используйте Flask/FastAPI для создания простого API-сервиса。
- Поймите контейнеризацию Dockerи базовые концепции облачных сервисов (например, AWS SageMaker, Google AI Platform).
Итоги и рекомендации по ресурсам
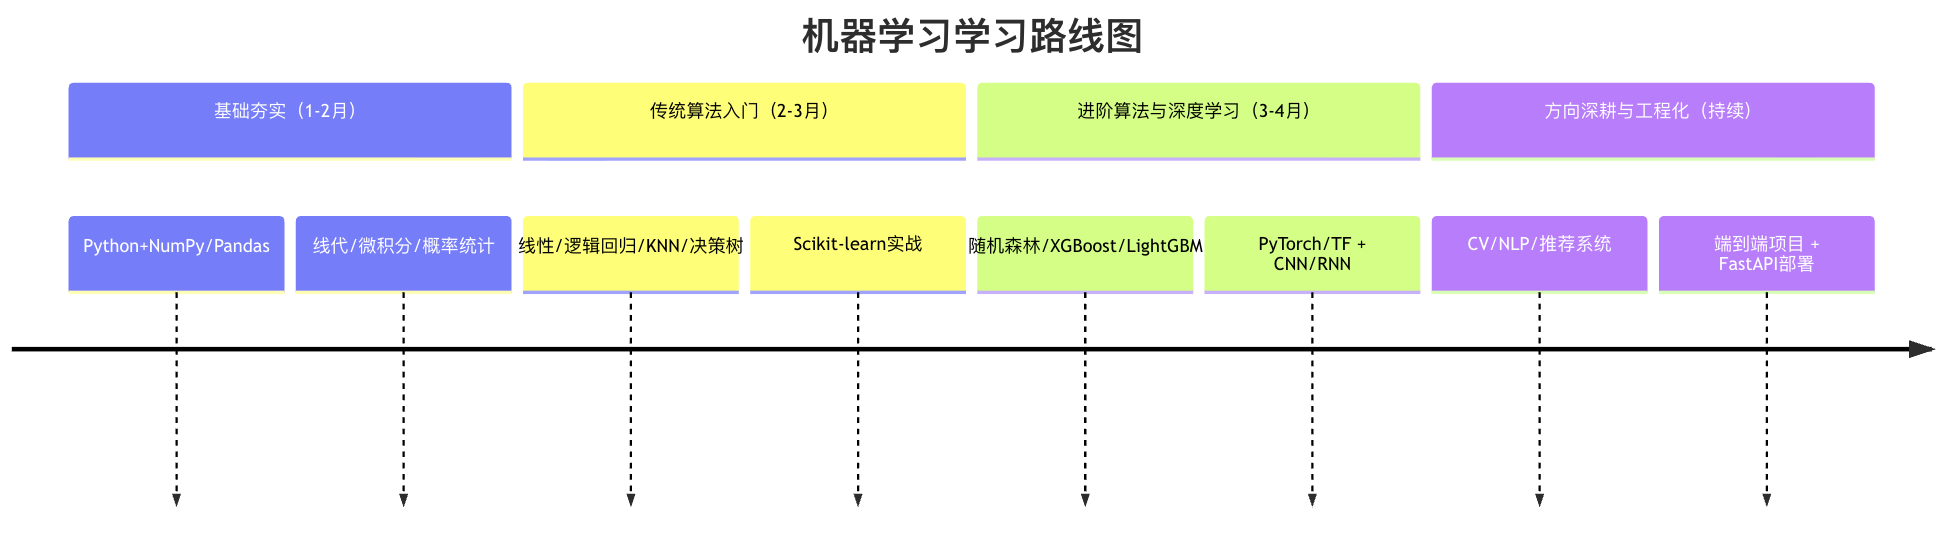
Визуализация пути обучения
Практика — единственный короткий путь
Самый важный совет:Учитесь на практике, через проекты!
- Имитируйте: воспроизводите проекты из руководств и статей.
- Практикуйтесь: участвуйте в соревнованиях начального уровня на таких платформах, как Kaggle и Tianchi.
- Создавайте: попробуйте использовать машинное обучение, чтобы решить небольшую задачу, которая вам лично интересна (например, анализ ваших данных о тренировках, автоматическая классификация вашей коллекции фотографий).
Рекомендации по качественным ресурсам
- Классические курсы: «Машинное обучение» Эндрю Ына (Coursera), «Погружение в глубокое обучение» Му Ли.
- Платформы для практики: Kaggle (соревнования и наборы данных), Colab / Jupyter Notebook (бесплатная облачная среда).
- Закрепление знаний: Читайте
scikit-learn、PyTorchофициальную документацию, и общайтесь на Stack Overflow и в связанных форумных сообществах.