Maschinelles Lernen - Lernpfad
Maschinelles Lernen ist heute eines der angesagtesten technischen Gebiete; es ermöglicht Computern, aus Daten zu lernen und Vorhersagen oder Entscheidungen zu treffen.
Für Anfänger, die mit einer Vielzahl von Algorithmen, mathematischen Theorien und Programmierwerkzeugen konfrontiert sind, ist es leicht, verwirrt zu sein und nicht zu wissen, wo man anfangen soll.
Dieser Artikel stellt eine Roadmap für maschinelles Lernen von null Grundlagen bis zur praktischen Anwendungsfähigkeit vor.
| Maschinelles Lernen - Kursliste | |
|---|---|
| Grundlegende Einführung | |
| Grundlegende Einführung | Tutorial für maschinelles Lernen |
| Grundlegende Einführung | Einführung in das maschinelle Lernen |
| Grundlegende Einführung | Lebenszyklus des maschinellen Lernens |
| Grundlegende Einführung | Wie maschinelles Lernen funktioniert |
| Grundlegende Einführung | Grundlegende Terminologie des maschinellen Lernens |
| Grundlegende Einführung | Einführung in maschinelles Lernen mit Python |
| Grundlegende Einführung | Python-Bibliotheken für maschinelles Lernen |
| Grundlegende Einführung | Gängige Datentypen |
| Grundlegende Einführung | Anwendungen des maschinellen Lernens |
| Datenverarbeitung und Statistik | |
| Datenverarbeitung und Statistik | Datenverständnis |
| Datenverarbeitung und Statistik | Datenbereinigung |
| Datenverarbeitung und Statistik | Feature-Engineering |
| Datenverarbeitung und Statistik | Datenvisualisierung |
| Datenverarbeitung und Statistik | Train-Test-Aufteilung |
| Datenverarbeitung und Statistik | Grundlagen der Statistik |
| Datenverarbeitung und Statistik | Probabilistisches Denken |
| Datenverarbeitung und Statistik | Verlustfunktionen und Gradienten |
| Datenverarbeitung und Statistik | Overfitting, Underfitting, Bias und Varianz |
| Überwachtes Lernen | |
| Überwachtes Lernen | Algorithmen für maschinelles Lernen |
| Überwachtes Lernen | Lineare Regression |
| Überwachtes Lernen | Multiple lineare Regression |
| Überwachtes Lernen | Polynomielle Regression |
| Überwachtes Lernen | Logistische Regression |
| Überwachtes Lernen | Evaluierung von Regressionsmodellen |
| Überwachtes Lernen | Entscheidungsbaum |
| Überwachtes Lernen | Support-Vektor-Maschine (SVM) |
| Überwachtes Lernen | K-Nächste-Nachbarn (KNN) |
| Überwachtes Lernen | Ensemble-Lernen |
| Überwachtes Lernen | Naive Bayes |
| Überwachtes Lernen | Random Forest |
| Überwachtes Lernen | Klassifikationsmetriken |
| Unüberwachtes Lernen | |
| Unüberwachtes Lernen | Clustering |
| Unüberwachtes Lernen | Dimensionsreduktion |
| Bestärkendes Lernen | |
| Bestärkendes Lernen | Grundgerüst des bestärkenden Lernens |
| Bestärkendes Lernen | Bestärkendes Lernen: Exploration vs. Exploitation |
| Bestärkendes Lernen | Bestärkendes Lernen: Q-Learning und SARSA |
| Bestärkendes Lernen | Deep Reinforcement Learning |
| Deep Learning | |
| Deep Learning | Grundstruktur neuronaler Netze |
| Deep Learning | Vorwärtspropagation und Backpropagation |
| Deep Learning | Deep Learning vs. traditionelles maschinelles Lernen |
| Deep Learning | Gängige Netzwerktypen |
| Modelloptimierung und Engineering | |
| Modelloptimierung und Engineering | Kreuzvalidierung |
| Modelloptimierung und Engineering | Regularisierung |
| Modelloptimierung und Engineering | Datenleck |
| Modelloptimierung und Engineering | Ensemble-Methoden |
| Modelloptimierung und Engineering | Hyperparametersuche |
| Modelloptimierung und Engineering | MLOps-Konzepte |
| Modelloptimierung und Engineering | Allgemeine Fehlerbehebung |
| Grenzen und Beschränkungen des maschinellen Lernens | |
| Grenzen und Beschränkungen des maschinellen Lernens | Probleme der Interpretierbarkeit |
| Grenzen und Beschränkungen des maschinellen Lernens | Einschränkungen der Annahmen |
| Grenzen und Beschränkungen des maschinellen Lernens | Datenverzerrung |
| Grenzen und Beschränkungen des maschinellen Lernens | Reale Kosten von Modellen |
| Praktische Beispiele | |
| Praktische Beispiele | Titanic-Überlebensvorhersage |
| Praktische Beispiele | Vorhersage von Hauspreisen |
| Praktische Beispiele | Kundensegmentierung |
| Praktische Beispiele | PCA-Visualisierung |
| Praktische Beispiele | Beispiel für bestärkendes Lernen |
Phase 1: Grundlagen - Eine solide Basis aufbauen
Bevor Sie in komplexe Algorithmen eintauchen, müssen Sie zuerst das Fundament legen, das das Gebäude des Wissens trägt. Das Ziel dieser Phase ist es, die notwendigen Fähigkeiten in Mathematik, Programmierung und Datenanalyse zu beherrschen.
Kernkompetenz 1: Programmiersprache (Python)
Python ist die Lingua franca des maschinellen Lernens und wird für seine saubere Syntax und sein reichhaltiges Ökosystem an Bibliotheken geschätzt.
Lernziele: Python-Grundsyntax, Datenstrukturen, Funktionen und objektorientierte Programmierung beherrschen.
Wichtige Bibliotheken:
NumPy: Wird für effiziente numerische Berechnungen verwendet; es ist die Grundlage für nahezu alle Bibliotheken für wissenschaftliches Rechnen.Pandas: Wird für Datenbereinigung, -analyse und -verarbeitung verwendet; ein leistungsstarkes Werkzeug zur Manipulation von Datentabellen (DataFrames).Matplotlib/Seaborn: Wird zur Datenvisualisierung verwendet, um Daten in intuitive Diagramme umzuwandeln.
Als Nächstes können wir uns ein Beispiel ansehen.
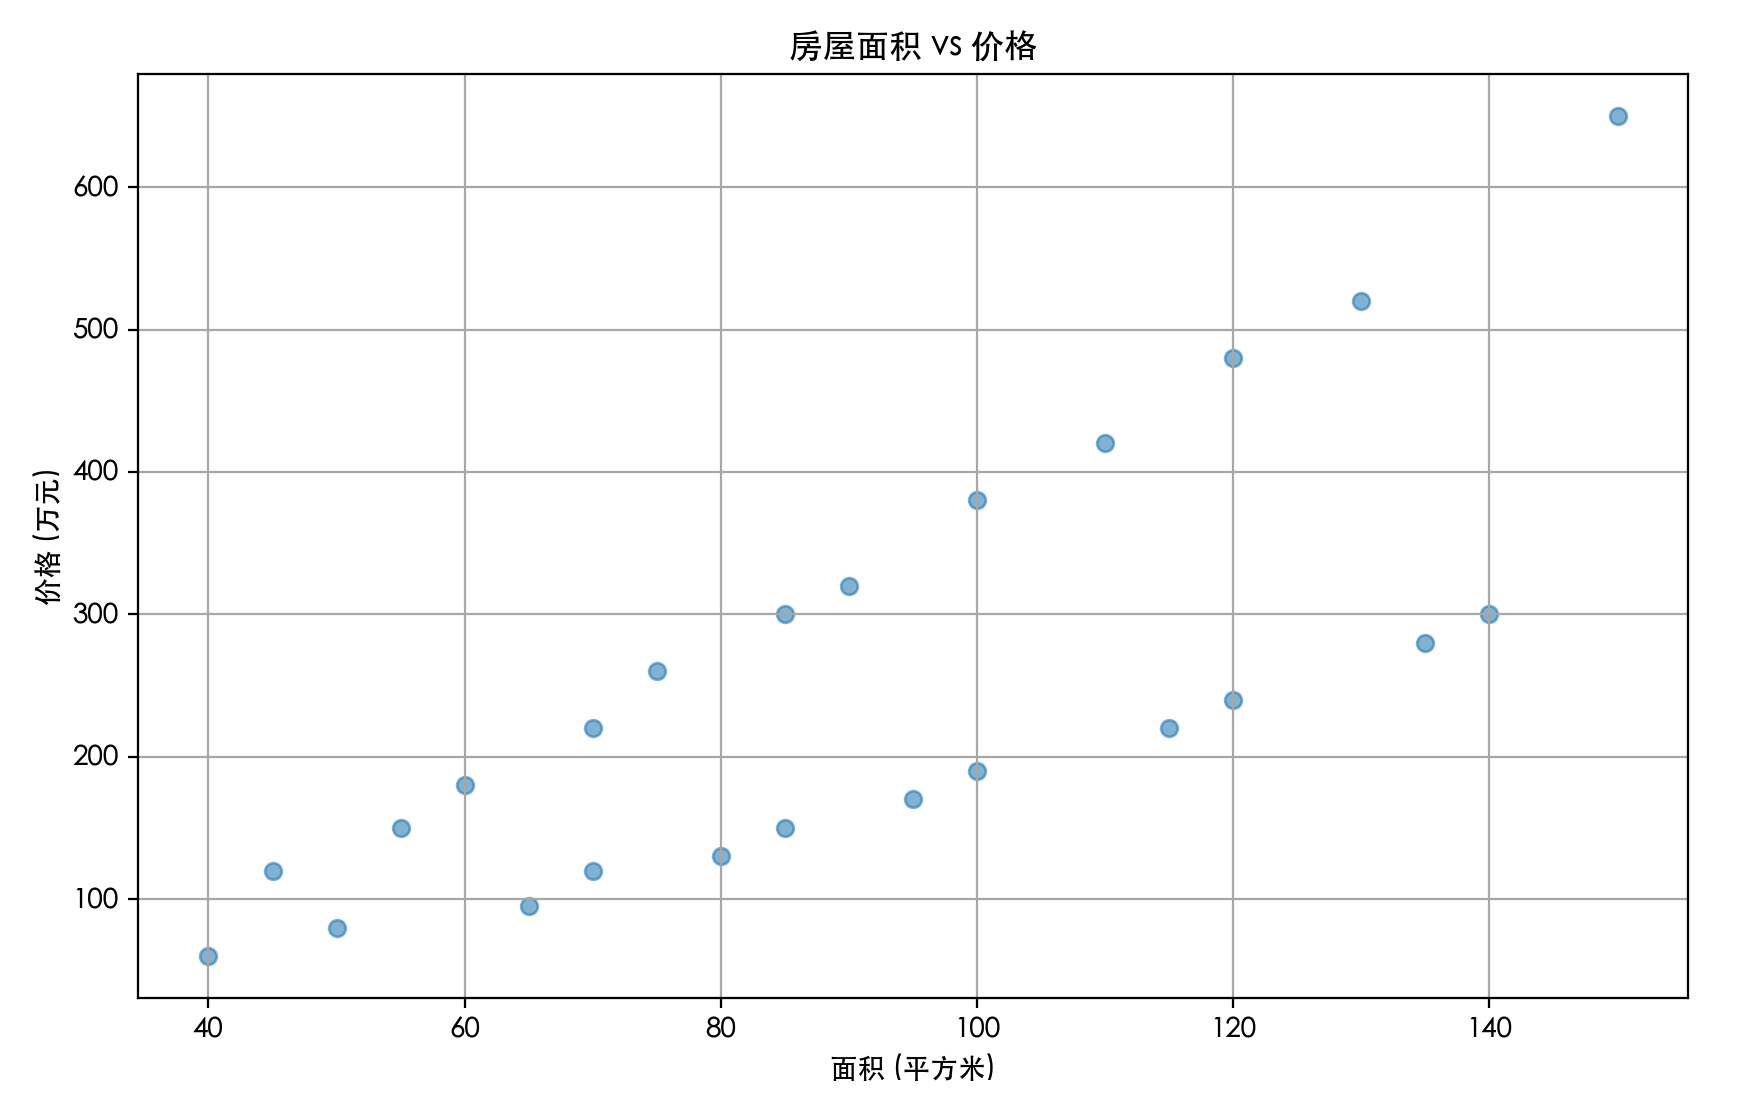
Inhalt der Testdatendatei house_prices.csv:
面积,价格,房龄,卧室数,城市
45,120,15,1,北京
60,180,12,2,北京
75,260,8,2,北京
90,320,6,3,北京
110,420,5,3,北京
130,520,3,4,北京
50,80,20,1,成都
70,120,15,2,成都
85,150,12,3,成都
100,190,10,3,成都
120,240,8,4,成都
140,300,5,4,成都
55,150,18,1,上海
70,220,14,2,上海
85,300,10,2,上海
100,380,8,3,上海
120,480,6,3,上海
150,650,4,4,上海
40,60,22,1,武汉
65,95,16,2,武汉
80,130,12,2,武汉
95,170,9,3,武汉
115,220,7,3,武汉
135,280,5,4,武汉
Beispiel
import pandas as pd
import matplotlib.pyplot as plt
# -------------------------- Chinesische Schriftart festlegen Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows zuerst
'SimHei', 'Microsoft YaHei',
# macOS zuerst
'PingFang SC', 'Heiti TC',
# Linux zuerst
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Problem beheben, dass Minuszeichen als Quadrate angezeigt werden
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
# 1. Daten lesen
data = pd.read_csv('house_prices.csv')
print("Erste 5 Datenzeilen:")
print(data.head())
# 2. Grundlegende Dateninformationen anzeigen
print("\nDateninfo:")
print(data.info())
# 3. Ein Streudiagramm für Wohnfläche und Preis zeichnen
plt.figure(figsize=(10, 6))
plt.scatter(data['Area'], data['Price'], Alpha=0.5)
plt.title('Wohnfläche vs. Preis')
plt.xlabel('Fläche (square meters)')
plt.ylabel('Preis (10,000 yuan)')
plt.grid(True)
plt.show()
"Nach der Ausführung sieht das Ausgabediagramm wie folgt aus:"
Kernkompetenz 2: Grundlegendes mathematisches Wissen
Sie müssen kein Mathematiker werden, aber Sie müssen die grundlegende Logik hinter den Algorithmen verstehen.
- Lineare Algebra: Verstehen Sie Vektoren, Matrizen und Matrixmultiplikation. Dies ist die Grundlage für das Verständnis, wie Daten im mehrdimensionalen Raum dargestellt und transformiert werden.
- Analysis: Der Schwerpunkt liegt auf dem Verständnis der Konzepte von Ableitungen und partiellen Ableitungen. Sie sind der Kern von Optimierungsalgorithmen (wie Gradientenabstieg), die verwendet werden, um die besten Parameter für ein Modell zu finden.
- Wahrscheinlichkeitsrechnung und Statistik: Verstehen Sie Mittelwert, Varianz, Standardabweichung, Wahrscheinlichkeitsverteilungen, bedingte Wahrscheinlichkeit und den Satz von Bayes. Dies ist entscheidend für die Bewertung von Modellen und das Verständnis von Unsicherheit.
Analogie: Stellen Sie sich ein Machine-Learning-Modell als ein komplexesMischpultvor. Mathematisches Wissen ist das Handbuch, das Ihnen hilft zu verstehen, wie jeder Regler (Parameter) den endgültigen Klang (Vorhersageergebnis) beeinflusst. Ohne das Handbuch können Sie nur blind herumprobieren.
Phase 2: Erste Schritte – Klassische Algorithmen beherrschen
Mit einem soliden Fundament können Sie beginnen, den Kern des maschinellen Lernens zu erkunden – die Algorithmen. Es wird empfohlen, mit den klassischsten und intuitivsten Algorithmen zu beginnen.
Einführung in das überwachte Lernen
Überwachtes Lernen bedeutet, Modelle mit Daten mit vorhandenen Labels zu trainieren.
- Lineare Regression: Kontinuierliche Werte vorhersagen (z. B. Hauspreise). Verstehe ihre Kostenfunktion und den Optimierungsprozess des Gradientenabstiegs.
- Logistische Regression: Löst Klassifikationsprobleme (z. B. die Bestimmung, ob eine E-Mail Spam ist). Verstehe die Sigmoid-Funktion und die Entscheidungsgrenze.
- K-Nearest Neighbors (K-NN): Ein einfacher instanzbasierter Klassifikations-/Regressionsalgorithmus.
- Entscheidungsbaum: Simuliert den menschlichen Entscheidungsprozess, sehr intuitiv und leicht zu verstehen.
Einführung in das unüberwachte Lernen
Unüberwachtes Lernen wird verwendet, um intrinsische Strukturen und Muster in Daten zu entdecken.
- K-Means-Clustering: Gruppiert Daten automatisch in K Cluster.
- Hauptkomponentenanalyse (PCA): Wird für Dimensionsreduktion und Visualisierung verwendet, wobei die wichtigsten Merkmale extrahiert werden.
Tool-Upgrade: In dieser Phase beginnen Sie, systematischscikit-learndie Bibliothek zu verwenden. Sie bietet eine einheitliche API, mit der Sie verschiedene Algorithmen schnell implementieren, vergleichen und bewerten können.
Beispiel
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, classification_report
# =========================
# 1. Ausführbare Testdaten erstellen
# Szenario: ob du die Prüfung bestehst (1=bestanden, 0=nicht bestanden)
# Merkmale: Lernzeit, Anwesenheitsquote, Hausaufgaben-Erledigungsquote
# =========================
X = np.array([
[2, 60, 50],
[3, 65, 55],
[4, 70, 65],
[5, 75, 70],
[6, 80, 75],
[7, 85, 80],
[8, 90, 85],
[9, 92, 88],
[10, 95, 90],
[11, 97, 92],
[1, 50, 40],
[2, 55, 45],
[3, 60, 50],
[4, 65, 55],
[5, 70, 60],
[6, 75, 65],
[7, 80, 70],
[8, 85, 75],
[9, 90, 80],
[10, 95, 85]
])
y = np.array([
0, 0, 0, 0, 1,
1, 1, 1, 1, 1,
0, 0, 0, 0, 0,
1, 1, 1, 1, 1
])
# =========================
# 2. Daten in Trainings- und Testsets aufteilen
# =========================
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.3, random_state=42
)
# =========================
# 3. Modell erstellen und trainieren
# =========================
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)
# =========================
# 4. Vorhersagen treffen
# =========================
y_pred = model.predict(X_test)
# =========================
# 5. Modellleistung bewerten
# =========================
print(f"Modellgenauigkeit: {accuracy_score(y_test, y_pred):.2f}")
print("\nDetaillierter Klassifikationsbericht:")
print(classification_report(y_test, y_pred))
Ausgabe:
模型准确率:0.83

详细分类报告:
              precision    recall  f1-score   support

           0       0.67      1.00      0.80         2
           1       1.00      0.75      0.86         4

    accuracy                           0.83         6
   macro avg       0.83      0.88      0.83         6
weighted avg       0.89      0.83      0.84         6
Phase 3: Fortgeschritten - In Kernbereiche eintauchen
Nachdem du klassische Algorithmen gemeistert hast, kannst du dich moderneren und leistungsfähigeren Bereichen zuwenden.
Tiefer Einblick in traditionelles maschinelles Lernen
- Ensemble Learning: Lerne, wie man mehrere schwache Modelle kombiniert, um ein starkes Modell zu erstellen.
- Random Forest: Ein Ensemble aus mehreren Entscheidungsbäumen mit starker Widerstandsfähigkeit gegen Overfitting.
- Gradient Boosting Trees (z. B. XGBoost, LightGBM): Hochleistungsfähige Algorithmen, extrem beliebt in Wettbewerben und der Industrie.
- Support Vector Machine (SVM): Verstehe die Kernidee, den "Margin" zu maximieren.
- Modellbewertung und -optimierung: Tauche tief in Kreuzvalidierung, Hyperparameter-Tuning (z. B. GridSearchCV) und Methoden zur Lösung von Overfitting/Underfitting ein.
Einstieg in Deep Learning
Wenn Daten (insbesondere Bilder, Text und Sprache) komplex werden, beginnt Deep Learning, seine leistungsstarken Fähigkeiten zu demonstrieren.
- Grundlagen neuronaler Netzwerke: Verstehe Neuronen, Aktivierungsfunktionen, Vorwärtspropagation, Backpropagation und Verlustfunktionen.
- Deep-Learning-Frameworks: Wähle
PyTorch(forschungsfreundlich, flexibel) oderTensorFlow/Keras(ausgereifte Produktionsumgebung, vollständiges Ökosystem), und studiere eines davon eingehend. - Faltungsnetzwerk (CNN): Der Standard für die Verarbeitung von Bilddaten; verstehen Sie die Rollen von Faltungsschichten und Pooling-Schichten.
- Rekurrentes neuronales Netz (RNN) und Long-Short-Term-Memory-Netzwerk (LSTM): Leistungsstarke Werkzeuge für die Verarbeitung von Sequenzdaten (z. B. Text, Zeitreihen).
Beispiel
from tensorflow import keras
from tensorflow.keras import layers
model = keras.Sequential([
layers.Dense(64, activation='relu', input_shape=(input_dim,)), # Versteckte Schicht 1
layers.Dropout(0.2), # Dropout-Schicht, um Overfitting zu vermeiden
layers.Dense(32, activation='relu'), # Versteckte Schicht 2
layers.Dense(1, activation='sigmoid') # Ausgabeschicht für binäre Klassifikation
])
model.compile(optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy'])
model.summary() # Modellstruktur ausgeben
# Danach können Sie model.fit zum Trainieren verwenden
Phase 4: Anwendung und Erweiterung – Fokus auf Richtungen, reale Probleme lösen
Maschinelles Lernen hat viele Teilgebiete; an diesem Punkt müssen Sie je nach Ihren Interessen oder Karriereplänen eine Richtung wählen, in die Sie sich vertiefen.
Auswahl der Hauptrichtung
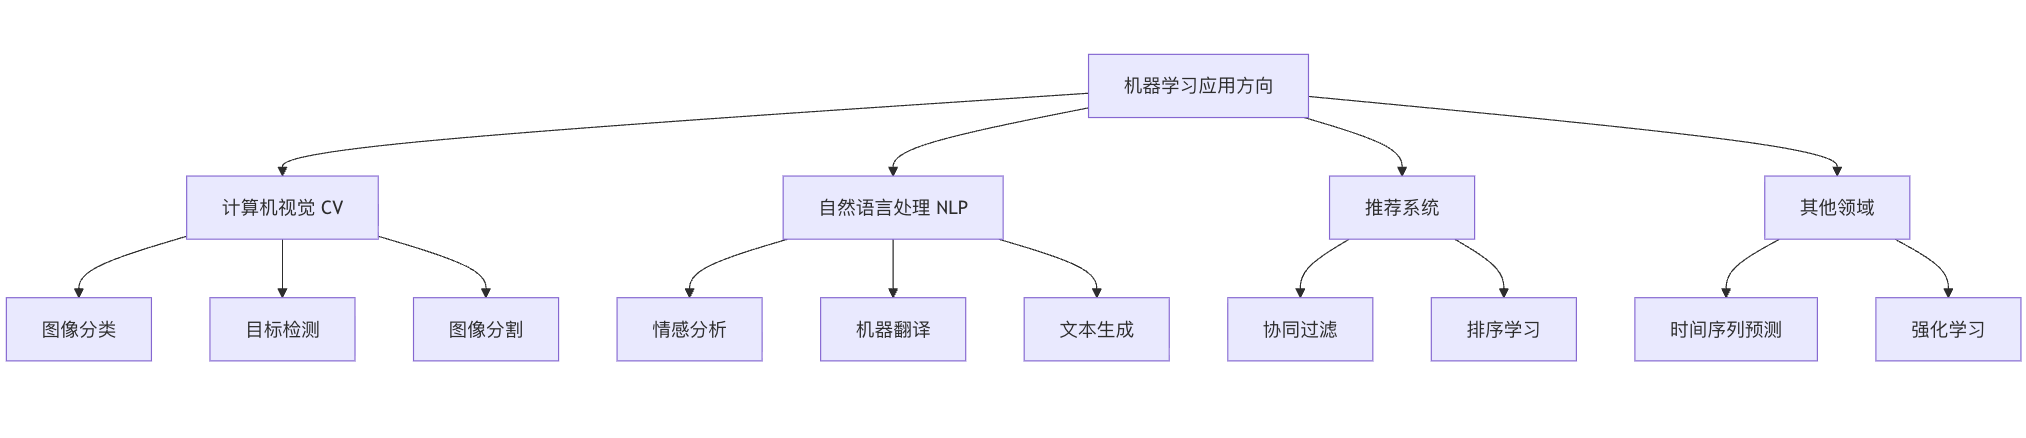
- Computer Vision (CV): Tauchen Sie tief in CNN-Varianten (ResNet, YOLO) ein, lernen Sie Bildsegmentierung und Objekterkennung.
- Verarbeitung natürlicher Sprache (NLP): Lernen Sie von Word Embeddings (Word2Vec) bis zur Transformer-Architektur (BERT, GPT) und beherrschen Sie Textklassifikation, Sentimentanalyse und maschinelle Übersetzung.
- Empfehlungssysteme: Lernen Sie kollaboratives Filtern, Matrixfaktorisierung und Deep-Learning-Empfehlungsmodelle.
- Bestärkendes Lernen: Ermöglicht es einem Agenten, durch Interaktion mit der Umgebung optimale Verhaltensstrategien zu lernen; es ist der Kern von Spiel-KI und Robotersteuerung.
Engineering und Deployment
Lernen Sie, trainierte Modelle in Produktionsumgebungen bereitzustellen und echte Dienste anzubieten.
- Speichern und Laden von Modellen(
pickle,joblib,.h5Datei). - Verwende Flask/FastAPI, um einen einfachen API-Dienst zu erstellen。
- Verstehe Docker-Containerisierungund die grundlegenden Konzepte von Cloud-Diensten (z. B. AWS SageMaker, Google AI Platform).
Zusammenfassung und Ressourcenempfehlungen
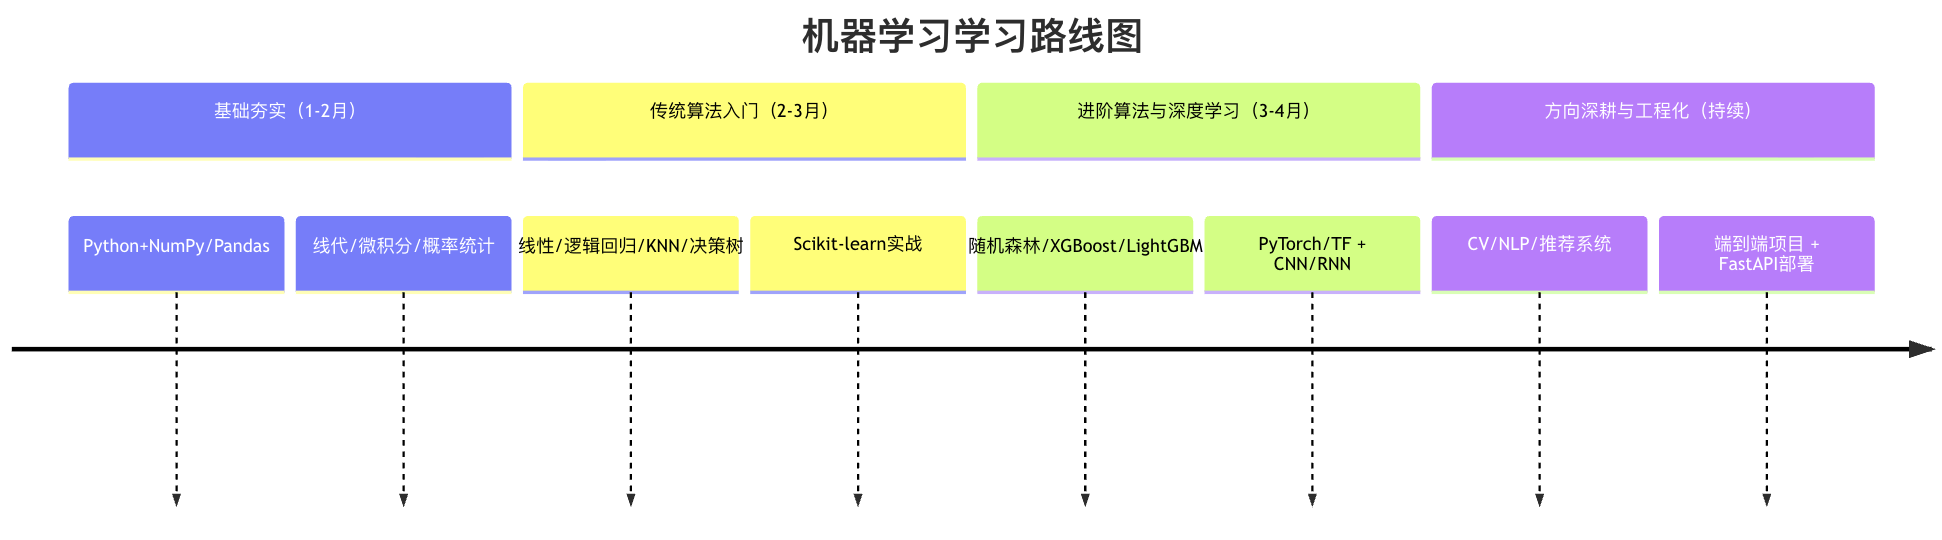
Visualisierung des Lernpfads
Übung ist die einzige Abkürzung
Der wichtigste Ratschlag:Lernen durch Tun, projektgetrieben!
- Imitieren: Projekte aus Tutorials und wissenschaftlichen Arbeiten reproduzieren.
- Üben: Nimm an Wettbewerben für Anfänger auf Plattformen wie Kaggle und Tianchi teil.
- Erstellen: Versuche, maschinelles Lernen zu nutzen, um ein kleines Problem zu lösen, an dem du persönlich interessiert bist (z. B. Analyse deiner Trainingsdaten, automatische Klassifizierung deiner Fotosammlung).
Empfehlungen für hochwertige Ressourcen
- Klassische Kurse: Andrew Ngs "Machine Learning" (Coursera), Mu Lis "Dive into Deep Learning".
- Übungsplattformen: Kaggle (Wettbewerbe und Datensätze), Colab / Jupyter Notebook (kostenlose Cloud-Umgebung).
- Wissensfestigung: Lesen Sie
scikit-learn、PyTorchoffizielle Dokumentation und tauschen Sie sich auf Stack Overflow und in verwandten Forum-Communities aus.