Визуализация данных
Прежде чем приступить к построению сложной модели машинного обучения, первое, что нам нужно сделать, — это не выбрать алгоритм, апонять данные.。
Если сравнить машинное обучение с кулинарией, то данные — это ингредиент.
Отличный шеф-повар должен понимать особенности ингредиентов — свежие они или испорченные, сладкие или кислые, подходят ли они для тушения или быстрого обжаривания.
Визуализация данных — это нашалупаии вкусовая почка。
Визуализация данных использует визуальные элементы, такие как диаграммы и графики, чтобы превратить скучные числа в интуитивно понятные образы, помогая нам:
- Обнаруживайте закономерности и тенденции в данных(Например: меняется ли выручка от продаж в зависимости от сезона?)
- Выявляйте выбросы и ошибочные данные(Например: запись с возрастом 300 лет)
- Понимайте взаимосвязи между признаками (переменными)(Например: есть ли положительная корреляция между площадью дома и ценой?)
- Проверяйте предположения, и обеспечивайте основу для последующей разработки признаков и выбора модели.
В этой статье будут использованы самые популярные библиотеки для анализа данных на Pythonpandasи библиотеки визуализацииmatplotlib、seaborn, чтобы помочь вам освоить ключевые навыки визуализации данных.
Подготовка: окружение и данные
Прежде чем начать рисовать графики, нам нужно подготовить «холст» и «краски».
Установите необходимые библиотеки
Если вы используете Anaconda, эти библиотеки обычно уже установлены. В противном случае вы можете установить их с помощью следующей команды:
pip install pandas matplotlib seaborn
Импортируйте библиотеки и загрузите данные
Мы будем использовать классический публичный набор данных: набор данных о пассажирах «Титаника». Он содержит информацию о выживании пассажиров, классе, возрасте, поле и т. д.
Пример
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# Установить стиль графика, чтобы он выглядел лучше
sns.set_style("whitegrid")
# -------------------------- Начало настройки китайского шрифта --------------------------
plt.rcParams['font.sans-serif'] = [
# Сначала Windows
'SimHei', 'Microsoft YaHei',
# Сначала macOS
'PingFang SC', 'Heiti TC',
# Сначала Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Исправить проблему, когда знак минуса отображается как квадрат
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Конец настройки китайского шрифта --------------------------
# Загрузить данные
# Здесь мы загружаем напрямую из встроенного набора данных seaborn
df = sns.load_dataset('titanic')
# Просмотреть первые несколько строк и базовую информацию о данных
print("Форма данных (строки, столбцы):", df.shape)
print("\n"Первые 5 строк данных:")
print(df.head())
print("\n"Базовая информация о данных (типы, количество непустых значений и т. д.):")
print(df.info())
# Загрузить данные
# Здесь мы загружаем напрямую из встроенного набора данных seaborn
df = sns.load_dataset('titanic')
# Просмотреть первые несколько строк и базовую информацию о данных
print("Форма данных (строки, столбцы):", df.shape)
print("\n"Первые 5 строк данных:")
print(df.head())
print("\n"Базовая информация о данных (типы, количество непустых значений и т. д.):")
print(df.info())
Запустив код выше, вы увидите, что данные содержат 891 строку (пассажиров) и 15 столбцов (признаков).df.head()Это даёт первоначальное представление о том, как выглядят данные.
Одномерный анализ: понимание распределения одного признака
Одномерный анализ фокусируется нараспределении одногопризнака (переменной). Это самый базовый анализ.
1. Числовые признаки: гистограммы и ящичные диаграммы
Для таких признаков, какage(age),fare(fare) и другие непрерывные числовые признаки, мы часто используемгистограммыии коробчатые диаграммы.。
Гистограммаотображает частотное распределение данных по различным интервалам ("bins").
Пример
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# Установить стиль графика, чтобы он выглядел лучше
sns.set_style("whitegrid")
# -------------------------- Начало настройки китайского шрифта --------------------------
plt.rcParams['font.sans-serif'] = [
# Сначала Windows
'SimHei', 'Microsoft YaHei',
# Сначала macOS
'PingFang SC', 'Heiti TC',
# Сначала Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Исправить проблему, когда знак минуса отображается как квадрат
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Конец настройки китайского шрифта --------------------------
# Загрузить данные
# Здесь мы загружаем напрямую из встроенного набора данных seaborn
df = sns.load_dataset('titanic')
# Просмотреть первые несколько строк и базовую информацию о данных
print("Форма данных (строки, столбцы):", df.shape)
print("\n"Первые 5 строк данных:")
print(df.head())
print("\n"Базовая информация о данных (типы, количество непустых значений и т. д.):")
print(df.info())
# Построить гистограмму age
plt.figure(figsize=(10, 6)) # Установить размер графика
plt.hist(df['age'].dropna(), bins=30, edgecolor='black', alpha=0.7) # dropna() игнорирует пропущенные значения
plt.title('Гистограмма распределения возраста пассажиров')
plt.xlabel('Возраст')
plt.ylabel('Частота')
plt.show()
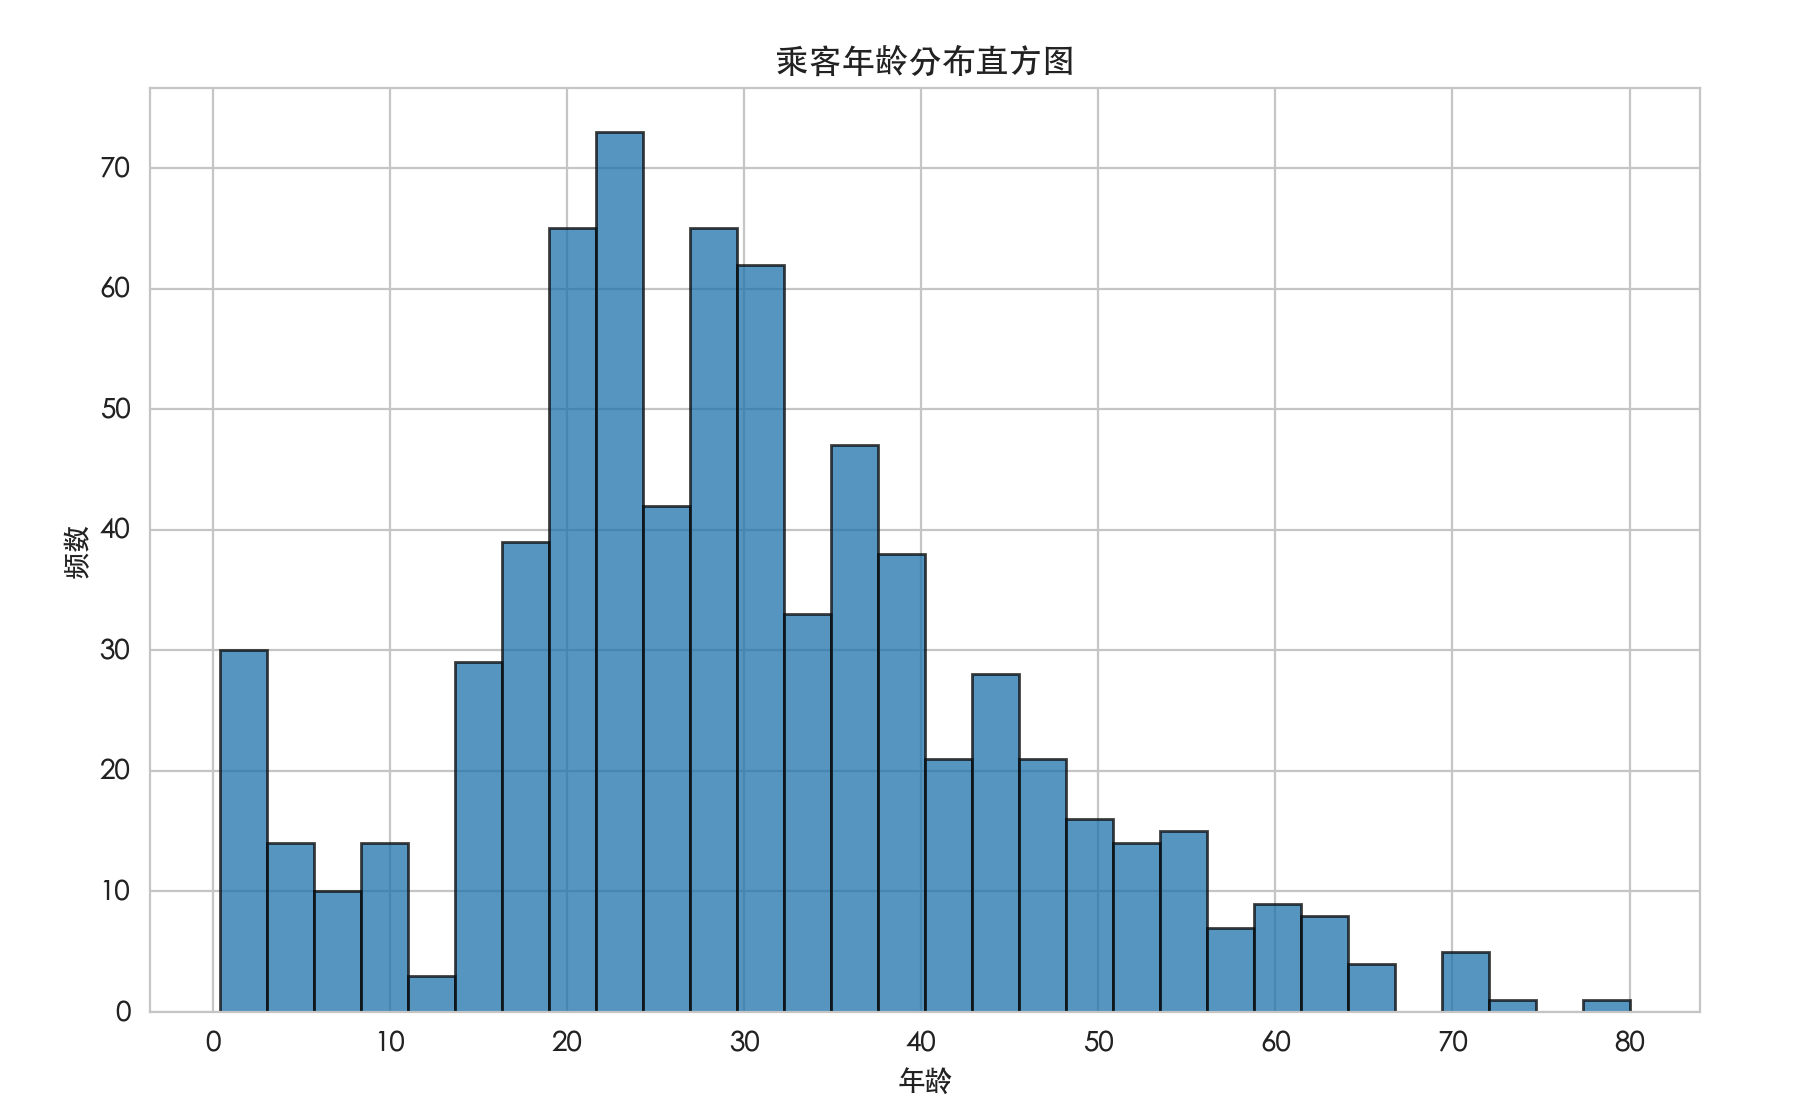
Интерпретация: Этот график может показать, в каком интервале в основном сосредоточены возрасты пассажиров (например, 20-30 лет), симметрично ли распределение, есть ли выбросы и т. д.
Коробчатая диаграммаможет наглядно показатьмедиану, квартили и выбросы данных.。
Пример
plt.figure(figsize=(8, 5))
plt.boxplot(df['fare'].dropna())
plt.title('Ящик с усами для Fare')
plt.ylabel('Fare')
plt.show()
Интерпретация: Линия в середине прямоугольника — это медиана. Верхняя и нижняя границы прямоугольника — это верхний квартиль (Q3) и нижний квартиль (Q1). Верхние и нижние "усы" обычно простираются до самых дальних точек данных в пределах 1.5 межквартильного размаха; точки за этими пределами считаютсявыбросами(кружки выше на рисунке). Этот график сразу показывает, что существует много чрезвычайно высоких выбросов в fare.
2. Категориальные признаки: столбчатые диаграммы
Для таких признаков, какsex(пол),embarked(порт посадки),survived(выжил или нет) и другие категориальные признаки, мы используемстолбчатые диаграммыдля подсчёта количества каждой категории.
Пример
survival_counts = df['sex'].value_counts()
plt.figure(figsize=(8, 5))
plt.bar(survival_counts.index, survival_counts.values, color=['lightblue', 'lightcoral'])
plt.title('Распределение пассажиров по полу')
plt.xlabel('Пол')
plt.ylabel('Количество')
plt.show()
Двумерный анализ: исследование взаимосвязей между признаками
Двумерный анализ исследуетвзаимосвязь между двумяпризнаками.
1. Числовые против числовых: диаграммы рассеяния
Диаграмма рассеяния — мощный инструмент для изучения корреляции между двумя непрерывными переменными.
Пример
plt.figure(figsize=(10, 6))
plt.scatter(df['age'], df['fare'], alpha=0.5) # alpha задаёт прозрачность, чтобы лучше наблюдать плотность точек
plt.title('Диаграмма рассеяния: возраст и стоимость билета')
plt.xlabel('Возраст')
plt.ylabel('Fare')
plt.show()
- Интерпретация: Характер распределения точек может указывать на корреляцию. Например, если точки примерно лежат вдоль диагональной линии, это означает, что две переменные коррелируют. По этому графику возраст и стоимость билета не показывают очевидной линейной зависимости, но он ещё раз подтверждает наличие высоких значений стоимости билета (выбросов).
2. Категориальные vs числовые: сгруппированные ящичные диаграммы или скрипичные диаграммы
Часто нам нужно понять, как распределение числового признака различается по категориям. Например: «Как распределение стоимости билета различается среди пассажиров разных классов?»
Пример
plt.figure(figsize=(10, 6))
sns.boxplot(x='pclass', y='fare', data=df)
plt.title('Распределение стоимости билета по классу пассажира')
plt.show()
- Интерпретация: Очень наглядно! Более высокий класс каюты (первый класс) имеет значительно более высокую медиану и общий диапазон цен на билеты. Это полностью соответствует здравому смыслу.
Скрипичная диаграмма— это усовершенствованная версия ящичной диаграммы. Она не только отображает статистику, но и показывает фактическую форму распределения данных с помощью ядерной оценки плотности.
Пример
plt.figure(figsize=(10, 6))
sns.violinplot(x='sex', y='age', data=df, inner='quartile') # Параметр inner отображает линии квартилей
plt.title('Распределение возраста по полу (скрипичная диаграмма)')
plt.show()
3. Категориальные vs Категориальные: составные столбчатые диаграммы или тепловые карты
Для двух категориальных переменных мы можем использоватьсоставные столбчатые диаграммы, чтобы увидеть комбинацию. Например: "Каково соотношение выживших по полу?"
Пример
cross_tab = pd.crosstab(df['sex'], df['survived'], normalize='index') # normalize='index' вычисляет пропорции по строкам
print(cross_tab)
# Нарисовать составную столбчатую диаграмму
cross_tab.plot(kind='bar', stacked=True, figsize=(10, 6), color=['tomato', 'lightgreen'])
plt.title('Доля выживших по полу')
plt.xlabel('Пол')
plt.ylabel('Доля')
plt.legend(['Не выжившие', 'Выжившие'])
plt.show()
Интерпретация: Из графика и таблицы сопряжённости очевидно, что доля выживших среди женщин намного выше, чем среди мужчин. Это очень сильный сигнал, указывающий на то, чтоsexэтот признак имеет решающее значение для предсказания выживания.
Многомерный анализ и расширенная визуализация
Иногда нам нужно рассматривать три или даже больше переменных одновременно.seabornБиблиотека упрощает это.
1. Диаграмма рассеяния с группировкой
На основе диаграммы рассеяния мы можем использовать цвет или форму, чтобы различать третью (категориальную) переменную.
Пример
plt.figure(figsize=(12, 8))
sns.scatterplot(x='age', y='fare', hue='survived', style='survived', data=df, alpha=0.7)
plt.title('Возраст и стоимость билета (цвет по выживаемости)')
plt.show()
- Интерпретация: Этот график позволяет интуитивно увидеть, различаются ли распределения выживших (оранжевый) и не выживших (синий) в двумерном пространстве «возраст — стоимость билета».
2. Тепловая карта корреляционной матрицы
Когда у нас есть несколько числовых признаков, мы можем сразу вычислить попарные коэффициенты корреляции и отобразить их с помощью тепловой карты.
Пример
numeric_df = df.select_dtypes(include=['float64', 'int64'])
# Вычисление матрицы коэффициентов корреляции
corr_matrix = numeric_df.corr()
# Построение тепловой карты
plt.figure(figsize=(12, 8))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', center=0, square=True)
plt.title('Тепловая карта корреляционной матрицы числовых признаков')
plt.show()
Интерпретация: Более теплые цвета (красный) указывают на более сильную положительную корреляцию; более холодные цвета (синий) указывают на более сильную отрицательную корреляцию.annot=TrueОтобразить конкретные значения внутри ячеек. Например,pclass(класс каюты) иfare(стоимость билета) имеют сильную отрицательную корреляцию (-0.55), что означает, что чем меньше номер класса (выше класс), тем выше стоимость билета, что согласуется с нашим предыдущим анализом.
Практическое упражнение: практическое исследование
Теперь, пожалуйста, попробуйте выполнить следующие упражнения, чтобы закрепить то, что вы узнали:
- Проверка данных: Используйте
df.isnull().sum()чтобы проверить, в каких столбцах набора данных есть пропущенные значения и сколько их пропущено. - Построение распределения: Для
ageстолбца постройтескрипичную диаграммуи сгруппируйте поsurvived(статус выживания), используяsns.violinplot(x='survived', y='age', data=df)). Понаблюдайте, как различаются распределения возраста выживших и не выживших. - Изучите взаимосвязи: Используйте
sns.countplot(x='pclass', hue='survived', data=df)чтобы построить столбчатую диаграмму количества и сравнить число выживших в разных классах кают. Какой вывод можно сделать? - (Задача) Многомерный график: Попробуйте построитьматрицу диаграмм рассеяния, чтобы сразу увидеть
age、fare、parch(количество родителей/детей) и попарные взаимосвязи между этими числовыми переменными. Подсказка: можно использоватьsns.pairplot(df[['age', 'fare', 'parch', 'survived']], hue='survived')。
Итог
Визуализация данных — этонезаменимый этап исследованияв рабочем процессе машинного обучения. Из этой статьи вы узнали:
Основные инструменты: Используйтеmatplotlibдля базового построения графиков и используйтеseabornчтобы строить более красивые и информативные статистические графики.
Подход к анализу:
- Одномерный анализ: Используйте гистограммы/ящичные диаграммы, чтобы увидеть распределения, и столбчатые диаграммы для подсчёта частот.
- Двумерный анализ: Используйте диаграммы рассеяния для числовых взаимосвязей, сгруппированные ящичные диаграммы для влияния категорий на числовые значения и столбчатые диаграммы с накоплением для комбинаций категорий.
- Многомерный анализ: Используйте цветные диаграммы рассеяния и тепловые карты корреляций, чтобы выявить более сложные закономерности.
Основная цель: Все графики предназначены для того, чтобывыдвигать гипотезыии обнаруживать инсайты, например, пол может быть важным прогностическим признаком, а в данных о стоимости проезда много выбросов, которые нужно обработать.
Помните: прежде чем подавать данные в модель, обязательно найдите время внимательно на них посмотреть. Ясный инсайт, полученный при визуализации, часто может направить вас в правильном направлении раньше, чем сложные алгоритмы.
Другие расширения Справочник команд Linux