Visualisation de données
Avant de commencer à construire un modèle d'apprentissage automatique complexe, la première chose à faire n'est pas de choisir un algorithme, mais decomprendre les données.。
Si nous comparons l'apprentissage automatique à la cuisine, alors les données sont les ingrédients.
Un excellent chef doit comprendre les caractéristiques des ingrédients — qu'ils soient frais ou avariés, sucrés ou acides, qu'ils conviennent à mijoter ou à faire sauter.
La visualisation de données est notreloupeetet papille gustative。
La visualisation de données utilise des éléments visuels tels que des diagrammes et des graphiques pour transformer des chiffres ternes en images intuitives, nous aidant à :
- Découvrir des motifs et des tendances dans les données(Par exemple : Le chiffre d'affaires varie-t-il selon les saisons ?)
- Identifier les valeurs aberrantes et les données erronées(Par exemple : un enregistrement avec un âge de 300 ans)
- Comprendre les relations entre les caractéristiques (variables)(Par exemple : La surface et le prix d'une maison sont-ils corrélés positivement ?)
- Valider les hypothèses, et fournir une base pour l'ingénierie des caractéristiques et la sélection de modèles ultérieures.
Cet article utilisera les bibliothèques de science des données les plus populaires en Pythonpandaset les bibliothèques de visualisationmatplotlib、seaborn, pour vous aider à maîtriser les compétences essentielles de la visualisation de données.
Préparation : Environnement et données
Avant de commencer à dessiner des graphiques, nous devons préparer la "toile" et la "peinture".
Installer les bibliothèques nécessaires
Si vous utilisez Anaconda, ces bibliothèques sont généralement préinstallées. Sinon, vous pouvez les installer avec la commande suivante :
pip install pandas matplotlib seaborn
Importer les bibliothèques et charger les données
Nous allons utiliser un jeu de données public classique : le jeu de données des passagers du Titanic. Il contient des informations sur la survie, la classe, l'âge, le sexe des passagers, etc.
Exemple
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# Définir le style du graphique pour le rendre plus esthétique
sns.set_style("whitegrid")
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows en premier
'SimHei', 'Microsoft YaHei',
# macOS en premier
'PingFang SC', 'Heiti TC',
# Linux d'abord
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème où le signe moins s'affiche comme un carré
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de la configuration de la police chinoise --------------------------
# Charger les données
# Ici, nous chargeons directement depuis le jeu de données intégré de seaborn
df = sns.load_dataset('titanic')
# Afficher les premières lignes et les informations de base des données
print("Dimensions des données (lignes, colonnes) :", df.shape)
print("\n"Les 5 premières lignes des données :")
print(df.head())
print("\n"Informations de base sur les données (types, nombres de valeurs non nulles, etc.) :")
print(df.info())
# Charger les données
# Ici, nous chargeons directement depuis le jeu de données intégré de seaborn
df = sns.load_dataset('titanic')
# Afficher les premières lignes et les informations de base des données
print("Dimensions des données (lignes, colonnes) :", df.shape)
print("\n"Les 5 premières lignes des données :")
print(df.head())
print("\n"Informations de base sur les données (types, nombres de valeurs non nulles, etc.) :")
print(df.info())
En exécutant le code ci-dessus, vous verrez que les données comportent 891 lignes (passagers) et 15 colonnes (caractéristiques).df.head()Cela vous donne une première impression de ce à quoi ressemblent les données.
Analyse univariée : comprendre la distribution d'une seule caractéristique
L'analyse univariée se concentre surla distribution d'une seulecaractéristique (variable). Il s'agit de l'analyse la plus élémentaire.
1. Caractéristiques numériques : histogrammes et diagrammes en boîte
Pour des variables telles queage(âge),fare(fare) et d'autres variables numériques continues, nous utilisons souvent deshistogrammesetet des boîtes à moustaches.。
L'histogrammeaffiche la distribution des fréquences des données dans différents intervalles ("bins").
Exemple
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# Définir le style du graphique pour le rendre plus esthétique
sns.set_style("whitegrid")
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows en premier
'SimHei', 'Microsoft YaHei',
# macOS en premier
'PingFang SC', 'Heiti TC',
# Linux d'abord
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème où le signe moins s'affiche comme un carré
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de la configuration de la police chinoise --------------------------
# Charger les données
# Ici, nous chargeons directement depuis le jeu de données intégré de seaborn
df = sns.load_dataset('titanic')
# Afficher les premières lignes et les informations de base des données
print("Dimensions des données (lignes, colonnes) :", df.shape)
print("\n"Les 5 premières lignes des données :")
print(df.head())
print("\n"Informations de base sur les données (types, nombres de valeurs non nulles, etc.) :")
print(df.info())
# Tracer l'histogramme de l'âge
plt.figure(figsize=(10, 6)) # Définir la taille de la figure
plt.hist(df['age'].dropna(), bins=30, edgecolor='black', alpha=0.7) # dropna() ignore les valeurs manquantes
plt.title('Histogramme de distribution des âges des passagers')
plt.xlabel('Âge')
plt.ylabel('Fréquence')
plt.show()
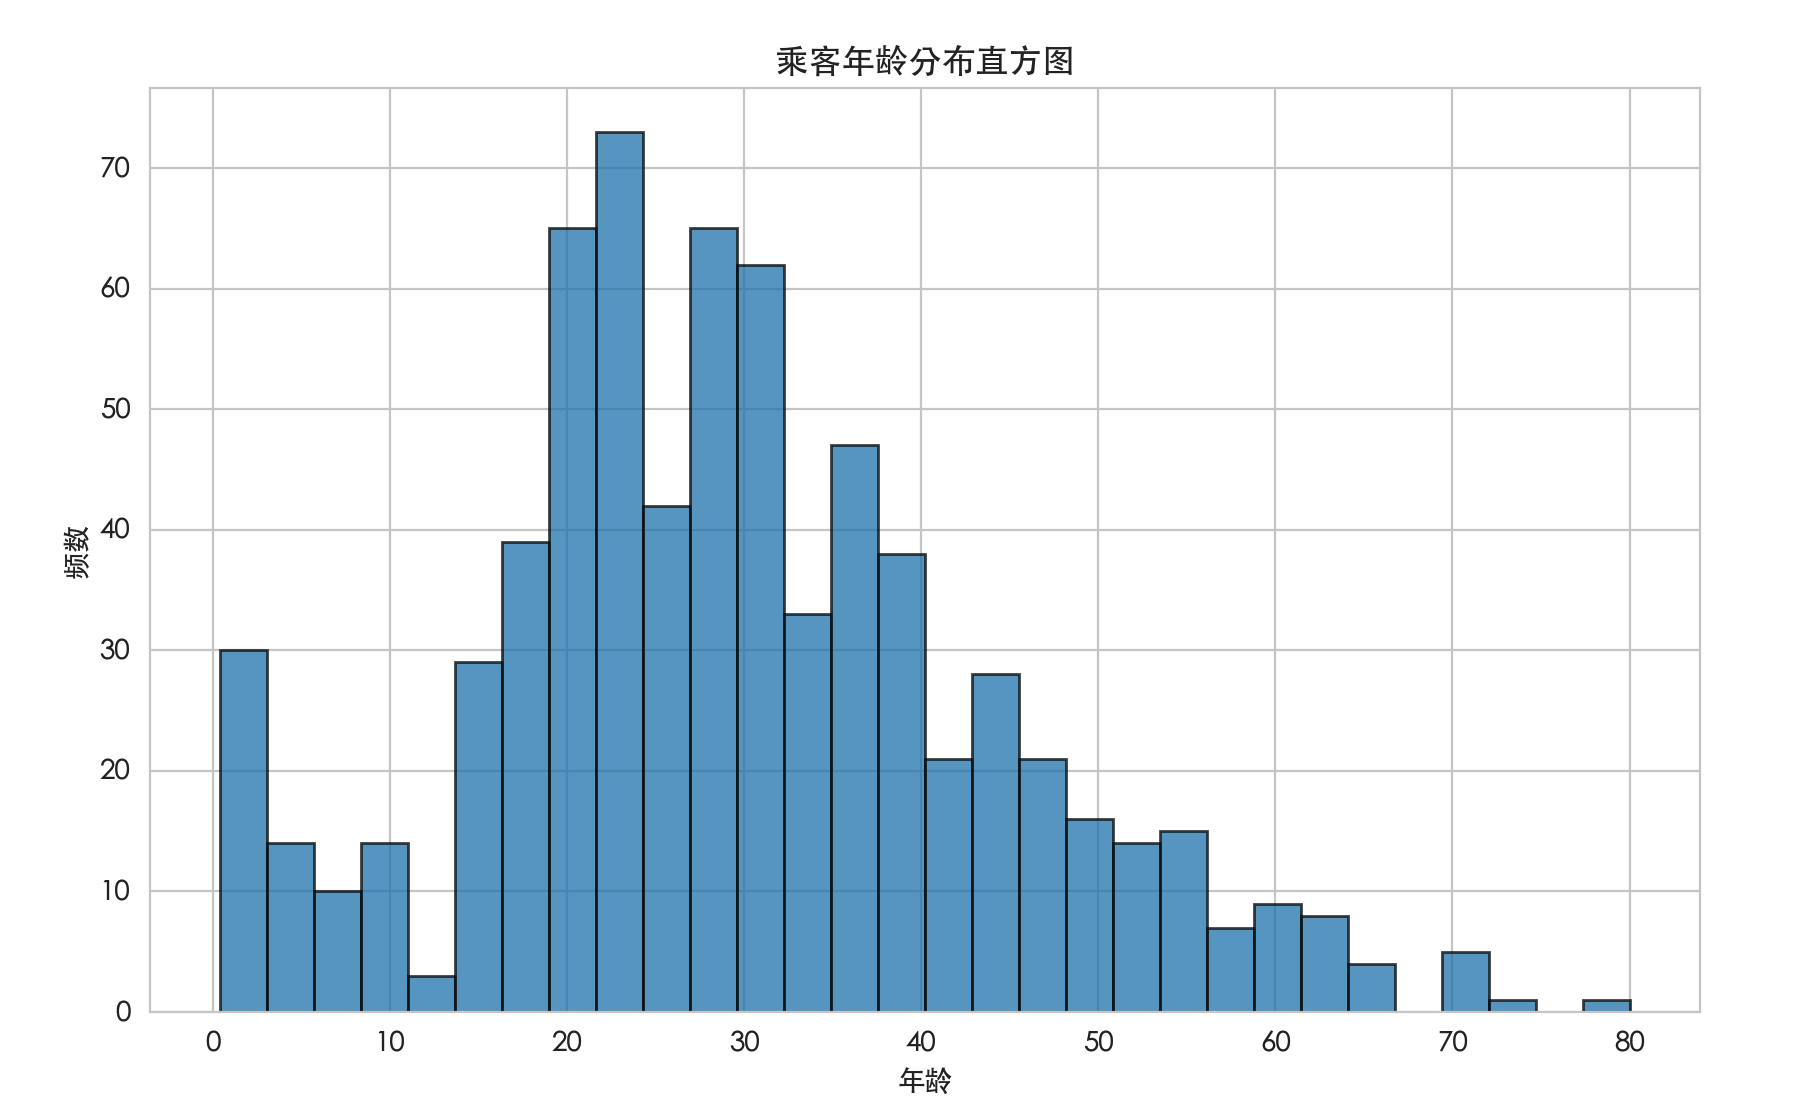
Interprétation: Ce graphique peut nous indiquer dans quel intervalle les âges des passagers sont principalement concentrés (par ex., 20-30 ans), si la distribution est symétrique, s'il y a des valeurs aberrantes, etc.
Le diagramme en boîtepeut clairement montrer lamédiane, les quartiles et les valeurs aberrantes des données.。
Exemple
plt.figure(figsize=(8, 5))
plt.boxplot(df['fare'].dropna())
plt.title('Fare box plot')
plt.ylabel('Fare')
plt.show()
Interprétation: La ligne au milieu de la boîte est la médiane. Les bords supérieur et inférieur de la boîte sont le quartile supérieur (Q3) et le quartile inférieur (Q1). Les « moustaches » supérieure et inférieure s'étendent généralement jusqu'aux points de données les plus éloignés dans la limite de 1.5 fois l'écart interquartile ; les points au-delà sont considérés commevaleurs aberrantes(les cercles ci-dessus sur la figure). Ce graphique nous indique immédiatement qu'il y a de nombreuses valeurs aberrantes extrêmement élevées dans fare.
2. Variables catégorielles : diagrammes à barres
Pour des variables telles quesex(sexe),embarked(port d'embarquement),survived(a survécu ou non) et d'autres variables catégorielles, nous utilisonsdes diagrammes à barrespour compter le nombre de chaque catégorie.
Exemple
survival_counts = df['sex'].value_counts()
plt.figure(figsize=(8, 5))
plt.bar(survival_counts.index, survival_counts.values, color=['lightblue', 'lightcoral'])
plt.title('Répartition des passagers par genre')
plt.xlabel('Genre')
plt.ylabel('Nombre')
plt.show()
Analyse bivariée : Explorer les relations entre les caractéristiques
L'analyse bivariée explorela relation entre deuxcaractéristiques.
1. Numérique vs Numérique : Nuages de points
Un nuage de points est un outil puissant pour étudier la corrélation entre deux variables continues.
Exemple
plt.figure(figsize=(10, 6))
plt.scatter(df['age'], df['fare'], alpha=0.5) # alpha définit la transparence pour mieux observer la densité des points
plt.title('Âge vs Tarif – Diagramme de dispersion')
plt.xlabel('Âge')
plt.ylabel('Fare')
plt.show()
- Interprétation: La répartition des points peut suggérer une corrélation. Par exemple, si les points se situent approximativement le long d'une ligne diagonale, cela indique que les deux variables sont corrélées. D'après ce graphique, l'âge et le tarif ne montrent pas de relation linéaire évidente, mais cela confirme à nouveau l'existence de tarifs élevés (valeurs aberrantes).
2. Catégoriel vs Numérique : Boîtes à moustaches groupées ou diagrammes en violon
Nous voulons souvent savoir comment la distribution d'une variable numérique diffère selon les catégories. Par exemple : « Comment la distribution des tarifs diffère-t-elle entre les passagers des différentes classes ? »
Exemple
plt.figure(figsize=(10, 6))
sns.boxplot(x='pclass', y='fare', data=df)
plt.title('Distribution des tarifs par classe de passager')
plt.show()
- Interprétation: Très clair ! Une classe de cabine plus élevée (Première classe) a une médiane et une étendue globale des prix des billets nettement plus élevées. Cela correspond totalement à notre bon sens.
Le diagramme en violonest une version avancée de la boîte à moustaches. Il affiche non seulement les statistiques, mais montre aussi la forme réelle de la distribution des données via l'estimation par noyau.
Exemple
plt.figure(figsize=(10, 6))
sns.violinplot(x='sex', y='age', data=df, inner='quartile') # Le paramètre inner affiche les lignes des quartiles
plt.title('Distribution de l'âge par sexe (diagramme en violon)')
plt.show()
3. Catégoriel vs Catégoriel : diagrammes à barres empilées ou cartes de chaleur
Pour deux variables catégorielles, on peut utiliserdes diagrammes à barres empiléespour observer la combinaison. Par exemple : « Quel est le taux de survie par sexe ? »
Exemple
cross_tab = pd.crosstab(df['sex'], df['survived'], normalize='index') # normalize='index' calcule les proportions par ligne
print(cross_tab)
# Tracer un diagramme à barres empilées
cross_tab.plot(kind='bar', stacked=True, figsize=(10, 6), color=['tomato', 'lightgreen'])
plt.title('Taux de survie par sexe')
plt.xlabel('Genre')
plt.ylabel('Proportion')
plt.legend(['Non survivant', 'Survivant'])
plt.show()
Interprétation: D'après le graphique et le tableau croisé, il est évident que le taux de survie des femmes est bien plus élevé que celui des hommes. C'est un signal très fort indiquant quesexla caractéristique est cruciale pour prédire la survie.
Analyse multivariée et visualisation avancée
Parfois, nous devons considérer trois variables, voire davantage, en même temps.seabornLa bibliothèque rend cela facile.
1. Nuage de points avec regroupement
À partir d'un nuage de points, nous pouvons utiliser la couleur ou la forme pour distinguer une troisième variable (catégorielle).
Exemple
plt.figure(figsize=(12, 8))
sns.scatterplot(x='age', y='fare', hue='survived', style='survived', data=df, alpha=0.7)
plt.title('Age vs. Fare (coloré par la survie)')
plt.show()
- Interprétation: Ce graphique nous permet de voir intuitivement si les distributions des survivants (orange) et des non-survivants (bleu) diffèrent dans l'espace bidimensionnel "age-fare".
2. Carte thermique de la matrice de corrélation
Lorsque nous avons plusieurs variables numériques, nous pouvons calculer les coefficients de corrélation par paires en une seule fois et les afficher avec une carte thermique.
Exemple
numeric_df = df.select_dtypes(include=['float64', 'int64'])
# Calculer la matrice des coefficients de corrélation
corr_matrix = numeric_df.corr()
# Dessiner la carte thermique
plt.figure(figsize=(12, 8))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', center=0, square=True)
plt.title('Carte thermique de la matrice de corrélation des variables numériques')
plt.show()
Interprétation: Les couleurs plus chaudes (rouge) indiquent une corrélation positive plus forte ; les couleurs plus froides (bleu) indiquent une corrélation négative plus forte.annot=TrueAfficher les valeurs spécifiques à l'intérieur des cellules. Par exemple,pclass(classe de cabine) etfare(tarif) ont une forte corrélation négative (-0.55), ce qui signifie que plus le numéro de classe est petit (classe plus élevée), plus le tarif est élevé, ce qui est cohérent avec notre analyse précédente.
Exercice pratique : Exploration concrète
Maintenant, essayez de réaliser les exercices suivants pour consolider ce que vous avez appris :
- Inspection des données: Utilisez
df.isnull().sum()pour vérifier quelles colonnes du jeu de données contiennent des valeurs manquantes et combien de valeurs sont manquantes. - Tracer la distribution: Pour la
agecolonne, dessinez undiagramme en violon, et regroupez parsurvived(statut de survie) en utilisantsns.violinplot(x='survived', y='age', data=df)). Observez comment les distributions d'âge des survivants et des non-survivants diffèrent. - Explorer les relations: Utilisez
sns.countplot(x='pclass', hue='survived', data=df)pour tracer un diagramme à barres des effectifs et comparer le nombre de survivants selon les différentes classes de cabine. Quelle conclusion pouvez-vous en tirer ? - (Défi) Graphique multivarié: Essayez de tracer unematrice de nuages de points, pour visualiser en une fois
age、fare、parch(nombre de parents/enfants) et les relations par paires entre ces variables numériques. Indice : vous pouvez utilisersns.pairplot(df[['age', 'fare', 'parch', 'survived']], hue='survived')。
Résumé
La visualisation de données est uneétape d’exploration indispensabledans le flux de travail d’apprentissage automatique. Dans cet article, vous avez appris :
Outils essentiels: Utilisezmatplotlibpour les tracés de base, et utilisezseabornpour tracer des graphiques statistiques plus beaux et plus informatifs.
Approche d’analyse:
- Analyse univariée: Utilisez des histogrammes/boîtes à moustaches pour visualiser les distributions, et des diagrammes à barres pour compter les fréquences.
- Analyse bivariée: Utilisez des nuages de points pour les relations numériques, des boîtes à moustaches groupées pour l’effet des catégories sur les valeurs numériques, et des diagrammes à barres empilées pour les combinaisons de catégories.
- Analyse multivariée: Utilisez des nuages de points colorés et des cartes thermiques de corrélation pour révéler des motifs plus complexes.
Objectif principal: Tous les graphiques sont destinés àproposer des hypothèsesetet découvrir des éclairages, par exemple, le sexe peut être une caractéristique prédictive importante, et il y a de nombreuses valeurs aberrantes dans les données tarifaires qui doivent être traitées.
N'oubliez pas : avant d'alimenter un modèle en données, prenez le temps de les examiner attentivement. Un éclairage clair issu de la visualisation peut souvent vous orienter dans la bonne direction plus tôt que des algorithmes complexes.
Autres extensions Référence des commandes Linux