Datenvisualisierung
Bevor wir mit dem Aufbau eines komplexen Machine-Learning-Modells beginnen, ist das Erste, was wir tun müssen, nicht einen Algorithmus auszuwählen, sonderndie Daten zu verstehen.。
Wenn wir maschinelles Lernen mit Kochen vergleichen, dann sind die Daten die Zutat.
Ein ausgezeichneter Koch muss die Eigenschaften der Zutaten verstehen — ob sie frisch oder verdorben, ob sie süß oder sauer, ob sie zum Schmoren oder Pfannenrühren geeignet sind.
Datenvisualisierung ist unsereLupeundund Geschmacksknospe。
Datenvisualisierung nutzt visuelle Elemente wie Diagramme und Grafiken, um trockene Zahlen in intuitive Bilder zu verwandeln und uns dabei zu helfen:
- Muster und Trends in den Daten entdecken(Zum Beispiel: Variiert der Umsatz mit den Jahreszeiten?)
- Ausreißer und fehlerhafte Daten identifizieren(Zum Beispiel: ein Datensatz mit einem Alter von 300 Jahren)
- Beziehungen zwischen Merkmalen (Variablen) verstehen(Zum Beispiel: Sind Hausfläche und Preis positiv korreliert?)
- Annahmen validierenund eine Grundlage für nachfolgendes Feature Engineering und die Modellauswahl bieten.
Dieser Artikel verwendet die beliebtesten Data-Science-Bibliotheken in Pythonpandasund Visualisierungsbibliothekenmatplotlib、seaborn, um Ihnen zu helfen, die Kernfähigkeiten der Datenvisualisierung zu beherrschen.
Vorbereitung: Umgebung und Daten
Bevor wir mit dem Zeichnen von Diagrammen beginnen, müssen wir die "Leinwand" und die "Farbe" vorbereiten.
Die notwendigen Bibliotheken installieren
Wenn Sie Anaconda verwenden, sind diese Bibliotheken normalerweise vorinstalliert. Andernfalls können Sie sie mit dem folgenden Befehl installieren:
pip install pandas matplotlib seaborn
Bibliotheken importieren und Daten laden
Wir verwenden einen klassischen öffentlichen Datensatz: den Titanic-Passagierdatensatz. Er enthält Informationen über das Überleben der Passagiere, Klasse, Alter, Geschlecht und so weiter.
Beispiel
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# Diagrammstil festlegen, damit es besser aussieht
sns.set_style("whitegrid")
# -------------------------- Chinesische Schriftart festlegen Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows zuerst
'SimHei', 'Microsoft YaHei',
# macOS zuerst
'PingFang SC', 'Heiti TC',
# Linux zuerst
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Das Problem beheben, dass das Minuszeichen als Quadrat angezeigt wird
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
# Daten laden
# Hier laden wir direkt aus seaborns integriertem Datensatz
df = sns.load_dataset('titanic')
# Die ersten paar Zeilen und grundlegende Informationen der Daten anzeigen
print("Datenform (Zeilen, Spalten):", df.shape)
print("\n"Erste 5 Datenzeilen:")
print(df.head())
print("\n"Grundlegende Dateninformationen (Typen, Nicht-Null-Anzahlen usw.):")
print(df.info())
# Daten laden
# Hier laden wir direkt aus seaborns integriertem Datensatz
df = sns.load_dataset('titanic')
# Die ersten paar Zeilen und grundlegende Informationen der Daten anzeigen
print("Datenform (Zeilen, Spalten):", df.shape)
print("\n"Erste 5 Datenzeilen:")
print(df.head())
print("\n"Grundlegende Dateninformationen (Typen, Nicht-Null-Anzahlen usw.):")
print(df.info())
Wenn Sie den obigen Code ausführen, sehen Sie, dass die Daten 891 Zeilen (Passagiere) und 15 Spalten (Merkmale) haben.df.head()Dies vermittelt Ihnen einen ersten Eindruck davon, wie die Daten aussehen.
Univariate Analyse: Verständnis der Verteilung eines einzelnen Merkmals
Die univariate Analyse konzentriert sich aufdie Verteilung eines einzelnenMerkmals (Variable). Dies ist die grundlegendste Analyse.
1. Numerische Merkmale: Histogramme und Boxplots
Für Merkmale wieage(Alter),fare(Fahrpreis) und andere kontinuierliche numerische Merkmale, verwenden wir oftHistogrammeundund Boxplots.。
Histogrammzeigt die Häufigkeitsverteilung der Daten in verschiedenen Intervallen ("Bins").
Beispiel
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# Diagrammstil festlegen, damit es besser aussieht
sns.set_style("whitegrid")
# -------------------------- Chinesische Schriftart festlegen Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows zuerst
'SimHei', 'Microsoft YaHei',
# macOS zuerst
'PingFang SC', 'Heiti TC',
# Linux zuerst
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Das Problem beheben, dass das Minuszeichen als Quadrat angezeigt wird
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
# Daten laden
# Hier laden wir direkt aus seaborns integriertem Datensatz
df = sns.load_dataset('titanic')
# Die ersten paar Zeilen und grundlegende Informationen der Daten anzeigen
print("Datenform (Zeilen, Spalten):", df.shape)
print("\n"Erste 5 Datenzeilen:")
print(df.head())
print("\n"Grundlegende Dateninformationen (Typen, Nicht-Null-Anzahlen usw.):")
print(df.info())
# Histogramm des Alters zeichnen
plt.figure(figsize=(10, 6)) # Figurengröße festlegen
plt.hist(df['age'].dropna(), bins=30, edgecolor='black', alpha=0.7) # dropna() ignoriert fehlende Werte
plt.title('Histogramm der Altersverteilung der Passagiere')
plt.xlabel('Alter')
plt.ylabel('Häufigkeit')
plt.show()
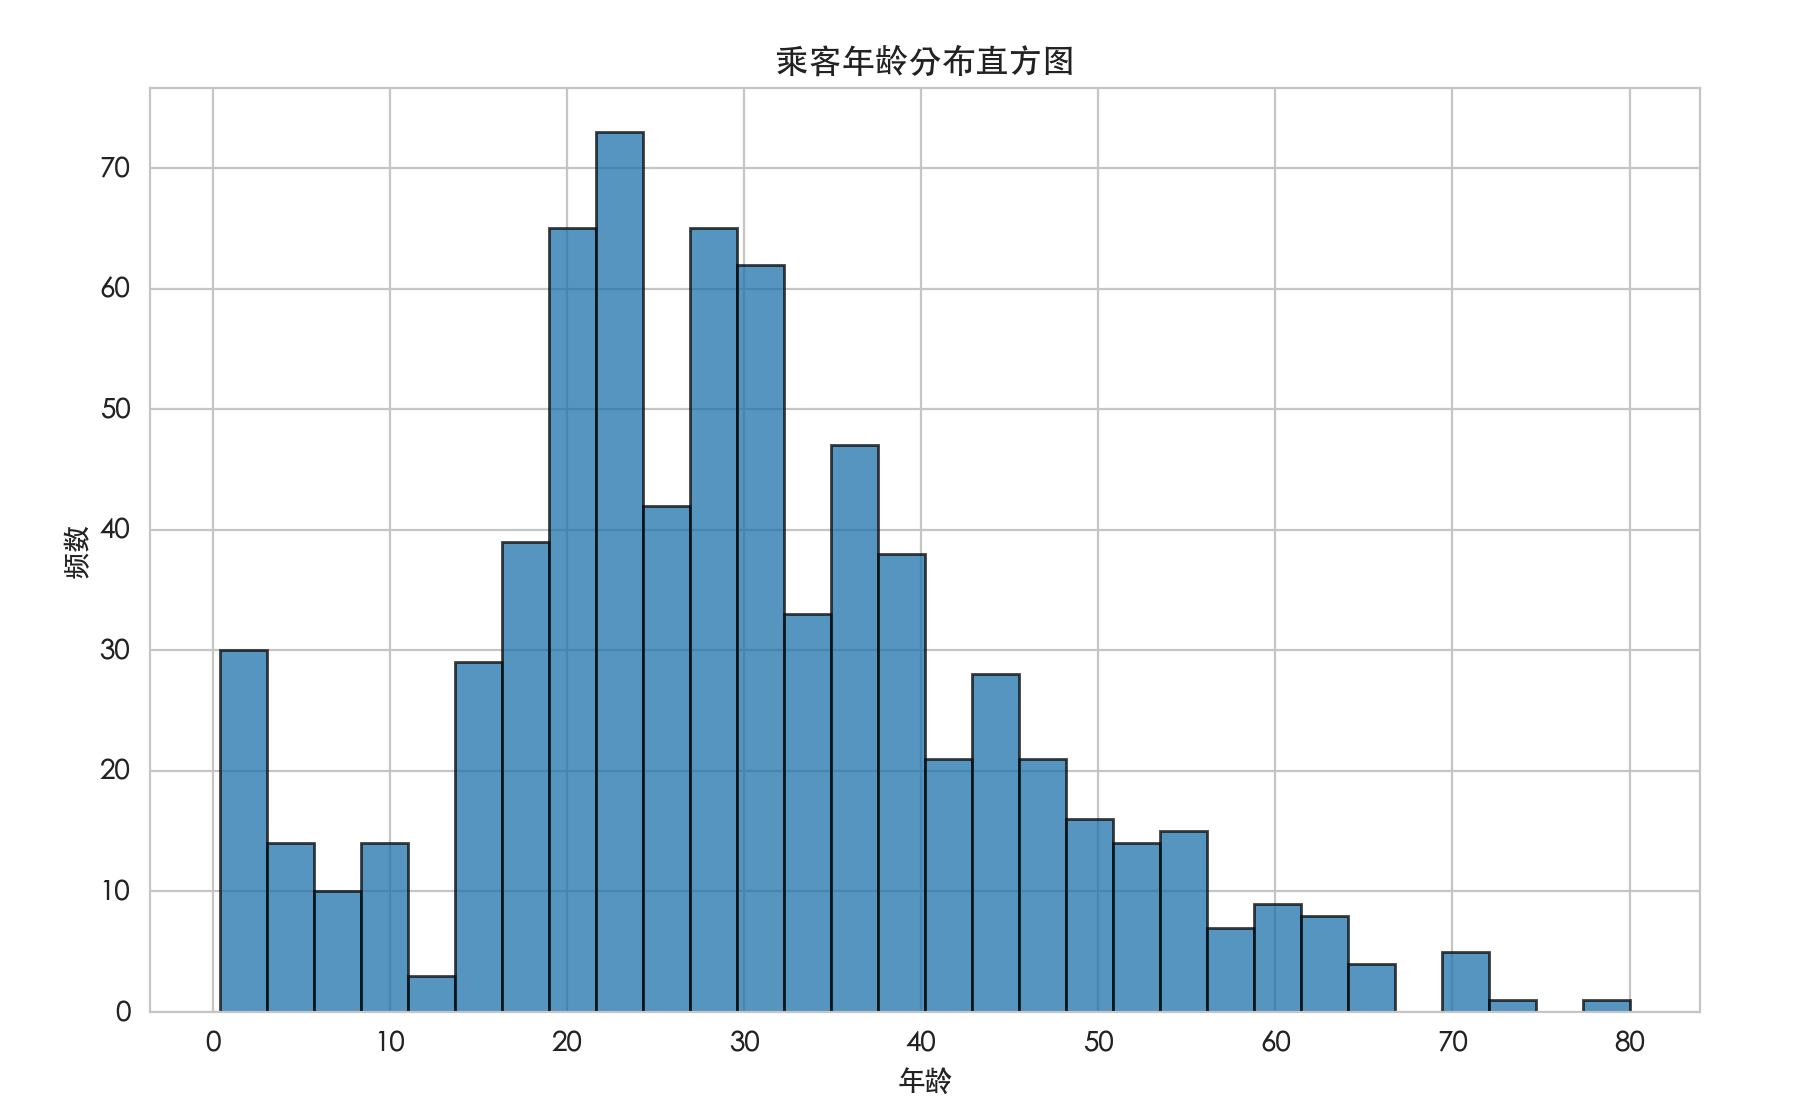
Interpretation: Dieses Diagramm kann uns zeigen, in welchem Intervall die Alterswerte der Passagiere hauptsächlich konzentriert sind (z. B. 20-30 Jahre), ob die Verteilung symmetrisch ist, ob es Ausreißer gibt usw.
Boxplotkann denMedian, die Quartile und Ausreißer der Daten deutlich zeigen.。
Beispiel
plt.figure(figsize=(8, 5))
plt.boxplot(df['fare'].dropna())
plt.title('Fahrpreis-Boxplot')
plt.ylabel⟦⟧'Fahrpreis'('Fare')
plt.show()
Interpretation: Die Mitte der Box ist der Median. Die unteren und oberen Kanten der Box sind das untere Quartil (Q1) und das obere Quartil (Q3). Die oberen und unteren "Whisker" erstrecken sich normalerweise bis zu den am weitesten entfernten Datenpunkten innerhalb des 1.5-fachen des Interquartilsabstands; Punkte darüber hinaus gelten alsAusreißer(die Kreise oben in der Abbildung). Dieses Diagramm sagt uns sofort, dass es viele extrem hohe Ausreißer im Fahrpreis gibt.
2. Kategorische Merkmale: Balkendiagramme
Für Merkmale wiesex(Geschlecht),embarked(Einschiffungshafen),survived(überlebt oder nicht) und andere kategorische Merkmale, verwenden wirBalkendiagramme, um die Anzahl jeder Kategorie zu zählen.
Beispiel
survival_counts = df['sex'].value_counts()
plt.figure(figsize=(8, 5))
plt.bar(survival_counts.index, survival_counts.values, color=['lightblue', 'lightcoral'])
plt.title('Geschlechterverteilung der Passagiere')
plt.xlabel('Geschlecht')
plt.ylabel('Anzahl')
plt.show()
Bivariate Analyse: Beziehungen zwischen Merkmalen untersuchen
Die bivariate Analyse untersuchtdie Beziehung zwischen zweiMerkmalen.
1. Numerisch vs. Numerisch: Streudiagramme
Ein Streudiagramm ist ein leistungsstarkes Werkzeug, um die Korrelation zwischen zwei kontinuierlichen Variablen zu untersuchen.
Beispiel
plt.figure(figsize=(10, 6))
plt.scatter(df['age'], df['fare'], alpha=0.5) # alpha legt die Transparenz fest, um die Punktdichte besser beobachten zu können
plt.title('Streudiagramm Alter vs. Fahrpreis')
plt.xlabel('Alter')
plt.ylabel⟦⟧'Fahrpreis'('Fare')
plt.show()
- Interpretation: Das Verteilungsmuster der Punkte kann auf eine Korrelation hindeuten. Wenn die Punkte beispielsweise ungefähr auf einer diagonalen Linie liegen, deutet dies darauf hin, dass die beiden Variablen korreliert sind. Aus diesem Diagramm lässt sich kein offensichtlicher linearer Zusammenhang zwischen Alter und Fahrpreis erkennen, aber es bestätigt erneut die Existenz hoher Fahrpreise (Ausreißer).
2. Kategorial vs. Numerisch: Gruppierte Boxplots oder Violinplots
Wir wollen oft wissen, wie sich die Verteilung eines numerischen Merkmals zwischen Kategorien unterscheidet. Zum Beispiel: "Wie unterscheidet sich die Fahrpreisverteilung zwischen Passagieren in verschiedenen Klassen?"
Beispiel
plt.figure(figsize=(10, 6))
sns.boxplot(x='pclass', y='fare', data=df)
plt.title('Fahrpreisverteilung nach Passagierklasse')
plt.show()
- Interpretation: Sehr klar! Eine höhere Kabinenklasse (Erste Klasse) hat einen deutlich höheren Median und eine insgesamt größere Spannweite der Ticketpreise. Das entspricht völlig unserem gesunden Menschenverstand.
Violinplotist eine weiterentwickelte Version des Boxplots. Er zeigt nicht nur Statistiken, sondern auch die tatsächliche Verteilungsform der Daten mithilfe der Kerndichteschätzung.
Beispiel
plt.figure(figsize=(10, 6))
sns.violinplot(x='sex', y='age', data=df, inner='quartile') # Der Parameter inner zeigt Quartilslinien an
plt.title('Altersverteilung nach Geschlecht (Violinplot)')
plt.show()
3. Kategorial vs. Kategorial: Gestapelte Balkendiagramme oder Heatmaps
Für zwei kategorische Variablen können wirgestapelte Balkendiagrammeverwenden, um die Kombination zu betrachten. Zum Beispiel: "Wie hoch ist die Überlebensrate nach Geschlecht?"
Beispiel
cross_tab = pd.crosstab(df['sex'], df['survived'], normalize='index') # normalize='index' berechnet Anteile pro Zeile
print(cross_tab)
# Gestapeltes Balkendiagramm zeichnen
cross_tab.plot(kind='bar', stacked=True, figsize=(10, 6), color=['tomato', 'lightgreen'])
plt.title('Überlebensrate nach Geschlecht')
plt.xlabel('Geschlecht')
plt.ylabel('Anteil')
plt.legend(['Nicht überlebt', 'Überlebt'])
plt.show()
Interpretation: Aus dem Diagramm und der Kreuztabelle ist ersichtlich, dass die Überlebensrate von Frauen viel höher ist als die von Männern. Das ist ein sehr starkes Signal, das darauf hinweist, dasssexdas Merkmal ist entscheidend für die Vorhersage des Überlebens.
Multivariate Analyse und fortgeschrittene Visualisierung
Manchmal müssen wir drei oder sogar mehr Variablen gleichzeitig betrachten.seabornDie Bibliothek macht das einfach.
1. Streudiagramm mit Gruppierung
Anhand eines Streudiagramms können wir Farbe oder Form verwenden, um eine dritte (kategorische) Variable zu unterscheiden.
Beispiel
plt.figure(figsize=(12, 8))
sns.scatterplot(x='age', y='fare', hue='survived', style='survived', data=df, alpha=0.7)
plt.title('Alter vs. Fahrpreis (nach Überlebensstatus eingefärbt)')
plt.show()
- Interpretation: Dieses Diagramm lässt uns intuitiv erkennen, ob sich die Verteilungen der Überlebenden (orange) und der Nichtüberlebenden (blau) im zweidimensionalen Raum von "Alter-Fahrpreis" unterscheiden.
2. Korrelationsmatrix-Heatmap
Wenn wir mehrere numerische Merkmale haben, können wir die paarweisen Korrelationskoeffizienten auf einmal berechnen und sie mit einer Heatmap darstellen.
Beispiel
numeric_df = df.select_dtypes(include=['float64', 'int64'])
# Korrelationskoeffizientenmatrix berechnen
corr_matrix = numeric_df.corr()
# Heatmap zeichnen
plt.figure(figsize=(12, 8))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', center=0, square=True)
plt.title('Korrelationsmatrix-Heatmap numerischer Merkmale')
plt.show()
Interpretation: Wärmere Farben (rot) weisen auf eine stärkere positive Korrelation hin; kühlere Farben (blau) weisen auf eine stärkere negative Korrelation hin.annot=TrueZeigen Sie die spezifischen Werte in den Zellen an. Zum Beispiel,pclass(Kabinenklasse) undfare(Fahrpreis) haben eine starke negative Korrelation (-0.55), was bedeutet, dass je kleiner die Klassennummer (höhere Klasse), desto höher der Fahrpreis ist, was mit unserer vorherigen Analyse übereinstimmt.
Praktische Übung: Praxisnahe Erkundung
Versuchen Sie nun, die folgenden Übungen abzuschließen, um das Gelernte zu festigen:
- Dateninspektion: Verwenden Sie
df.isnull().sum()um zu prüfen, welche Spalten im Datensatz fehlende Werte haben und wie viele fehlen. - Verteilung darstellen: Für die
ageSpalte, zeichnen Sie einViolindiagramm, und gruppieren Sie nachsurvived(Überlebensstatus) mitsns.violinplot(x='survived', y='age', data=df)). Beobachten Sie, wie sich die Altersverteilungen von Überlebenden und Nicht-Überlebenden unterscheiden. - Beziehungen erkunden: Verwenden Sie
sns.countplot(x='pclass', hue='survived', data=df), um ein Balkendiagramm der Häufigkeiten zu zeichnen und die Anzahl der Überlebenden in verschiedenen Kabinenklassen zu vergleichen. Welche Schlussfolgerung können Sie ziehen? - (Herausforderung) Multivariater Plot: Versuchen Sie, eineStreudiagrammmatrixzu zeichnen, um auf einmal zu betrachten
age、fare、parch(Eltern-/Kind-Anzahl) und die paarweisen Beziehungen zwischen diesen numerischen Variablen. Hinweis: Sie könnensns.pairplot(df[['age', 'fare', 'parch', 'survived']], hue='survived')。
Zusammenfassung
Datenvisualisierung ist einunverzichtbarer explorativer Schrittim Workflow des maschinellen Lernens. In diesem Artikel haben Sie gelernt:
Kernwerkzeuge: Verwenden Siematplotlibfür grundlegende Diagrammerstellung, und verwenden Sieseaborn, um schönere und informativere statistische Grafiken zu zeichnen.
Analyseansatz:
- Univariate Analyse: Verwenden Sie Histogramme/Boxplots, um Verteilungen zu sehen, und Balkendiagramme, um Häufigkeiten zu zählen.
- Bivariate Analyse: Verwenden Sie Streudiagramme für numerische Beziehungen, gruppierte Boxplots für die Auswirkung von Kategorien auf numerische Werte und gestapelte Balkendiagramme für Kategorienkombinationen.
- Multivariate Analyse: Verwenden Sie farbige Streudiagramme und Korrelations-Heatmaps, um komplexere Muster aufzudecken.
Kernziel: Alle Diagramme sollenHypothesen vorschlagenundund Erkenntnisse gewinnen, zum Beispiel könnte das Geschlecht ein wichtiges prädiktives Merkmal sein, und es gibt viele Ausreißer in den Fahrpreisdaten, die behandelt werden müssen.
Denken Sie daran: Bevor Sie Daten in ein Modell einspeisen, sollten Sie sich unbedingt Zeit nehmen, sie sorgfältig anzusehen. Eine klare Erkenntnis aus der Visualisierung kann Sie oft früher in die richtige Richtung führen als komplexe Algorithmen.
Andere Erweiterungen Linux-Befehlsreferenz