Algorithmen für maschinelles Lernen
Algorithmen für maschinelles Lernen lassen sich in Kategorien wie überwachtes Lernen, unüberwachtes Lernen und bestärkendes Lernen einteilen.
Algorithmen für überwachtes Lernen:
- Lineare Regression(Linear Regression): Wird für Regressionsaufgaben verwendet, zur Vorhersage kontinuierlicher Werte.
- Logistische Regression(Logistic Regression): Wird für binäre Klassifikationsaufgaben verwendet, zur Vorhersage von Kategorien.
- Support Vector Machine(SVM): Wird für Klassifikationsaufgaben verwendet, wobei eine Hyperebene zur Klassifikation konstruiert wird.
- Entscheidungsbaum(Decision Tree): Eine Klassifikations- oder Regressionsmethode, die Entscheidungen auf Basis einer Baumstruktur trifft.
Unüberwachte Lernalgorithmen:
- K-means-Clustering: Gruppiert Daten anhand von Clusterzentren.
- Hauptkomponentenanalyse (PCA): Wird zur Dimensionsreduktion verwendet, wobei die Hauptkomponenten der Daten extrahiert werden.
Jeder Algorithmus hat seine anwendbaren Szenarien. In praktischen Anwendungen können Sie den am besten geeigneten Machine-Learning-Algorithmus basierend auf den Eigenschaften der Daten auswählen (z. B. ob Labels vorhanden sind, Datendimensionen usw.).
| Klassifikationsdimension | Kategorie | Kerndefinition | Typische Algorithmen | Zentrale Vor- und Nachteile | Geeignete Szenarien |
|---|---|---|---|---|---|
| Lernmethode | Überwachtes Lernen | Lernen der Abbildung von Eingaben auf Ausgaben mithilfe gelabelter Daten | Logistic Regression, SVM, Decision Tree, CNN, LSTM | Vorteile: hohe Vorhersagegenauigkeit; Nachteile: hängt von hochwertigen gelabelten Daten ab | Klassifikation, Regression, Bilderkennung, Textübersetzung |
| Unüberwachtes Lernen | Nicht gelabelte Daten verwenden, um intrinsische Muster in Daten zu erkennen | K-Means, PCA, DBSCAN, Autoencoders | Vorteile: keine Kennzeichnung erforderlich; Nachteile: schwache Interpretierbarkeit der Ergebnisse | Datenclustering, Dimensionsreduktion, Anomalieerkennung, Nutzersegmentierung | |
| Semi-überwachtes Lernen | Mit einer kleinen Menge gelabelter Daten und einer großen Menge nicht gelabelter Daten trainieren | Semi-überwachte SVM, Label-Propagation-Algorithmen | Vorteile: reduziert Labeling-Kosten; Nachteile: komplexes Modelldesign | Medizinische Bildanalyse, NLP für Nischensprachen | |
| Bestärkendes Lernen | Das Modell optimiert seine Richtlinie durch Interaktion mit der Umgebung und Belohnungssignalen | Q-Learning、DQN、PPO | Vorteile: geeignet für dynamische Entscheidungsfindung; Nachteile: lange Trainingszyklen | Spiel-KI, Robotersteuerung, Optimierung von Empfehlungsrichtlinien | |
| Aufgabenziel | Klassifikationsalgorithmen | Diskrete Klassenlabels vorhersagen | Logistische Regression, Random Forest, CNN | Vorteile: geeignet für Klassifikationsszenarien; Nachteile: empfindlich gegenüber Klassenungleichgewicht | Spam-Erkennung, Bildklassifikation, Krankheitsdiagnose |
| Regressionsalgorithmen | Vorhersage kontinuierlicher numerischer Ausgaben | Lineare Regression, Ridge-Regression, XGBoost | Vorteile: liefert kontinuierliche Werte; Nachteile: empfindlich gegenüber Ausreißern | Immobilienpreisvorhersage, Verkaufsvorhersage, Temperaturvorhersage | |
| Clustering-Algorithmen | Ähnliche Daten ohne Labels zu einer Klasse gruppieren | K-Means, Hierarchisches Clustering, DBSCAN | Vorteile: automatische Gruppierung; Nachteile: Clustering-Effekt hängt von der Distanzmetrik ab | Marktsegmentierung, Nutzerprofilerstellung, Anomalieerkennung | |
| Dimensionsreduktionsalgorithmen | Merkmalsdimensionen reduzieren und dabei Kerninformationen beibehalten | PCA, t-SNE, LDA | Vorteile: reduziert den Rechenaufwand; Nachteile: kann einige Informationen verlieren | Visualisierung hochdimensionaler Daten, Merkmalsvorverarbeitung | |
| Modellstruktur | Lineare Modelle | Annahme einer linearen Beziehung zwischen Eingabe und Ausgabe | Lineare Regression, Logistische Regression, Ridge-Regression | Vorteile: starke Interpretierbarkeit, schnelles Training; Nachteile: schwierig, nichtlineare Zusammenhänge abzubilden | Einfache Klassifikation/Regression, Erstellung von Baseline-Modellen |
| Baummodelle | Auf Entscheidungsbäumen basierend, verarbeiten nichtlineare Zusammenhänge | Entscheidungsbaum, Random Forest, XGBoost, LightGBM | Vorteile: keine Feature-Normalisierung nötig; Nachteile: zu tiefe Bäume neigen zu Overfitting | Klassifikation/Regression in Industriequalität, Aufgaben auf Wettbewerbsniveau | |
| Neuronale Netzwerkmodelle | Mehrschichtige Neuronstrukturen, die automatisch komplexe Merkmale extrahieren | ANN, CNN, RNN, Transformer | Vorteile: bildet komplexe Zusammenhänge ab; Nachteile: erfordert große Datenmengen und Rechenleistung | Bilderkennung, NLP, Sprachsynthese | |
| Probabilistische Modelle | Basierend auf Wahrscheinlichkeitstheorie und Statistik, berechnen Wahrscheinlichkeitsverteilungen | Naive Bayes, Hidden-Markov-Modelle | Vorteile: solide theoretische Grundlage; Nachteile: beruht auf starken Annahmen | Textklassifikation, Spracherkennung, Sequenzmarkierung |
Algorithmen für überwachtes Lernen
Lineare Regression
Die lineare Regression ist ein Algorithmus für Regressionsprobleme. Sie prognostiziert eine kontinuierliche Ausgabe, indem sie die lineare Beziehung zwischen Eingabemerkmalen und Zielwerten lernt.
Anwendungsszenarien:Vorhersage von Hauspreisen, Aktienkursen usw.
Das Ziel der linearen Regression ist es, eine optimale lineare Gleichung zu finden:
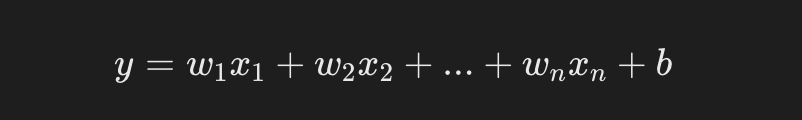
- y ist der vorhergesagte Wert (Zielwert).
- x1,x2,xnist das Eingabemerkmal.
- w1,w2,wnsind die zu lernenden Gewichte (Modellparameter).
- b ist der Bias-Term.
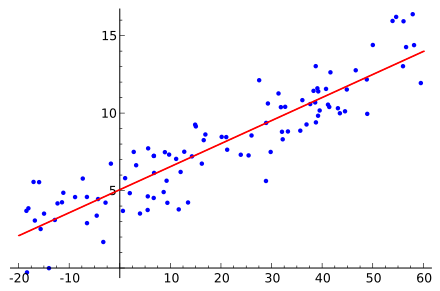
Als Nächstes verwenden wir sklearn, um eine einfache Hauspreisvorhersage durchzuführen:
Beispiel
from sklearn.model_selection import train_test_split
import pandas as pd
# Angenommen, wir haben einen einfachen Datensatz mit Hauspreisen
data = {
'area': [50, 60, 80, 100, 120],
'price': [150, 180, 240, 300, 350]
}
df = pd.DataFrame(data)
# Merkmale und Zielwerte
X = df[['area']]
y = df['price']
# Datenaufteilung
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Ein lineares Regressionsmodell trainieren
model = LinearRegression()
model.fit(X_train, y_train)
# Vorhersagen
y_pred = model.predict(X_test)
print(f"Vorhergesagter Immobilienpreis: {y_pred}")
Die Ausgabe ist:
预测的房价: [180.8411215]
Logistische Regression
Die logistische Regression ist ein Algorithmus für Klassifikationsprobleme. Trotz des Begriffs "Regression" in ihrem Namen wird sie für binäre Klassifikationsprobleme verwendet.
Die logistische Regression sagt ein Klassenlabel voraus, indem sie die Beziehung zwischen Eingabemerkmalen und Kategorien erlernt.
Anwendungsszenarien:Spam-Klassifizierung, Krankheitsdiagnose (ob die Krankheit vorliegt).
Die Ausgabe der logistischen Regression ist ein Wahrscheinlichkeitswert, der die Wahrscheinlichkeit angibt, dass eine Stichprobe zu einer bestimmten Klasse gehört.
Verwendet üblicherweise die Sigmoid-Funktion:
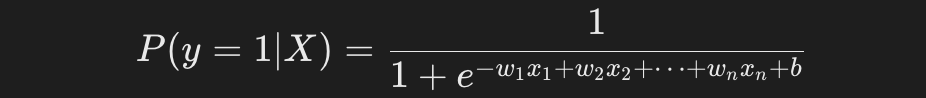
Logistische Regression für eine binäre Klassifizierungsaufgabe verwenden:
Beispiel
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Laden des Iris-Datensatzes
iris = load_iris()
X = iris.data
y = iris.target
# Nur die ersten beiden Klassen für die binäre Klassifizierung verwenden
X = X[y != 2]
y = y[y != 2]
# Datenaufteilung
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Ein logistisches Regressionsmodell trainieren
model = LogisticRegression()
model.fit(X_train, y_train)
# Vorhersagen
y_pred = model.predict(X_test)
# Modell bewerten
print(f"Klassifikationsgenauigkeit: {accuracy_score(y_test, y_pred):.2f}")
Die Ausgabe ist:
分类准确率: 1.00
Support-Vektor-Maschine (SVM)
Die Support-Vektor-Maschine ist ein häufig verwendeter Klassifikationsalgorithmus. Sie konstruiert eine Hyperebene, um den Margin zwischen den Klassen zu maximieren und den Klassifikationsfehler zu minimieren.
Anwendungsszenarien:Textklassifikation, Gesichtserkennung usw.
SVM für die Iris-Klassifikationsaufgabe verwenden:
Beispiel
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Laden des Iris-Datensatzes
iris = load_iris()
X = iris.data
y = iris.target
# Datenaufteilung
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# SVM-Modell trainieren
model = SVC(kernel='linear')
model.fit(X_train, y_train)
# Vorhersagen
y_pred = model.predict(X_test)
# Modell bewerten
print(f"SVM-Klassifikationsgenauigkeit: {accuracy_score(y_test, y_pred):.2f}")
Die Ausgabe ist:
SVM 分类准确率: 1.00
Entscheidungsbaum
Ein Entscheidungsbaum ist eine auf Baumstrukturen basierende Klassifikations- und Regressionsmethode zur Entscheidungsfindung. Er bestimmt anhand einer Reihe von "Entscheidungsbedingungen", zu welcher Klasse eine Stichprobe gehört.
Anwendungsszenarien:Kundenklassifizierung, Kredit-Scoring usw.
Verwenden Sie einen Entscheidungsbaum für eine Klassifizierungsaufgabe:
Beispiel
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Laden des Iris-Datensatzes
iris = load_iris()
X = iris.data
y = iris.target
# Datenaufteilung
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Ein Entscheidungsbaummodell trainieren
model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)
# Vorhersage
y_pred = model.predict(X_test)
# Modell bewerten
print(f"Genauigkeit der Entscheidungsbaumklassifizierung: {accuracy_score(y_test, y_pred):.2f}")
Das Ausgabeergebnis ist:
决策树分类准确率: 1.00
Unüberwachte Lernalgorithmen
K-Means-Clustering
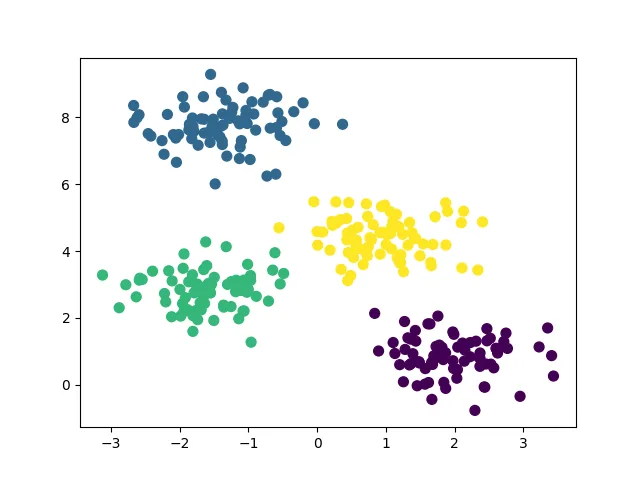
K-Means ist ein zentroidbasiertes Clustering-Verfahren, das die Cluster-Zentroide kontinuierlich anpasst, sodass Datenpunkte in jedem Cluster so nah wie möglich am Clusterzentrum liegen.
Anwendungsszenarien:Kundensegmentierung, Marktanalyse, Bildkomprimierung.
K-Means für die Kundensegmentierung verwenden:
Beispiel
from sklearn.datasets import make_blobs
import matplotlib.pyplot as plt
# Erzeuge einen einfachen 2D-Datensatz
X, _ = make_blobs(n_samples=300, centers=4, cluster_std=0.60, random_state=0)
# Trainiere K-means-Modell
model = KMeans(n_clusters=4)
model.fit(X)
# Clustering-Ergebnisse vorhersagen
y_kmeans = model.predict(X)
# Clustering-Ergebnisse visualisieren
plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.show()
Die Ausgabegrafik ist unten dargestellt:
Hauptkomponentenanalyse (PCA)
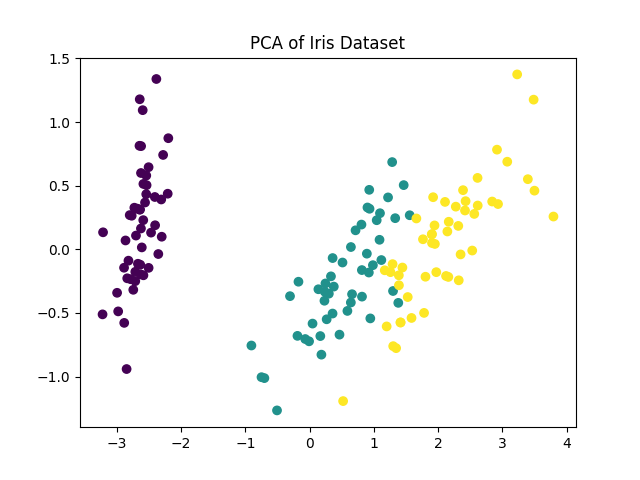
PCA ist eine Technik zur Dimensionsreduktion, die Daten durch lineare Transformation in ein neues Koordinatensystem überführt und den größten Teil der Varianz in den ersten wenigen Hauptkomponenten konzentriert.
Anwendungsszenarien:Dimensionsreduktion von Bildern, Merkmalsauswahl, Datenvisualisierung.
Verwendung von PCA zur Dimensionsreduktion und Visualisierung hochdimensionaler Daten:
Beispiel
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt
# Laden des Iris-Datensatzes
iris = load_iris()
X = iris.data
y = iris.target
# Auf 2 Dimensionen reduzieren
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)
# Ergebnisse visualisieren
plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, cmap='viridis')
plt.title('PCA des Iris-Datensatzes')
plt.show()
Die Ausgabegrafik ist unten dargestellt:
Algorithmen für maschinelles Lernen
| Vollständiger chinesischer Name | Englischer vollständiger Name | Abkürzung | Kernanwendungsszenarien |
|---|---|---|---|
| Traditionelle Algorithmen des maschinellen Lernens | |||
| Entscheidungsbaum | Entscheidungsbaum | DT | Klassifikation, Regression, Analyse der Feature-Wichtigkeit |
| Random Forest | Random Forest | RF | Klassifikation, Regression, Anomalieerkennung, Feature-Auswahl |
| Logistische Regression | Logistische Regression | LR | Binäre Klassifikationsaufgaben, Wahrscheinlichkeitsvorhersage, Kredit-Scoring |
| Support-Vektor-Maschine | Support-Vektor-Maschine | SVM | Klassifikation, hochdimensionale Daten mit kleinem Stichprobenumfang, Textklassifikation |
| Naive Bayes | Naive Bayes | NB | Textklassifikation, Spam-Erkennung, Sentimentanalyse |
| Gradient-Boosting-Baum | Gradient-Boosting-Entscheidungsbaum | GBDT | Klassifikation, Regression, Ranking-Aufgaben |
| Extremes Gradienten-Boosting | Extremes Gradienten-Boosting | XGBoost | Hochpräzise Klassifikation und Regression, Aufgaben auf Wettbewerbsniveau, Klickratenvorhersage |
| Leichte Gradient-Boosting-Maschine | Leichte Gradient-Boosting-Maschine | LightGBM | Klassifikation und Regression großer Datenmengen, Echtzeitvorhersage, Empfehlungssysteme |
| K-Nächste-Nachbarn-Algorithmus | K-Nächste-Nachbarn | KNN | Einfache Klassifikation und Regression, Empfehlungssysteme, Anomalieerkennung |
| K-Means-Clustering | K-Means-Clustering | K-Means | Datenclustering, Nutzersegmentierung, Bildsegmentierung |
| Hauptkomponentenanalyse | Hauptkomponentenanalyse | PCA | Dimensionsreduktion von Daten, Visualisierung hochdimensionaler Daten, Merkmalsentrauschung |
| Deep-Learning-Algorithmen | |||
| Künstliches Neuronales Netz | Künstliches Neuronales Netz | ANN | Einfache Klassifikation und Regression, Validierung von Baseline-Modellen |
| Faltungsneuronales Netz | Faltungsneuronales Netz | CNN | Bilderkennung, Objekterkennung, Videoanalyse, medizinische Bilddiagnose |
| Rekurrentes Neuronales Netz | Rekurrentes Neuronales Netz | RNN | Verarbeitung sequenzieller Daten, Textgenerierung, Spracherkennung |
| Long Short-Term Memory-Netzwerk | Long Short-Term Memory | LSTM | Übersetzung langer Sequenzen, Sprachübersetzung, Zeitreihenvorhersage |
| Gated Recurrent Unit | Gated Recurrent Unit | GRU | Sequenzklassifikation, Sentimentanalyse, Dialogsysteme |
| Generatives adversarisches Netzwerk | Generatives adversarisches Netzwerk | GAN | Bildgenerierung, Stilübertragung, Datenaugmentierung, Super-Resolution-Rekonstruktion |
| Transformer | Transformer | Transformer | Übersetzung natürlicher Sprache, Textzusammenfassung, multimodale Aufgaben, Basisarchitektur für große Modelle |
| Autoencoder | Autoencoder | AE | Datenkompression, Anomalieerkennung, Merkmalsextraktion |
| Variational Autoencoder | Variational Autoencoder | VAE | Generative Aufgaben, Datenentrauschung, Bildgenerierung |
| Graph-Neuronales Netz | Graph-Neuronales Netz | GNN | Analyse sozialer Netzwerke, Vorhersage von Molekülstrukturen, Wissensgraph-Schlussfolgerung |