Алгоритмы машинного обучения
Алгоритмы машинного обучения можно разделить на категории, такие как обучение с учителем, обучение без учителя и обучение с подкреплением.
Алгоритмы обучения с учителем:
- Линейная регрессия(Линейная регрессия): используется для задач регрессии, прогнозирования непрерывных значений.
- Логистическая регрессия(Логистическая регрессия): используется для задач бинарной классификации, прогнозирования категорий.
- Машина опорных векторов(SVM): используется для задач классификации, построения гиперплоскости для классификации.
- Дерево решений(Дерево решений): метод классификации или регрессии, принимающий решения на основе древовидной структуры.
Алгоритмы обучения без учителя:
- Кластеризация K-средних: группирует данные по центрам кластеров.
- Анализ главных компонент (PCA): используется для снижения размерности, извлечения главных компонент данных.
У каждого алгоритма есть свои сценарии применения. В практических приложениях можно выбрать наиболее подходящий алгоритм машинного обучения на основе характеристик данных (таких как наличие меток, размерность данных и т. д.).
| Критерий классификации | Категория | Основное определение | Типичные алгоритмы | Основные преимущества и недостатки | Применимые сценарии |
|---|---|---|---|---|---|
| Метод обучения | Обучение с учителем | Изучение отображения входов в выходы с использованием размеченных данных | Логистическая регрессия, SVM, дерево решений, CNN, LSTM | Преимущества: высокая точность предсказания; Недостатки: зависит от высококачественных размеченных данных | Классификация, регрессия, распознавание изображений, перевод текста |
| Обучение без учителя | Использование неразмеченных данных для выявления внутренних закономерностей в данных | K-Means, PCA, DBSCAN, автоэнкодеры | Преимущества: не требуется разметка; Недостатки: слабая интерпретируемость результатов | Кластеризация данных, снижение размерности, обнаружение аномалий, сегментация пользователей | |
| Полуконтролируемое обучение | Обучение с малым объёмом размеченных данных и большим объёмом неразмеченных данных | Полуконтролируемый SVM, алгоритмы распространения меток | Преимущества: снижает затраты на разметку; недостатки: сложное проектирование модели | Анализ медицинских изображений, обработка естественного языка для нишевых языков | |
| Обучение с подкреплением | Модель оптимизирует свою политику через взаимодействие со средой и сигналы вознаграждения | Q-Learning、DQN、PPO | Преимущества: подходит для динамического принятия решений; недостатки: длительные циклы обучения | Игровой ИИ, управление роботами, оптимизация политики рекомендаций | |
| Цель задачи | Алгоритмы классификации | Предсказание дискретных меток классов | Логистическая регрессия, случайный лес, CNN | Преимущества: подходит для сценариев классификации; недостатки: чувствительность к дисбалансу классов | Обнаружение спама, классификация изображений, диагностика заболеваний |
| Алгоритмы регрессии | Предсказывают непрерывные числовые выходные значения | Linear Regression, Ridge Regression, XGBoost | Преимущества: выдают непрерывные значения; Недостатки: чувствительны к выбросам | Прогнозирование цен на жильё, прогнозирование продаж, прогнозирование температуры | |
| Алгоритмы кластеризации | Группируют похожие данные в один класс без меток | K-Means, Hierarchical Clustering, DBSCAN | Преимущества: автоматическая группировка; Недостатки: результат кластеризации зависит от метрики расстояния | Сегментация рынка, профилирование пользователей, обнаружение аномалий | |
| Алгоритмы снижения размерности | Снижают размерность признаков, сохраняя основную информацию | PCA, t-SNE, LDA | Преимущества: снижает вычислительные затраты; Недостатки: может потерять часть информации | Визуализация многомерных данных, предварительная обработка признаков | |
| Структура модели | Линейные модели | Предполагают линейную зависимость между входом и выходом | Линейная регрессия, логистическая регрессия, гребневая регрессия | Преимущества: высокая интерпретируемость, быстрое обучение; Недостатки: сложно аппроксимировать нелинейные зависимости | Простая классификация/регрессия, построение базовой модели |
| Древовидные модели | Построены на решающих деревьях, обрабатывают нелинейные зависимости | Дерево решений, случайный лес, XGBoost, LightGBM | Преимущества: не требуется нормализация признаков; Недостатки: слишком глубокие деревья склонны к переобучению | Промышленного уровня классификация/регрессия, задачи уровня соревнований | |
| Модели нейронных сетей | Многослойные нейронные структуры, автоматически извлекающие сложные признаки | ANN、CNN、RNN、Transformer | Преимущества: подходят для сложных взаимосвязей; Недостатки: требуют больших объёмов данных и вычислительных ресурсов | Распознавание изображений, NLP, синтез речи | |
| Вероятностные модели | На основе теории вероятностей и статистики вычисляют распределения вероятностей | Наивный Байес, скрытые марковские модели | Преимущества: прочная теоретическая основа; Недостатки: зависят от сильных предположений | Классификация текста, распознавание речи, разметка последовательностей |
Алгоритмы обучения с учителем
Линейная регрессия
Линейная регрессия — это алгоритм для задач регрессии. Она предсказывает непрерывное выходное значение, изучая линейную зависимость между входными признаками и целевыми значениями.
Сценарии применения:Прогнозирование цен на жильё, цен на акции и т. д.
Цель линейной регрессии — найти оптимальное линейное уравнение:
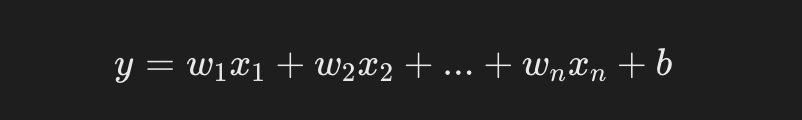
- y — предсказанное значение (целевое значение).
- x1,x2,xn— входной признак.
- w1,w2,wn— обучаемые веса (параметры модели).
- b — это член смещения.
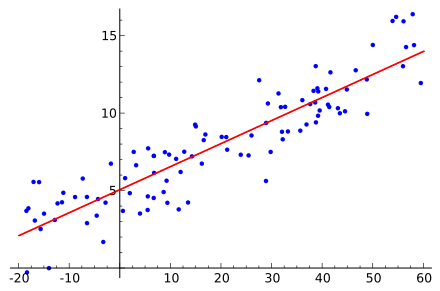
Далее мы используем sklearn для простого прогнозирования цен на жильё:
Пример
from sklearn.model_selection import train_test_split
import pandas as pd
# Предположим, у нас есть простой набор данных о ценах на жильё
data = {
'area': [50, 60, 80, 100, 120],
'price': [150, 180, 240, 300, 350]
}
df = pd.DataFrame(data)
# Признаки и метки
X = df[['area']]
y = df['price']
# Разделение данных
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Обучение модели линейной регрессии
model = LinearRegression()
model.fit(X_train, y_train)
# Прогнозирование
y_pred = model.predict(X_test)
print(f"Прогнозируемая цена жилья: {y_pred}")
Вывод:
预测的房价: [180.8411215]
Логистическая регрессия
Логистическая регрессия — это алгоритм для задач классификации. Несмотря на «регрессию» в названии, он используется для задач бинарной классификации.
Логистическая регрессия предсказывает метку класса, изучая взаимосвязь между входными признаками и категориями.
Сценарии применения:Классификация спама, диагностика заболеваний (наличие заболевания).
Выход логистической регрессии — это значение вероятности, представляющее вероятность того, что образец принадлежит определённому классу.
Обычно используется сигмоидная функция:
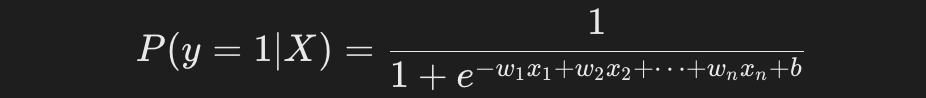
Использование логистической регрессии для задачи бинарной классификации:
Пример
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Загрузить набор данных Iris
iris = load_iris()
X = iris.data
y = iris.target
# Взять только первые два класса для бинарной классификации
X = X[y != 2]
y = y[y != 2]
# Разделение данных
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Обучить модель логистической регрессии
model = LogisticRegression()
model.fit(X_train, y_train)
# Прогнозирование
y_pred = model.predict(X_test)
# Оценка модели
print(f"Точность классификации: {accuracy_score(y_test, y_pred):.2f}")
Вывод:
分类准确率: 1.00
Машина опорных векторов (SVM)
Машина опорных векторов — часто используемый алгоритм классификации. Она строит гиперплоскость, чтобы максимизировать отступ между классами, минимизируя ошибку классификации.
Сценарии применения:Классификация текста, распознавание лиц и т. д.
Использование SVM для задачи классификации ирисов:
Пример
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Загрузить набор данных Iris
iris = load_iris()
X = iris.data
y = iris.target
# Разделение данных
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Обучение модели SVM
model = SVC(kernel='linear')
model.fit(X_train, y_train)
# Прогнозирование
y_pred = model.predict(X_test)
# Оценка модели
print(f"Точность классификации SVM: {accuracy_score(y_test, y_pred):.2f}")
Вывод:
SVM 分类准确率: 1.00
Дерево решений
Дерево решений — это метод классификации и регрессии, основанный на древовидных структурах для принятия решений. Оно определяет, к какому классу принадлежит образец, с помощью серии «условий проверки».
Сценарии применения:Классификация клиентов, кредитный скоринг и т. д.
Использование дерева решений для задачи классификации:
Пример
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Загрузить набор данных Iris
iris = load_iris()
X = iris.data
y = iris.target
# Разделение данных
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Обучение модели дерева решений
model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)
# Предсказание
y_pred = model.predict(X_test)
# Оценка модели
print(f"Точность классификации дерева решений: {accuracy_score(y_test, y_pred):.2f}")
Результат вывода:
决策树分类准确率: 1.00
Алгоритмы обучения без учителя
Кластеризация K-means
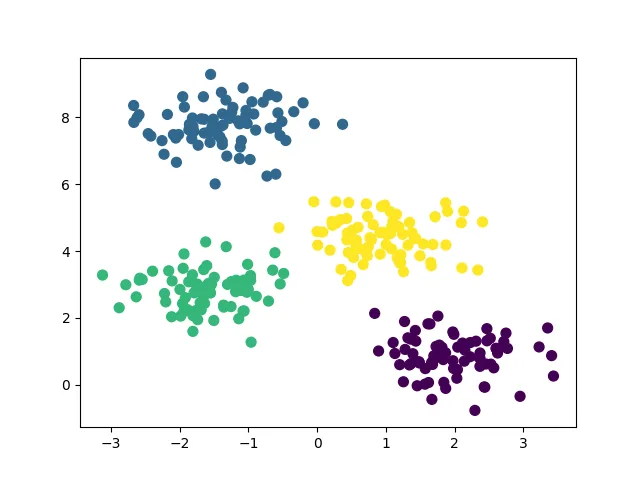
K-means — это алгоритм кластеризации на основе центроидов, который непрерывно корректирует центроиды кластеров так, чтобы точки данных в каждом кластере были как можно ближе к центру кластера.
Сценарии применения:Сегментация клиентов, анализ рынка, сжатие изображений.
Использование K-means для сегментации клиентов:
Пример
from sklearn.datasets import make_blobs
import matplotlib.pyplot as plt
# Сгенерировать простой двумерный набор данных
X, _ = make_blobs(n_samples=300, centers=4, cluster_std=0.60, random_state=0)
# Обучить модель K-means
model = KMeans(n_clusters=4)
model.fit(X)
# Предсказать результаты кластеризации
y_kmeans = model.predict(X)
# Визуализировать результаты кластеризации
plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.show()
Полученный график показан ниже:
Метод главных компонент (PCA)
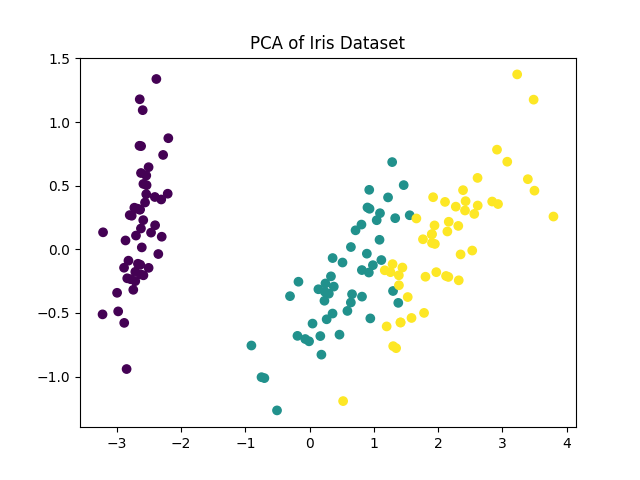
PCA — это метод снижения размерности, который с помощью линейного преобразования переводит данные в новую систему координат, сосредотачивая большую часть дисперсии в первых нескольких главных компонентах.
Сценарии применения:Снижение размерности изображений, отбор признаков, визуализация данных.
Использование PCA для снижения размерности и визуализации многомерных данных:
Пример
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt
# Загрузить набор данных Iris
iris = load_iris()
X = iris.data
y = iris.target
# Уменьшить до 2 измерений
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)
# Визуализировать результаты
plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, cmap='viridis')
plt.title('PCA для набора данных Iris')
plt.show()
Полученный график показан ниже:
Алгоритмы машинного обучения
| Полное название на китайском | Полное название на английском | Сокращение | Основные сценарии применения |
|---|---|---|---|
| Традиционные алгоритмы машинного обучения | |||
| Дерево решений | Дерево решений | DT | Классификация, регрессия, анализ важности признаков |
| Случайный лес | Случайный лес | RF | Классификация, регрессия, обнаружение аномалий, отбор признаков |
| Логистическая регрессия | Логистическая регрессия | LR | Задачи бинарной классификации, прогнозирование вероятности, кредитный скоринг |
| Метод опорных векторов | Метод опорных векторов | SVM | Классификация, данные высокой размерности с малой выборкой, классификация текстов |
| Наивный Байес | Наивный Байес | NB | Классификация текстов, обнаружение спама, анализ тональности |
| Дерево градиентного бустинга | Решающее дерево с градиентным бустингом | GBDT | Классификация, регрессия, задачи ранжирования |
| Экстремальный градиентный бустинг | Экстремальный градиентный бустинг | XGBoost | Высокоточная классификация и регрессия, задачи соревновательного уровня, предсказание кликабельности |
| Машина лёгкого градиентного бустинга | Машина лёгкого градиентного бустинга | LightGBM | Классификация и регрессия на крупномасштабных данных, прогнозирование в реальном времени, рекомендательные системы |
| Алгоритм K-ближайших соседей | K-ближайших соседей | KNN | Простая классификация и регрессия, рекомендательные системы, обнаружение аномалий |
| Кластеризация K-Means | Кластеризация K-Means | K-Means | Кластеризация данных, сегментация пользователей, сегментация изображений |
| Метод главных компонент | Метод главных компонент | PCA | Снижение размерности данных, визуализация многомерных данных, шумоподавление признаков |
| Алгоритмы глубокого обучения | |||
| Искусственная нейронная сеть | Искусственная нейронная сеть | ANN | Простая классификация и регрессия, валидация базовой модели |
| Свёрточная нейронная сеть | Свёрточная нейронная сеть | CNN | Распознавание изображений, обнаружение объектов, анализ видео, диагностика медицинских изображений |
| Рекуррентная нейронная сеть | Рекуррентная нейронная сеть | RNN | Обработка последовательных данных, генерация текста, распознавание речи |
| Сеть долгой краткосрочной памяти | Долгая краткосрочная память | LSTM | Перевод длинных последовательностей текста, синтез речи, прогнозирование временных рядов |
| Рекуррентный блок с вентилями | Рекуррентный блок с вентилями | GRU | Классификация последовательностей, анализ тональности, диалоговые системы |
| Генеративная состязательная сеть | Генеративная состязательная сеть | GAN | Генерация изображений, перенос стиля, аугментация данных, реконструкция сверхвысокого разрешения |
| Трансформер | Трансформер | Трансформер | Перевод на естественном языке, суммаризация текста, мультимодальные задачи, базовая архитектура для больших моделей |
| Автоэнкодер | Автоэнкодер | AE | Сжатие данных, обнаружение аномалий, извлечение признаков |
| Вариационный автоэнкодер | Вариационный автоэнкодер | VAE | Генеративные задачи, шумоподавление данных, генерация изображений |
| Графовая нейронная сеть | Графовая нейронная сеть | GNN | Анализ социальных сетей, предсказание молекулярных структур, рассуждение на графах знаний |