Dépannage des problèmes courants
Les projets d'apprentissage automatique qui passent d'un prototype de laboratoire à un environnement de production rencontrent souvent une série de défis inattendus.
Un modèle performant sur l'ensemble d'entraînement mais qui se comporte mal, voire échoue complètement, après le déploiement réel. C'est un dilemme vécu par de nombreux ingénieurs en apprentissage automatique et débutants.
Cet article recense systématiquement les types de problèmes les plus courants dans l'optimisation et l'ingénierie des modèles d'apprentissage automatique, et fournit des idées de dépannage claires ainsi que des solutions pour vous aider à construire des systèmes d'apprentissage automatique plus robustes et fiables.
I. Problèmes de performance du modèle : bon à l'entraînement, mauvais en production
C'est le problème classique et le plus épineux. Votre modèle atteint 95% de précision dans Jupyter Notebook, mais une fois déployé en ligne, ses performances chutent considérablement.
1. Distribution des données incohérente
C'est le « tueur numéro un » de la dégradation des performances. Il existe une différence de distribution statistique entre les données d'entraînement et les données en ligne en temps réel.
Scénarios courants et points de dépannage :
Ingénierie des caractéristiques incohérente: Le code de traitement des caractéristiques hors ligne (par ex., normalisation, discrétisation, imputation des valeurs manquantes) n'est pas exactement le même que le code du service en ligne.
- Dépannage: Comparez les données d'échantillon après le prétraitement hors ligne et le prétraitement en ligne. Assurez-vous que le Scaler utilisé (par ex.,
StandardScaler) en ligne utilise les paramètres ajustés hors ligne (scaler.mean_,scaler.scale_), plutôt que de réajuster.
Biais temporel de collecte des données: Les données d'entraînement proviennent des trois derniers mois, tandis que les données en ligne proviennent du présent. Le comportement des utilisateurs et les conditions du marché peuvent avoir changé (dérive conceptuelle).
- Dépannage: Surveillez la distribution des caractéristiques d'entrée du modèle au fil du temps. Vous pouvez calculer périodiquement la moyenne, la variance et les quantiles des caractéristiques et les comparer avec l'ensemble d'entraînement.
Biais de sélection des échantillons: Les données d'entraînement ne peuvent pas représenter tous les utilisateurs. Par exemple, entraîner un modèle de recommandation uniquement avec les données des utilisateurs actifs le rendra inefficace pour les nouveaux utilisateurs ou les utilisateurs silencieux.
- Dépannage: Analysez la distribution des profils utilisateurs de l'ensemble d'entraînement et des requêtes en ligne (par ex., ratio nouveaux/anciens utilisateurs, répartition géographique, etc.).
Solution :Mettez en place un système complet desurveillance des donnéeset desurveillance des modèles. Ne surveillez pas seulement la sortie du modèle (par ex., AUC, exactitude), mais surveillez aussi la distribution des caractéristiques d'entrée. Une fois une dérive détectée, déclenchez des alertes et envisagez de mettre à jour les données d'entraînement ou de réentraîner le modèle.
Exemple
import numpy as np
import pandas as pd
# Supposons qu'il s'agit de la valeur de la caractéristique 'feature_a' reçue en temps réel en ligne
online_feature_values = [0.1, 0.5, 1.2, 0.8, 1.5, 2.0, 2.5]
training_mean = 0.5 # Moyenne de 'feature_a' sur l'ensemble d'entraînement
training_std = 0.3 # Écart-type de 'feature_a' sur l'ensemble d'entraînement
current_online_mean = np.mean(online_feature_values[-100:]) # Moyenne des 100 derniers points
# Calculer le score Z pour déterminer simplement si une dérive significative se produit
z_score = (current_online_mean - training_mean) / training_std
print(f"Moyenne actuelle de la caractéristique en ligne : {current_online_mean:.3f}")
print(f"Score Z de la moyenne en ligne par rapport à la moyenne de l'ensemble d'entraînement : {z_score:.3f}")
if abs(z_score) > 3: # Seuil, par ex., 3 écarts-types
print("Avertissement : La caractéristique 'feature_a' peut avoir subi une dérive de distribution !")
2. Fuite de données
Pendant l'entraînement, le modèle "jette un coup d'œil" à des informations qui ne devraient être connues qu'au moment de la prédiction, ce qui gonfle les résultats d'évaluation.
Scénarios courants :
- Avant de diviser l'ensemble d'entraînement/de testavantune normalisation globale ou une imputation des valeurs manquantes a été effectuée (en utilisant des informations de l'ensemble de test).
- Dans les problèmes de séries temporelles, des données futures sont utilisées pour prédire le passé.
- Les caractéristiques contiennent des "informations futures" fortement liées à la variable cible (par exemple, utiliser "si une réclamation a été reçue aujourd'hui" pour prédire "si la commande sera annulée aujourd'hui").
Dépannage et résolution :Suivre strictement le flux de travail d'apprentissage automatique.Toute opération qui apprend des paramètres à partir des données (comme l'ajustement d'un Scaler, l'imputation des valeurs manquantes, la sélection de caractéristiques) doit être effectuée sur l'ensemble d'entraînement, puis seuls ces paramètres sont utilisés pour transformer les ensembles de validation et de test.UtilisationsklearndePipelinepeut efficacement éviter ce problème.
Exemple
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
# X, y sont les données et étiquettes d'origine
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X) # Incorrect ! Ici, toutes les données sont utilisées pour ajuster le scaler
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2)
# À ce stade, les informations dans X_test ont "fuité" vers le scaler, affectant ainsi la transformation de X_train
# Exemple correct : diviser d'abord, puis traiter séparément
X_train_raw, X_test_raw, y_train, y_test = train_test_split(X, y, test_size=0.2)
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train_raw) # Ajuster en utilisant uniquement l'ensemble d'entraînement
X_test = scaler.transform(X_test_raw) # Utiliser les paramètres ajustés sur l'ensemble d'entraînement pour transformer l'ensemble de test
II. Problèmes d'ingénierie et de déploiement
Transformer un modèle d'un fichier en une API hautement disponible pouvant être servie de manière stable est semé d'embûches.
1. Dépendances d'environnement et conflits de versions
"Ça marche sur ma machine !" — un problème classique. La version de Python et les versions des bibliothèques dans l'environnement d'entraînement ne correspondent pas à celles de l'environnement d'inférence en ligne.
Liste de contrôle de dépannage :
- Version majeure de Python (3.7 vs 3.9)
- Versions des bibliothèques principales (
tensorflow==2.8vstensorflow==2.12) - Dépendances système (par ex., certaines bibliothèques dépendent de bibliothèques d'exécution C++ spécifiques)
- Format de sérialisation du modèle (en utilisant
picklele SavedModel, si l'écart de versions Python est important, peut échouer à se charger)
Solution :
- Conteneurisation: Utilisez Docker pour empaqueter le modèle et toutes ses dépendances dans une seule image. C'est la référence absolue pour garantir la cohérence de l'environnement.
- Gestion des dépendances: Utilisez
requirements.txtouenvironment.ymlpour enregistrer précisément tous les paquets et leurs versions. - Format de modèle: Envisagez d'utiliser un format de modèle inter-langages et inter-environnements, tel queONNXouPMML, ou un format sûr natif du framework (par ex.,
TensorFlow SavedModel,PyTorch TorchScript)。
2. Performances médiocres en inférence en ligne
Le temps de réponse de l'API est trop long, et le débit (TPS) ne parvient pas à suivre, ne répondant pas aux exigences métier.
Goulots d'étranglement et optimisations courants :
- Coût élevé par prédiction unique: Le modèle lui-même est complexe (par ex., un grand modèle d'apprentissage profond).
- Optimisation: Élagage de modèle, quantification, distillation de connaissances ou réécriture avec une architecture de modèle plus efficace.
- Appels d'E/S ou réseau fréquents: Chaque prédiction nécessite de récupérer des caractéristiques depuis une base de données ou un service distant.
- Optimisation: Mettre en place une mise en cache des caractéristiques, un précalcul ou un service de caractéristiques pour réduire la latence.
- Non-utilisation de l'accélération matérielle: Exécuter un modèle adapté au GPU sur CPU.
- Optimisation: Choisir le bon matériel d'inférence (CPU/GPU/puces d'IA dédiées) et le bon framework d'inférence (par ex.,
TensorRT,OpenVINO)。
- Optimisation: Choisir le bon matériel d'inférence (CPU/GPU/puces d'IA dédiées) et le bon framework d'inférence (par ex.,
- Faible efficacité du framework de service: L'utilisation de Flask pour charger directement le modèle a une faible capacité de gestion de la concurrence.
- Optimisation: Utiliser un framework de service ML hautes performances, tel queTensorFlow Serving, TorchServe, ouTriton Inference Server. Ils prennent en charge des fonctionnalités avancées telles que le rechargement à chaud des modèles, le traitement par lots dynamique et l'hébergement multi-modèles.
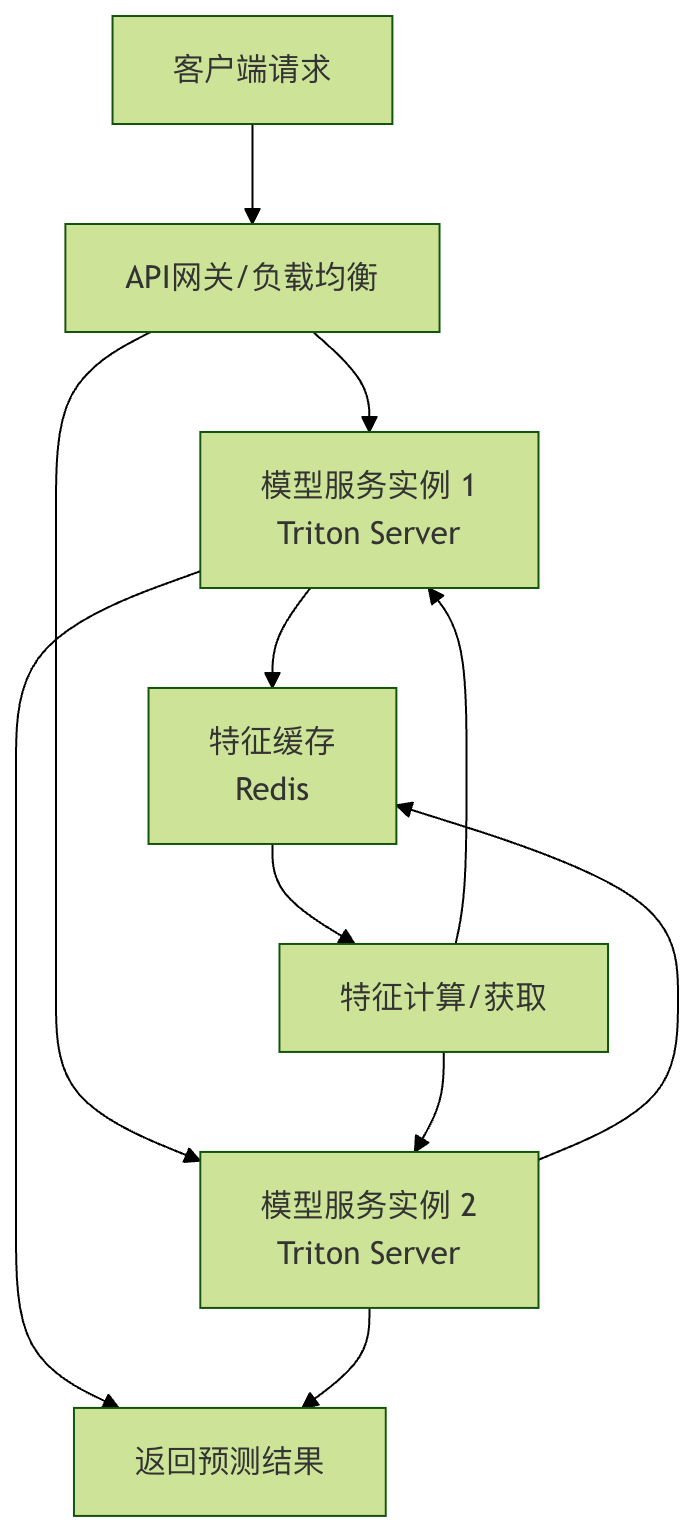
Figure : Un exemple d'architecture de service de modèle hautes performances, incluant l'équilibrage de charge, la mise en cache des caractéristiques et un serveur de modèle dédié.
3. Gestion inappropriée des ressources
Le service de modèle a des fuites de mémoire, ou l'utilisation de la mémoire ne cesse d'augmenter au fil du temps, finissant par faire planter le service.
Dépannage :
- Approche de chargement du modèle: Le modèle est-il rechargé à chaque requête ? L'approche correcte consiste à le charger en mémoire une seule fois au démarrage du service et à le partager pour les requêtes suivantes.
- Accumulation de variables globales: Y a-t-il un List ou un Dict global dans le code du service qui continue d'accumuler des données sans être nettoyées ?
- Résultats de prédiction volumineux: Les résultats de prédiction renvoyés (par exemple, des images, de grands textes) occupent-ils une grande quantité de mémoire et ne sont-ils pas libérés à temps ?
Solution :
- Utilisation
gunicorn、uvicornserveurs multi-processus/asynchrones, comprenez leur modèle Worker. - Redémarrez régulièrement le processus de service (via un outil de gestion de processus tel que
systemdousupervisor)。 - Utilisez des outils professionnels d'analyse de mémoire (par exemple,
memory_profiler) pour localiser le point de fuite.
III. Problèmes de modèle et d'algorithme
1. Surapprentissage et sous-apprentissage
C'est un problème fondamental de capacité du modèle.
| Problème | Symptôme | Causes possibles | Solution |
|---|---|---|---|
| Sous-apprentissage | Performance sur l'ensemble d'entraînement et l'ensemble de validationLes deux sont médiocres | Le modèle est trop simple (faible complexité), caractéristiques insuffisantes, pas assez d'époques d'entraînement | Augmenter la complexité du modèle, ajouter des caractéristiques plus efficaces, augmenter les époques d'entraînement |
| Surapprentissage | Performance sur l'ensemble d'entraînementTrès bonne, performance sur l'ensemble de validationTrès mauvaise | Le modèle est trop complexe, trop peu de données d'entraînement, trop de bruit | Augmenter les données d'entraînement, utiliser la régularisation (L1/L2/Dropout), réduire la complexité du modèle, arrêt précoce |
Dépannage :Tracer les courbes d'apprentissage est le meilleur moyen de juger la situation d'ajustement.
2. Disparition/Explosion des gradients
Courant lors de l'entraînement de réseaux de neurones profonds, entraînant l'incapacité du modèle à converger ou l'instabilité de l'entraînement.
Symptômes :
- La perte du modèle devient
NaN。 - Les valeurs des poids deviennent extrêmement grandes ou extrêmement petites.
- Au début de l'entraînement, la valeur de perte ne change plus.
Solutions :
- Initialisation des poids: Utiliser
He初始化(fonction d'activation ReLU) ouXavier初始化(Tanh/Sigmoid). - Écrêtage du gradient: Définir un seuil et écrêter le gradient lorsqu'il dépasse ce seuil.
- Normalisation par lots: Ajouter une
BatchNormcouche avant la fonction d'activation, ce qui peut stabiliser l'entraînement et permettre l'utilisation d'un taux d'apprentissage plus élevé. - Ajuster l'architecture du réseau: Utiliser des structures telles que les connexions résiduelles dans ResNet.
IV. Établir un processus de dépannage systématique
Lorsque des problèmes surviennent avec un modèle en ligne, un processus de dépannage systématique peut vous aider à localiser rapidement le problème.
- Confirmer le problème: Toutes les prédictions sont-elles fausses, ou est-ce spécifique à certains groupes/scénarios ? Quel est le taux d'erreur ?
- Vérifier l'entrée: Obtenir un lot de données de requête qui ont échoué en ligne, vérifier si les caractéristiques d'entrée sont complètes, si le format est correct, et si les valeurs se situent dans une plage raisonnable (comme l'apparition de
NaN,Infou de valeurs extrêmes). - Reproduire localement: Utilisez les données d'entrée qui ont échoué en ligne, et dans l'environnement de développement local, utilisezle même modèle et le même codepour faire des prédictions, et voyez si le problème peut être reproduit.
- Comparer les données: Comparez la distribution des données des requêtes en ligne avec la distribution des données d'entraînement, et vérifiez s'il existe une dérive.
- Vérifier le code et la configuration: Vérifiez si la version du code, la version du fichier de modèle et le fichier de configuration du service en ligne sont cohérents avec l'environnement qui a passé les tests.
- Vérifier les journaux et la surveillance: Vérifiez si les journaux du service comportent des erreurs anormales, et si les métriques de CPU, de mémoire et de temps de réponse dans le système de surveillance sont anormales.
- Simplifier et localiser: Si possible, essayez d'utiliser un modèle minimaliste ou un système à base de règles pour traiter l'entrée erronée, et déterminez s'il s'agit d'un problème de données ou d'un problème de modèle.