Устранение распространённых проблем
Проекты машинного обучения, переходящие из лабораторного прототипа в производственную среду, часто сталкиваются с рядом неожиданных проблем.
Модель хорошо работает на обучающем наборе, но плохо работает или даже полностью отказывает после фактического развёртывания. С такой дилеммой сталкиваются многие инженеры по машинному обучению и новички.
В этой статье систематизированы наиболее распространённые типы проблем в оптимизации и инженерии моделей машинного обучения, а также приведены чёткие идеи и решения по устранению неполадок, которые помогут вам создавать более устойчивые и надёжные системы машинного обучения.
I. Проблемы производительности модели: хорошо при обучении, плохо в производственной среде
Это классическая и самая проблемная проблема. Ваша модель достигает точности 95% в Jupyter Notebook, но после развёртывания в онлайн-среде её производительность резко падает.
1. Несогласованное распределение данных
Это «убийца номер один» для деградации производительности. Существует различие в статистическом распределении между обучающими данными и онлайн-данными в реальном времени.
Типичные сценарии и пункты диагностики:
Несогласованное конструирование признаков: Код офлайн-обработки признаков (например, нормализация, бакетирование, заполнение пропущенных значений) не совсем совпадает с кодом в онлайн-сервисе.
- Диагностика: Сравните образцы данных после офлайн-предобработки и онлайн-предобработки. Убедитесь, что используемый Scaler (например,
StandardScaler) онлайн использует параметры, обученные офлайн (scaler.mean_,scaler.scale_), а не выполняет повторное обучение.
Временное смещение при сборе данных: Обучающие данные взяты за последние три месяца, тогда как онлайн-данные поступают из настоящего. Поведение пользователей и рыночные условия могли измениться (концептуальный дрейф).
- Диагностика: Отслеживайте распределение входных признаков модели с течением времени. Можно периодически вычислять среднее, дисперсию и квантили признаков и сравнивать их с обучающим набором.
Смещение при отборе выборки: Обучающие данные не могут представлять всех пользователей. Например, обучение рекомендательной модели только на данных активных пользователей приведёт к тому, что она не будет работать для новых или молчаливых пользователей.
- Диагностика: Проанализируйте распределение профилей пользователей в обучающем наборе и онлайн-запросах (например, соотношение новых и старых пользователей, географическое распределение и т. д.).
Решение:Создайте комплекснуюсистему мониторинга данныхимониторинга модели. Отслеживайте не только выход модели (например, AUC, accuracy), но и распределение входных признаков. Как только будет обнаружен дрейф, запускайте оповещения и рассмотрите возможность обновления обучающих данных или переобучения модели.
Пример
import numpy as np
import pandas as pd
# Предположим, это значение признака 'feature_a', полученное в режиме реального времени онлайн
online_feature_values = [0.1, 0.5, 1.2, 0.8, 1.5, 2.0, 2.5]
training_mean = 0.5 # Среднее значение 'feature_a' на обучающем наборе
training_std = 0.3 # Стандартное отклонение 'feature_a' на обучающем наборе
current_online_mean = np.mean(online_feature_values[-100:]) # Среднее значение последних 100 точек
# Рассчитайте Z-оценку, чтобы просто определить, возникает ли значительный дрейф
z_score = (current_online_mean - training_mean) / training_std
print(f"Текущее среднее значение признака онлайн: {current_online_mean:.3f}")
print(f"Z-оценка среднего онлайн относительно среднего по обучающему набору: {z_score:.3f}")
if abs(z_score) > 3: # Порог, например, 3 стандартных отклонения
print("Предупреждение: признак 'feature_a', возможно, подвергся дрейфу распределения!")
2. Утечка данных
Во время обучения модель "подсматривает" информацию, которая должна быть известна только во время предсказания, что приводит к завышенным результатам оценки.
Распространённые сценарии:
- Перед разделением на обучающую/тестовую выборкидо того какбыла выполнена глобальная нормализация или заполнение пропущенных значений (с использованием информации из тестовой выборки).
- В задачах временных рядов будущие данные используются для предсказания прошлого.
- Признаки содержат "будущую информацию", сильно связанную с целевой переменной (например, использование "была ли сегодня получена жалоба" для предсказания "будет ли сегодня отменён заказ").
Диагностика и устранение проблем:Строго следуйте рабочему процессу машинного обучения.Любая операция, которая изучает параметры из данных (например, подгонка Scaler, заполнение пропущенных значений, отбор признаков), должна выполняться на обучающей выборке, и затем только эти параметры используются для преобразования валидационной и тестовой выборок.ИспользованиеsklearnизPipelineможет эффективно избежать этой проблемы.
Пример
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
# X, y — исходные данные и метки
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X) # Неправильно! Здесь все данные используются для обучения scaler
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2)
# На этом этапе информация из X_test "утекла" в scaler, тем самым влияя на преобразование X_train
# Правильный пример: сначала разделить, затем обрабатывать отдельно
X_train_raw, X_test_raw, y_train, y_test = train_test_split(X, y, test_size=0.2)
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train_raw) # Обучение только на тренировочном наборе
X_test = scaler.transform(X_test_raw) # Использовать параметры, полученные при обучении на тренировочном наборе, для преобразования тестового набора
II. Проблемы инженерии и развертывания
Превращение модели из файла в высокодоступный API, который можно стабильно обслуживать, изобилует подводными камнями.
1. Зависимости окружения и конфликты версий
"У меня на машине работает!" — классическая проблема. Версия Python и версии библиотек в среде обучения не соответствуют таковым в среде онлайн-инференса.
Контрольный список для устранения неполадок:
- Основная версия Python (3.7 vs 3.9)
- Версии основных библиотек (
tensorflow==2.8противtensorflow==2.12) - Системные зависимости (например, некоторые библиотеки зависят от конкретных библиотек среды выполнения C++)
- Формат сериализации модели (с использованием
pickleсохранённая модель, если разброс версий Python велик, может не загрузиться)
Решение:
- Контейнеризация: используйте Docker, чтобы упаковать модель и все её зависимости в один образ. Это золотой стандарт обеспечения согласованности среды.
- Управление зависимостями: используйте
requirements.txtилиenvironment.ymlчтобы точно записать все пакеты и их версии. - Формат модели: рассмотрите использование кросс-языкового, кросс-средового формата модели, такого какONNXилиPMML, или безопасного нативного для фреймворка формата (например,
TensorFlow SavedModel,PyTorch TorchScript)。
2. Низкая производительность онлайн-инференса
Время отклика API слишком велико, а пропускная способность (TPS) не успевает, не соответствуя бизнес-требованиям.
Типичные узкие места и оптимизации:
- Высокая стоимость одного прогноза: сама модель сложна (например, большая модель глубокого обучения).
- Оптимизация: прунинг модели, квантование, дистилляция знаний или переписывание с использованием более эффективной архитектуры модели.
- Частые операции ввода-вывода или сетевые вызовы: каждый прогноз требует извлечения признаков из базы данных или удаленного сервиса.
- Оптимизация: реализуйте кеширование признаков, предварительные вычисления или сервинг признаков для снижения задержки.
- Не используется аппаратное ускорение: запуск модели, предназначенной для GPU, на CPU.
- Оптимизация: выберите правильное аппаратное обеспечение для инференса (CPU/GPU/специализированные чипы ИИ) и фреймворк для инференса (например,
TensorRT,OpenVINO)。
- Оптимизация: выберите правильное аппаратное обеспечение для инференса (CPU/GPU/специализированные чипы ИИ) и фреймворк для инференса (например,
- Низкая эффективность фреймворка для обслуживания моделей: использование Flask для прямой загрузки модели имеет слабую способность обработки конкурентных запросов.
- Оптимизация: используйте высокопроизводительный фреймворк для обслуживания ML-моделей, такой какTensorFlow Serving, TorchServe, илиTriton Inference Server. Они поддерживают продвинутые функции, такие как горячая перезагрузка модели, динамическая пакетная обработка и хостинг нескольких моделей.
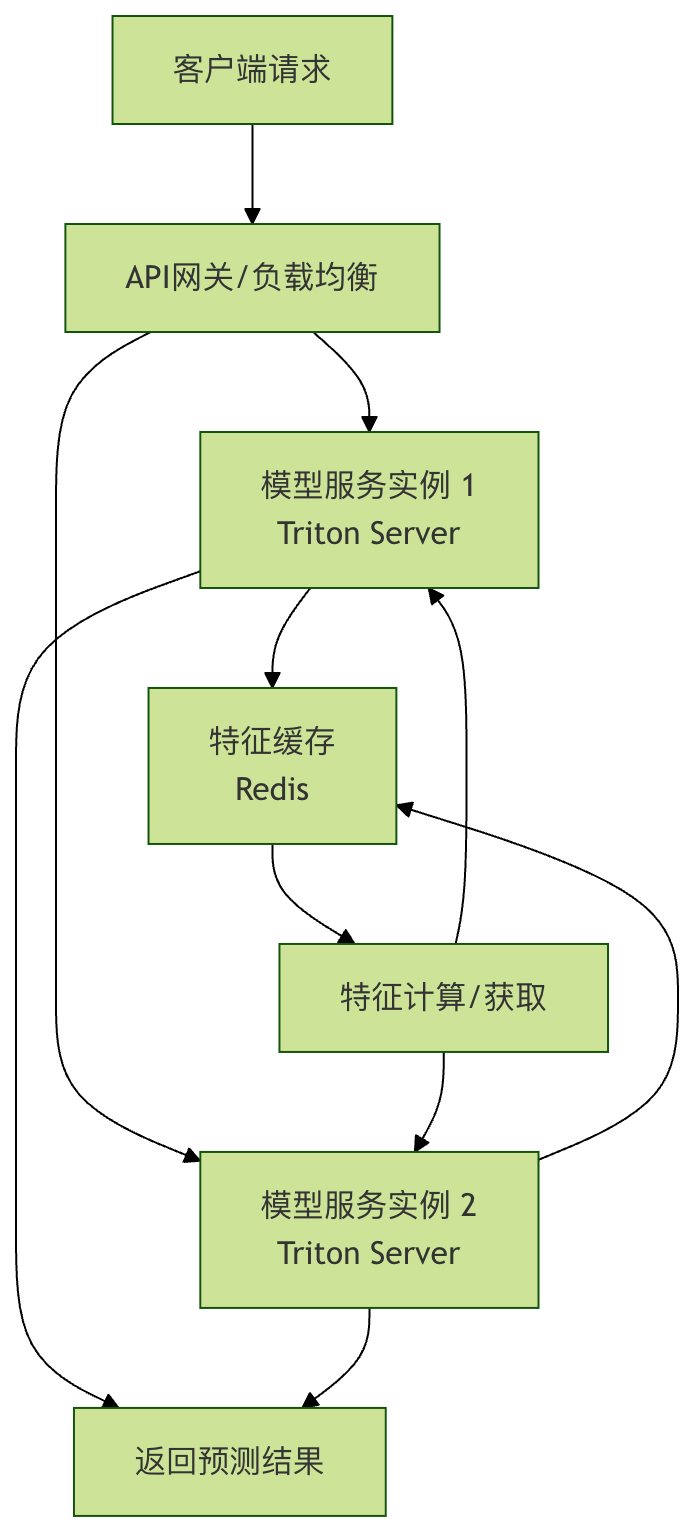
Рисунок: пример высокопроизводительной архитектуры обслуживания моделей, включающей балансировку нагрузки, кеширование признаков и выделенный сервер моделей.
3. Неправильное управление ресурсами
В сервисе модели возникают утечки памяти, или потребление памяти со временем постоянно растет, что в конечном итоге приводит к сбою сервиса.
Устранение неполадок:
- Загрузка модели: Перезагружается ли она при каждом запросе? Правильный подход — загрузить её в память при запуске сервиса и переиспользовать для последующих запросов.
- Накопление глобальных переменных: Есть ли в коде сервиса глобальный список, который постоянно растёт и не очищается?
- Большие результаты предсказаний: Занимают ли возвращаемые результаты предсказаний (например, изображения, большие тексты) большой объём памяти и не освобождаются своевременно?
Решение:
- Использование
gunicorn、uvicornмногопроцессные/асинхронные серверы, понимать их модель Worker. - Регулярно перезапускать процесс сервиса (например,
systemdилиsupervisor)。 - Использовать профессиональные инструменты анализа памяти (например,
memory_profiler) для обнаружения утечек памяти.
III. Проблемы модели и алгоритма
1. Переобучение и недообучение
Это фундаментальная проблема возможностей модели.
| Проблема | Симптом | Возможные причины | Решение |
|---|---|---|---|
| Недообучение | Производительность на обучающем и валидационном наборахОбе низкие | Модель слишком проста (низкая сложность), недостаточно признаков, недостаточно эпох обучения | Увеличьте сложность модели, добавьте более эффективные признаки, увеличьте количество эпох обучения |
| Переобучение | Производительность на обучающем набореОчень хорошая, производительность на валидационном набореОчень плохая | Модель слишком сложна, слишком мало обучающих данных, слишком много шума | Увеличьте объём обучающих данных, используйте регуляризацию (L1/L2/Dropout), уменьшите сложность модели, ранняя остановка |
Диагностика:Построение кривых обучения — лучший способ оценить ситуацию с подгонкой.
2. Исчезающие/взрывающиеся градиенты
Часто возникает при обучении глубоких нейронных сетей, из-за чего модель не может сойтись или обучение становится нестабильным.
Симптомы:
- Потери модели становятся
NaN。 - Значения весов становятся чрезвычайно большими или чрезвычайно малыми.
- В начале обучения значение функции потерь перестаёт изменяться.
Решения:
- Инициализация весов: используйте
He初始化(функция активации ReLU) илиXavier初始化(Tanh/Sigmoid)。 - Отсечение градиента: задайте порог и отсекайте градиент, когда он его превышает.
- Пакетная нормализация: добавьте
BatchNormслой перед функцией активации, который может стабилизировать обучение и позволить использовать более высокую скорость обучения. - Настройте архитектуру сети: используйте такие структуры, как остаточные связи в ResNet.
IV. Создайте систематический процесс устранения неполадок
Когда с онлайн-моделью возникают проблемы, систематический процесс устранения неполадок может помочь быстро определить источник проблемы.
- Подтвердите проблему: все прогнозы неверны или это касается только определённых групп/сценариев? Какова частота ошибок?
- Проверьте входные данные: получите пакет данных запросов, которые не удалось обработать онлайн, проверьте, полны ли входные признаки, корректен ли формат и находятся ли значения в разумном диапазоне (например, появление
NaN,Infили экстремальных значений). - Воспроизвести локально: Используйте входные данные, которые не сработали в онлайн-режиме, и в локальной среде разработки используйтету же модель и коддля выполнения предсказаний и посмотрите, можно ли воспроизвести проблему.
- Сравнить данные: Сравните распределение данных онлайн-запросов с распределением обучающих данных и проверьте, существует ли дрейф.
- Проверить код и конфигурацию: Убедитесь, что версия кода, версия файла модели и файл конфигурации онлайн-сервиса соответствуют окружению, прошедшему тестирование.
- Проверить логи и мониторинг: Проверьте, есть ли в логах сервиса аномальные ошибки, и не являются ли аномальными метрики CPU, памяти и времени отклика в системе мониторинга.
- Упростить и локализовать: Если возможно, попробуйте использовать минималистичную модель или систему на основе правил для обработки ошибочных входных данных и определить, это проблема данных или проблема модели.