Problèmes d'explicabilité
Imaginez que vous allez voir un médecin, et que le médecin vous dit : Selon mon système de diagnostic avancé, vous avez besoin de cette chirurgie, mais je ne peux pas expliquer pourquoi. Accepteriez-vous ? La plupart des gens hésiteraient, car nous voulons comprendre les raisons qui sous-tendent les décisions.
Dans le domaine de l'apprentissage automatique, nous sommes confrontés à un dilemme similaire. De nombreux modèles avancés d'apprentissage automatique, en particulier les modèles d'apprentissage profond, sont comme des boîtes noires — nous pouvons voir les entrées et les sorties, mais il est difficile de comprendre comment les décisions sont prises en interne. C'estle problème d'interprétabilité de l'apprentissage automatique, qui est devenu l'un des principaux obstacles limitant l'application généralisée de la technologie de l'IA dans des domaines clés pratiques (tels que la santé, la finance et la justice).
Cet article vous aidera à comprendre ce qu'est l'interprétabilité, pourquoi elle est si importante, ainsi que les défis et solutions actuels.
Qu'est-ce que l'interprétabilité de l'apprentissage automatique ?
Concepts de base
L'interprétabilité de l'apprentissage automatiquedésigne notre capacité à comprendre, à faire confiance et à gérer efficacement le processus décisionnel de l'intelligence artificielle.
En termes simples, c'est la capacité de répondre à la question de savoir pourquoi le modèle a fait une telle prédiction.
Deux niveaux d'interprétabilité
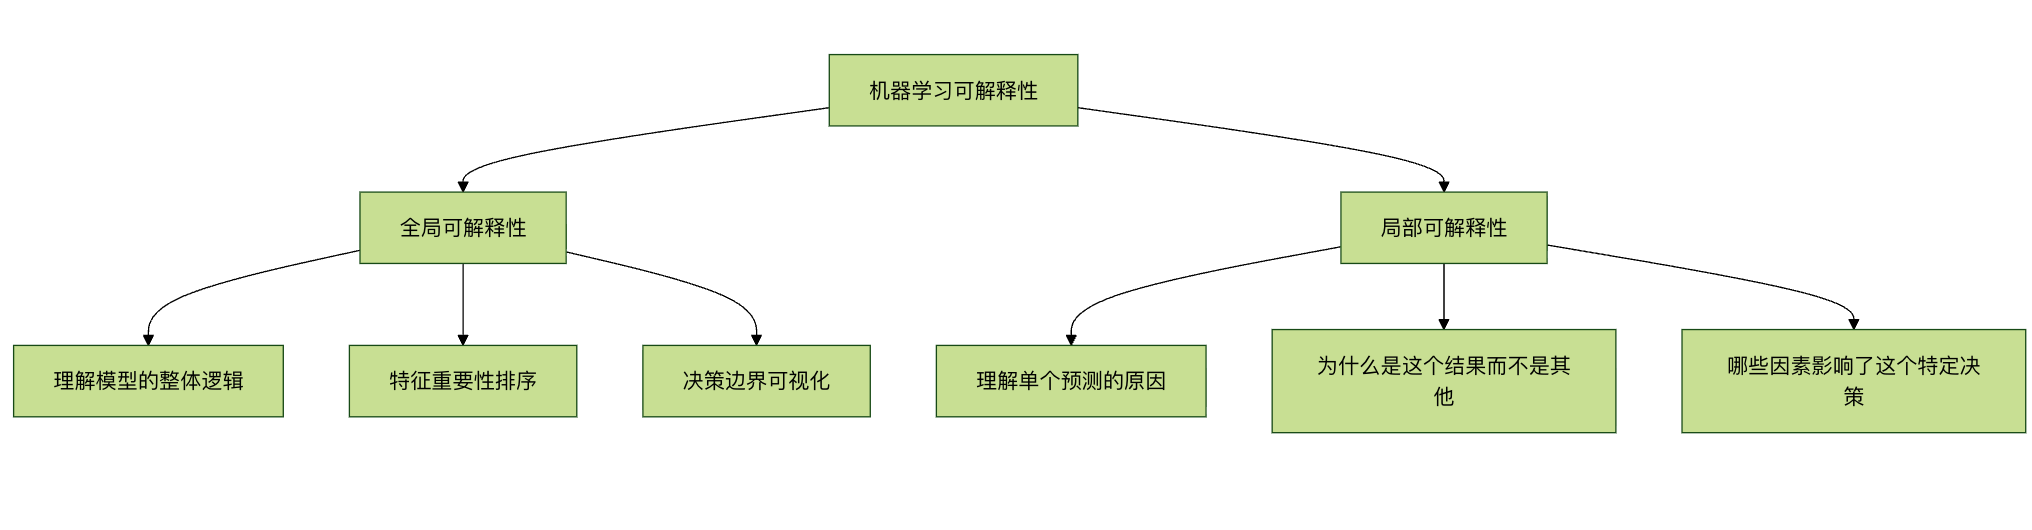
Interprétabilité globaleSe concentre sur le comportement global du modèle :
- Quels motifs le modèle a-t-il appris ?
- Quelles caractéristiques sont les plus importantes pour les prédictions ?
- Quelle est la forme de la frontière de décision du modèle ?
Interprétabilité localeSe concentre sur les prédictions individuelles :
- Pourquoi cet échantillon a-t-il été prédit comme classe A plutôt que comme classe B ?
- Si la valeur d'une caractéristique change légèrement, comment la prédiction changera-t-elle ?
- Quelles caractéristiques ont le plus contribué à cette prédiction spécifique ?
Pourquoi l'interprétabilité est-elle si importante ?
1. Établir la confiance et la transparence
Dans les domaines à haut risque tels que la santé, la conduite autonome et le contrôle des risques financiers, les gens doivent connaître la base des décisions de l'IA. Si un modèle rejette une demande de prêt ou diagnostique une maladie, nous devons être en mesure d'expliquer les raisons.
2. Répondre aux exigences réglementaires
Le RGPD (Règlement général sur la protection des données) de l'UE stipule explicitement que les utilisateurs ont le droit de recevoir « des informations significatives sur la logique impliquée ». De nombreuses réglementations sectorielles exigent la transparence du processus décisionnel.
3. Débogage et amélioration des modèles
En comprenant le fonctionnement du modèle, nous pouvons :
- Découvrir et corriger les biais dans le modèle
- Identifier les corrélations fallacieuses apprises par le modèle
- Améliorer l'architecture du modèle et l'ingénierie des caractéristiques
4. Découverte de connaissances et perspectives scientifiques
Parfois, les modèles peuvent découvrir des motifs que les experts humains n'ont pas remarqués, et ces éclairages peuvent faire progresser la science.
5. Sécurité et attaques adversariales
Comprendre les faiblesses du modèle aide à se défendre contre les attaques adversariales (des entrées soigneusement conçues qui poussent le modèle à mal classer).
Différents types de modèles et interprétabilité
Spectre de transparence des modèles
| Type de modèle | Interprétabilité | Représentants typiques | Scénarios applicables |
|---|---|---|---|
| Modèles à haute interprétabilité | Élevée | Régression linéaire, arbres de décision, régression logistique | Domaines nécessitant une forte explicabilité, tels que le crédit financier |
| Modèles à interprétabilité moyenne | Moyenne | Forêts aléatoires, arbres de gradient boosting | Scénarios qui équilibrent performance et interprétabilité |
| Modèles à faible interprétabilité | Faible | Apprentissage profond, modèles d'ensemble complexes | Priorité à la performance, comme la reconnaissance d'images, le traitement du langage naturel |
Comparaison d'exemples : arbre de décision vs réseau de neurones
Exemple d'arbre de décision (haute interprétabilité) :
Exemple
from sklearn.tree import DecisionTreeClassifier, plot_tree
import matplotlib.pyplot as plt
# Créer et entraîner le modèle
model = DecisionTreeClassifier(max_depth=3, random_state=42)
model.fit(X_train, y_train)
# Visualiser l'arbre de décision
plt.figure(figsize=(12, 8))
plot_tree(model, feature_names=feature_names,
class_names=['Non approuvé', 'Approuvé'],
filled=True, rounded=True)
plt.title(Arbre de décision d'approbation de prêt - Entièrement interprétable)
plt.show()
L'avantage des arbres de décision est que nous pouvons directement suivre le chemin du nœud racine aux nœuds feuilles et comprendre pleinement comment chaque décision est prise.
Exemple de réseau de neurones (faible interprétabilité) :
Exemple
import tensorflow as tf
from tensorflow import keras
# Créer un réseau de neurones simple
model = keras.Sequential([
keras.layers.Dense(128, activation='relu', input_shape=(10,)),
keras.layers.Dense(64, activation='relu'),
keras.layers.Dense(32, activation='relu'),
keras.layers.Dense(1, activation='sigmoid') # Sortie de classification binaire
])
model.compile(optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy'])
# Entraîner le modèle
history = model.fit(X_train, y_train,
époques=50,
validation_split=0.2,
verbose=0)
Un réseau de neurones est constitué de centaines, voire de millions, de neurones interconnectés, chaque connexion ayant un poids qui est automatiquement ajusté au cours de l’entraînement. Bien que nous puissions visualiser toutes les valeurs des poids, il est presque impossible de comprendre comment ces nombres produisent collectivement une prédiction spécifique.
Défis de l’interprétabilité
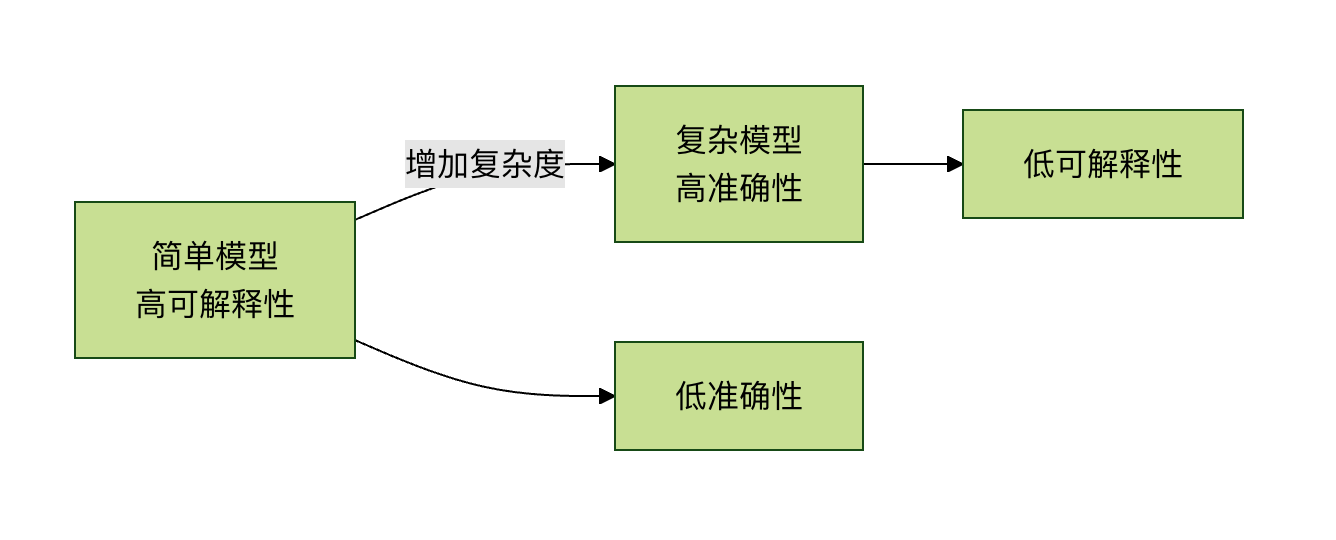
1. Le compromis entre exactitude et interprétabilité
En général, plus le modèle est complexe et meilleures sont ses performances, plus son interprétabilité est faible. C’est ce qu’on appellele compromis exactitude-interprétabilité。
2. Complexité technique
Les modèles d'apprentissage profond peuvent avoir :
- Des millions de paramètres
- Des transformations non linéaires complexes
- Des représentations abstraites à plusieurs couches
3. Limites cognitives humaines
Même si nous obtenons des explications techniques, elles peuvent dépasser la compréhension humaine. Par exemple, une explication d'interactions complexes impliquant 1000 caractéristiques est difficile à traiter pour le cerveau humain.
4. Manque de normes d'évaluation
Comment mesurer la « qualité » d'une explication ? Actuellement, il y a un manque de normes d'évaluation unifiées et objectives.
Techniques d'interprétabilité actuelles
1. Analyse de l'importance des caractéristiques
Exemple
import shap
import xgboost as xgb
import matplotlib.pyplot as plt
# Entraîner un modèle XGBoost
model = xgb.XGBClassifier()
model.fit(X_train, y_train)
# Créer un explicateur SHAP
explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X_test)
# Visualiser l'importance des variables
shap.summary_plot(shap_values, X_test, plot_type="bar")
plt.title(Classement de l'importance des variables)
plt.show()
# Explication d'une prédiction unique
shap.force_plot(explainer.expected_value, shap_values[0,:], X_test.iloc[0,:])
SHAP (SHapley Additive exPlanations) est basé sur la théorie des jeux et attribue une valeur d'importance à chaque caractéristique, montrant la contribution de la caractéristique à la prédiction.
2. LIME (Local Interpretable Model-agnostic Explanations)
Exemple
import lime
from lime import lime_image
from skimage.segmentation import mark_boundaries
# Créer un explicateur LIME
explainer = lime_image.LimeImageExplainer()
# Expliquer la prédiction d'une seule image
explanation = explainer.explain_instance(
image_array,
model.predict,
top_labels=3,
hide_color=0,
num_samples=1000
)
# Afficher les régions qui soutiennent la prédiction
temp, mask = explanation.get_image_and_mask(
explanation.top_labels[0],
positive_only=True,
num_features=5,
hide_rest=False
)
plt.imshow(mark_boundaries(temp, mask))
plt.title(Régions de l'image qui soutiennent la prédiction)
plt.axis('off')
plt.show()
L'idée centrale de LIME est de créer un modèle simple et interprétable (tel qu'un modèle linéaire) près d'un point de prédiction unique pour approximer le comportement du modèle complexe.
3. Mécanisme d'attention
En traitement du langage naturel, le mécanisme d'attention peut montrer sur quelles parties du texte d'entrée le modèle "se concentre" lors des prédictions :
Exemple
import numpy as np
import matplotlib.pyplot as plt
def visualize_attention(text, attention_weights):
"""
Visualiser les poids d'attention
Paramètres :
text: liste de texte tokenisé
attention_weights: poids d'attention pour chaque mot
"""
fig, ax = plt.subplots(figsize=(10, 2))
# Créer une carte de chaleur
im = ax.imshow([attention_weights], cmap='YlOrRd', aspect='auto')
# Définir les axes de coordonnées
ax.set_xticks(range(len(text)))
ax.set_xticklabels(text, rotation=45, ha='right')
# Ajouter une barre de couleurs
plt.colorbar(im)
plt.title("Visualisation des poids d'attention")
plt.tight_layout()
plt.show()
# Exemple d'utilisation
sample_text = ["I", "aime", "apprentissage automatique", "'s", "interprétabilité", "recherche"]
sample_attention = [0.1, 0.15, 0.4, 0.05, 0.25, 0.05]
visualize_attention(sample_text, sample_attention)
4. Visualisation de la frontière de décision
Pour les données de faible dimension, nous pouvons directement visualiser la frontière de décision du modèle :
Exemple
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
def plot_decision_boundary(model, X, y):
"""
Tracer la frontière de décision de données bidimensionnelles
Paramètres :
model : classifieur entraîné
X : données de caractéristiques (2D)
y : étiquettes
"""
# Créer une grille de maillage
x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.02),
np.arange(y_min, y_max, 0.02))
# Prédire sur toute la grille de maillage
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
# Tracer la frontière de décision et le nuage de points
plt.figure(figsize=(10, 8))
plt.contourf(xx, yy, Z, alpha=0.4, cmap=plt.cm.RdYlBu)
plt.scatter(X[:, 0], X[:, 1], c=y, s=50,
edgecolor='k', cmap=plt.cm.RdYlBu)
plt.xlabel('Caractéristique 1')
plt.ylabel('Caractéristique 2')
plt.title('Visualisation de la frontière de décision')
plt.show()
# Générer des données d'exemple et entraîner le modèle
np.random.seed(42)
X = np.random.randn(200, 2)
y = (X[:, 0] + X[:, 1] > 0).astype(int) # Frontière de décision linéaire simple
model = LogisticRegression()
model.fit(X, y)
plot_decision_boundary(model, X, y)
Conseils pratiques : comment gérer les problèmes d’interprétabilité dans les projets
1. Choisir des stratégies en fonction du scénario d’application
| Scénario d’application | Exigence d’interprétabilité | Méthode recommandée |
|---|---|---|
| Diagnostic médical | Très élevé | Utiliser des modèles hautement interprétables, ou ajouter des explications post-hoc pour les modèles complexes |
| Contrôle des risques financiers | Élevée | Analyse de l’importance des caractéristiques, extraction de règles de décision |
| Systèmes de recommandation | Moyenne | Mécanismes d’attention, génération de raisons de recommandation |
| Reconnaissance d’images | Relativement faible | Cartes de saillance, visualisation d'activation |
| Exploration de la recherche | Variable | Choisissez en fonction de la question de recherche spécifique |
2. Étapes pour mettre en œuvre l'interprétabilité
Exemple
class ExplainableMLPipeline:
def __init__(self, model, feature_names):
self.model = model
self.feature_names = feature_names
self.explanations = {}
def add_global_explanation(self, method='shap'):
"""Ajouter une explication globale"""
if method == 'shap':
explainer = shap.TreeExplainer(self.model)
shap_values = explainer.shap_values(self.X)
self.explanations['global_shap'] = shap_values
# Générer un graphique d'importance des caractéristiques
shap.summary_plot(shap_values, self.X,
feature_names=self.feature_names)
def add_local_explanation(self, instance_index, method='lime'):
"""Ajouter une explication locale"""
if method == 'lime':
# Simplifié ici ; en pratique, choisissez l'explicateur en fonction du type de modèle
print(f"Explication de la prédiction pour l'instance {instance_index} :")
print(f"Valeur prédite : {self.model.predict([self.X[instance_index]]))
print("Principaux facteurs d'influence :")
# Afficher les caractéristiques les plus importantes et leurs contributions
def generate_report(self):
"""Générer un rapport d'interprétabilité"""
report = {
'model_type': type(self.model).__name__,
'global_importance': self.get_feature_importance(),
'sample_explanations': self.get_sample_explanations(3),
'fairness_metrics': self.check_fairness()
}
return report
def get_feature_importance(self):
"""Obtenir l'importance des caractéristiques"""
# Implémenter le calcul de l'importance des caractéristiques
pass
def check_fairness(self):
"""Vérifier l'équité du modèle"""
# Implémenter la vérification de l'équité
pass
3. Liste de contrôle pratique
Avant de déployer un modèle d'apprentissage automatique, posez ces questions :
Considérations techniques
- Pouvons-nous expliquer la logique globale du modèle ?
- Pouvons-nous expliquer les prédictions individuelles ?
- Quelles caractéristiques ont le plus grand impact sur les prédictions ?
- Le modèle repose-t-il sur des corrélations fallacieuses ?
Considérations éthiques et de conformité
- Le modèle présente-t-il des biais ? À l'égard de quels groupes ?
- Est-il conforme aux exigences réglementaires pertinentes ?
- Les utilisateurs peuvent-ils recevoir des explications significatives ?
- Existe-t-il un mécanisme pour corriger les prédictions erronées ?
Considérations pratiques
- Les explications peuvent-elles être comprises par des experts du domaine ?
- Les explications aident-elles à améliorer le modèle ?
- Les explications soutiennent-elles la prise de décision ?
- Les explications des décisions clés sont-elles documentées ?
Perspectives d'avenir et orientations de recherche
1. Développement de modèles intrinsèquement interprétables
Les chercheurs développent de nouvelles architectures de modèles à la fois puissantes et interprétables, telles que :
- Systèmes neuro-symboliques: Combinaison de réseaux de neurones avec des règles d'apprentissage
- Réseaux de neurones interprétables: Conception de réseaux avec des structures transparentes
- Réseaux à capsules: fournir de meilleures représentations hiérarchiques
2. Cadres de normalisation et d’évaluation
L’industrie a besoin de :
- Des métriques standardisées pour l’évaluation de l’interprétabilité
- Des méthodes objectives pour mesurer la qualité des explications
- Validation de la cohérence de différentes méthodes d’explication
3. Systèmes d’explication collaboratifs humain-IA
Les systèmes futurs pourraient :
- Fournir des explications à différents niveaux en fonction du profil de l’utilisateur
- Prendre en charge l’exploration interactive et le questionnement
- Combiner les connaissances du domaine pour générer des explications plus pertinentes
4. Automatisation de l’interprétabilité
Directions de développement pour les outils :
- Sélectionner automatiquement la méthode d'explication la plus adaptée
- Générer des explications en temps réel sans affecter excessivement les performances
- Adaptation personnalisée des explications
Résumé et points clés
L'interprétabilité n'est pas facultative: Dans les domaines à haut risque, l'interprétabilité est une condition nécessaire au déploiement de systèmes d'IA.
Les compromis sont réels: Un compromis judicieux entre précision et interprétabilité doit être fait en fonction du scénario d'application.
La boîte à outils est riche: De SHAP et LIME aux mécanismes d'attention, il existe de multiples techniques pour améliorer l'interprétabilité des modèles.
Le processus est systématique: L'interprétabilité devrait couvrir l'ensemble du cycle de vie de l'apprentissage automatique, de la collecte des données au déploiement du modèle.
L'avenir est prometteur: À mesure que la recherche s'approfondit, nous développons de nouvelles méthodes à la fois puissantes et interprétables.
Conseils pour les débutants
Si vous êtes un débutant en apprentissage automatique :
- Commencez par les modèles interprétables: Maîtrisez d'abord les modèles interprétables tels que la régression linéaire, la régression logistique et les arbres de décision
- Comprenez les bases avant de progresser: Après avoir compris comment fonctionnent les modèles simples, apprenez ensuite les modèles complexes
- Pratiquez les techniques d'explication: Utilisez des outils comme SHAP et LIME pour expliquer vos modèles
- Cultivez la pensée critique: Demandez toujours « Pourquoi le modèle a-t-il fait cette prédiction ? »
L'interprétabilité de l'apprentissage automatique n'est pas seulement une question technique, mais aussi un pont reliant l'intelligence artificielle à la confiance humaine. À mesure que la technologie progresse, nous nous dirigeons vers des systèmes d'IA plus transparents et dignes de confiance, ce qui permettra à l'apprentissage automatique de jouer un rôle important dans des domaines plus critiques.
Exercices pratiques
Exercice 1 : Comparaison de l'interprétabilité de différents modèles
Utilisez le jeu de données Iris pour comparer l'interprétabilité de différents modèles :
Exemple
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier
import shap
# Charger les données
iris = load_iris()
X_train, X_test, y_train, y_test = train_test_split(
iris.data, iris.target, test_size=0.2, random_state=42
)
# Entraîner différents modèles
models = {
'Régression logistique': LogisticRegression(max_iter=1000),
'Arbre de décision': DecisionTreeClassifier(max_depth=3),
'Forêt aléatoire': RandomForestClassifier(n_estimators=100)
}
# Générer des explications pour chaque modèle et comparer
for name, model in models.items():
model.fit(X_train, y_train)
accuracy = model.score(X_test, y_test)
print(f"{name} - Précision : {accuracy:.3f}")
# Essayez d'expliquer (en utilisant l'importance des caractéristiques comme exemple ici)
if hasattr(model, 'feature_importances_'):
print(f" Importance des caractéristiques : {model.feature_importances_}")
elif hasattr(model, 'coef_'):
print(f" Coefficients : {model.coef_}")
Exercice 2 : Utilisation de SHAP pour expliquer un modèle de prédiction du prix des maisons
Exemple
from sklearn.datasets import fetch_california_housing
from sklearn.ensemble import RandomForestRegressor
import shap
import matplotlib.pyplot as plt
# Charger le jeu de données California housing
housing = fetch_california_housing()
X = pd.DataFrame(housing.data, columns=housing.feature_names)
y = housing.target
# Entraîner le modèle
model = RandomForestRegressor(n_estimators=100, random_state=42)
model.fit(X, y)
# Utiliser SHAP pour expliquer
explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X)
# 1. Résumé de l'importance des caractéristiques
plt.figure(figsize=(10, 6))
shap.summary_plot(shap_values, X, plot_type="bar")
plt.title("Importance des caractéristiques pour la prédiction du prix des logements en Californie")
plt.tight_layout()
plt.show()
# 2. Explication d'une prédiction individuelle
sample_idx = 10 # Sélectionner un échantillon
print(f"Prix réel du logement pour l'échantillon {sample_idx} : ${y[sample_idx]:.2f}k")
print(f"Prix prédit du logement pour l'échantillon {sample_idx} : ${model.predict([X.iloc[sample_idx]]))
shap.force_plot(explainer.expected_value,
shap_values[sample_idx,:],
X.iloc[sample_idx,:],
matplotlib=True)