Проблемы объяснимости
Представьте, что вы пришли к врачу, и врач говорит вам: Согласно моей продвинутой диагностической системе, вам нужна эта операция, но я не могу объяснить почему. Вы бы согласились? Большинство людей заколебались бы, потому что мы хотим понимать причины, стоящие за решениями.
В области машинного обучения мы сталкиваемся с аналогичной дилеммой. Многие продвинутые модели машинного обучения, особенно модели глубокого обучения, подобны чёрным ящикам — мы можем видеть входы и выходы, но трудно понять, как внутренне принимаются решения. Этопроблема интерпретируемости машинного обучения, которая стала одним из главных препятствий, ограничивающих широкое применение технологий ИИ в практически важных областях (таких как здравоохранение, финансы и юстиция).
Эта статья поможет вам понять, что такое интерпретируемость, почему она так важна, а также текущие проблемы и решения.
Что такое интерпретируемость машинного обучения?
Базовые понятия
Интерпретируемость машинного обученияотносится к нашей способности понимать, доверять и эффективно управлять процессом принятия решений искусственного интеллекта.
Проще говоря, это способность ответить, почему модель сделала такое предсказание.
Два уровня интерпретируемости
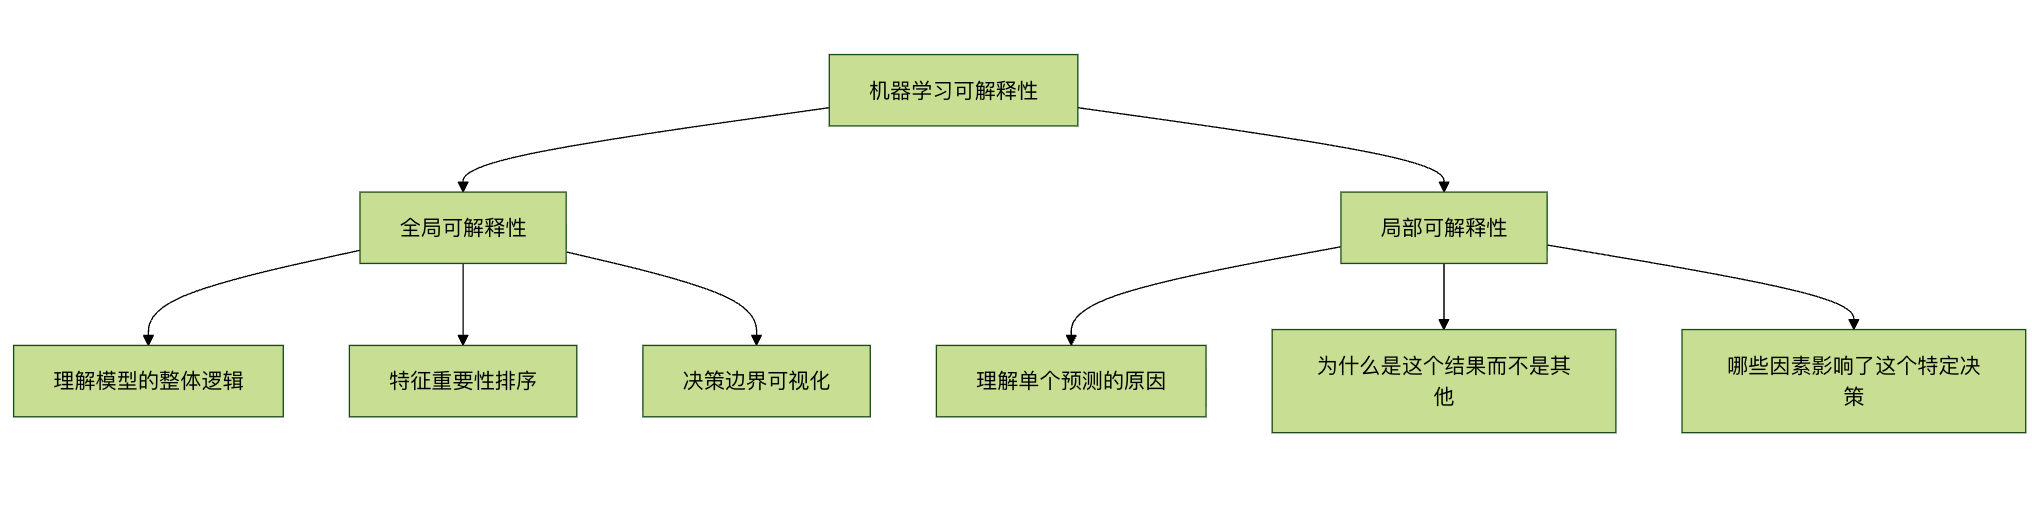
Глобальная интерпретируемостьФокусируется на общем поведении модели:
- Какие закономерности выучила модель?
- Какие признаки наиболее важны для предсказаний?
- Какую форму имеет граница принятия решений модели?
Локальная интерпретируемостьФокусируется на отдельных предсказаниях:
- Почему этот пример был предсказан как класс A, а не как класс B?
- Если значение признака немного изменится, как изменится предсказание?
- Какие признаки внесли наибольший вклад в это конкретное предсказание?
Почему интерпретируемость так важна?
1. Формирование доверия и прозрачности
В областях с высоким риском, таких как здравоохранение, автономное вождение и контроль финансовых рисков, людям нужно знать основу решений ИИ. Если модель отклоняет заявку на кредит или диагностирует заболевание, мы должны уметь объяснять причины.
2. Соблюдение нормативных требований
GDPR (Общий регламент по защите данных) ЕС явно устанавливает, что пользователи имеют право получать «значимую информацию о задействованной логике». Многие отраслевые нормативы требуют прозрачности процесса принятия решений.
3. Отладка и улучшение моделей
Понимая, как работает модель, мы можем:
- Обнаруживать и исправлять смещения в модели
- Выявлять ложные корреляции, выученные моделью
- Улучшать архитектуру модели и конструирование признаков
4. Обнаружение знаний и научное понимание
Иногда модели могут обнаруживать закономерности, которые не заметили эксперты-люди, и такие выводы могут способствовать научному прогрессу.
5. Безопасность и состязательные атаки
Понимание слабых мест модели помогает защищаться от состязательных атак (тщательно подобранных входных данных, заставляющих модель неправильно классифицировать).
Различные типы моделей и интерпретируемость
Спектр прозрачности моделей
| Тип модели | Интерпретируемость | Типичные представители | Применимые сценарии |
|---|---|---|---|
| Модели с высокой интерпретируемостью | Высокая | Линейная регрессия, решающие деревья, логистическая регрессия | Области, требующие высокой объяснимости, например финансовое кредитование |
| Модели со средней интерпретируемостью | Средняя | Случайные леса, деревья с градиентным бустингом | Сценарии, балансирующие производительность и интерпретируемость |
| Модели с низкой интерпретируемостью | Низкая | Глубокое обучение, сложные ансамблевые модели | Приоритет производительности, например распознавание изображений, обработка естественного языка |
Пример сравнения: решающее дерево против нейронной сети
Пример дерева решений (высокая интерпретируемость):
Пример
from sklearn.tree import DecisionTreeClassifier, plot_tree
import matplotlib.pyplot as plt
# Создание и обучение модели
model = DecisionTreeClassifier(max_depth=3, random_state=42)
model.fit(X_train, y_train)
# Визуализация дерева решений
plt.figure(figsize=(12, 8))
plot_tree(model, feature_names=feature_names,
class_names=['Не одобрено', 'Одобрено'],
filled=True, rounded=True)
plt.title(Дерево решений по одобрению кредита - полностью интерпретируемо)
plt.show()
Преимущество деревьев решений в том, что мы можем напрямую проследить путь от корневого узла к листовым узлам и полностью понять, как принимается каждое решение.
Пример нейронной сети (низкая интерпретируемость):
Пример
import tensorflow as tf
from tensorflow import keras
# Создайте простую нейронную сеть
model = keras.Sequential([
keras.layers.Dense(128, activation='relu', input_shape=(10,)),
keras.layers.Dense(64, activation='relu'),
keras.layers.Dense(32, activation='relu'),
keras.layers.Dense(1, activation='sigmoid') # Выход бинарной классификации
])
model.compile(optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy'])
# Обучение модели
history = model.fit(X_train, y_train,
epochs=50,
validation_split=0.2,
verbose=0)
Нейронная сеть состоит из сотен или даже миллионов взаимосвязанных нейронов, причём каждая связь имеет вес, который автоматически настраивается в процессе обучения. Хотя мы можем просмотреть все значения весов, практически невозможно понять, как эти числа вместе формируют конкретное предсказание.
Проблемы интерпретируемости
1. Компромисс между точностью и интерпретируемостью
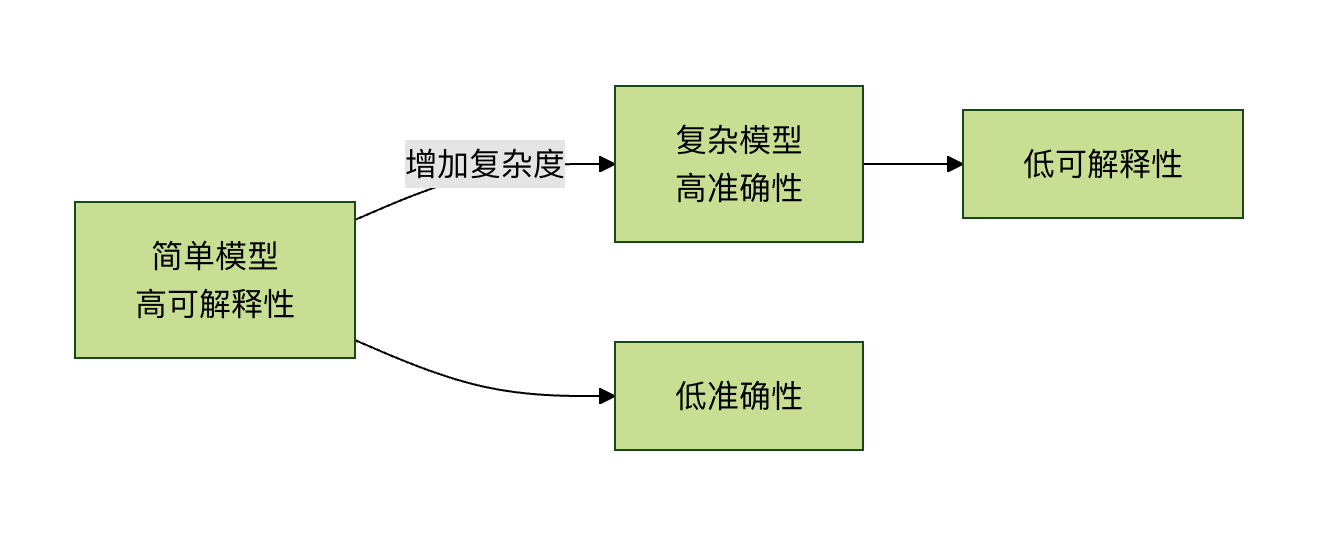
Как правило, чем сложнее модель и чем лучше её производительность, тем хуже её интерпретируемость. Это называетсякомпромиссом между точностью и интерпретируемостью。
2. Техническая сложность
Модели глубокого обучения могут иметь:
- Миллионы параметров
- Сложные нелинейные преобразования
- Многослойные абстрактные представления
3. Когнитивные ограничения человека
Даже если мы получим технические объяснения, они могут превзойти человеческое понимание. Например, объяснение сложных взаимодействий, включающих 1000 признаков, трудно для обработки человеческим мозгом.
4. Отсутствие стандартов оценки
Как мы измеряем «качество» объяснения? В настоящее время отсутствуют единые и объективные стандарты оценки.
Современные методы интерпретируемости
1. Анализ важности признаков
Пример
import shap
import xgboost as xgb
import matplotlib.pyplot as plt
# Обучить модель XGBoost
model = xgb.XGBClassifier()
model.fit(X_train, y_train)
# Создать объяснитель SHAP
explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X_test)
# Визуализировать важность признаков
shap.summary_plot(shap_values, X_test, plot_type="bar")
plt.title(Ранжирование важности признаков)
plt.show()
# Объяснение отдельного предсказания
shap.force_plot(explainer.expected_value, shap_values[0,:], X_test.iloc[0,:])
SHAP (SHapley Additive exPlanations) основан на теории игр и присваивает каждому признаку значение важности, показывая вклад признака в предсказание.
2. LIME (локальные интерпретируемые объяснения, не зависящие от модели)
Пример
import lime
from lime import lime_image
from skimage.segmentation import mark_boundaries
# Создание объяснителя LIME
explainer = lime_image.LimeImageExplainer()
# Объяснение предсказания для одного изображения
explanation = explainer.explain_instance(
image_array,
model.predict,
top_labels=3,
hide_color=0,
num_samples=1000
)
# Показать, какие области поддерживают предсказание
temp, mask = explanation.get_image_and_mask(
explanation.top_labels[0],
positive_only=True,
num_features=5,
hide_rest=False
)
plt.imshow(mark_boundaries(temp, mask))
plt.title(Области на изображении, которые поддерживают предсказание)
plt.axis('off')
plt.show()
Основная идея LIME — создать простую, интерпретируемую модель (например, линейную модель) вблизи одной точки предсказания, чтобы аппроксимировать поведение сложной модели.
3. Механизм внимания
В обработке естественного языка механизм внимания может показать, на какие части входного текста модель "обращает внимание" при выполнении предсказаний:
Пример
import numpy as np
import matplotlib.pyplot as plt
def visualize_attention(text, attention_weights):
"""
Визуализировать веса внимания
Параметры:
text: список токенизированного текста
attention_weights: вес внимания для каждого слова
"""
fig, ax = plt.subplots(figsize=(10, 2))
# Создать тепловую карту
im = ax.imshow([attention_weights], cmap='YlOrRd', aspect='auto')
# Задать координатные оси
ax.set_xticks(range(len(text)))
ax.set_xticklabels(text, rotation=45, ha='right')
# Добавить цветовую шкалу
plt.colorbar(im)
plt.title("Визуализация весов внимания")
plt.tight_layout()
plt.show()
# Пример использования
sample_text = ["I", "нравиться", "машинное обучение", "'s", "интерпретируемость", "исследование"]
sample_attention = [0.1, 0.15, 0.4, 0.05, 0.25, 0.05]
visualize_attention(sample_text, sample_attention)
4. Визуализация решающей границы
Для низкоразмерных данных мы можем напрямую визуализировать решающую границу модели:
Пример
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
def plot_decision_boundary(model, X, y):
"""
Построить решающую границу для двумерных данных
Параметры:
model: обученный классификатор
X: данные признаков (2D)
y: метки
"""
# Создать сетку
x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.02),
np.arange(y_min, y_max, 0.02))
# Предсказание на всей координатной сетке
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
# Построение границы решения и диаграммы рассеяния
plt.figure(figsize=(10, 8))
plt.contourf(xx, yy, Z, alpha=0.4, cmap=plt.cm.RdYlBu)
plt.scatter(X[:, 0], X[:, 1], c=y, s=50,
edgecolor='k', cmap=plt.cm.RdYlBu)
plt.xlabel('Признак 1')
plt.ylabel('Признак 2')
plt.title('Визуализация границы решения')
plt.show()
# Сгенерировать выборочные данные и обучить модель
np.random.seed(42)
X = np.random.randn(200, 2)
y = (X[:, 0] + X[:, 1] > 0).astype(int) # Простая линейная граница решения
model = LogisticRegression()
model.fit(X, y)
plot_decision_boundary(model, X, y)
Практические советы: как справляться с проблемами интерпретируемости в проектах
1. Выбирайте стратегии в зависимости от сценария применения
| Сценарий применения | Требование к интерпретируемости | Рекомендуемый метод |
|---|---|---|
| Медицинская диагностика | Очень высокий | Используйте легко интерпретируемые модели или добавляйте пост-хок объяснения для сложных моделей |
| Контроль финансовых рисков | Высокая | Анализ важности признаков, извлечение решающих правил |
| Рекомендательные системы | Средняя | Механизмы внимания, генерация причин рекомендаций |
| Распознавание изображений | Относительно низкая | Карты значимости, визуализация активаций |
| Исследовательский поиск | Переменная | Выбор на основе конкретного исследовательского вопроса |
2. Шаги по реализации интерпретируемости
Пример
class ExplainableMLPipeline:
def __init__(self, model, feature_names):
self.model = model
self.feature_names = feature_names
self.explanations = {}
def add_global_explanation(self, method='shap'):
"""Добавить глобальное объяснение"""
if method == 'shap':
explainer = shap.TreeExplainer(self.model)
shap_values = explainer.shap_values(self.X)
self.explanations['global_shap'] = shap_values
# Построить график важности признаков
shap.summary_plot(shap_values, self.X,
feature_names=self.feature_names)
def add_local_explanation(self, instance_index, method='lime'):
"""Добавить локальное объяснение"""
if method == 'lime':
# Здесь упрощено; на практике выбирайте объяснитель в зависимости от типа модели
print(f"Объяснение предсказания для экземпляра {instance_index}:")
print(f"Предсказанное значение: {self.model.predict([self.X[instance_index]]))
print("Ключевые факторы влияния:")
# Показать наиболее важные признаки и их вклад
def generate_report(self):
"""Сгенерировать отчёт об интерпретируемости"""
report = {
'model_type': type(self.model).__name__,
'global_importance': self.get_feature_importance(),
'sample_explanations': self.get_sample_explanations(3),
'fairness_metrics': self.check_fairness()
}
return report
def get_feature_importance(self):
"""Получить важность признаков"""
# Реализовать расчёт важности признаков
pass
def check_fairness(self):
"""Проверить справедливость модели"""
# Реализовать проверку справедливости
pass
3. Практический чек-лист
Перед развертыванием модели машинного обучения задайте следующие вопросы:
Технические аспекты
- Можем ли мы объяснить общую логику модели?
- Можем ли мы объяснить отдельные предсказания?
- Какие признаки оказывают наибольшее влияние на предсказания?
- Полагается ли модель на ложные корреляции?
Этические аспекты и вопросы соответствия
- Есть ли у модели предвзятость? Против каких групп?
- Соответствует ли она применимым нормативным требованиям?
- Могут ли пользователи получать содержательные объяснения?
- Существует ли механизм исправления ошибочных прогнозов?
Практические соображения
- Могут ли объяснения быть поняты экспертами в предметной области?
- Помогают ли объяснения улучшить модель?
- Поддерживают ли объяснения принятие решений?
- Документируются ли объяснения ключевых решений?
Перспективы и направления исследований
1. Разработка внутренне интерпретируемых моделей
Исследователи разрабатывают новые архитектуры моделей, которые одновременно мощны и интерпретируемы, например:
- Нейро-символические системы: объединение нейронных сетей с правилами обучения
- Интерпретируемые нейронные сети: проектирование сетей с прозрачными структурами
- Капсульные сети: Обеспечение лучших иерархических представлений
2. Стандартизация и фреймворки оценки
Отрасли необходимы:
- Стандартизированные метрики для оценки интерпретируемости
- Объективные методы измерения качества объяснений
- Проверка согласованности различных методов объяснения
3. Системы совместного объяснения человек-ИИ
Будущие системы могут:
- Предоставлять объяснения на разных уровнях в зависимости от подготовки пользователя
- Поддерживать интерактивное исследование и постановку вопросов
- Сочетать знания предметной области для создания более содержательных объяснений
4. Автоматизация интерпретируемости
Направления развития инструментов:
- Автоматический выбор наиболее подходящего метода объяснения
- Генерация объяснений в реальном времени без чрезмерного влияния на производительность
- Персонализированная адаптация объяснений
Итоги и ключевые моменты
Интерпретируемость не является необязательной: В областях с высоким риском интерпретируемость — необходимое условие для развертывания систем ИИ.
Компромиссы реальны: Мудрый компромисс между точностью и интерпретируемостью должен быть сделан с учетом сценария применения.
Набор инструментов богат: От SHAP и LIME до механизмов внимания существует множество методов повышения интерпретируемости модели.
Процесс систематичен: Интерпретируемость должна охватывать весь жизненный цикл машинного обучения, от сбора данных до развертывания модели.
Будущее светлое: По мере углубления исследований мы разрабатываем новые методы, которые одновременно мощны и интерпретируемы.
Советы для начинающих
Если вы начинающий в машинном обучении:
- Начните с интерпретируемых моделей: Сначала освоьте интерпретируемые модели, такие как линейная регрессия, логистическая регрессия и деревья решений
- Разберитесь с основами, прежде чем двигаться дальше: Поняв, как работают простые модели, переходите к сложным моделям
- Практикуйте методы объяснения: Используйте такие инструменты, как SHAP и LIME, чтобы объяснять свои модели
- Развивайте критическое мышление: Всегда спрашивайте: «Почему модель сделала такое предсказание?»
Интерпретируемость машинного обучения — это не только техническая проблема, но и мост, соединяющий искусственный интеллект с человеческим доверием. По мере развития технологий мы движемся к более прозрачным и надёжным системам ИИ, что позволит машинному обучению играть важную роль в более критически важных областях.
Практические упражнения
Упражнение 1: Сравнение интерпретируемости разных моделей
Используйте набор данных Iris для сравнения интерпретируемости разных моделей:
Пример
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier
import shap
# Загрузить данные
iris = load_iris()
X_train, X_test, y_train, y_test = train_test_split(
iris.data, iris.target, test_size=0.2, random_state=42
)
# Обучите разные модели
models = {
'Logistic Regression': LogisticRegression(max_iter=1000),
'Дерево решений': DecisionTreeClassifier(max_depth=3),
'Случайный лес': RandomForestClassifier(n_estimators=100)
}
# Сгенерируйте объяснения для каждой модели и сравните
for name, model in models.items():
model.fit(X_train, y_train)
accuracy = model.score(X_test, y_test)
print(f"{name} - Точность: {accuracy:.3f}")
# Попробуйте объяснить (используя важность признаков в качестве примера здесь)
if hasattr(model, 'feature_importances_'):
print(f" Важность признаков: {model.feature_importances_}")
elif hasattr(model, 'coef_'):
print(f" Коэффициенты: {model.coef_}")
Упражнение 2: Использование SHAP для объяснения модели прогнозирования цен на жилье
Пример
from sklearn.datasets import fetch_california_housing
from sklearn.ensemble import RandomForestRegressor
import shap
import matplotlib.pyplot as plt
# Загрузите набор данных о жилье в Калифорнии
housing = fetch_california_housing()
X = pd.DataFrame(housing.data, columns=housing.feature_names)
y = housing.target
# Обучите модель
model = RandomForestRegressor(n_estimators=100, random_state=42)
model.fit(X, y)
# Используйте SHAP для объяснения
explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X)
# 1. Сводка важности признаков
plt.figure(figsize=(10, 6))
shap.summary_plot(shap_values, X, plot_type="bar")
plt.title("Важность признаков для прогнозирования цен на жилье в Калифорнии")
plt.tight_layout()
plt.show()
# 2. Объяснение отдельного прогноза
sample_idx = 10 # Выберите образец
print(f"Фактическая цена дома для образца {sample_idx}: ${y[sample_idx]:.2f}k")
print(f"Прогнозируемая цена дома для образца {sample_idx}: ${model.predict([X.iloc[sample_idx]]))
shap.force_plot(explainer.expected_value,
shap_values[sample_idx,:],
X.iloc[sample_idx,:],
matplotlib=True)