ハイパーパラメータ探索
機械学習の実践では、よくこんな悩みに直面します。同じアルゴリズムを使っているのに、他人のモデルの精度は95%に達するのに、自分のモデルは85%しかないのはなぜか?データ品質や特徴量エンジニアリングの違いに加えて、重要な要因の一つはしばしばハイパーパラメータの設定にあります。
モデルアルゴリズムを車のエンジンに例えるなら、ハイパーパラメータはエンジンの点火時期や燃料噴射量などを微調整するつまみのようなものです。うまく調整すればエンジンのパワーは力強く、調整が悪ければ出力不足や大きな消耗につながる可能性があります。
本記事では、モデル最適化とエンジニアリングにおいて極めて重要なハイパーパラメータ探索について、体系的に解説します。
ハイパーパラメータとは?
探索方法を詳しく見る前に、まず核心となる概念を明確にしておきましょう。ハイパーパラメータとモデルパラメータの違いです。
モデルパラメータ vs ハイパーパラメータ
| 特性 | モデルパラメータ | ハイパーパラメータ |
|---|---|---|
| 定義 | モデルがトレーニングデータから学習して得られる内部変数。 | モデルトレーニング開始前に、開発者が手動で設定するか、アルゴリズムによって選択される設定変数。 |
| 学習方法 | 最適化アルゴリズム(例:勾配降下法)によって自動的に調整される。 | トレーニングデータからは学習せず、外部からの設定が必要。 |
| 例 | 線形回帰における重みwとバイアスb;ニューラルネットワークにおける重みとバイアス。 |
学習率、決定木の最大深さ、ランダムフォレストの木の数、KNN のK値。 |
| 影響 | モデルの特定データへの適合能力を決定する。 | モデルの学習プロセス、容量、構造を決定し、それによって最終的な性能に影響を与える。 |
分かりやすい例え:新しい料理を学んでいると想像してください(モデルのトレーニング)。
- モデルパラメータこれは、料理の過程で食材や火加減に応じて見つけ出した「塩少々、砂糖半さじ」といった具体的な量のようなものです。この量は実践(トレーニング)によって得られます。
- ハイパーパラメータは、料理を始める前に決めておくものです:強火で一気に炒めるそれとも弱火でじっくり煮込む(学習率)?全体で何回炒めるか(トレーニング回数)?これらの選択は、料理のプロセスと最終的な味に根本的な影響を与えます。
よくあるハイパーパラメータの例
機械学習アルゴリズムによって固有のハイパーパラメータがあります:
汎用ハイパーパラメータ:
learning_rate:学習率。モデルパラメータ更新の歩幅を制御します。大きすぎると最適点を「飛び越えて」しまいやすく、小さすぎると学習が遅すぎます。n_estimators:アンサンブルモデルにおける弱学習器(例:木)の数。max_iter/epochs:最大反復回数またはトレーニングのエポック数。
線形モデル/ニューラルネットワーク:
alpha/lambda:正則化項の強さ。過学習を防ぐために使われます。batch_size:パラメータ更新ごとに使用するサンプル数(バッチサイズ)。hidden_layer_sizes:ニューラルネットワークの隠れ層のサイズ。
木モデル:
max_depth:木の最大深さ。モデルの複雑さを制御します。min_samples_split:内部ノードをさらに分割するために必要な最小サンプル数。min_samples_leaf:葉ノードに必要な最小サンプル数。
なぜハイパーパラメータ探索が必要なのか?
ハイパーパラメータがこれほど重要なら、経験や直感で適当に設定してもよいのでしょうか? 答えはノーです。理由は以下の通りです。
- 性能への影響が大きい:同じモデルでも、ハイパーパラメータの組み合わせが異なると、性能(例:精度、F1スコア)に天と地ほどの差が生じることがあります。
- 汎用的な最適値は存在しない:最適なハイパーパラメータは特定のデータセット、タスク、モデルに大きく依存し、どこでも通用する「デフォルトの神パラメータ」は存在しません。
- 組み合わせ空間が膨大:複数のハイパーパラメータが相互に影響し合い、高次元の探索空間を構成します。手動の試行錯誤は効率が非常に低く、局所的な考え方に陥りやすいです。
そのため、この膨大なパラメータ空間を探索し、より優れた性能の設定を見つけるための体系的かつ自動化された方法が必要です。このプロセスこそがハイパーパラメータ探索 或 ハイパーパラメータ最適化。
その核心的な目標は、許容可能な計算コスト内で、モデルが未確認のデータ(検証セット)上で性能指標が最適になるようなハイパーパラメータの組を見つけることです。
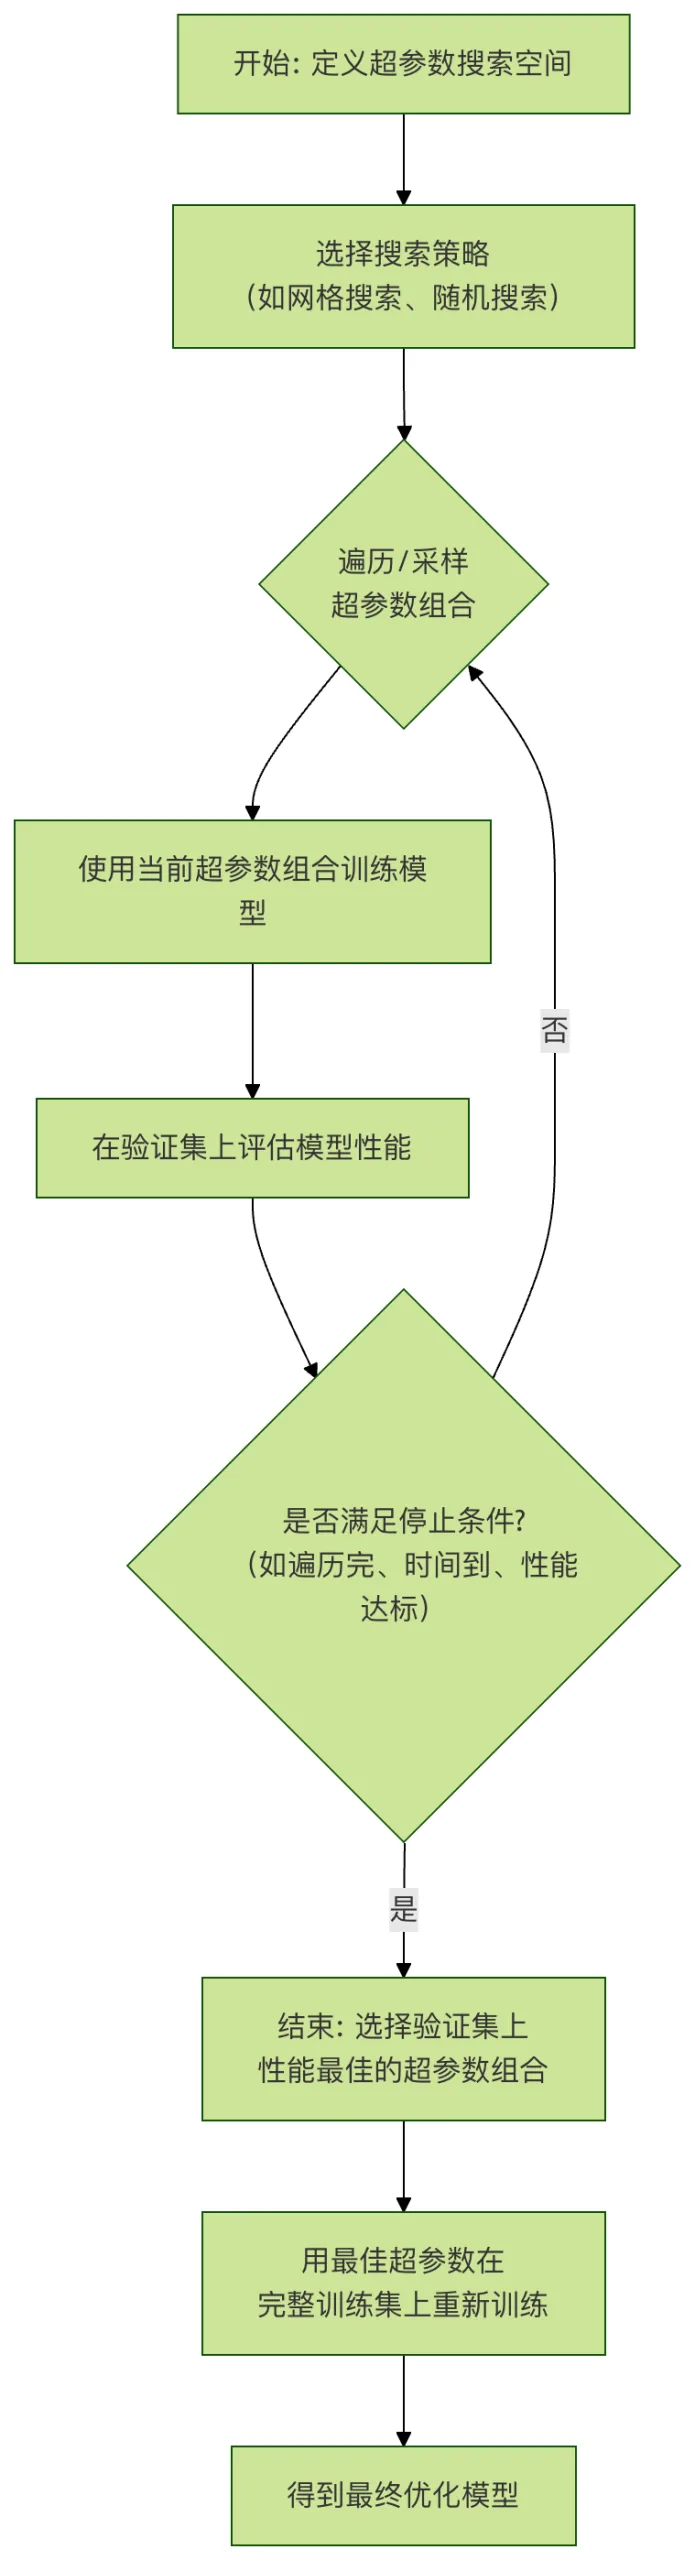
主要なハイパーパラメータ探索戦略
1. グリッドサーチ
グリッドサーチは最も基本的で直感的な探索方法です。
動作原理:
- 探索対象の各ハイパーパラメータに対して、候補値のリストを定義します。
- 探索アルゴリズムはこれらのリストのデカルト積、すなわちすべての可能な組み合わせを生成します。
- すべての組み合わせを網羅し、モデルをトレーニングして評価します。
- 検証セット上で最も性能の良い組み合わせを選択します。
例: サポートベクターマシン(SVM)の2つのハイパーパラメータを探索します。
例
param_grid = {
'C': [0.1, 1, 10, 100], # 正則化強度、候補値4つ
'gamma': [0.001, 0.01, 0.1, 1] # カーネル関数の係数、候補値4つ
}
# グリッドサーチは 4 * 4 = 16 通りの異なる組み合わせを試します
利点:
- シンプルで信頼性が高い:グリッドが十分に細かければ、指定された範囲内の最適解を必ず探索できます。
- 並列化が容易:各パラメータ組み合わせのトレーニング評価は互いに独立しており、並列計算に非常に適しています。
欠点:
- 次元の呪い:ハイパーパラメータの数が少し多かったり、候補値が少し密だったりすると、組み合わせ数は指数関数的に増加し、計算コストが耐えられなくなります。例えば、5つのパラメータでそれぞれ10個の値を取る場合、トレーニング評価が必要なモデル数は 10^5 = 100,000 個になります!
- 効率が低い:重要でないパラメータに大量の計算リソースを浪費する可能性があります。
2. ランダムサーチ
ランダムサーチは、グリッドサーチの欠点に対する効果的な改良です。
動作原理:
- 各ハイパーパラメータに対して確率分布(例:一様分布、対数一様分布)を定義します。
- 指定された総試行回数(
n_iter)以内で、ランダムサンプリング一組のハイパーパラメータ値を取得します。 - サンプリングされた各パラメータ組に対してトレーニングと評価を行います。
- 最も性能の良い組み合わせを選択します。
例: ランダムサーチを使ってランダムフォレストを最適化します。
例
from scipy.stats import randint, uniform
param_dist = {
'n_estimators': randint(100, 500), # 整数一様分布、100〜500
'max_depth': randint(5, 30), # 整数一様分布、5〜30
'min_samples_split': uniform(0.01, 0.2) # 連続一様分布、0.01〜0.21
}
# ランダムに50回の試行を行う
random_search = RandomizedSearchCV(estimator=rf_model,
param_distributions=param_dist,
n_iter=50,
cv=5,
verbose=2)
random_search.fit(X_train, y_train)
なぜランダムサーチはより効率的なのか?研究(Bergstra & Bengio, 2012)によれば、ほとんどの問題において、モデルの性能は通常、少数のハイパーパラメータにのみ敏感です。ランダムサーチでは、各次元それぞれでより多くの探索を行うことができ、重要でないパラメータの固定グリッドに束縛されるグリッドサーチとは異なり、重要なパラメータの最適な領域を見つける確率が高くなります。
利点:
- 計算効率が高い:同じ計算予算であれば、グリッドサーチよりも優れた解を見つける確率が高くなります。
- 柔軟性:パラメータの確率分布を簡単に指定できます(例:対数スケールで学習率を探索するなど)。
欠点:
- ランダム性:結果が乱数シードによって異なる可能性があり、特定の領域を見逃すことがあります。
- 記憶がない:各試行は独立しており、以前の試行の情報を利用してその後の探索を導くことはありません。
3. ベイズ最適化
ベイズ最適化はより賢い探索方法であり、評価コストが非常に高い関数の最適化(例:大規模なディープラーニングモデルのトレーニングに数日かかる場合)に適しています。
核心的な考え方:
- 代理モデル:計算コストが低い確率モデル(ガウス過程など)を使って、実際の計算コストが高い目的関数(つまりモデル性能とハイパーパラメータの関係)を「模倣」する。
- 獲得関数:代理モデルの不確実性に基づいて、次に評価する「最も有望な」ハイパーパラメータの組み合わせを選択する。これは以下のバランスを取る:探索(不確実性が高い領域でのサンプリング)と利用(既知の性能が良い領域の近くでのサンプリング)。
ワークフロー:
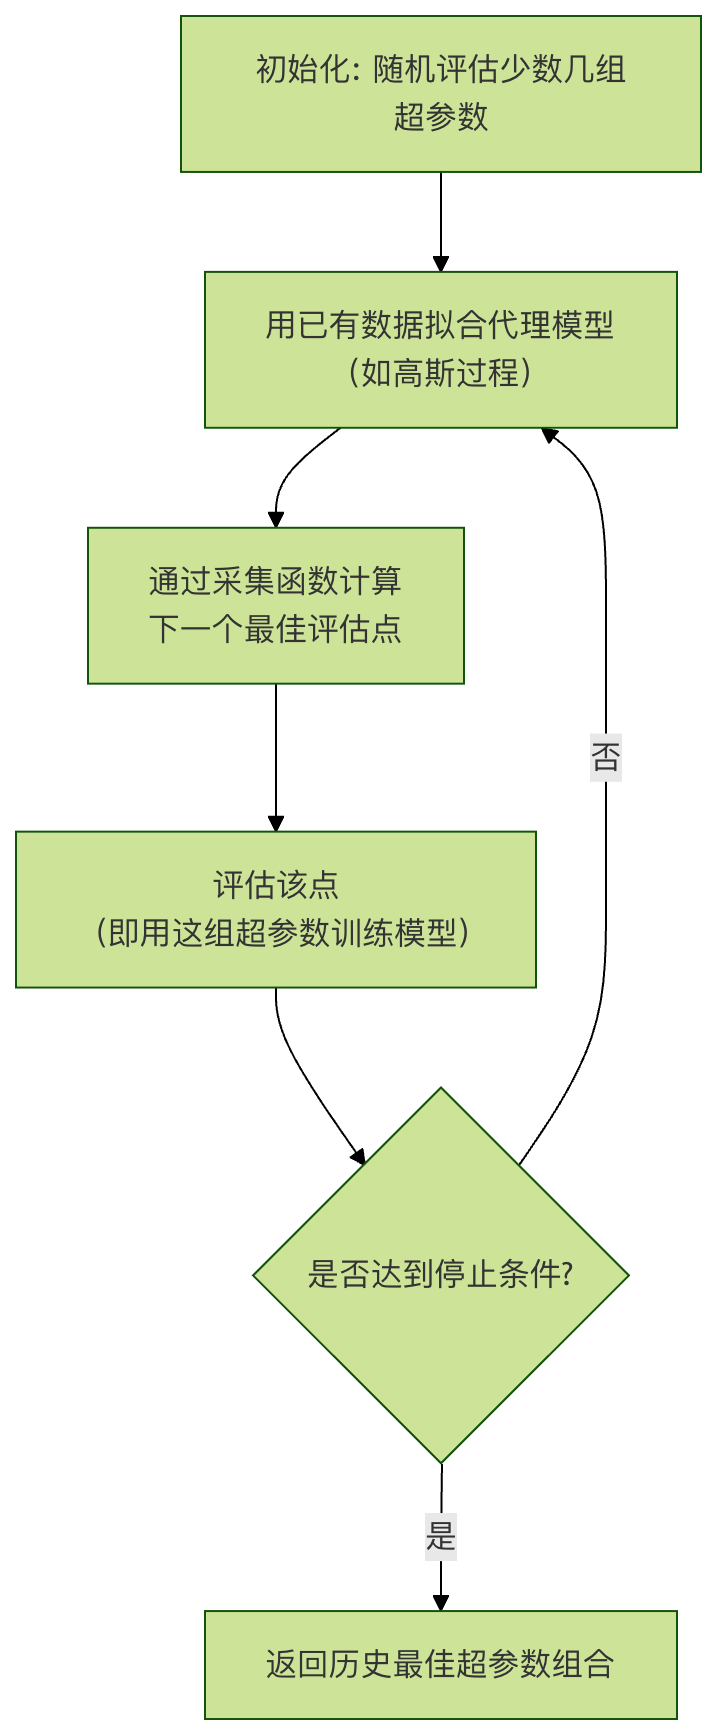
利点:
- 非常に効率的:最小限の試行回数で最適に近い解を見つけることができ、特に計算コストが高いモデルに適している。
- 適応性:履歴情報を利用して検索方向をインテリジェントに導く。
欠点:
- 実装が複雑:前の2つと比べて複雑である。
- 並列化が困難:標準的なベイズ最適化は逐次的であり、直接並列化するのは難しい(改善方法はあるが)。
- 高次元空間に対して:ハイパーパラメータの次元が増えると、代理モデルの適合と最適化が難しくなる。
よく使われるツール: scikit-optimize, BayesianOptimization, Optuna, Hyperopt。
実践的なエンジニアリングと注意点
1. 検証戦略:テストセットを汚染しないでください!
ハイパーパラメータを探索する際、絶対にテストセットを探索プロセスの指針に使用してはいけません。そうしないと、情報漏洩と過度に楽観的な汎化性能の推定につながります。
正しい方法:
- データを次のように分割する:トレーニングセット、検証セット、テストセット。
- ハイパーパラメータ探索は「トレーニングセット+検証セット」で行う(例:交差検証を使用)。
- 最適なハイパーパラメータを選択した後、このパラメータセットを用いて完全なトレーニングセット(またはトレーニングセット+検証セットを結合したもの)で最終モデルを再トレーニングする。
- 最後に、トレーニングやチューニングのプロセスに一切関与したことのないテストセットを用いて、最終モデルの汎化能力を公平に評価する。
2. 交差検証を使う
ハイパーパラメータの性能をより頑健に評価し、1回のデータ分割による偶然性を避けるために、交差検証を使用すべきです。
例
# 5分割交差検証を使用したグリッドサーチ
grid_search = GridSearchCV(estimator=model,
param_grid=param_grid,
cv=5, # 5分割交差検証
scoring='accuracy',
return_train_score=True)
grid_search.fit(X_train_val, y_train_val) # ここではトレーニング+検証データを使用
print(f"最適パラメータ: {grid_search.best_params_}")
print(f"最適な交差検証スコア: {grid_search.best_score_:.4f}")
# 最適モデルを取得(最適パラメータで全データに再適合済み)
best_model = grid_search.best_estimator_
3. ハイパーパラメータ空間の設計テクニック
- スケールに敏感なパラメータ:学習率や正則化強度などのパラメータは、その有効範囲がしばしば複数の桁にわたる。対数スケールで探索すべきです(例:
[0.001, 0.01, 0.1, 1])、線形スケールではなく(例:[0.1, 0.2, ..., 1.0])。 - 最初に粗く、後で精密に:最初に広範囲のランダムサーチまたは疎なグリッドサーチを行い、性能が良い領域を特定してから、その領域でより細かい探索を行うことができます。
- 事前知識を活用する:アルゴリズムの原理や経験的な文献に基づいて、合理的な初期範囲と分布を設定します。
4. 自動化とツールチェーン
実際のエンジニアリングでは、ハイパーパラメータ探索はしばしばMLOpsパイプラインに統合されます。
- フレームワーク:
Scikit-learnは提供しますGridSearchCVとRandomizedSearchCV。 - 高度なライブラリ:
Optuna,Ray Tune,Keras Tunerなどは、より強力で分散処理に適した探索機能を提供し、早期停止や枝刈りなどの高度な機能をサポートしています。 - クラウドサービス:AWS SageMaker、Google Vertex AI などのプラットフォームは、管理型のハイパーパラメータ最適化サービスを提供しています。
実践演習
それでは、Scikit-learnとランダムフォレストデータセットを使って完全なハイパーパラメータ探索の演習を行いましょう。
タスク:ワインのデータセットを使用し、ランダムサーチによってランダムフォレスト分類器を最適化します。
例
import numpy as np
from sklearn.datasets import load_wine
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split, RandomizedSearchCV
from sklearn.metrics import classification_report
from scipy.stats import randint
# 2. データを読み込んで分割
data = load_wine()
X, y = data.data, data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
X_train_val, X_val, y_train_val, y_val = train_test_split(X_train, y_train, test_size=0.25, random_state=42) # 0.25 * 0.8 = 0.2
# 3. モデルとパラメータ分布を定義
rf = RandomForestClassifier(random_state=42)
param_dist = {
'n_estimators': randint(50, 300), # 木の数
'max_depth': randint(3, 20), # 木の最大深さ
'min_samples_split': randint(2, 10), # 内部ノード分割に必要な最小サンプル数
'min_samples_leaf': randint(1, 5), # 葉ノードの最小サンプル数
'max_features': ['sqrt', 'log2'] # 最適な分割を探す際に考慮する特徴量の数
}
# 4. ランダムサーチを実行(3分割交差検証付き)
random_search = RandomizedSearchCV(estimator=rf,
param_distributions=param_dist,
n_iter=30, # ランダムに30組のパラメータを試す
cv=3, # 3分割交差検証
scoring='accuracy',
random_state=42,
verbose=1,
n_jobs=-1) # すべてのCPUコアを使用して並列処理
random_search.fit(X_train_val, y_train_val)
# 5. 探索結果を出力
print("="*50)
print("ランダムサーチの最適パラメータ:")
print(random_search.best_params_)
print(f"\n最適な交差検証精度:{random_search.best_score_:.4f}")
# 6. 独立した検証セットで最適モデルを評価
best_model = random_search.best_estimator_
y_val_pred = best_model.predict(X_val)
print("\n検証セットでの性能レポート:")
print(classification_report(y_val, y_val_pred, target_names=data.target_names))
# 7. (最終ステップ)最適パラメータでトレーニングセット全体を再トレーニングし、テストセットで評価
final_model = RandomForestClassifier(**random_search.best_params_, random_state=42)
final_model.fit(X_train, y_train) # すべてのトレーニングデータを使用
y_test_pred = final_model.predict(X_test)
print("="*50)
print("最終モデルのテストセット(新しいデータ)での性能レポート:")
print(classification_report(y_test, y_test_pred, target_names=data.target_names))
出力:
Fitting 3 folds for each of 30 candidates, totalling 90 fits
==================================================
随机搜索最佳参数:
{'max_depth': 9, 'max_features': 'log2', 'min_samples_leaf': 1, 'min_samples_split': 8, 'n_estimators': 156}

最佳交叉验证准确率:0.9812

在验证集上的性能报告:
              precision    recall  f1-score   support

     class_0       1.00      1.00      1.00        11
     class_1       1.00      0.94      0.97        16
     class_2       0.90      1.00      0.95         9

    accuracy                           0.97        36
   macro avg       0.97      0.98      0.97        36
weighted avg       0.98      0.97      0.97        36

==================================================
最终模型在测试集(全新数据)上的性能报告:
              precision    recall  f1-score   support

     class_0       1.00      1.00      1.00        14
     class_1       1.00      1.00      1.00        14
     class_2       1.00      1.00      1.00         8

    accuracy                           1.00        36
   macro avg       1.00      1.00      1.00        36
weighted avg       1.00      1.00      1.00        36
その他の拡張