Поиск гиперпараметров
В практике машинного обучения мы часто сталкиваемся с такой путаницей: почему модели других людей могут достигать точности 95% с тем же алгоритмом, а моя — только 85%? Помимо различий в качестве данных и конструировании признаков, ключевой фактор часто заключается вгиперпараметрическихнастройках.
Если алгоритм модели — это двигатель автомобиля, то гиперпараметры — это тонкие регулировочные винты, такие как момент зажигания и объём впрыска топлива. При хорошей настройке двигатель выдаёт мощный прилив силы; при плохой — может не хватать мощности или возможен сильный износ.
В этой статье мы системно познакомим вас с поиском гиперпараметров — важнейшей частью оптимизации и инженерии моделей.
Что такое гиперпараметры?
Прежде чем погрузиться в методы поиска, мы должны сначала прояснить одну ключевую концепцию:гиперпараметрыипараметры моделиразницу между ними.
Параметры модели vs. гиперпараметры
| Свойство | Параметры модели | Гиперпараметры |
|---|---|---|
| Определение | Внутренние переменные, которые модельизучаетиз обучающих данных. | До того как обучение моделиначнётся,конфигурационные переменные, вручную задаваемые разработчиком или выбираемые с помощью алгоритмов. |
| Метод обучения | Автоматически настраиваются с помощью алгоритмов оптимизации (например, градиентного спуска). | Не изучаются из обучающих данных; требуют внешней настройки. |
| Пример | Веса в линейной регрессииwи смещенияb; веса и смещения в нейронных сетях. |
Скорость обучения, максимальная глубина деревьев решений, количество деревьев в случайном лесу и значение K в KNN. |
| Влияние | Определяет способность модели подстраиваться под конкретные данные. | Определяет у моделипроцесс обучения, емкость и структуру,тем самым влияя на итоговую производительность. |
Наглядная аналогия: представьте, что вы учитесь готовить новое блюдо (обучение модели).
- Параметры моделипохожи на конкретные количества "щепотка соли, половина ложки сахара", которые вы определяете в процессе готовки исходя из ингредиентов и температуры. Это количество выводится на практике (обучении).
- Гиперпараметрыопределяются до того, как вы начнете готовить: использовать лижарку на сильном огне с помешиваниемилимедленное томление на слабом огне(скорость обучения)? Сколько всего раз вы должныжарить с помешиванием(количество эпох обучения)? Эти решения принципиально влияют на процесс готовки и итоговый вкус.
Примеры распространенных гиперпараметров
У разных алгоритмов машинного обучения есть свои уникальные гиперпараметры:
Общие гиперпараметры:
learning_rate: Скорость обучения, управляет размером шага обновления параметров модели. Если слишком большая, может «перескочить» оптимальную точку; если слишком маленькая, обучение будет слишком медленным.n_estimators: Количество слабых обучающих алгоритмов (например, деревьев) в ансамблевых моделях.max_iter/epochs: Максимальное количество итераций или эпох обучения.
Линейные модели / нейронные сети:
alpha/lambda: Сила члена регуляризации, используется для предотвращения переобучения.batch_size: Количество примеров, используемых для одного обновления параметров.hidden_layer_sizes: Размер скрытого слоя нейронных сетей.
Древовидные модели:
max_depth: Максимальная глубина дерева, управляет сложностью модели.min_samples_split: Минимальное количество примеров, необходимое для разделения внутреннего узла.min_samples_leaf: Минимальное количество примеров, необходимое в листовом узле.
Зачем нужен поиск гиперпараметров?
Раз гиперпараметры так важны, можно ли просто задавать их произвольно, основываясь на опыте или интуиции? Ответ — нет. Причины следующие:
- Огромное влияние на качество: Для одной и той же модели разные комбинации гиперпараметров могут приводить к сильно различающемуся качеству (например, точности, F1-мере).
- Нет универсальных оптимальных значений: Оптимальные гиперпараметры сильно зависят от конкретного набора данных, задачи и модели; не существует универсального "магического параметра по умолчанию".
- Огромное пространство комбинаций: Множество гиперпараметров взаимодействует друг с другом, образуя многомерное пространство поиска. Ручной перебор методом проб и ошибок крайне неэффективен и легко может застрять в локальном мышлении.
Поэтому нам нужны систематические, автоматизированные методы для исследования этого огромного пространства параметров и поиска конфигураций с лучшим качеством. Этот процесс называетсяпоиском гиперпараметровилиоптимизацией гиперпараметров.。
Его основная цель — найти при приемлемых вычислительных затратах набор гиперпараметров, который обеспечивает оптимальное качество модели нане встречавшихся ранее данных(валидационной выборке) с точки зрения метрик качества.
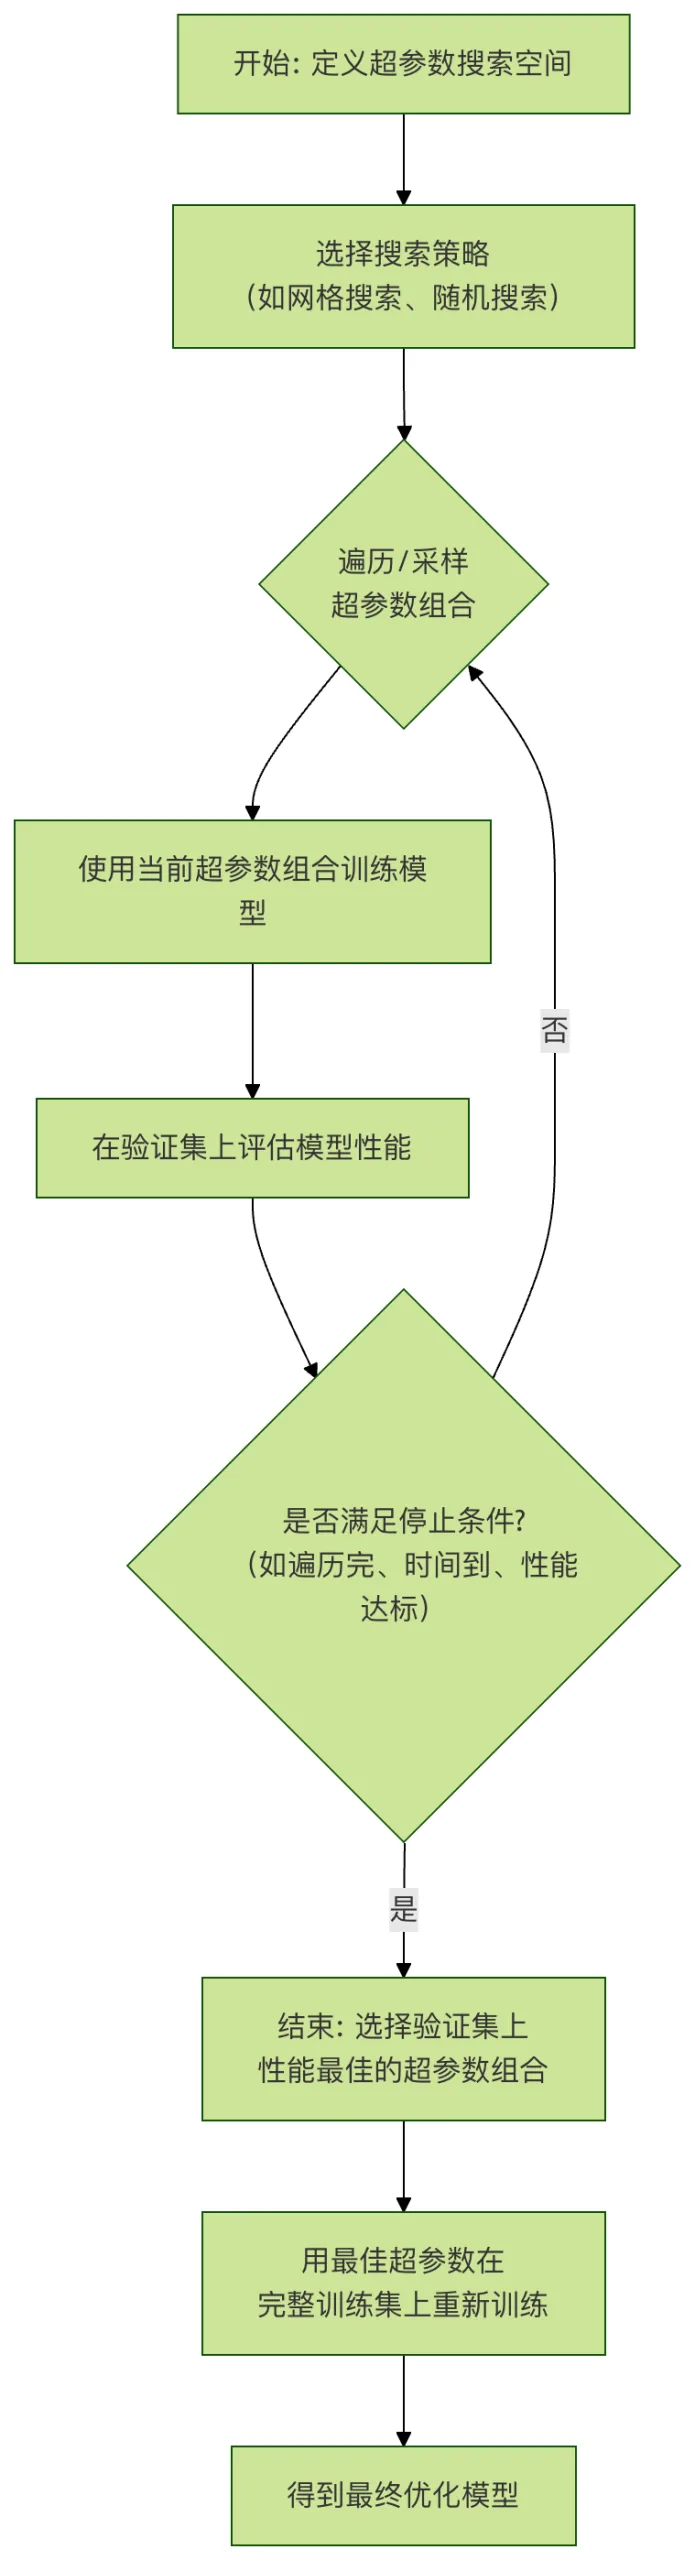
Основные стратегии поиска гиперпараметров
1. Поиск по сетке
Поиск по сетке — самый базовый и интуитивно понятный метод поиска.
Как это работает:
- Определите список значений-кандидатов для каждого искомого гиперпараметра.
- Алгоритм поиска генерируетдекартово произведениеэтих списков, то есть все возможные комбинации.
- Переберите каждую комбинацию, обучите модель и оцените.
- Выберите комбинацию с лучшими показателями на валидационном наборе.
Пример: Поиск двух гиперпараметров машины опорных векторов (SVM).
Пример
param_grid = {
'C': [0.1, 1, 10, 100], # Сила регуляризации, 4 значения-кандидата
'gamma': [0.001, 0.01, 0.1, 1] # Коэффициент ядра, 4 значения-кандидата
}
# Поиск по сетке попробует 4 * 4 = 16 различных комбинаций
Преимущества:
- Простота и надёжность: Если сетка достаточно мелкая, гарантируется нахождение оптимального решения в заданном диапазоне.
- Легко распараллеливается: Обучение и оценка каждой комбинации параметров независимы друг от друга, что делает это очень подходящим для параллельных вычислений.
Недостатки:
- Проклятие размерности: Если число гиперпараметров немного увеличивается или значения-кандидаты становятся плотнее, количество комбинаций растёт экспоненциально, что делает вычислительные затраты непосильными. Например, при 5 параметрах, каждый из которых принимает 10 значений, вам придётся обучить и оценить 10^5 = 100,000 моделей!
- Низкая эффективность: Он может тратить много вычислительных ресурсов на "неважные" параметры.
2. Случайный поиск
Случайный поиск — эффективное улучшение, устраняющее недостатки поиска по сетке.
Как это работает:
- Определите для каждого гиперпараметрараспределение вероятностей(например, равномерное распределение, логарифмически равномерное распределение).
- В пределах указанного общего числа испытаний (
n_iter),случайным образом выберитенабор значений гиперпараметров. - Обучите и оцените каждый выбранный набор параметров.
- Выберите комбинацию с наилучшей производительностью.
Пример: используйте случайный поиск для оптимизации случайного леса.
Пример
from scipy.stats import randint, uniform
param_dist = {
'n_estimators': randint(100, 500), # Целочисленное равномерное распределение, от 100 до 500
'max_depth': randint(5, 30), # Целочисленное равномерное распределение, от 5 до 30
'min_samples_split': uniform(0.01, 0.2) # Непрерывное равномерное распределение, от 0.01 до 0.21
}
# Случайно выполнить 50 испытаний
random_search = RandomizedSearchCV(estimator=rf_model,
param_distributions=param_dist,
n_iter=50,
cv=5,
verbose=2)
random_search.fit(X_train, y_train)
Почему случайный поиск эффективнее?Исследование (Bergstra & Bengio, 2012) показывает, что для большинства задач качество модели обычно чувствительно лишь к нескольким гиперпараметрам. Случайный поиск позволяет намисследовать каждое измерениебольше раз, таким образом имея более высокую вероятность найти лучшую область для важных параметров, а не быть ограниченным фиксированной сеткой неважных параметров, как при поиске по сетке.
Преимущества:
- Высокая вычислительная эффективность: При одинаковом вычислительном бюджете он имеет более высокую вероятность найти лучшее решение, чем поиск по сетке.
- Гибкость: Можно легко задавать распределения вероятностей для параметров (например, поиск скорости обучения по логарифмической шкале).
Недостатки:
- Случайность: Результаты могут различаться в зависимости от случайного начального значения и могут пропускать некоторые области.
- Отсутствие памяти: Каждое испытание независимо и не использует информацию из предыдущих испытаний для управления последующими поисками.
3. Байесовская оптимизация
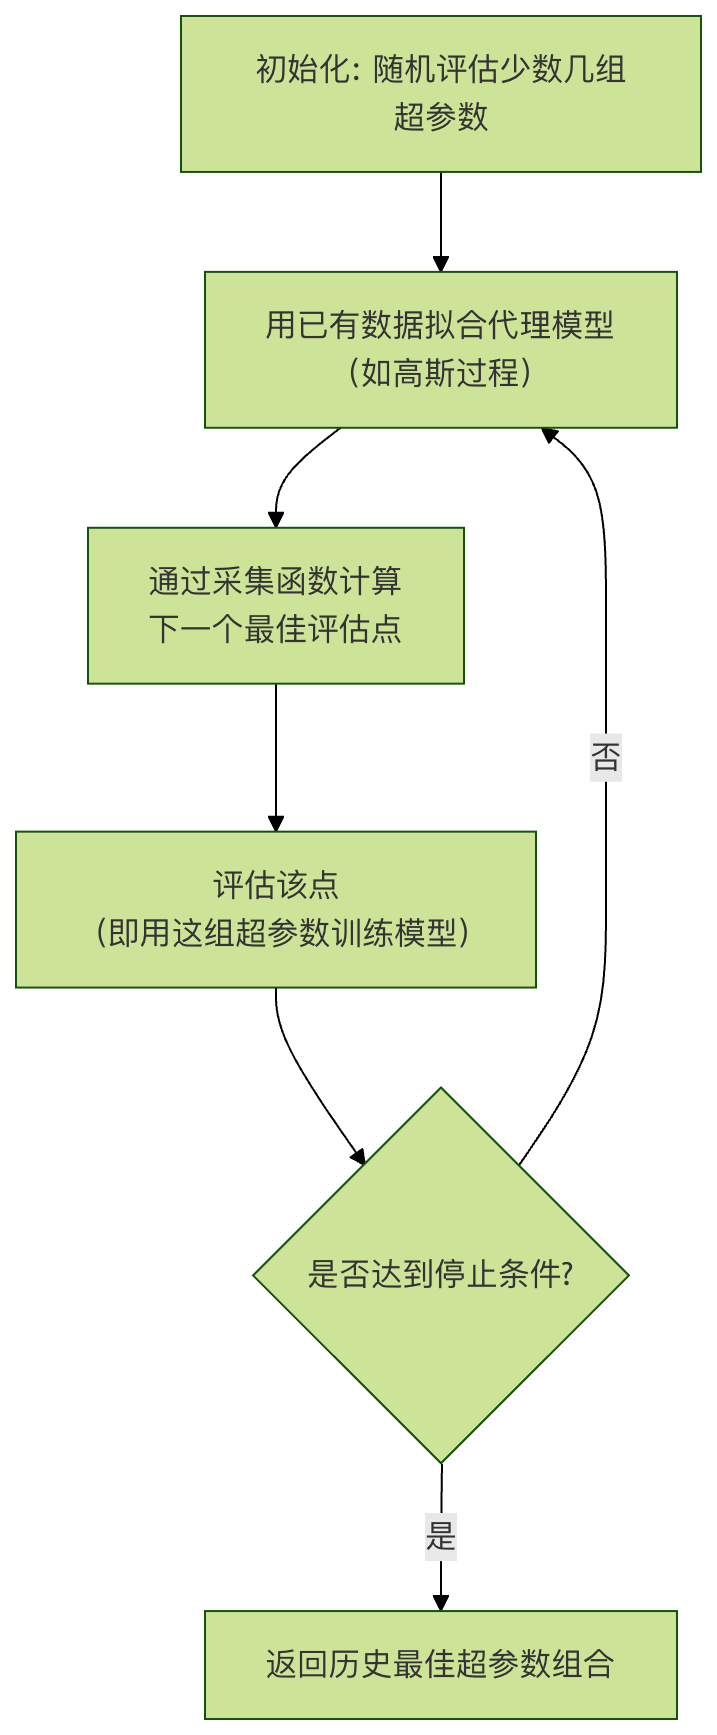
Байесовская оптимизация — это более разумный метод поиска, подходящий для оптимизации функций с очень высокой стоимостью оценки (например, обучение большой модели глубокого обучения может занимать дни).
Основная идея:
- Суррогатная модель: Используйте вычислительно недорогую вероятностную модель (например, гауссовский процесс), чтобы «симулировать» реальную вычислительно дорогую целевую функцию (то есть зависимость между качеством модели и гиперпараметрами).
- Функция сбора: Основываясь на неопределённости суррогатной модели, выберите «наиболее перспективную» комбинацию гиперпараметров для следующей оценки. Она балансируетисследование(выборку в областях с высокой неопределённостью) ииспользование(выборку вблизи областей, о которых известно, что они хорошо работают).
Рабочий процесс:
Преимущества:
- Чрезвычайно эффективна: Может находить почти оптимальное решение при наименьшем числе испытаний, особенно подходит для дорогостоящих моделей.
- Адаптивность: Использует историческую информацию для разумного управления направлением поиска.
Недостатки:
- Сложная реализация: Сложнее, чем два предыдущих.
- Трудно распараллелить: Стандартная байесовская оптимизация является последовательной, и её трудно распараллелить напрямую (хотя существуют улучшенные методы).
- Высокоразмерные пространства: По мере увеличения размерности гиперпараметров подгонка и оптимизация суррогатной модели становятся сложнее.
Распространённые инструменты: scikit-optimize, BayesianOptimization, Optuna, Hyperopt。
Инженерные практики и соображения
1. Стратегия валидации: не загрязняйте тестовую выборку!
При поиске гиперпараметров,никогда неиспользуйте тестовый набор для управления процессом поиска; в противном случае это приведёт к утечке информации и чрезмерно оптимистичным оценкам обобщающей способности.
Правильный подход:
- Разделите данные на:Обучающий набор、Валидационный набор、Тестовый набор。
- Поиск гиперпараметров выполняется по "обучающему набору + валидационному набору" (например, с использованием кросс-валидации).
- После выбора лучших гиперпараметров используйте этот набор параметров, чтобыпереобучить итоговую модель на полном обучающем наборе(или на объединённом обучающем + валидационном наборе).
- Наконец, используйтетестовый набор, который никогда не участвовал ни в каком обучении или настройке, чтобы объективно оценить обобщающую способность итоговой модели.
2. Используйте кросс-валидацию
Чтобы более надёжно оценивать качество гиперпараметров и избежать случайности из-за одного разбиения данных, следует использовать кросс-валидацию.
Пример
# Использовать 5-кратную кросс-валидацию для поиска по сетке
grid_search = GridSearchCV(estimator=model,
param_grid=param_grid,
cv=5, # 5-кратная кросс-валидация
scoring='accuracy',
return_train_score=True)
grid_search.fit(X_train_val, y_train_val) # Здесь используются данные для обучения + валидации
print(f"Лучшие параметры: {grid_search.best_params_}")
print(f"Лучшая оценка кросс-валидации: {grid_search.best_score_:.4f}")
# Получить лучшую модель (уже заново обученную на всех данных с лучшими параметрами)
best_model = grid_search.best_estimator_
3. Советы по проектированию пространства гиперпараметров
- Параметры, чувствительные к масштабу: Для таких параметров, как скорость обучения и сила регуляризации, ихэффективный диапазон часто охватывает несколько порядков величины. Их следует искать в логарифмическом масштабе (например,
[0.001, 0.01, 0.1, 1]), а не в линейном масштабе (например,[0.1, 0.2, ..., 1.0])。 - От грубого к точному: Сначала можно выполнить крупномасштабный случайный поиск или разреженный поиск по сетке, чтобы найти области с лучшей производительностью, затем провести более точный поиск в этих областях.
- Используйте априорные знания: Задавайте разумные начальные диапазоны и распределения на основе принципов алгоритма и эмпирической литературы.
4. Автоматизация и инструментальные цепочки
В реальной инженерии поиск гиперпараметров часто интегрируется в конвейер MLOps.
- Фреймворки:
Scikit-learnпредоставляютGridSearchCVиRandomizedSearchCV。 - продвинутые библиотеки:
Optuna,Ray Tune,Keras Tunerи т. д. предоставляют более мощные, удобные для распределённой работы возможности поиска и поддерживают продвинутые функции, такие как ранняя остановка и прунинг. - Облачные сервисы: Платформы, такие как AWS SageMaker и Google Vertex AI, предоставляют управляемые сервисы оптимизации гиперпараметров.
Практическое занятие
Теперь давайте используемScikit-learnиRandom Forestнабор данных, чтобы выполнить полное упражнение по поиску гиперпараметров.
Задание: Используйте набор данных wine для оптимизации классификатора случайного леса с помощью случайного поиска.
Пример
import numpy as np
from sklearn.datasets import load_wine
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split, RandomizedSearchCV
from sklearn.metrics import classification_report
from scipy.stats import randint
# 2. Загрузка данных и разделение
data = load_wine()
X, y = data.data, data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
X_train_val, X_val, y_train_val, y_val = train_test_split(X_train, y_train, test_size=0.25, random_state=42) # 0.25 * 0.8 = 0.2
# 3. Определение модели и распределений параметров
rf = RandomForestClassifier(random_state=42)
param_dist = {
'n_estimators': randint(50, 300), # Количество деревьев
'max_depth': randint(3, 20), # Максимальная глубина деревьев
'min_samples_split': randint(2, 10), # Минимальное количество образцов, необходимое для разделения внутреннего узла
'min_samples_leaf': randint(1, 5), # Минимальное количество образцов в листовом узле
'max_features': ['sqrt', 'log2'] # Количество признаков, рассматриваемых при поиске лучшего разделения
}
# 4. Выполнение случайного поиска (с 3-кратной кросс-валидацией)
random_search = RandomizedSearchCV(estimator=rf,
param_distributions=param_dist,
n_iter=30, # Случайно перебрать 30 комбинаций параметров
cv=3, # 3-кратная кросс-валидация
scoring='accuracy',
random_state=42,
verbose=1,
n_jobs=-1) # Использовать все ядра CPU для распараллеливания
random_search.fit(X_train_val, y_train_val)
# 5. Вывод результатов поиска
print("="*50)
print("Лучшие параметры случайного поиска:")
print(random_search.best_params_)
print(f"\n"Лучшая точность кросс-валидации: {random_search.best_score_:.4f}")
# 6. Оценить лучшую модель на независимом валидационном наборе
best_model = random_search.best_estimator_
y_val_pred = best_model.predict(X_val)
print("\nОтчёт о производительности на валидационном наборе:)
print(classification_report(y_val, y_val_pred, target_names=data.target_names))
# 7. (Финальный шаг) Переобучите с лучшими параметрами на всём обучающем наборе и оцените на тестовом наборе
final_model = RandomForestClassifier(**random_search.best_params_, random_state=42)
final_model.fit(X_train, y_train) # Использовать все обучающие данные
y_test_pred = final_model.predict(X_test)
print("="*50)
print("Отчёт о производительности финальной модели на тестовом наборе (полностью новые данные):")
print(classification_report(y_test, y_test_pred, target_names=data.target_names))
Вывод:
Fitting 3 folds for each of 30 candidates, totalling 90 fits
==================================================
随机搜索最佳参数:
{'max_depth': 9, 'max_features': 'log2', 'min_samples_leaf': 1, 'min_samples_split': 8, 'n_estimators': 156}

最佳交叉验证准确率:0.9812

在验证集上的性能报告:
              precision    recall  f1-score   support

     class_0       1.00      1.00      1.00        11
     class_1       1.00      0.94      0.97        16
     class_2       0.90      1.00      0.95         9

    accuracy                           0.97        36
   macro avg       0.97      0.98      0.97        36
weighted avg       0.98      0.97      0.97        36

==================================================
最终模型在测试集(全新数据)上的性能报告:
              precision    recall  f1-score   support

     class_0       1.00      1.00      1.00        14
     class_1       1.00      1.00      1.00        14
     class_2       1.00      1.00      1.00         8

    accuracy                           1.00        36
   macro avg       1.00      1.00      1.00        36
weighted avg       1.00      1.00      1.00        36
Другие расширения