Recherche d'hyperparamètres
Dans la pratique de l'apprentissage automatique, nous rencontrons souvent cette confusion : pourquoi les modèles des autres peuvent-ils atteindre 95% de précision avec le même algorithme, alors que le mien n'atteint que 85% ? Outre les différences de qualité des données et d'ingénierie des caractéristiques, un facteur clé réside souvent danshyperparamètresréglages.
Si l’algorithme du modèle est le moteur d’une voiture, alors les hyperparamètres sont les boutons de réglage fin tels que le calage de l’allumage et la quantité d’injection de carburant. Bien réglé, le moteur délivre une poussée de puissance ; mal réglé, il peut manquer de puissance ou subir une usure sévère.
Cet article vous présentera systématiquement la recherche d’hyperparamètres, une partie cruciale de l’optimisation et de l’ingénierie des modèles.
Que sont les hyperparamètres ?
Avant de plonger dans les méthodes de recherche, nous devons d’abord clarifier un concept fondamental :hyperparamètresetparamètres du modèle,la différence entre eux.
Paramètres du modèle vs hyperparamètres
| Propriété | Paramètres du modèle | Hyperparamètres |
|---|---|---|
| Définition | Les variables internes que le modèleapprendà partir des données d’entraînement. | Avant que l’entraînement du modèlene commence,les variables de configuration définies manuellement par le développeur ou sélectionnées via des algorithmes. |
| Méthode d’apprentissage | Ajustés automatiquement via des algorithmes d’optimisation (par exemple, descente de gradient). | Non appris à partir des données d’entraînement ; nécessite un réglage externe. |
| Exemple | Poids dans la régression linéairewet biaisb; les poids et biais dans les réseaux de neurones. |
Taux d'apprentissage, profondeur maximale des arbres de décision, nombre d'arbres dans une forêt aléatoire, et valeur K dans KNN. |
| Impact | Détermine la capacité du modèle à s'ajuster à des données spécifiques. | Détermine le processus d'apprentissage du modèle, sa capacité et sa structure,ce qui affecte ainsi les performances finales. |
Une analogie parlante: Imaginez que vous apprenez à cuisiner un nouveau plat (entraîner un modèle).
- Les paramètres du modèlesont comme les quantités précises de « une pincée de sel, une demi-cuillère de sucre » que vous déterminez pendant le processus de cuisson en fonction des ingrédients et de la chaleur. Cette quantité est obtenue par la pratique (l'entraînement).
- Les hyperparamètresse décident avant de commencer à cuisiner : faut-il utiliserune cuisson à feu vif en remuantouune cuisson lente à feu doux(taux d'apprentissage) ? Combien de fois au total devez-vousfaire revenir(nombre d'époques d'entraînement) ? Ces choix affectent fondamentalement votre processus de cuisson et le goût final.
Exemples d'hyperparamètres courants
Les différents algorithmes d'apprentissage automatique ont leurs hyperparamètres uniques :
Hyperparamètres généraux:
learning_rate: Taux d'apprentissage, contrôle la taille du pas des mises à jour des paramètres du modèle. S'il est trop grand, il peut « sauter » le point optimal ; s'il est trop petit, l'apprentissage sera trop lent.n_estimators: Nombre d'apprenants faibles (par exemple, arbres) dans les modèles d'ensemble.max_iter/epochs: Nombre maximal d'itérations ou d'époques d'entraînement.
Modèles linéaires / réseaux de neurones:
alpha/lambda: Force du terme de régularisation, utilisée pour éviter le surapprentissage.batch_size: Nombre d'échantillons utilisés par mise à jour des paramètres.hidden_layer_sizes: Taille de la couche cachée des réseaux de neurones.
Modèles d'arbres:
max_depth: Profondeur maximale de l'arbre, contrôle la complexité du modèle.min_samples_split: Nombre minimum d'échantillons requis pour scinder un nœud interne.min_samples_leaf: Nombre minimum d'échantillons requis à un nœud feuille.
Pourquoi la recherche d’hyperparamètres est-elle nécessaire ?
Les hyperparamètres étant si importants, pouvons-nous simplement les définir arbitrairement en nous basant sur l’expérience ou l’intuition ? La réponse est non. Les raisons sont les suivantes :
- Impact énorme sur les performances: Pour un même modèle, différentes combinaisons d’hyperparamètres peuvent conduire à des performances très différentes (par ex., exactitude, score F1).
- Pas de valeurs optimales universelles: Les hyperparamètres optimaux dépendent fortement du jeu de données, de la tâche et du modèle spécifiques ; il n’existe pas de « paramètre par défaut magique » universel.
- Espace de combinaisons immense: Plusieurs hyperparamètres interagissent entre eux, formant un espace de recherche de grande dimension. L’essai-erreur manuel est extrêmement inefficace et peut facilement rester bloqué dans une réflexion locale.
Par conséquent, nous avons besoin de méthodes systématiques et automatisées pour explorer ce vaste espace de paramètres et trouver des configurations aux meilleures performances. Ce processus est larecherche d’hyperparamètresou l’optimisation des hyperparamètres.。
Son objectif principal est de trouver, dans un coût de calcul acceptable, un ensemble d’hyperparamètres qui rend le modèle optimal surdes données non vues(ensemble de validation) en termes de métriques de performance.
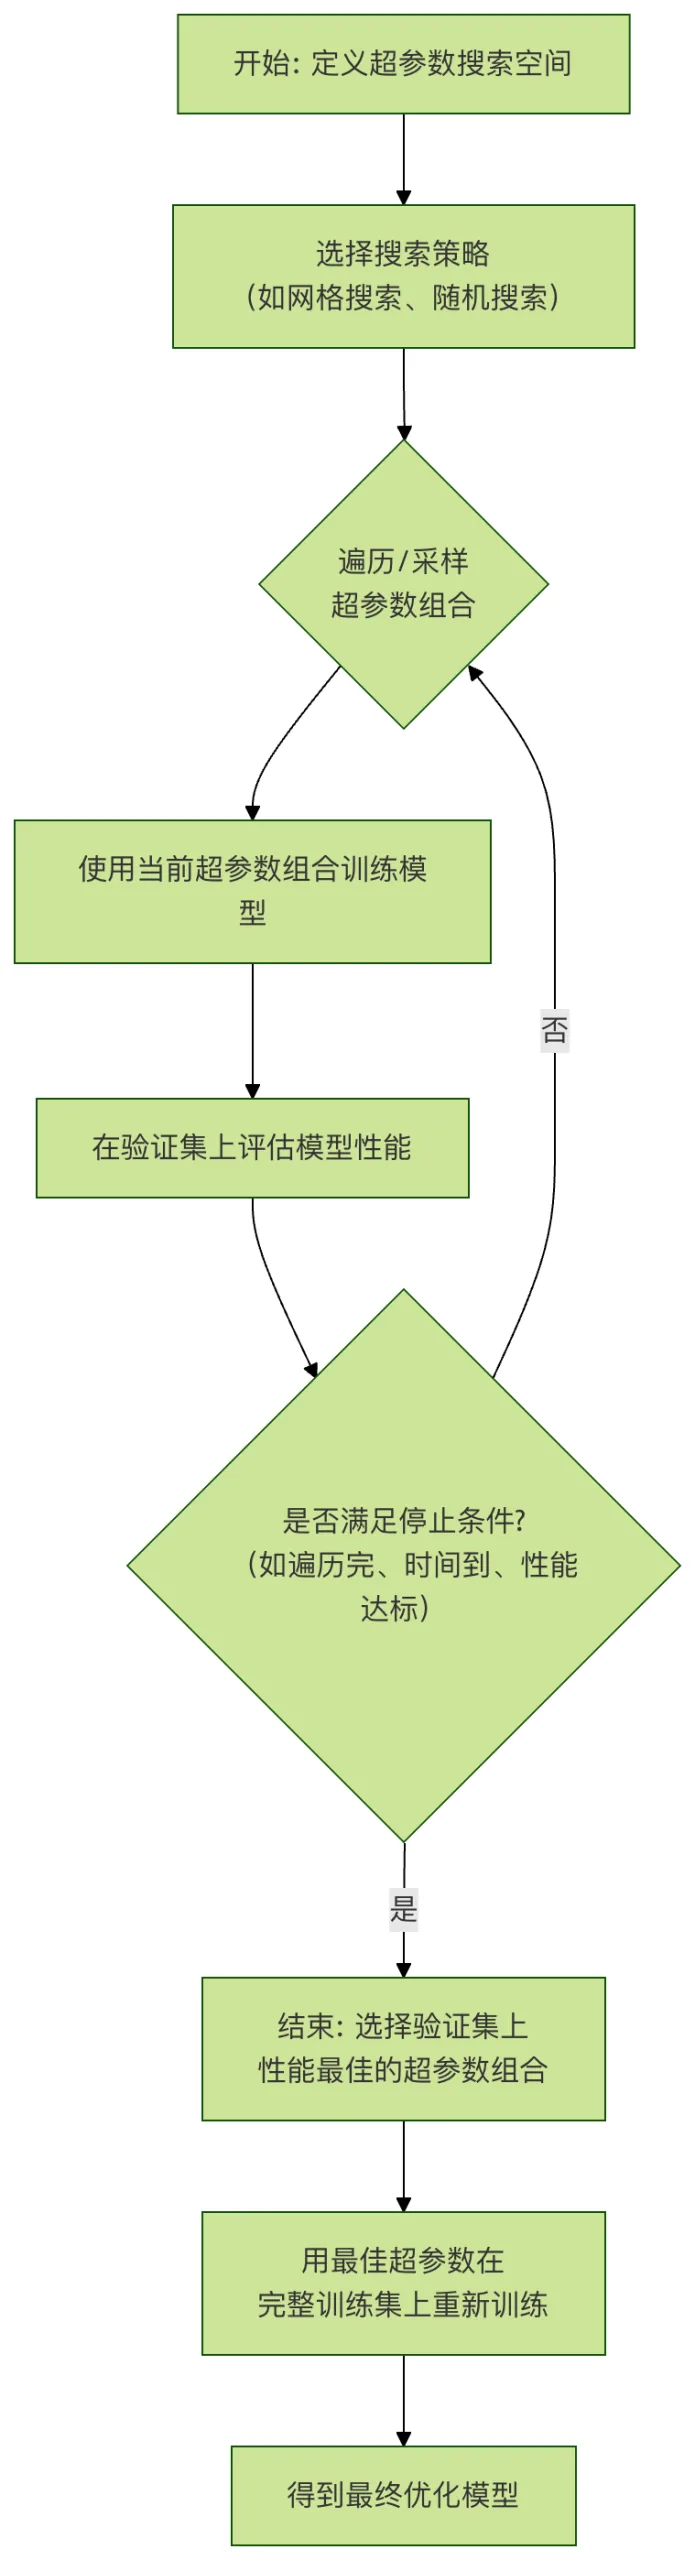
Stratégies de recherche d’hyperparamètres courantes
1. Recherche par grille
La recherche par grille est la méthode de recherche la plus basique et la plus intuitive.
Fonctionnement:
- Définir une liste de valeurs candidates pour chaque hyperparamètre à rechercher.
- L’algorithme de recherche génère leproduit cartésiende ces listes, c’est-à-dire toutes les combinaisons possibles.
- Parcourez chaque combinaison, entraînez le modèle et évaluez-le.
- Sélectionnez la combinaison avec la meilleure performance sur l’ensemble de validation.
Exemple: Rechercher deux hyperparamètres d’une machine à vecteurs de support (SVM).
Exemple
param_grid = {
'C': [0.1, 1, 10, 100], # Force de régularisation, 4 valeurs candidates
'gamma': [0.001, 0.01, 0.1, 1] # Coefficient du noyau, 4 valeurs candidates
}
# La recherche par grille essaiera 4 * 4 = 16 combinaisons différentes
Avantages:
- Simple et fiable: Tant que la grille est suffisamment fine, il est garanti de trouver la solution optimale dans la plage donnée.
- Facile à paralléliser: L’entraînement et l’évaluation de chaque combinaison de paramètres sont indépendants les uns des autres, ce qui les rend très adaptés au calcul parallèle.
Inconvénients:
- Malédiction de la dimensionnalité: Si le nombre d’hyperparamètres augmente légèrement ou que les valeurs candidates deviennent plus denses, le nombre de combinaisons croît exponentiellement, rendant le coût de calcul insupportable. Par exemple, avec 5 paramètres prenant chacun 10 valeurs, vous auriez besoin d’entraîner et d’évaluer 10^5 = 100,000 modèles !
- Faible efficacité: Cela peut gaspiller beaucoup de ressources de calcul sur des paramètres « sans importance ».
2. Recherche aléatoire
La recherche aléatoire est une amélioration efficace par rapport aux inconvénients de la recherche par grille.
Fonctionnement:
- Définir unedistribution de probabilité(par exemple, distribution uniforme, distribution log-uniforme) pour chaque hyperparamètre.
- Dans le nombre total d'essais spécifié (
n_iter),échantillonner aléatoirementun ensemble de valeurs d'hyperparamètres. - Entraîner et évaluer chaque ensemble de paramètres échantillonné.
- Sélectionner la combinaison avec la meilleure performance.
Exemple: Utiliser la recherche aléatoire pour optimiser une forêt aléatoire.
Exemple
from scipy.stats import randint, uniform
param_dist = {
'n_estimators': randint(100, 500), # Distribution uniforme entière, 100 à 500
'max_depth': randint(5, 30), # Distribution uniforme entière, 5 à 30
'min_samples_split': uniform(0.01, 0.2) # Distribution uniforme continue, 0.01 à 0.21
}
# Effectuer 50 essais de manière aléatoire
random_search = RandomizedSearchCV(estimator=rf_model,
param_distributions=param_dist,
n_iter=50,
cv=5,
verbose=2)
random_search.fit(X_train, y_train)
Pourquoi la recherche aléatoire est-elle plus efficace ?Les travaux de recherche (Bergstra & Bengio, 2012) montrent que pour la plupart des problèmes, la performance du modèle n'est généralement sensible qu'à quelques hyperparamètres. La recherche aléatoire nous permet d'explorer chaque dimensionplus souvent, ce qui donne une probabilité plus élevée de trouver la meilleure région pour les paramètres importants, plutôt que d'être contraint par la grille fixe de paramètres non importants comme dans la recherche par grille.
Avantages:
- Efficacité de calcul élevée: Avec le même budget de calcul, elle a une probabilité plus élevée de trouver une meilleure solution que la recherche par grille.
- Flexible: Vous pouvez facilement spécifier des distributions de probabilité pour les paramètres (par ex., rechercher le taux d'apprentissage sur une échelle logarithmique).
Inconvénients:
- Caractère aléatoire: Les résultats peuvent varier selon la graine aléatoire et peuvent manquer certaines régions.
- Aucune mémoire: Chaque essai est indépendant et n'utilise pas les informations des essais précédents pour guider les recherches suivantes.
3. Optimisation bayésienne
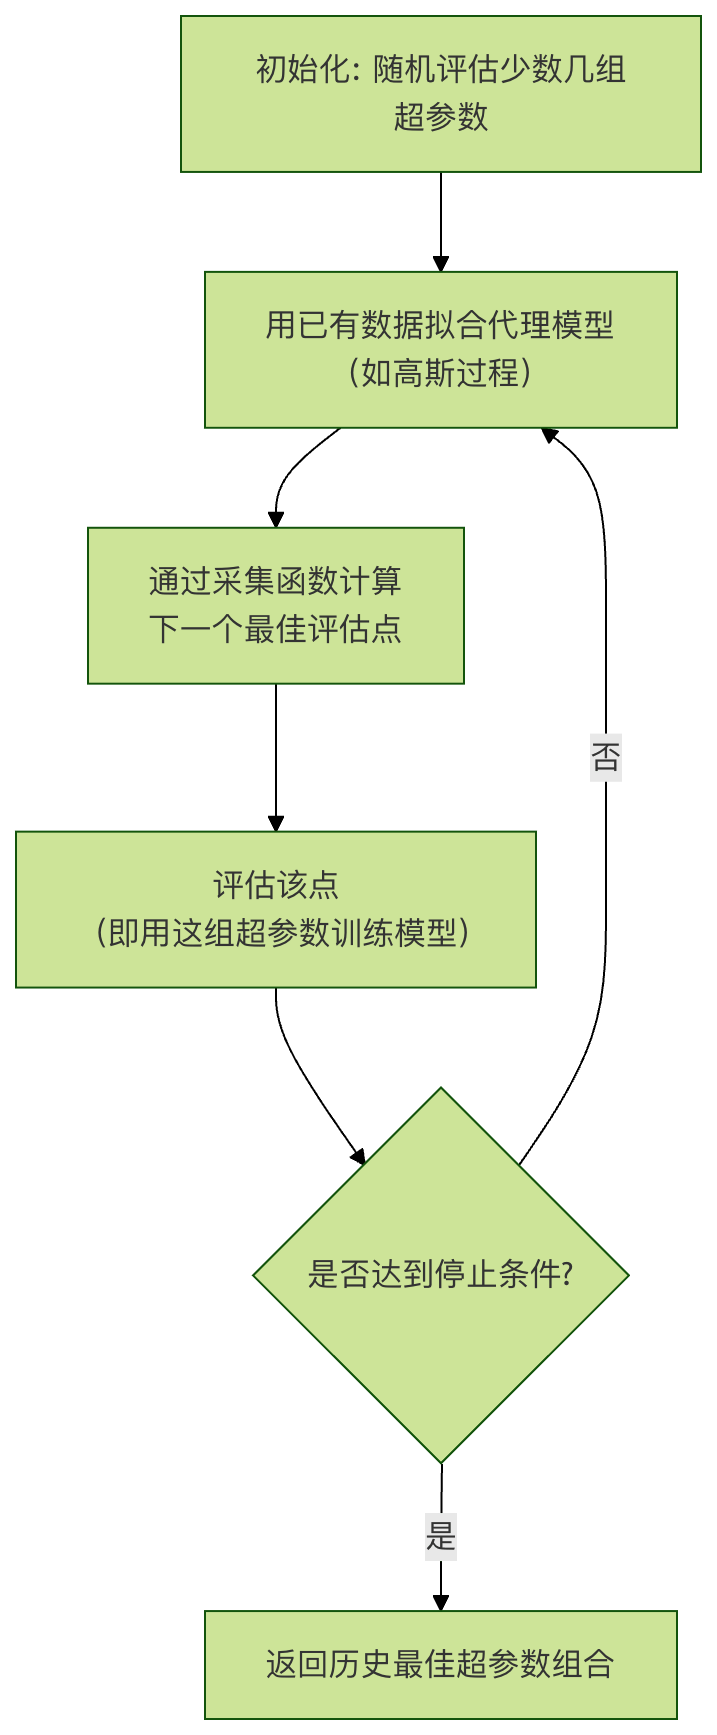
L’optimisation bayésienne est une méthode de recherche plus intelligente adaptée à l’optimisation de fonctions dont les coûts d’évaluation sont très élevés (p. ex., l’entraînement d’un grand modèle d’apprentissage profond peut prendre des jours).
Idée centrale:
- Modèle de substitution: Utiliser un modèle probabiliste peu coûteux en calcul (p. ex., un processus gaussien) pour « simuler » la véritable fonction objectif coûteuse en calcul (c’est-à-dire la relation entre la performance du modèle et les hyperparamètres).
- Fonction d’acquisition: En se fondant sur l’incertitude du modèle de substitution, sélectionner la combinaison d’hyperparamètres « la plus prometteuse » pour l’évaluation suivante. Elle équilibrel’exploration(échantillonnage dans des régions à forte incertitude) etl’exploitation(échantillonnage près de régions connues pour bien fonctionner).
Workflow:
Avantages:
- Extrêmement efficace: Peut trouver une solution quasi optimale avec le moins d’essais possible, particulièrement adaptée aux modèles coûteux.
- Adaptativité: Utilise les informations historiques pour guider intelligemment la direction de recherche.
Inconvénients:
- Implémentation complexe: Plus complexe que les deux précédentes.
- Difficile à paralléliser: L’optimisation bayésienne standard est séquentielle et difficile à paralléliser directement (bien que des méthodes améliorées existent).
- Espaces de grande dimension: À mesure que la dimensionnalité des hyperparamètres augmente, l’ajustement et l’optimisation du modèle de substitution deviennent plus difficiles.
Outils courants: scikit-optimize, BayesianOptimization, Optuna, Hyperopt。
Pratiques d’ingénierie et considérations
1. Stratégie de validation : ne polluez pas votre ensemble de test !
Lors de la recherche des hyperparamètres,n'utilisez jamais l'ensemble de test pour guider le processus de recherche ; sinon, cela entraînera une fuite d'informations et des estimations de performance de généralisation trop optimistes.
Approche correcte:
- Divisez les données en :Ensemble d'entraînement、Ensemble de validation、Ensemble de test。
- La recherche d'hyperparamètres est effectuée sur l'"ensemble d'entraînement + ensemble de validation" (par exemple, en utilisant la validation croisée).
- Après avoir sélectionné les meilleurs hyperparamètres, utilisez cet ensemble de paramètres pourréentraîner le modèle final sur l'ensemble d'entraînement complet(ou l'ensemble combiné d'entraînement + validation).
- Enfin, utilisez l'ensemble de testqui n'a jamais participé à aucun processus d'entraînement ou de réglage pour évaluer équitablement la capacité de généralisation du modèle final.
2. Utilisez la validation croisée
Afin d'évaluer les performances des hyperparamètres de manière plus robuste et d'éviter les aléas liés à une seule division des données, la validation croisée doit être utilisée.
Exemple
# Utilisez une validation croisée à 5 plis pour la recherche sur grille
grid_search = GridSearchCV(estimator=model,
param_grid=param_grid,
cv=5, # Validation croisée à 5 plis
scoring='accuracy',
return_train_score=True)
grid_search.fit(X_train_val, y_train_val) # Ici, utilisez les données d'entraînement + de validation
print(f"Meilleurs paramètres : {grid_search.best_params_}")
print(f"Meilleur score de validation croisée : {grid_search.best_score_:.4f}")
# Obtenir le meilleur modèle (déjà réajusté sur toutes les données avec les meilleurs paramètres)
best_model = grid_search.best_estimator_
3. Conseils de conception pour l'espace des hyperparamètres
- Paramètres sensibles à l'échelle: Pour des paramètres tels que le taux d'apprentissage et l'intensité de régularisation, leurplage effective s'étend souvent sur plusieurs ordres de grandeur. Ils doivent être recherchés sur une échelle logarithmique (par ex.,
[0.001, 0.01, 0.1, 1]), et non sur une échelle linéaire (par ex.,[0.1, 0.2, ..., 1.0])。 - Du grossier au fin: Vous pouvez d'abord effectuer une recherche aléatoire à grande échelle ou une recherche sur grille clairsemée pour localiser les régions performantes, puis mener une recherche plus fine dans ces régions.
- Utilisez les connaissances préalables: Définissez des plages et des distributions initiales raisonnables en vous basant sur les principes de l'algorithme et les données empiriques.
4. Automatisation et chaînes d'outils
Dans l'ingénierie réelle, la recherche d'hyperparamètres est souvent intégrée au pipeline MLOps.
- Frameworks:
Scikit-learnfournissentGridSearchCVetRandomizedSearchCV。 - bibliothèques avancées:
Optuna,Ray Tune,Keras Tuneretc. offrent des capacités de recherche plus puissantes et adaptées au distribué, et prennent en charge des fonctionnalités avancées telles que l’arrêt précoce et l’élagage. - Services cloud: des plateformes telles que AWS SageMaker et Google Vertex AI fournissent des services gérés d’optimisation des hyperparamètres.
Mise en pratique
Maintenant, utilisonsScikit-learnetRandom Forestle jeu de données pour réaliser un exercice complet de recherche d’hyperparamètres.
Tâche: Utilisez le jeu de données wine pour optimiser un classifieur de forêt aléatoire via une recherche aléatoire.
Exemple
import numpy as np
from sklearn.datasets import load_wine
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split, RandomizedSearchCV
from sklearn.metrics import classification_report
from scipy.stats import randint
# 2. Charger les données et les diviser
data = load_wine()
X, y = data.data, data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
X_train_val, X_val, y_train_val, y_val = train_test_split(X_train, y_train, test_size=0.25, random_state=42) # 0.25 * 0.8 = 0.2
# 3. Définir le modèle et les distributions des paramètres
rf = RandomForestClassifier(random_state=42)
param_dist = {
'n_estimators': randint(50, 300), # Nombre d'arbres
'max_depth': randint(3, 20), # Profondeur maximale des arbres
'min_samples_split': randint(2, 10), # Nombre minimum d'échantillons requis pour diviser un nœud interne
'min_samples_leaf': randint(1, 5), # Nombre minimum d'échantillons dans un nœud feuille
'max_features': ['sqrt', 'log2'] # Nombre de caractéristiques à considérer lors de la recherche de la meilleure division
}
# 4. Effectuer une recherche aléatoire (avec validation croisée à 3 plis)
random_search = RandomizedSearchCV(estimator=rf,
param_distributions=param_dist,
n_iter=30, # Essayer aléatoirement 30 combinaisons de paramètres
cv=3, # Validation croisée à 3 plis
scoring='accuracy',
random_state=42,
verbose=1,
n_jobs=-1) # Utiliser tous les cœurs CPU pour la parallélisation
random_search.fit(X_train_val, y_train_val)
# 5. Afficher les résultats de la recherche
print("="*50)
print("Meilleurs paramètres de la recherche aléatoire:")
print(random_search.best_params_)
print(f"\n"Meilleure précision de validation croisée: {random_search.best_score_:.4f}")
# 6. Évaluer le meilleur modèle sur l'ensemble de validation indépendant
best_model = random_search.best_estimator_
y_val_pred = best_model.predict(X_val)
print("\nRapport de performance sur l'ensemble de validation :)
print(classification_report(y_val, y_val_pred, target_names=data.target_names))
# 7. (Étape finale) Réentraîner avec les meilleurs paramètres sur l'ensemble d'entraînement complet, et évaluer sur l'ensemble de test
final_model = RandomForestClassifier(**random_search.best_params_, random_state=42)
final_model.fit(X_train, y_train) # Utiliser toutes les données d'entraînement
y_test_pred = final_model.predict(X_test)
print("="*50)
print("Rapport de performance du modèle final sur l'ensemble de test (données entièrement nouvelles) :")
print(classification_report(y_test, y_test_pred, target_names=data.target_names))
Sortie :
Fitting 3 folds for each of 30 candidates, totalling 90 fits
==================================================
随机搜索最佳参数:
{'max_depth': 9, 'max_features': 'log2', 'min_samples_leaf': 1, 'min_samples_split': 8, 'n_estimators': 156}

最佳交叉验证准确率:0.9812

在验证集上的性能报告:
              precision    recall  f1-score   support

     class_0       1.00      1.00      1.00        11
     class_1       1.00      0.94      0.97        16
     class_2       0.90      1.00      0.95         9

    accuracy                           0.97        36
   macro avg       0.97      0.98      0.97        36
weighted avg       0.98      0.97      0.97        36

==================================================
最终模型在测试集(全新数据)上的性能报告:
              precision    recall  f1-score   support

     class_0       1.00      1.00      1.00        14
     class_1       1.00      1.00      1.00        14
     class_2       1.00      1.00      1.00         8

    accuracy                           1.00        36
   macro avg       1.00      1.00      1.00        36
weighted avg       1.00      1.00      1.00        36
Autres extensions