Ingénierie des fonctionnalités
Imaginez que vous êtes un chef, préparant un délicieux plat. Le modèle d'apprentissage automatique est comme votre « algorithme de cuisson », et les données brutes sont les divers ingrédients que vous avez achetés au marché : légumes, viande, assaisonnements, mais certains peuvent être couverts de boue, certains sont entiers, et certains ont une forte odeur.L'ingénierie des caractéristiquesest le processus de nettoyage, de découpe, de marinage et de combinaison de ces « ingrédients » bruts en « produits semi-finis » pouvant être directement cuisinés. C'est le pont entre les données brutes et les modèles d'apprentissage automatique, et une étape clé qui détermine la limite supérieure des performances du modèle.
En termes simples,l'ingénierie des caractéristiquesest le processus consistant à utiliser la connaissance du domaine, au moyen d'une série de techniques, pour extraire, construire et sélectionner des caractéristiques (variables) plus précieuses et plus faciles à apprendre pour les modèles d'apprentissage automatique à partir des données brutes.
I. Pourquoi l'ingénierie des caractéristiques est-elle si importante ?
Dans les projets d'apprentissage automatique, la qualité des données et des caractéristiques détermine directement la limite supérieure des performances du modèle, tandis que les modèles et les algorithmes ne font que s'en approcher. Une excellente ingénierie des caractéristiques peut :
- Améliorer les performances du modèle: de bonnes caractéristiques permettent au modèle de découvrir plus facilement des motifs dans les données.
- Accélérer l'entraînement du modèle: réduire les caractéristiques non pertinentes ou redondantes peut diminuer la complexité computationnelle.
- Améliorer la généralisation du modèle: Empêcher le modèle de surapprendre le bruit dans les données d'entraînement.
- Adapter aux exigences du modèle: Différents modèles ont différentes hypothèses sur les données (par exemple, les modèles linéaires supposent des relations linéaires) ; l'ingénierie des caractéristiques peut faire en sorte que les données satisfassent ces hypothèses.
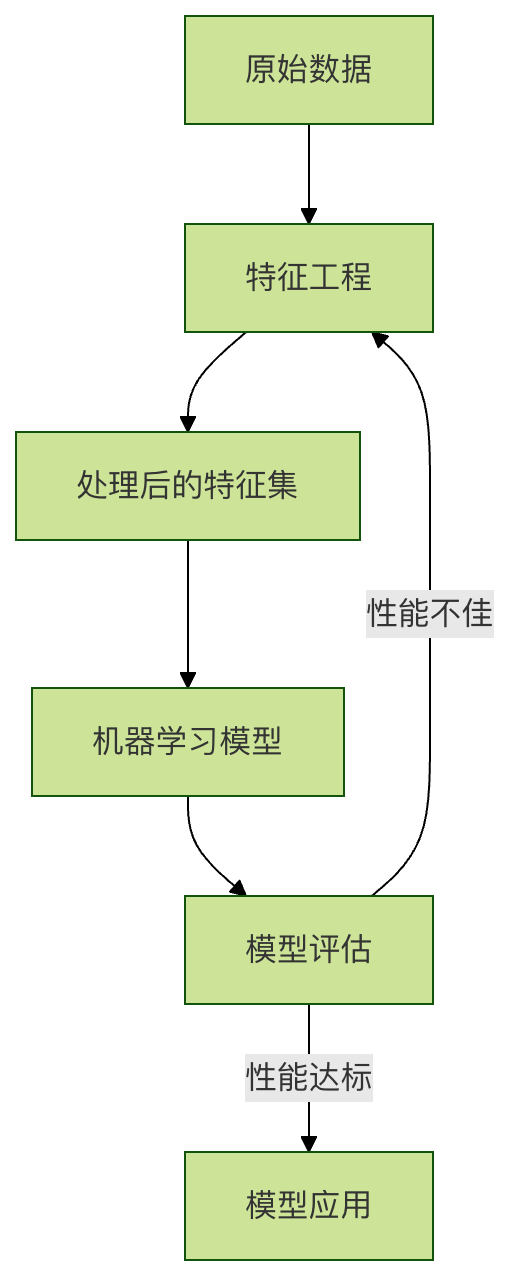
Nous pouvons utiliser l'organigramme suivant pour comprendre intuitivement la position de l'ingénierie des caractéristiques dans l'ensemble du pipeline d'apprentissage automatique :
II. Opérations essentielles de l'ingénierie des caractéristiques
L'ingénierie des caractéristiques comprend principalement trois grandes catégories d'opérations :Traitement des caractéristiques、Construction de caractéristiquesetSélection de caractéristiques。
1. Traitement des caractéristiques
Il s'agit de l'étape la plus élémentaire, visant à « nettoyer » les données brutes pour les transformer en un format propre et bien organisé.
a) Gestion des valeurs manquantes
Les valeurs manquantes existent souvent dans les données (par exemple,NaN, NULL), et doivent être traitées de manière appropriée.
| Méthode de gestion | Description | Scénario d'application |
|---|---|---|
| Delete | Supprimer directement les lignes ou les colonnes contenant des valeurs manquantes | Lorsque les données manquantes sont très rares, ou que la caractéristique n'est pas importante |
| Imputation | Remplir avec une certaine valeur, telle que la moyenne, la médiane, le mode, ou une valeur spéciale (par exemple, -1) | La méthode la plus couramment utilisée, applicable à diverses situations |
| Interpolation | Utiliser des séries temporelles ou des points de données adjacents pour le calcul d'interpolation | Données de séries temporelles |
Exemple de code (avec la bibliothèque pandas de Python) :
Exemple
import numpy as np
# Créer un DataFrame d'exemple avec des valeurs manquantes
data = {'age': [25, np.nan, 30, 35, np.nan],
'salary': [50000, 54000, np.nan, 62000, 58000],
'city': ['Beijing', 'Shanghai', 'Guangzhou', np.nan, 'Beijing']}
df = pd.DataFrame(data)
print(“Données brutes :”)
print(df)
# 1. Supprimer les valeurs manquantes (supprimer toutes les lignes contenant NaN)
df_dropped = df.dropna()
print("\nAprès suppression des valeurs manquantes :")
print(df_dropped)
# 2. Remplir les valeurs manquantes
# Remplir les colonnes numériques avec la moyenne
df_filled = df.copy()
df_filled['age'].fillna(df_filled['age'].mean(), inplace=True)
df_filled['salary'].fillna(df_filled['salary'].mean(), inplace=True)
# Remplir les colonnes catégorielles avec le mode
df_filled['city'].fillna(df_filled['city'].mode()[0], inplace=True)
print("\nAprès remplissage des valeurs manquantes :")
print(df_filled)
b) Traitement des valeurs aberrantes
Les valeurs aberrantes sont des valeurs significativement différentes de la plupart des données et peuvent perturber le modèle. Les méthodes de détection courantes incluent :
- Méthode de l'écart-type: Les valeurs en dehors de l'intervalle de la moyenne ± 3 fois l'écart-type sont considérées comme aberrantes.
- Méthode du diagramme en boîte: Les valeurs inférieures à
Q1 - 1.5*IQRou supérieure àQ3 + 1.5*IQRsont considérées comme aberrantes (IQR = Q3 - Q1)。
Les méthodes de traitement peuvent être la suppression, le remplacement par des valeurs limites, ou leur traitement comme des valeurs manquantes.
c) Standardisation/normalisation des données
De nombreux modèles (tels que SVM, KNN, réseaux de neurones) sont sensibles à l'échelle des caractéristiques. Nous devons transformer des caractéristiques d'échelles différentes vers la même échelle.
| Méthode | Formule | Description | Scénario d'application |
|---|---|---|---|
| Normalisation | (x - 均值) / 标准差 |
Après traitement, les données ont une moyenne de 0 et un écart-type de 1 | Lorsque la distribution des données est approximativement normale |
| Normalisation | (x - min) / (max - min) |
Mettre les données à l'échelle de l'intervalle [0, 1] | Lorsque les limites des données sont claires et qu'un calcul rapide est nécessaire |
Exemple de code (utilisant la bibliothèque scikit-learn) :
Exemple
import numpy as np
# Données d'exemple
data = np.array([[1000, 25],
[1500, 30],
[800, 20],
[1200, 28]])
# Standardisation
scaler_standard = StandardScaler()
data_standardized = scaler_standard.fit_transform(data)
print("Données standardisées (moyenne ~ 0, écart-type ~ 1) :")
print(data_standardized)
print(f"Moyenne : {data_standardized.mean(axis=0)}")
print(f"Écart-type : {data_standardized.std(axis=0)}")
# Normalisation
scaler_minmax = MinMaxScaler()
data_normalized = scaler_minmax.fit_transform(data)
print("\nDonnées normalisées (plage [0,1]) : ")
print(data_normalized)
2. Construction de caractéristiques
Créez de nouvelles caractéristiques plus prédictives en combinant ou en transformant des caractéristiques existantes.
a) Transformer les caractéristiques numériques
- Caractéristiques polynomiales: Créez des carrés, des cubes, etc. de caractéristiques pour aider les modèles linéaires à apprendre des relations non linéaires.
- Discrétisation: Divisez l'âge continu en intervalles tels que "jeune", "d'âge moyen", "âgé", en discrétisant les données continues.
- Transformation mathématique: Utilisez des transformations comme le logarithme, l'exponentielle, etc. pour modifier la distribution des données.
b) Encoder les caractéristiques catégorielles
Les modèles d'apprentissage automatique ne peuvent pas traiter directement du texte tel que "Beijing", "Shanghai". Ils doivent être convertis en nombres.
| Méthode | Description | Caractéristiques |
|---|---|---|
| Encodage des étiquettes | Assignez un entier unique à chaque catégorie, par exemple,北京:0, 上海:1 |
Simple, mais peut introduire des relations d'ordre incorrectes (le modèle peut penser que 1>0) |
| Encodage one-hot | Créer une nouvelle caractéristique binaire (0 ou 1) pour chaque catégorie | Peut éliminer les malentendus d'ordre, mais s'il y a de nombreuses catégories, cela entraînera une explosion de la dimension des caractéristiques |
Exemple de code :
Exemple
from sklearn.preprocessing import LabelEncoder, OneHotEncoder
# Données d'exemple
df_cat = pd.DataFrame({'city': ['Beijing', 'Shanghai', 'Guangzhou', 'Beijing', 'Shenzhen']})
# Encodage des étiquettes
le = LabelEncoder()
df_cat['city_label_encoding'] = le.fit_transform(df_cat['city'])
print("Résultat de l'encodage des étiquettes :")
print(df_cat)
# Encodage one-hot
# Méthode 1 : Utiliser pandas get_dummies
df_onehot_pd = pd.get_dummies(df_cat['city'], prefix='city')
print("\nUtiliser pandas pour l'encodage one-hot : ")
print(df_onehot_pd)
# Méthode 2 : utiliser OneHotEncoder de sklearn (plus couramment utilisé dans les pipelines)
ohe = OneHotEncoder(sparse_output=False) # sparse_output=False renvoie un tableau au lieu d'une matrice creuse
encoded_array = ohe.fit_transform(df_cat[['city']]) # Notez que l'entrée doit être en 2D
print("\nEncodage one-hot avec sklearn (forme tableau) :")
print(encoded_array)
print("Nom de la nouvelle caractéristique :", ohe.get_feature_names_out())
3. Sélection des caractéristiques
Sélectionnez le sous-ensemble le plus important parmi toutes les caractéristiques pour réduire la dimensionnalité et le risque de surapprentissage.
| Méthode | Description |
|---|---|
| Méthode de filtrage | Classer et filtrer en fonction de la corrélation statistique entre les caractéristiques et la variable cible (par ex., variance, test du chi carré, information mutuelle). Indépendant de tout modèle. |
| Méthode d'encapsulation | Traiter la sélection de caractéristiques comme un problème de recherche, en utilisant la performance du modèle comme critère d'évaluation (par ex., élimination récursive des caractéristiques, RFE). De meilleurs résultats, mais un coût de calcul élevé. |
| Méthode embarquée | Effectuer automatiquement la sélection de caractéristiques pendant l'entraînement du modèle (par ex., régularisation L1, régression LASSO, importance des caractéristiques d'un modèle arborescent). |
Exemple de code (sélection basée sur l'importance des caractéristiques) :
Exemple
from sklearn.ensemble import RandomForestClassifier
import pandas as pd
import matplotlib.pyplot as plt
# Charger le jeu de données
data = load_breast_cancer()
X = pd.DataFrame(data.data, columns=data.feature_names)
y = data.target
# Entraîner un modèle de forêt aléatoire, qui calculera l'importance des caractéristiques
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X, y)
# Obtenir l'importance des caractéristiques
importances = model.feature_importances_
feature_importance_df = pd.DataFrame({
'Feature': data.feature_names,
'Importance': importances
}).sort_values('Importance', ascending=False)
print("Classement de l'importance des caractéristiques :")
print(feature_importance_df.head(10)) # Afficher les 10 caractéristiques les plus importantes
# Visualisation
plt.figure(figsize=(10, 6))
plt.barh(feature_importance_df['Feature'][:10], feature_importance_df['Importance'][:10])
plt.xlabel('Importance des caractéristiques')
plt.title('Top 10 des caractéristiques les plus importantes')
plt.gca().invert_yaxis() # Placer les plus importantes en haut
plt.show()
# Supposons que nous sélectionnions les caractéristiques ayant une importance supérieure à 0.03
selected_features = feature_importance_df[feature_importance_df['Importance'] > 0.03]['Feature'].tolist()
print(f"\n" Caractéristiques filtrées : {selected_features}")
III. Exercice pratique : Traiter un jeu de données simple à la main
Tâche: Effectuer une ingénierie de base des caractéristiques sur le célèbre jeu de données des passagers du Titanic afin de préparer la prédiction de la survie des passagers.
Indications pour les étapes:
- Chargez les données (vous pouvez utiliser
seabornde la bibliothèqueload_dataset('titanic'))。 - Observez les données : vérifiez les types de caractéristiques et les valeurs manquantes.
- Traitement des caractéristiques :
- Gérer les valeurs manquantes (par ex., remplir avec la médiane
age, remplir avec le modeembarked)。 - va
sexcaractéristique (Sex) en utilisantl'encodage par étiquettesoul'encodage one-hot。 - Pair
age(Age) en utilisantla discrétisation, créez une nouvelle caractéristique de groupe d'âge.
- Gérer les valeurs manquantes (par ex., remplir avec la médiane
- Construction de caractéristiques :
- Combinez
sibsp(nombre de frères et sœurs/conjoints) etparch(nombre de parents/enfants) pour construire une nouvellefamily_sizecaractéristique (taille de la famille).
- Combinez
- Sélection de caractéristiques :
- Supprimez les caractéristiques que vous jugez clairement non pertinentes (par ex.,
passenger_id,name,ticket)。 - Essayez de calculer la corrélation entre les caractéristiques numériques et la cible de survie, puis filtrez les caractéristiques.
- Supprimez les caractéristiques que vous jugez clairement non pertinentes (par ex.,
À travers cet exercice, vous constaterez par vous-même comment les données brutes deviennent plus « conviviales » pour les modèles d'apprentissage automatique grâce à une ingénierie des caractéristiques étape par étape.
Résumé
L'ingénierie des caractéristiques est un artisanat en apprentissage automatique qui combinel'art(connaissances du domaine, expérience, intuition) etla science(méthodes statistiques, algorithmes). Elle n'a pas de règles fixes ; elle nécessite des essais et des itérations répétés en fonction des données, du problème et du modèle spécifiques. Pour les débutants, maîtriser les méthodes de base présentées dans cet article et s'exercer assidûment jettera les bases les plus solides pour construire des modèles d'apprentissage automatique efficaces. Rappelez-vous,les excellents modèles viennent souvent d'excellentes caractéristiques。
Autres extensions