Инженерия признаков
Представьте, что вы шеф-повар, готовящий вкусное блюдо. Модель машинного обучения похожа на ваш "алгоритм приготовления", а исходные данные — это различные ингредиенты, купленные на рынке: овощи, мясо, приправы, но некоторые могут быть в грязи, некоторые — целыми кусками, а некоторые имеют сильный запах.Инженерия признаков— это процесс очистки, нарезки, маринования и объединения этих исходных "ингредиентов" в "полуфабрикаты", которые можно сразу готовить. Это мост, соединяющий исходные данные и модели машинного обучения, и ключевой шаг, определяющий верхний предел эффективности модели.
Проще говоря,инженерия признаков— это процесс использования знаний предметной области, посредством ряда технических приёмов, для извлечения, конструирования и выбора признаков (переменных), которые более ценны и легче изучаются моделями машинного обучения из исходных данных.
I. Почему инженерия признаков так важна?
В проектах машинного обучения качество данных и признаков напрямую определяет верхний предел эффективности модели, тогда как модели и алгоритмы лишь приближаются к этому пределу. Отличная инженерия признаков может:
- Улучшить эффективность модели: Хорошие признаки позволяют модели легче обнаруживать закономерности в данных.
- Ускорить обучение модели: Сокращение нерелевантных или избыточных признаков может снизить вычислительную сложность.
- Повысить обобщающую способность модели: предотвратить переобучение модели на шуме в обучающих данных.
- Адаптироваться к требованиям модели: Разные модели имеют разные предположения о данных (например, линейные модели предполагают линейные зависимости); инженерия признаков может заставить данные удовлетворять этим предположениям.
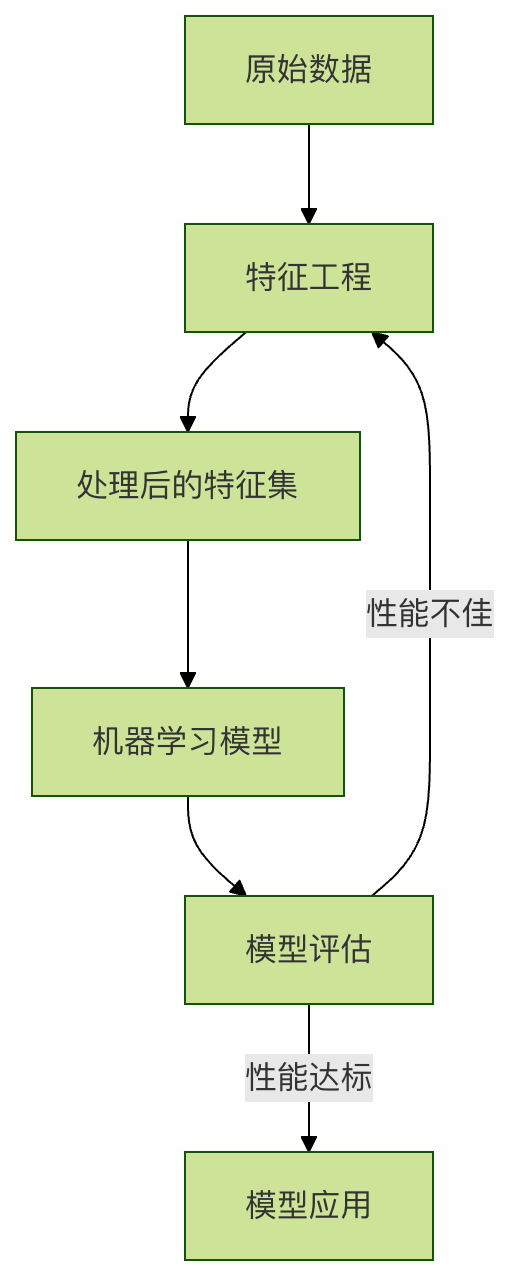
С помощью следующей блок-схемы можно наглядно понять место инженерии признаков во всём конвейере машинного обучения:
II. Основные операции инженерии признаков
Инженерия признаков в основном включает три основные категории операций:обработка признаков,、конструирование признаковиотбор признаков。
1. Обработка признаков
Это самый базовый этап, направленный на "очистку" исходных данных и приведение их к чистому и хорошо организованному формату.
a) Обработка пропущенных значений
Пропущенные значения часто встречаются в данных (например,NaN, NULL), и их нужно обрабатывать надлежащим образом.
| Способ обработки | Описание | Сценарий применения |
|---|---|---|
| Delete | Непосредственно удалить строки или столбцы, содержащие пропущенные значения | Когда пропущенных данных очень мало или признак неважен |
| Импутация | Заполнение определённым значением, например средним, медианой, модой или специальным значением (например, -1) | Наиболее часто используемый метод, применимый в различных ситуациях |
| Интерполяция | Использование временных рядов или соседних точек данных для расчёта интерполяции | Данные временных рядов |
Пример кода (с использованием библиотеки pandas для Python):
Пример
import numpy as np
# Создать пример DataFrame с пропущенными значениями
data = {'age': [25, np.nan, 30, 35, np.nan],
'salary': [50000, 54000, np.nan, 62000, 58000],
'city': ['Пекин', 'Шанхай', 'Гуанчжоу', np.nan, 'Beijing']}
df = pd.DataFrame(data)
print(“Исходные данные:”)
print(df)
# 1. 删除缺失值 (删除任何包含 NaN 的行)
df_dropped = df.dropna()
print("\n删除缺失值后:")
print(df_dropped)
# 2. 填充缺失值
# 用均值填充数值列
df_filled = df.copy()
df_filled['age'].fillna(df_filled['age'].mean(), inplace=True)
df_filled['salary'⟦⟧fillna].fillna(df_filled['salary'].mean(), inplace=True)
# 用众数填充分类列
df_filled['city'].fillna(df_filled['city'].mode()[0], inplace=True)
print("\n填充缺失值后:")
print(df_filled)
б) Обработка выбросов
Выбросы — это значения, которые значительно отличаются от большинства данных и могут мешать модели. Распространённые методы обнаружения включают:
- Метод стандартного отклонения: значения, выходящие за пределы диапазона среднего значения ± 3 стандартных отклонения, считаются выбросами.
- Метод ящика с усами: значения меньше
Q1 - 1.5*IQRили большеQ3 + 1.5*IQRсчитаются выбросами (IQR = Q3 - Q1)。
Методы обработки могут включать удаление, замену граничными значениями или обработку их как пропущенных значений.
в) Стандартизация/нормализация данных
Многие модели (такие как SVM, KNN, нейронные сети) чувствительны к масштабам признаков. Нам нужно привести признаки разных масштабов к одному масштабу.
| Метод | Формула | Описание | Сценарий применения |
|---|---|---|---|
| Стандартизация | (x - 均值) / 标准差 |
После обработки данные имеют среднее 0 и стандартное отклонение 1 | Когда распределение данных приблизительно нормальное |
| Нормализация | (x - min) / (max - min) |
Масштабируйте данные к интервалу [0, 1] | Когда границы данных чёткие и требуется быстрый расчёт |
Пример кода (с использованием библиотеки scikit-learn):
Пример
import numpy as np
# Пример данных
data = np.array([[1000, 25],
[1500, 30],
[800, 20],
[1200, 28]])
# Стандартизация
scaler_standard = StandardScaler()
data_standardized = scaler_standard.fit_transform(data)
print("Стандартизированные данные (среднее ~ 0, стандартное отклонение ~ 1):")
print(data_standardized)
print(f"Среднее: {data_standardized.mean(axis=0)}")
print(f"Стандартное отклонение: {data_standardized.std(axis=0)}")
# Нормализация
scaler_minmax = MinMaxScaler()
data_normalized = scaler_minmax.fit_transform(data)
print("\nНормализованные данные (диапазон [0,1]): ")
print(data_normalized)
2. Конструирование признаков
Создавайте новые, более предсказательные признаки, комбинируя или преобразуя существующие признаки.
a) Преобразование числовых признаков
- Полиномиальные признаки: создавайте квадраты, кубы и т. д. признаков, чтобы помочь линейным моделям улавливать нелинейные зависимости.
- Биннинг: разделите непрерывный возраст на интервалы, такие как "молодой", "средний возраст", "пожилой", дискретизируя непрерывные данные.
- Математическое преобразование: используйте такие преобразования, как логарифм, экспонента и т. д., чтобы изменить распределение данных.
b) Кодирование категориальных признаков
Модели машинного обучения не могут напрямую обрабатывать текст, такой как "Пекин", "Шанхай". Его необходимо преобразовать в числа.
| Метод | Описание | Характеристики |
|---|---|---|
| Кодирование меток | Присвойте каждой категории уникальное целое число, например,北京:0, 上海:1 |
Просто, но может привести к неправильным отношениям порядка (модель может подумать, что 1>0) |
| One-hot-кодирование | Создать новый бинарный признак (0 или 1) для каждой категории | Может устранить непонимание порядка, но если категорий много, это приведёт к взрыву размерности признаков |
Пример кода:
Пример
from sklearn.preprocessing import LabelEncoder, OneHotEncoder
# Пример данных
df_cat = pd.DataFrame({'city': ['Beijing', 'Shanghai', 'Guangzhou', 'Beijing', 'Shenzhen']})
# Кодирование меток
le = LabelEncoder()
df_cat['city_label_encoding'] = le.fit_transform(df_cat['city'])
print("Результат кодирования метками:")
print(df_cat)
# Одноразрядное кодирование
# Способ 1: использовать pandas get_dummies
df_onehot_pd = pd.get_dummies(df_cat['city'], prefix='city')
print("\nИспользуйте pandas для one-hot кодирования: ")
print(df_onehot_pd)
# Метод 2: Использование OneHotEncoder из sklearn (чаще используется в конвейерах)
ohe = OneHotEncoder(sparse_output=False) # sparse_output=False возвращает массив вместо разреженной матрицы
encoded_array = ohe.fit_transform(df_cat[['city']]) # Обратите внимание, что входные данные должны быть 2D
print("\nOne-hot кодирование с использованием sklearn (в виде массива):")
print(encoded_array)
print("Название нового признака:", ohe.get_feature_names_out())
3. Отбор признаков
Выберите наиболее важное подмножество из всех признаков, чтобы уменьшить размерность и снизить риск переобучения.
| Метод | Описание |
|---|---|
| Метод фильтрации | Ранжирование и фильтрация на основе статистической корреляции между признаками и целевой переменной (например, дисперсия, критерий хи-квадрат, взаимная информация). Не зависит от модели. |
| Метод обертки | Рассматривает отбор признаков как задачу поиска, используя производительность модели в качестве критерия оценки (например, рекурсивное исключение признаков, RFE). Лучшие результаты, но высокие вычислительные затраты. |
| Встроенный метод | Выполняет отбор признаков автоматически во время обучения модели (например, L1-регуляризация, LASSO-регрессия, важность признаков в древовидной модели). |
Пример кода (отбор на основе важности признаков):
Пример
from sklearn.ensemble import RandomForestClassifier
import pandas as pd
import matplotlib.pyplot as plt
# Загрузить набор данных
data = load_breast_cancer()
X = pd.DataFrame(data.data, columns=data.feature_names)
y = data.target
# Обучите модель случайного леса, которая вычислит важность признаков
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X, y)
# Получите важность признаков
importances = model.feature_importances_
feature_importance_df = pd.DataFrame({
'Feature': data.feature_names,
'Importance': importances
}).sort_values('Importance', ascending=False)
print("Рейтинг важности признаков:")
print(feature_importance_df.head(10)) # Просмотр 10 наиболее важных признаков
# Визуализация
plt.figure(figsize=(10, 6))
plt.barh(feature_importance_df['Feature'][:10], feature_importance_df['Importance'][:10])
plt.xlabel('Важность признаков')
plt.title('Топ-10 важных признаков')
plt.gca().invert_yaxis() # Расположить самые важные сверху
plt.show()
# Предположим, мы выбираем признаки с важностью больше 0.03
selected_features = feature_importance_df[feature_importance_df['Importance'] > 0.03]['Feature'].tolist()
print(f"\n" Отфильтрованные признаки: {selected_features}")
III. Практическое упражнение: Обработка простого набора данных вручную
Задача: Выполните базовое конструирование признаков на знаменитом наборе данных о пассажирах «Титаник», чтобы подготовиться к прогнозированию выживаемости пассажиров.
Подсказки по шагам:
- Загрузите данные (можно использовать
seabornиз библиотекиload_dataset('titanic'))。 - Изучите данные: проверьте типы признаков и пропущенные значения.
- Обработка признаков:
- Обработайте пропущенные значения (например, заполните медианой
age, заполните модойembarked)。 - будет
sexПризнак (Sex) с использованиемlabel encodingилиone-hot encoding。 - Пара
age(Age) с использованиембиннинга, создайте новый признак возрастной группы.
- Обработайте пропущенные значения (например, заполните медианой
- Конструирование признаков:
- Объедините
sibsp(количество братьев/сестер и супругов) иparch(количество родителей/детей), чтобы создать новыйfamily_sizeпризнак (размер семьи).
- Объедините
- Отбор признаков:
- Удалите признаки, которые, по вашему мнению, явно нерелевантны (например,
passenger_id,name,ticket)。 - Попробуйте вычислить корреляцию между числовыми признаками и целевой переменной выживания и отфильтровать признаки.
- Удалите признаки, которые, по вашему мнению, явно нерелевантны (например,
С помощью этого упражнения вы на собственном опыте увидите, как сырые данные становятся более «дружелюбными» для моделей машинного обучения благодаря пошаговому конструированию признаков.
Итог
Конструирование признаков — это ремесло в машинном обучении, которое сочетаетискусство(знания предметной области, опыт, интуицию) инауку(статистические методы, алгоритмы). У него нет фиксированных правил; оно требует повторных проб и итераций с учётом конкретных данных, задачи и модели. Новичкам освоение базовых методов, представленных в этой статье, и усердная практика заложат прочнейшую основу для создания эффективных моделей машинного обучения. Запомните,отличные модели часто получаются из отличных признаков。
Другие расширения