アンサンブル学習
機械学習の分野では、アンサンブル学習(Ensemble Learning)は、複数のモデルの予測結果を組み合わせることで全体の性能を向上させる技術です。
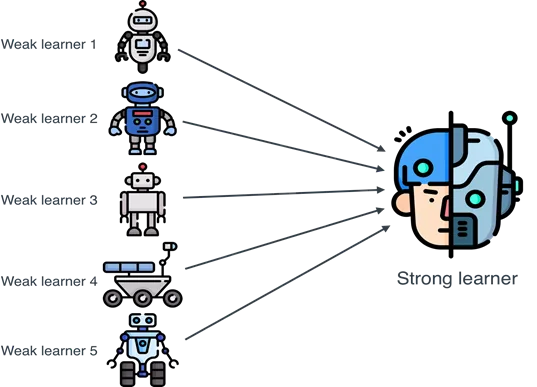
アンサンブル学習の核となる考え方は「三人寄れば文殊の知恵」であり、複数の弱学習器を組み合わせることで、強い学習器を構築できるというものです。
アンサンブル学習の主な目的は、複数のモデルを組み合わせることで予測の正確性とロバスト性を向上させることです。
一般的なアンサンブル学習の方法には、以下のものがあります。
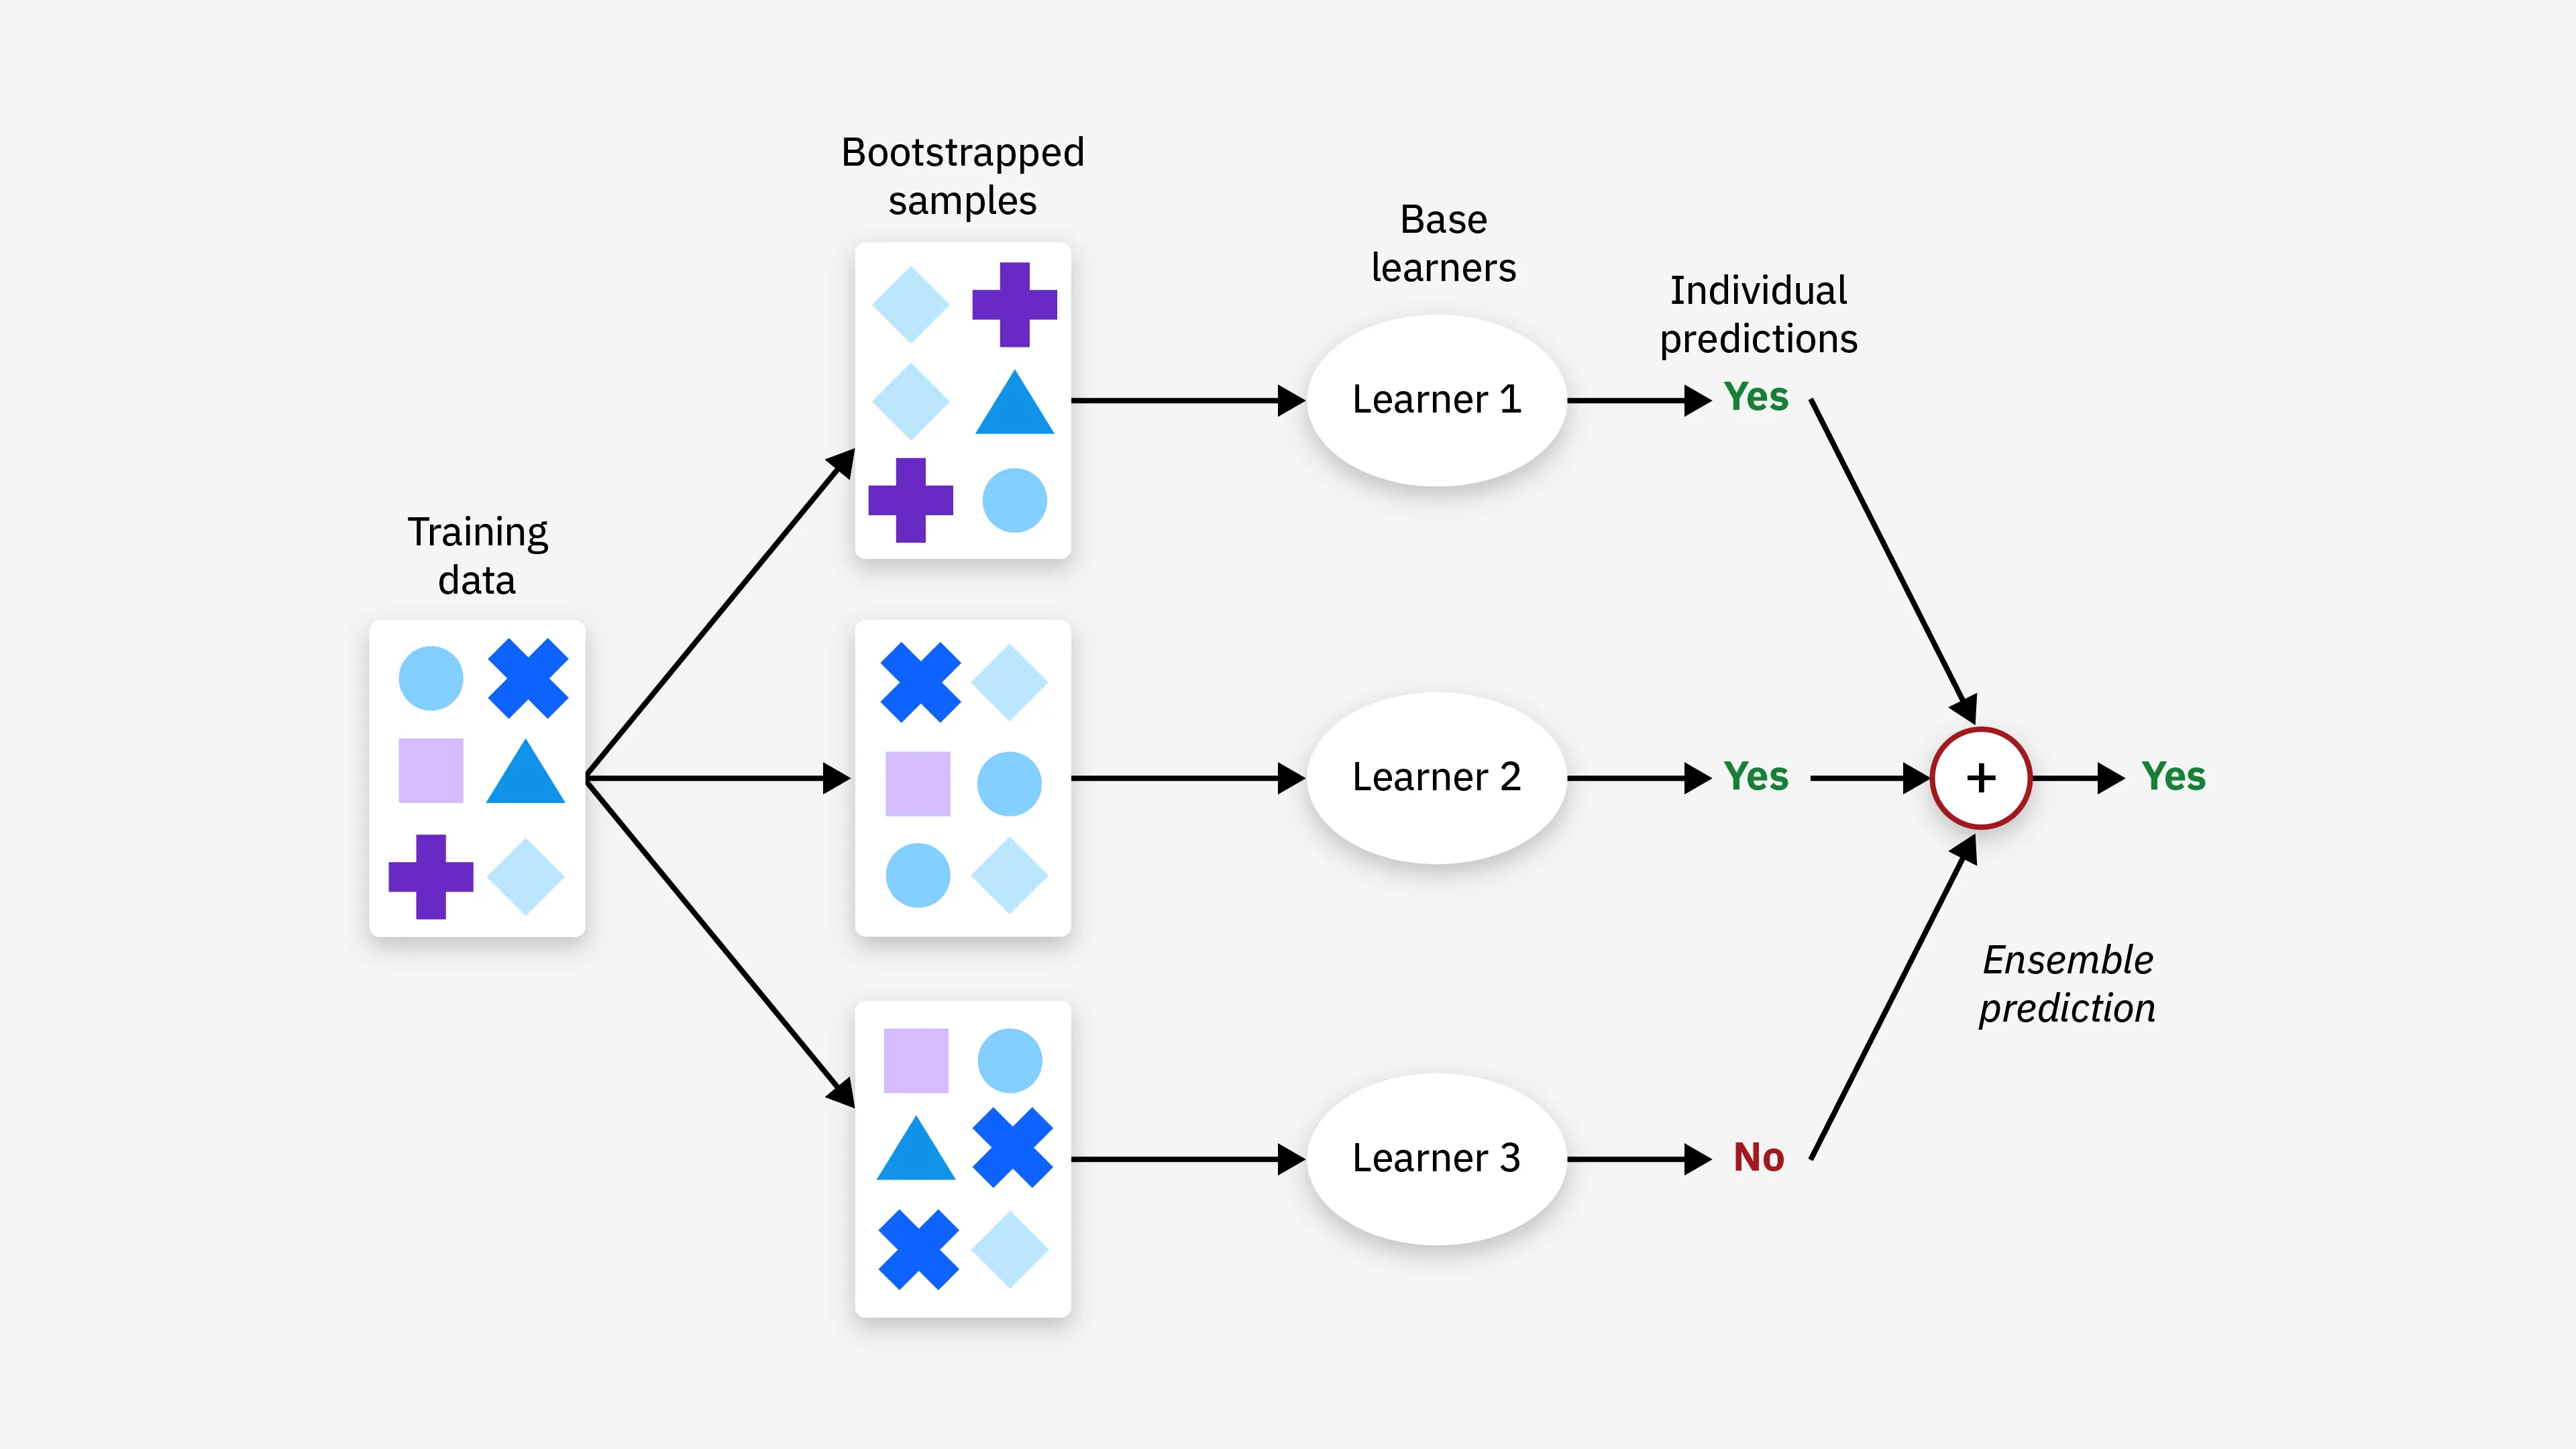
- Bagging:ブートストラップサンプリング(Bootstrap Sampling)によって複数のトレーニングセットを生成し、それぞれ複数のモデルを訓練して、最後に投票または平均によって最終結果を得る方法です。
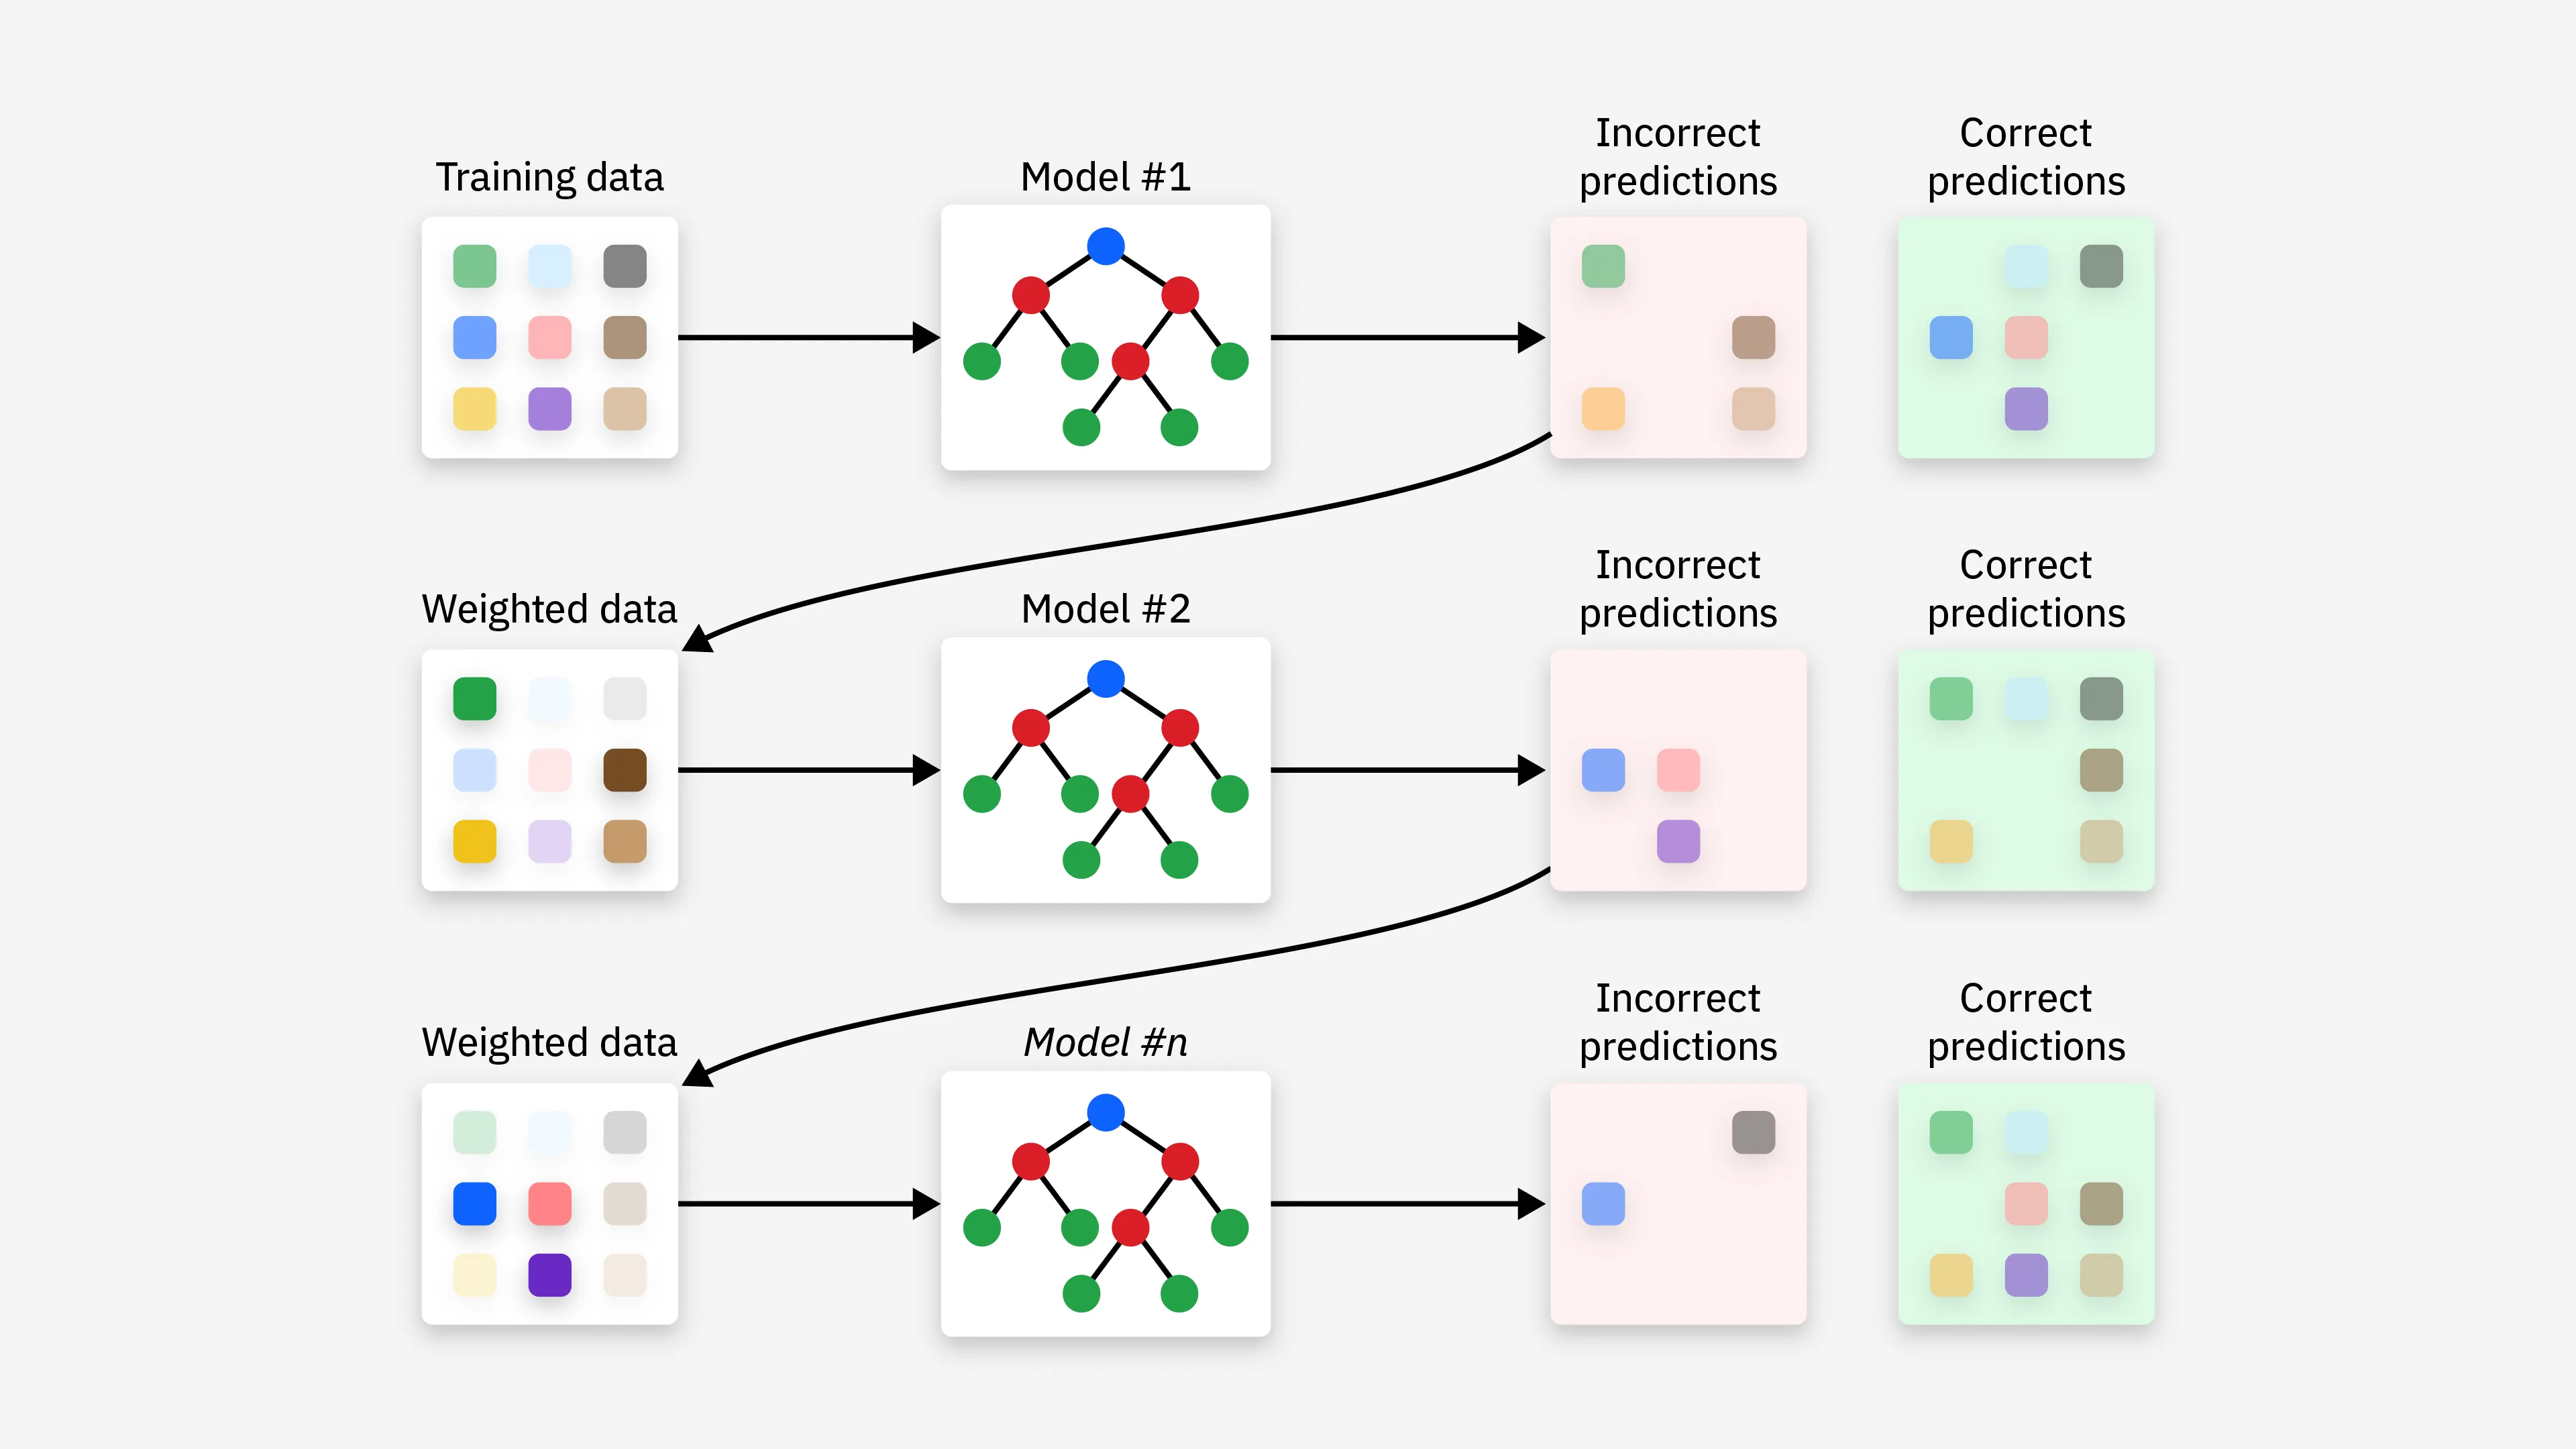
- Boosting:反復的に複数のモデルを訓練し、各モデルが前のモデルの誤りを修正しようとし、最終的に加重投票によって結果を得る方法です。
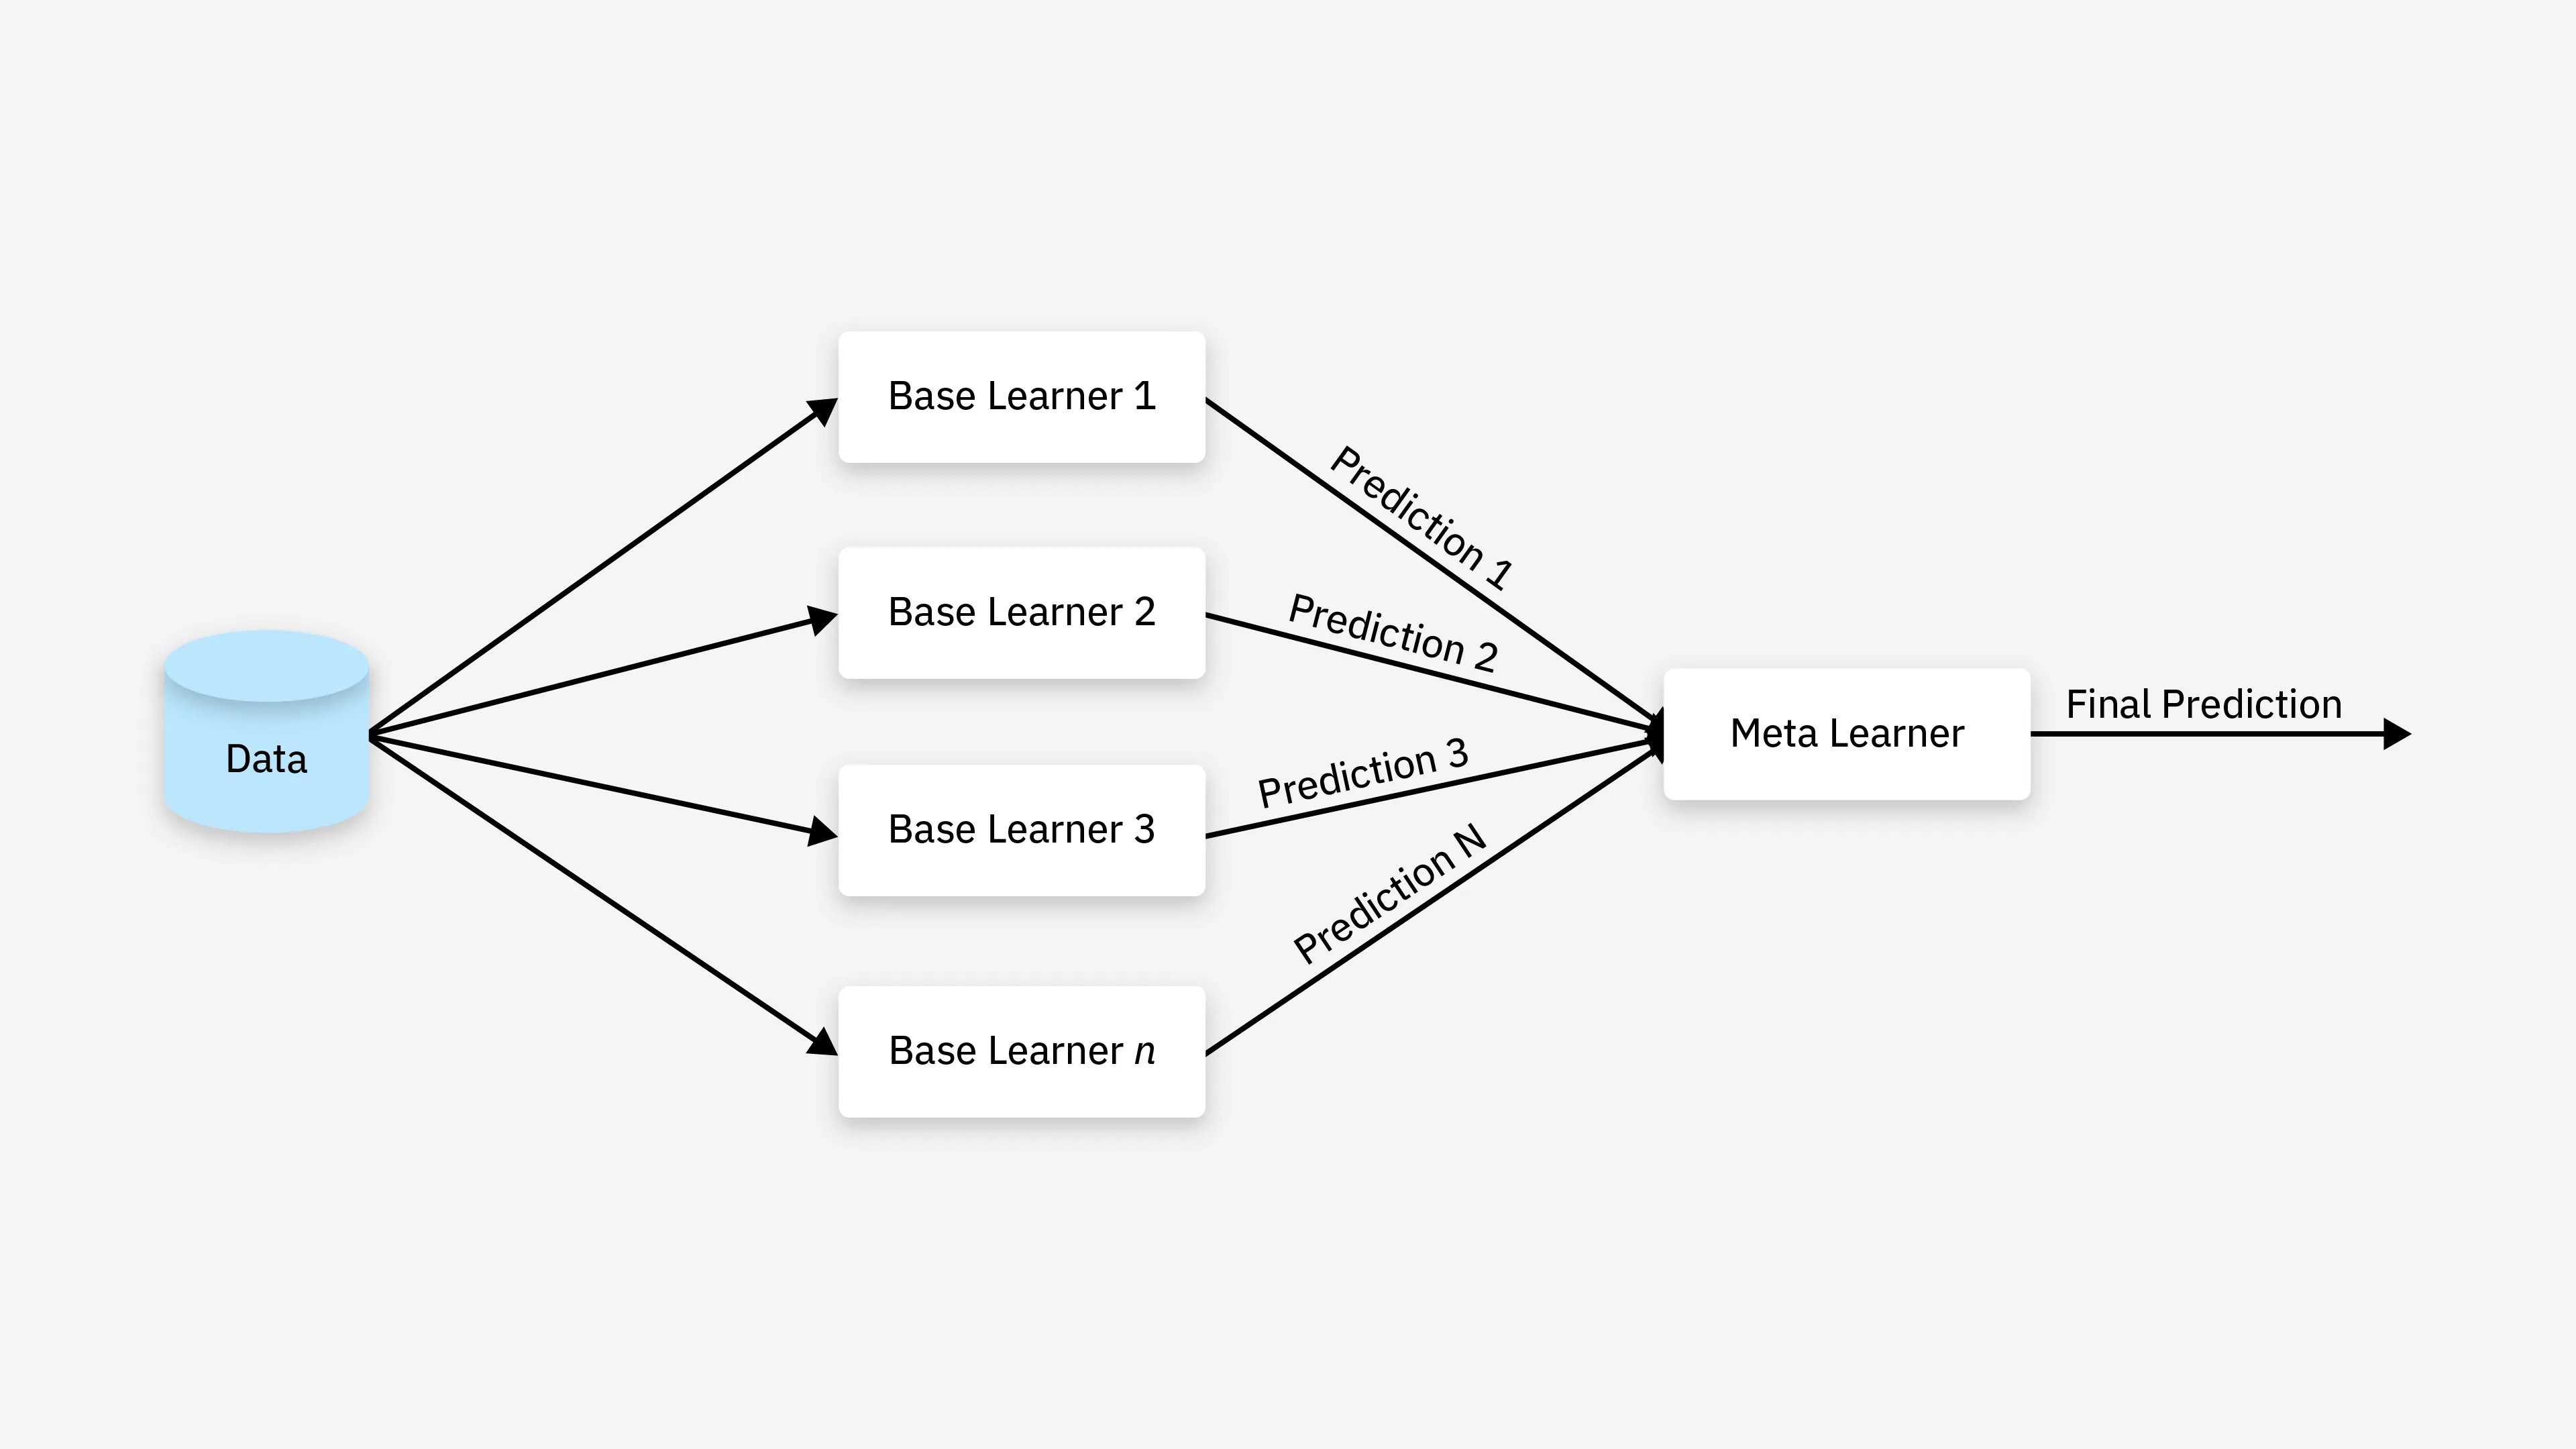
- Stacking:複数の異なるモデルを訓練し、それらのモデルの出力を新しい特徴として使用し、さらにメタモデル(Meta-Model)を訓練して最終的な予測を行う方法です。
1. Bagging(Bootstrap Aggregating)
Baggingの目標は、モデルの分散を減らすことで性能を向上させることであり、高分散で過学習しやすいモデルに適しています。これは以下の手順で実現されます。
- データセットのリサンプリング:トレーニングデータセットに対して復元抽出(ブートストラップ)によるランダムサンプリングを複数回行い、各サンプリングでサブデータセットを取得します。
- 複数のモデルの訓練:各サブデータセットでベース学習器(通常は同じタイプのモデル)を訓練します。
- 結果の統合:複数のベース学習器の結果を統合します。通常は投票(分類問題)または平均(回帰問題)によって行います。
代表的なアルゴリズム:
- ランダムフォレスト(Random Forest):ランダムフォレストはBaggingの古典的な実装であり、複数の決定木を構築し、各木は訓練時にランダムに特徴を選択することで過学習のリスクを減らします。
利点:
- 分散を効果的に減らし、モデルの安定性を高めることができます。
- 決定木など、高分散のモデルに適しています。
欠点:
- 複数のモデルを訓練する必要があるため、トレーニングに時間がかかります。
- 単一のモデルではないため、結果を解釈するのが難しいです。
2. Boosting
Boostingの目標は、モデルのバイアスを減らすことで性能を向上させることであり、弱学習器に適しています。Boostingの核となる考え方は、各モデルの重みを段階的に調整し、前のラウンドのモデルが誤分類したサンプルを強調することです。Boostingは以下の手順で実現されます。
- シーケンシャルトレーニング(逐次訓練):モデルは1つずつ訓練され、各ラウンドの訓練は前のラウンドの誤りに基づいて調整されます。
- 加重投票:最終的な予測は、すべての弱学習器の予測の加重和であり、誤分類されたサンプルにはより高い重みが与えられます。
- モデルの統合:各モデルの重みは、トレーニング過程でのパフォーマンスに基づいて決定されます。
代表的なアルゴリズム:
- AdaBoost(Adaptive Boosting):AdaBoostはサンプルの重みを変更することで、後続の各分類器が前のラウンドで誤分類されたサンプルにより注目するようにします。
- 勾配ブースティング木(Gradient Boosting Trees, GBT):GBTは目的関数を反復的に最適化し、バイアスを段階的に減らします。
- XGBoost(Extreme Gradient Boosting):XGBoostは効率的な勾配ブースティングアルゴリズムであり、データサイエンスコンペティションで広く使用され、優れた性能と最適化を備えています。
- LightGBM(Light Gradient Boosting Machine):LightGBMは勾配ブースティング木に基づくフレームワークであり、XGBoostと比較して、より高速なトレーニング速度とより低いメモリ使用量を実現します。
利点:
- バイアスの大きいモデルに適しており、予測精度を効果的に向上させることができます。
- 強力な性能を持ち、多くの実用的なアプリケーションで優れた結果を示します。
欠点:
- ノイズデータに敏感で、過学習を引き起こしやすいです。
- トレーニングプロセスが比較的遅く、特にデータ量が多い場合に顕著です。
3. Stacking(Stacked Generalization)
Stackingは、異なる種類のモデルを訓練し、それらの予測を組み合わせることで全体の予測精度を向上させる方法です。その核となる考え方は次のとおりです。
- 第1層(ベース学習器):複数の異なるタイプのベース学習器(例:決定木、SVM、KNNなど)を訓練してデータを予測します。
- 第2層(メタ学習器):第1層の学習器の予測結果を入力として、メタ学習器(通常はロジスティック回帰、線形回帰など)を訓練し、最終的な予測を行います。
利点:
- 異なるタイプのベース学習器を使用して、データ内の異なるパターンを捉えることができます。
- 理論的には複数のモデルの利点を組み合わせて、より強力な予測能力を達成できます。
欠点:
- トレーニングプロセスが複雑で、複数のモデルを訓練する必要があり、モデル間の組み合わせ方も慎重に設計する必要があります。
- BaggingやBoostingなどの他のアンサンブル手法よりも複雑で、過学習しやすいです。
実例デモ
実例
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# データセットを読み込む
iris = load_iris()
X, y = iris.data, iris.target
# トレーニングセットとテストセットに分割する
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# ランダムフォレスト分類器を作成する
rf = RandomForestClassifier(n_estimators=100, random_state=42)
# モデルを訓練する
rf.fit(X_train, y_train)
# 予測する
y_pred = rf.predict(X_test)
# 精度を計算する
accuracy = accuracy_score(y_test, y_pred)
print(f"ランダムフォレストの精度: {accuracy:.2f}")
出力結果は次のとおりです:
随机森林的准确率: 1.00
コードの説明:
- データセットの読み込み:私たちが使用する
load_iris()関数は古典的なアヤメデータセットを読み込みます。 - トレーニングセットとテストセットの分割:使用する
train_test_split()関数はデータセットをトレーニングセットとテストセットに分割します。 - ランダムフォレスト分類器の作成:使用する
RandomForestClassifierクラスはランダムフォレスト分類器を作成し、n_estimators=100100本の決定木を使用することを示します。 - モデルの訓練:使用する
fit()メソッドはモデルを訓練します。 - 予測:使用する
predict()メソッドはテストセットに対して予測を行います。 - 精度の計算:使用する
accuracy_score()関数はモデルの精度を計算します。
Boosting:AdaBoost
アルゴリズムの原理:Boostingの核となる考え方は、反復的に複数のモデルを訓練し、各モデルが前のモデルの誤りを修正しようとするものです。AdaBoost(Adaptive Boosting)は、Boostingアルゴリズムの中で最も古典的なものの1つです。
実例
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.tree import DecisionTreeClassifier
# データセットを読み込む
iris = load_iris()
X, y = iris.data, iris.target
# トレーニングセットとテストセットに分割する
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# デフォルトの弱学習器(決定木)を使用し、SAMMEアルゴリズムを使用するように指定します
ada = AdaBoostClassifier(DecisionTreeClassifier(max_depth=1),
n_estimators=50,
random_state=42,
algorithm='SAMME')
# モデルを訓練する
ada.fit(X_train, y_train)
# 予測する
y_pred = ada.predict(X_test)
# 精度を計算する
accuracy = accuracy_score(y_test, y_pred)
print(f"AdaBoostの精度: {accuracy:.2f}")
出力結果は次のとおりです:
AdaBoost的准确率: 1.00
コードの説明:
- データセットの読み込み:使用する
load_iris()関数はアヤメデータセットを読み込み、特徴データXとラベルデータを含みます。y。 - トレーニングセットとテストセットの分割:使用する
train_test_split()関数はデータセットをトレーニングセットとテストセットに分割し、テストセットが30%、トレーニングセットが70%です。 - 決定木分類器の作成:使用して
DecisionTreeClassifier(max_depth=1)深さ1の決定木分類器を作成し、AdaBoostのベース学習器とします。 - AdaBoost分類器の作成:使用する
AdaBoostClassifier()クラスはAdaBoost分類器を作成し、n_estimators=5050個の弱学習器を使用することを示し、algorithm='SAMME'SAMMEアルゴリズムを使用することを指定します。 - モデルの訓練:使用する
fit()メソッドはトレーニングデータ上でAdaBoostモデルを訓練します。 - 予測:使用する
predict()メソッドはテストセットに対して予測を行い、予測ラベルを生成します。y_pred。 - 精度の計算:使用する
accuracy_score()関数はモデルの予測精度を計算して出力します。
Stacking:モデルスタッキング
アルゴリズムの原理:Stackingの核となる考え方は、複数の異なるモデルを訓練し、それらのモデルの出力を新しい特徴として使用し、さらにメタモデル(Meta-Model)を訓練して最終的な予測を行うことです。
実例
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.svm import SVC
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# データセットを読み込む
iris = load_iris()
X, y = iris.data, iris.target
# トレーニングセットとテストセットに分割する
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# ベース学習器を定義する
estimators = [
('dt', DecisionTreeClassifier(max_depth=1)),
('svc', SVC(kernel='linear', probability=True))
]
# Stacking分類器を作成する
stacking = StackingClassifier(estimators=estimators, final_estimator=LogisticRegression())
# モデルを訓練する
stacking.fit(X_train, y_train)
# 予測する
y_pred = stacking.predict(X_test)
# 精度を計算する
accuracy = accuracy_score(y_test, y_pred)
print(f"Stackingの精度: {accuracy:.2f}")
出力結果は次のとおりです:
tacking的准确率: 1.00
コードの説明:
- データセットの読み込み:同様に使用する
load_iris()関数はアヤメのデータセットを読み込む。 - トレーニングセットとテストセットに分割する。:使用
train_test_split()関数はデータセットをトレーニングセットとテストセットに分割する。 - ベース学習器を定義する。:使用
DecisionTreeClassifierとSVCベース学習器として。 - Stacking分類器を作成する。:使用
StackingClassifierクラスでStacking分類器を作成し、final_estimator=LogisticRegression()ロジスティック回帰をメタモデルとして使用することを示す。 - モデルを訓練する。:使用
fit()メソッドでモデルを訓練する。 - 予測する。:使用
predict()メソッドでテストセットに対して予測を行う。 - 正解率を計算する。:使用
accuracy_score()関数でモデルの正解率を計算する。