Ансамблевое обучение
В области машинного обучения ансамблевое обучение — это техника, которая повышает общую производительность путём объединения результатов прогнозирования нескольких моделей.
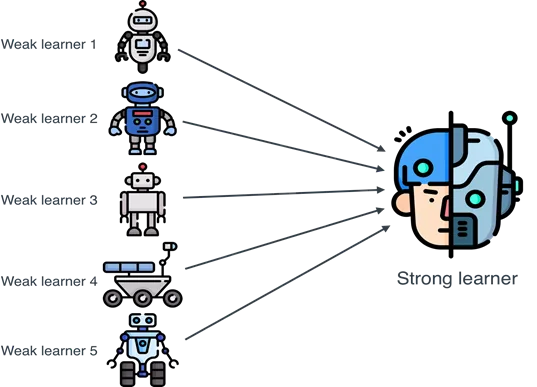
Основная идея ансамблевого обучения — «три сапожника, объединив свои умы, равны Чжугэ Ляну», то есть объединение нескольких слабых моделей обучения позволяет построить сильную модель обучения.
Основная цель ансамблевого обучения — повысить точность прогнозирования и устойчивость путём объединения нескольких моделей.
Распространённые методы ансамблевого обучения включают:
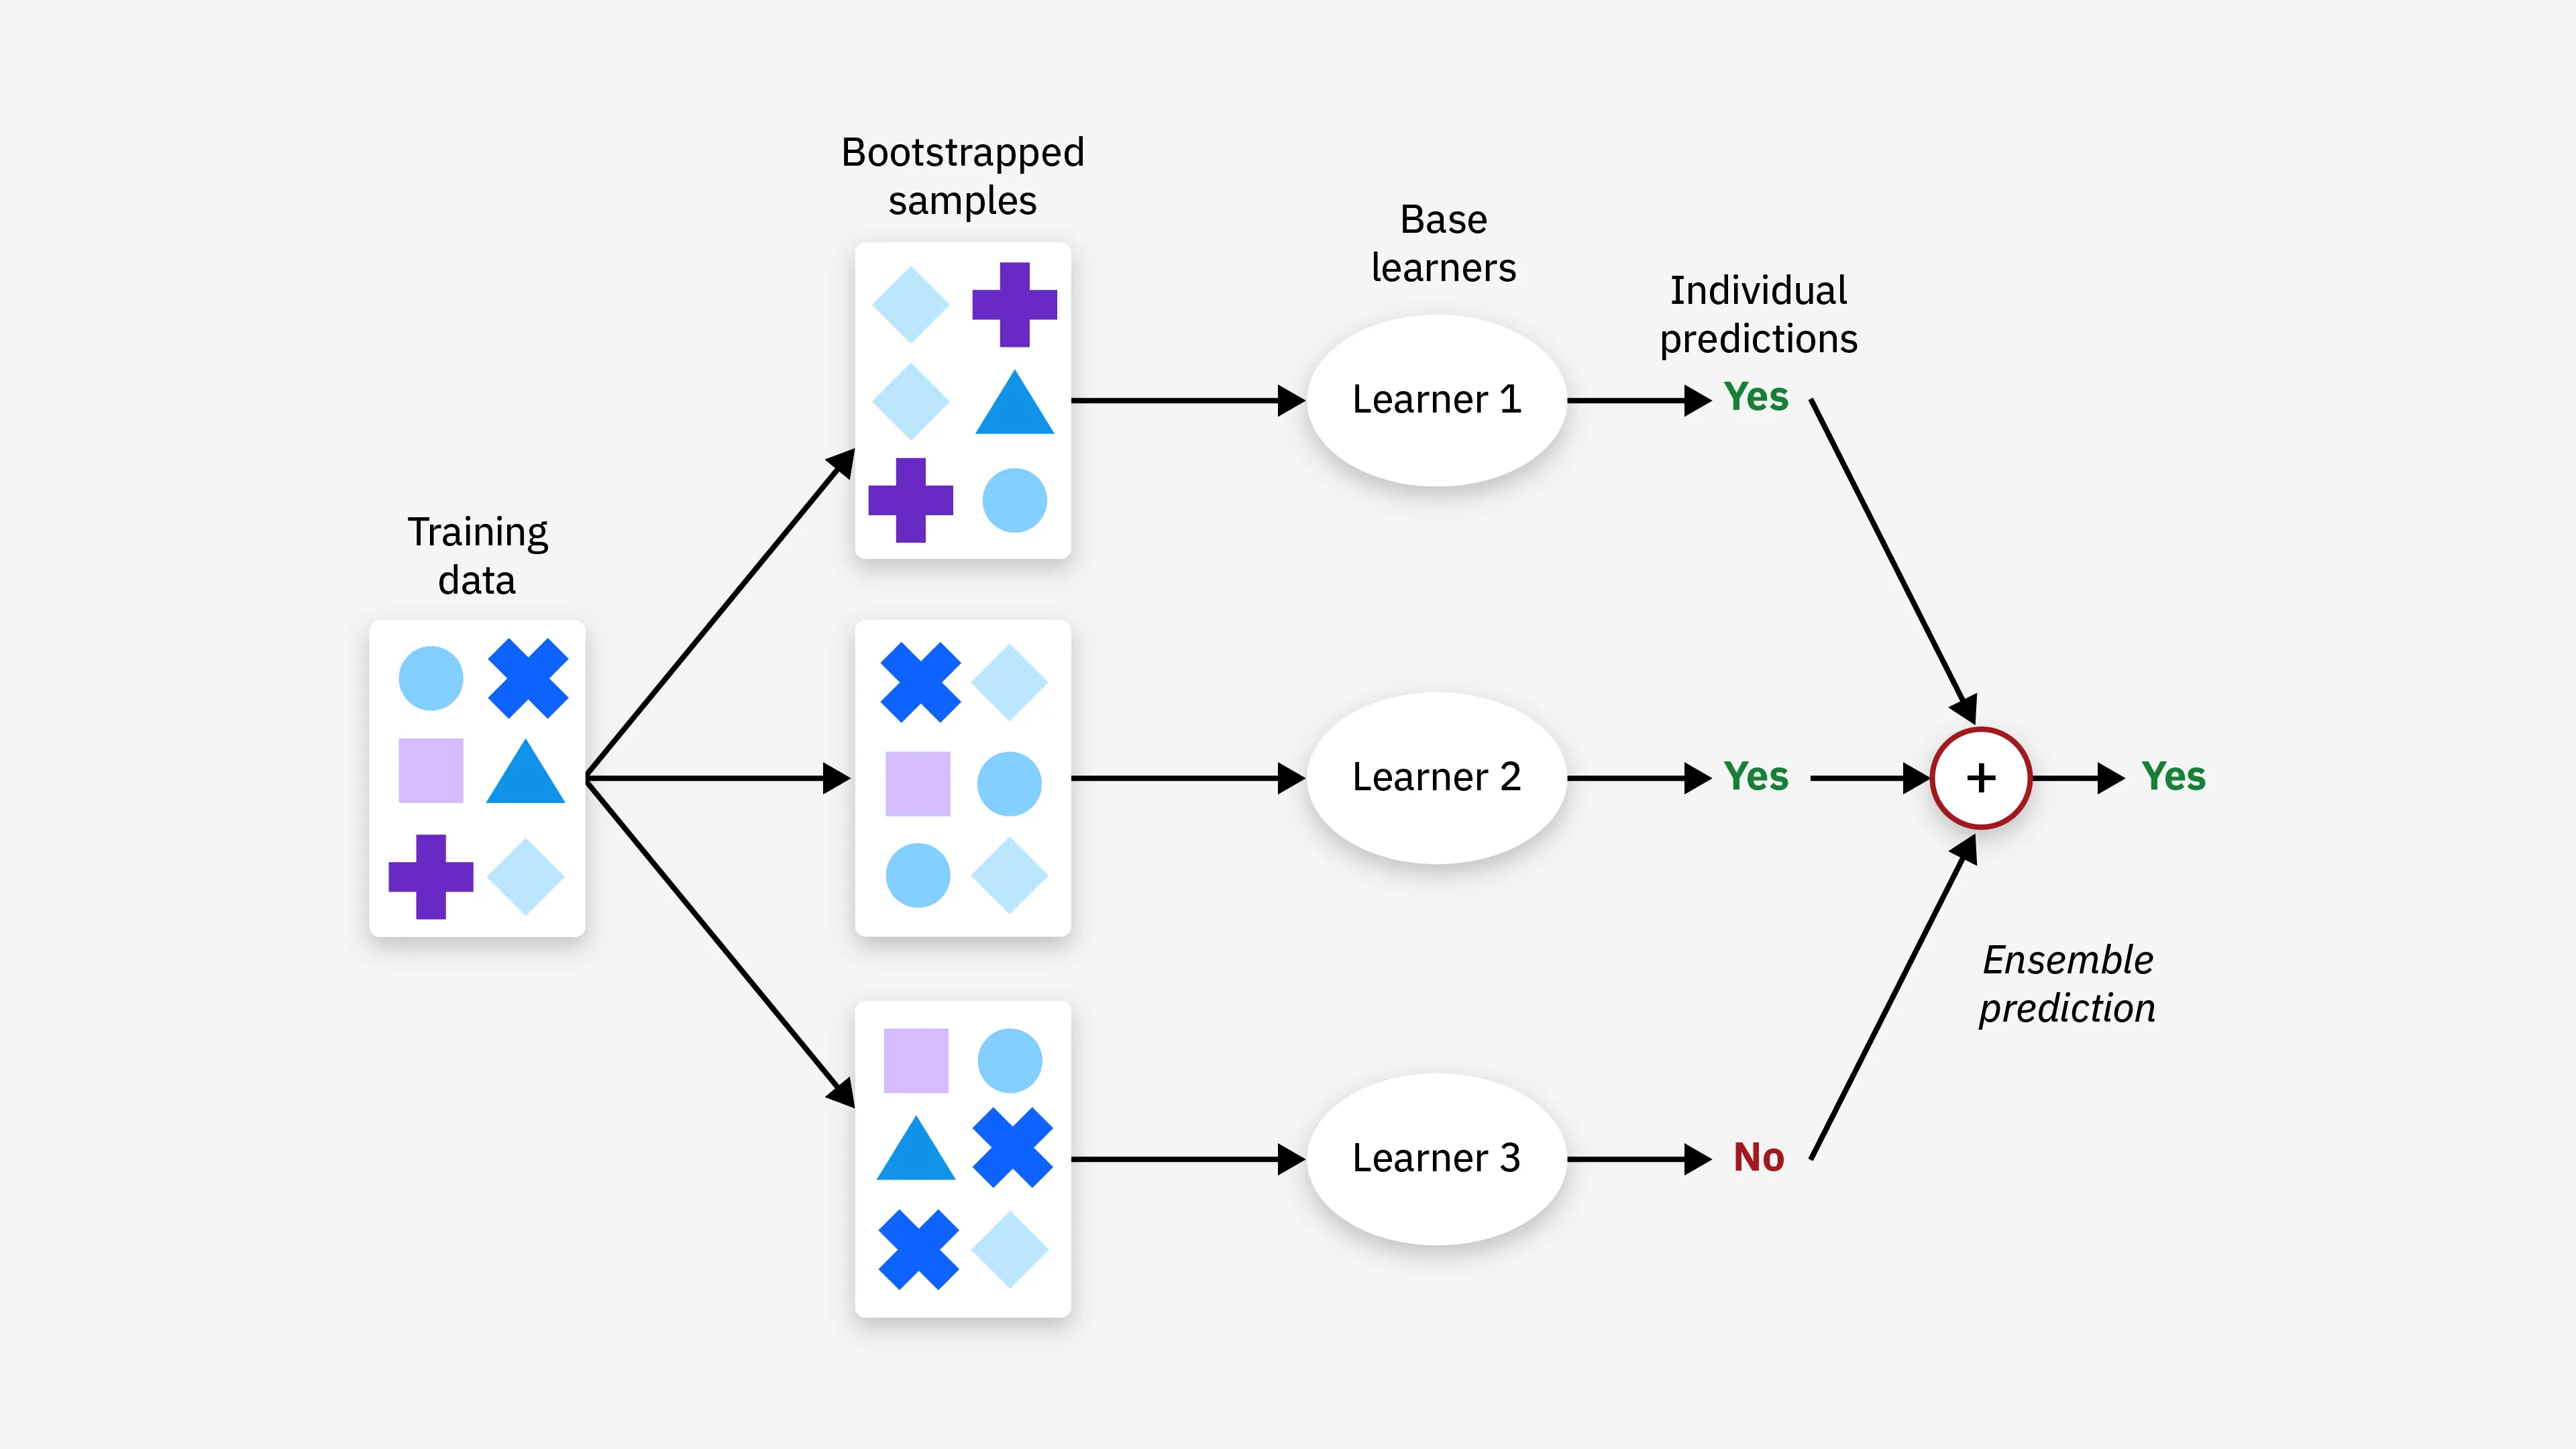
- Бэггинг: сгенерировать несколько обучающих наборов с помощью бутстрэп-выборки, затем обучить несколько моделей по отдельности и, наконец, получить итоговый результат путём голосования или усреднения.
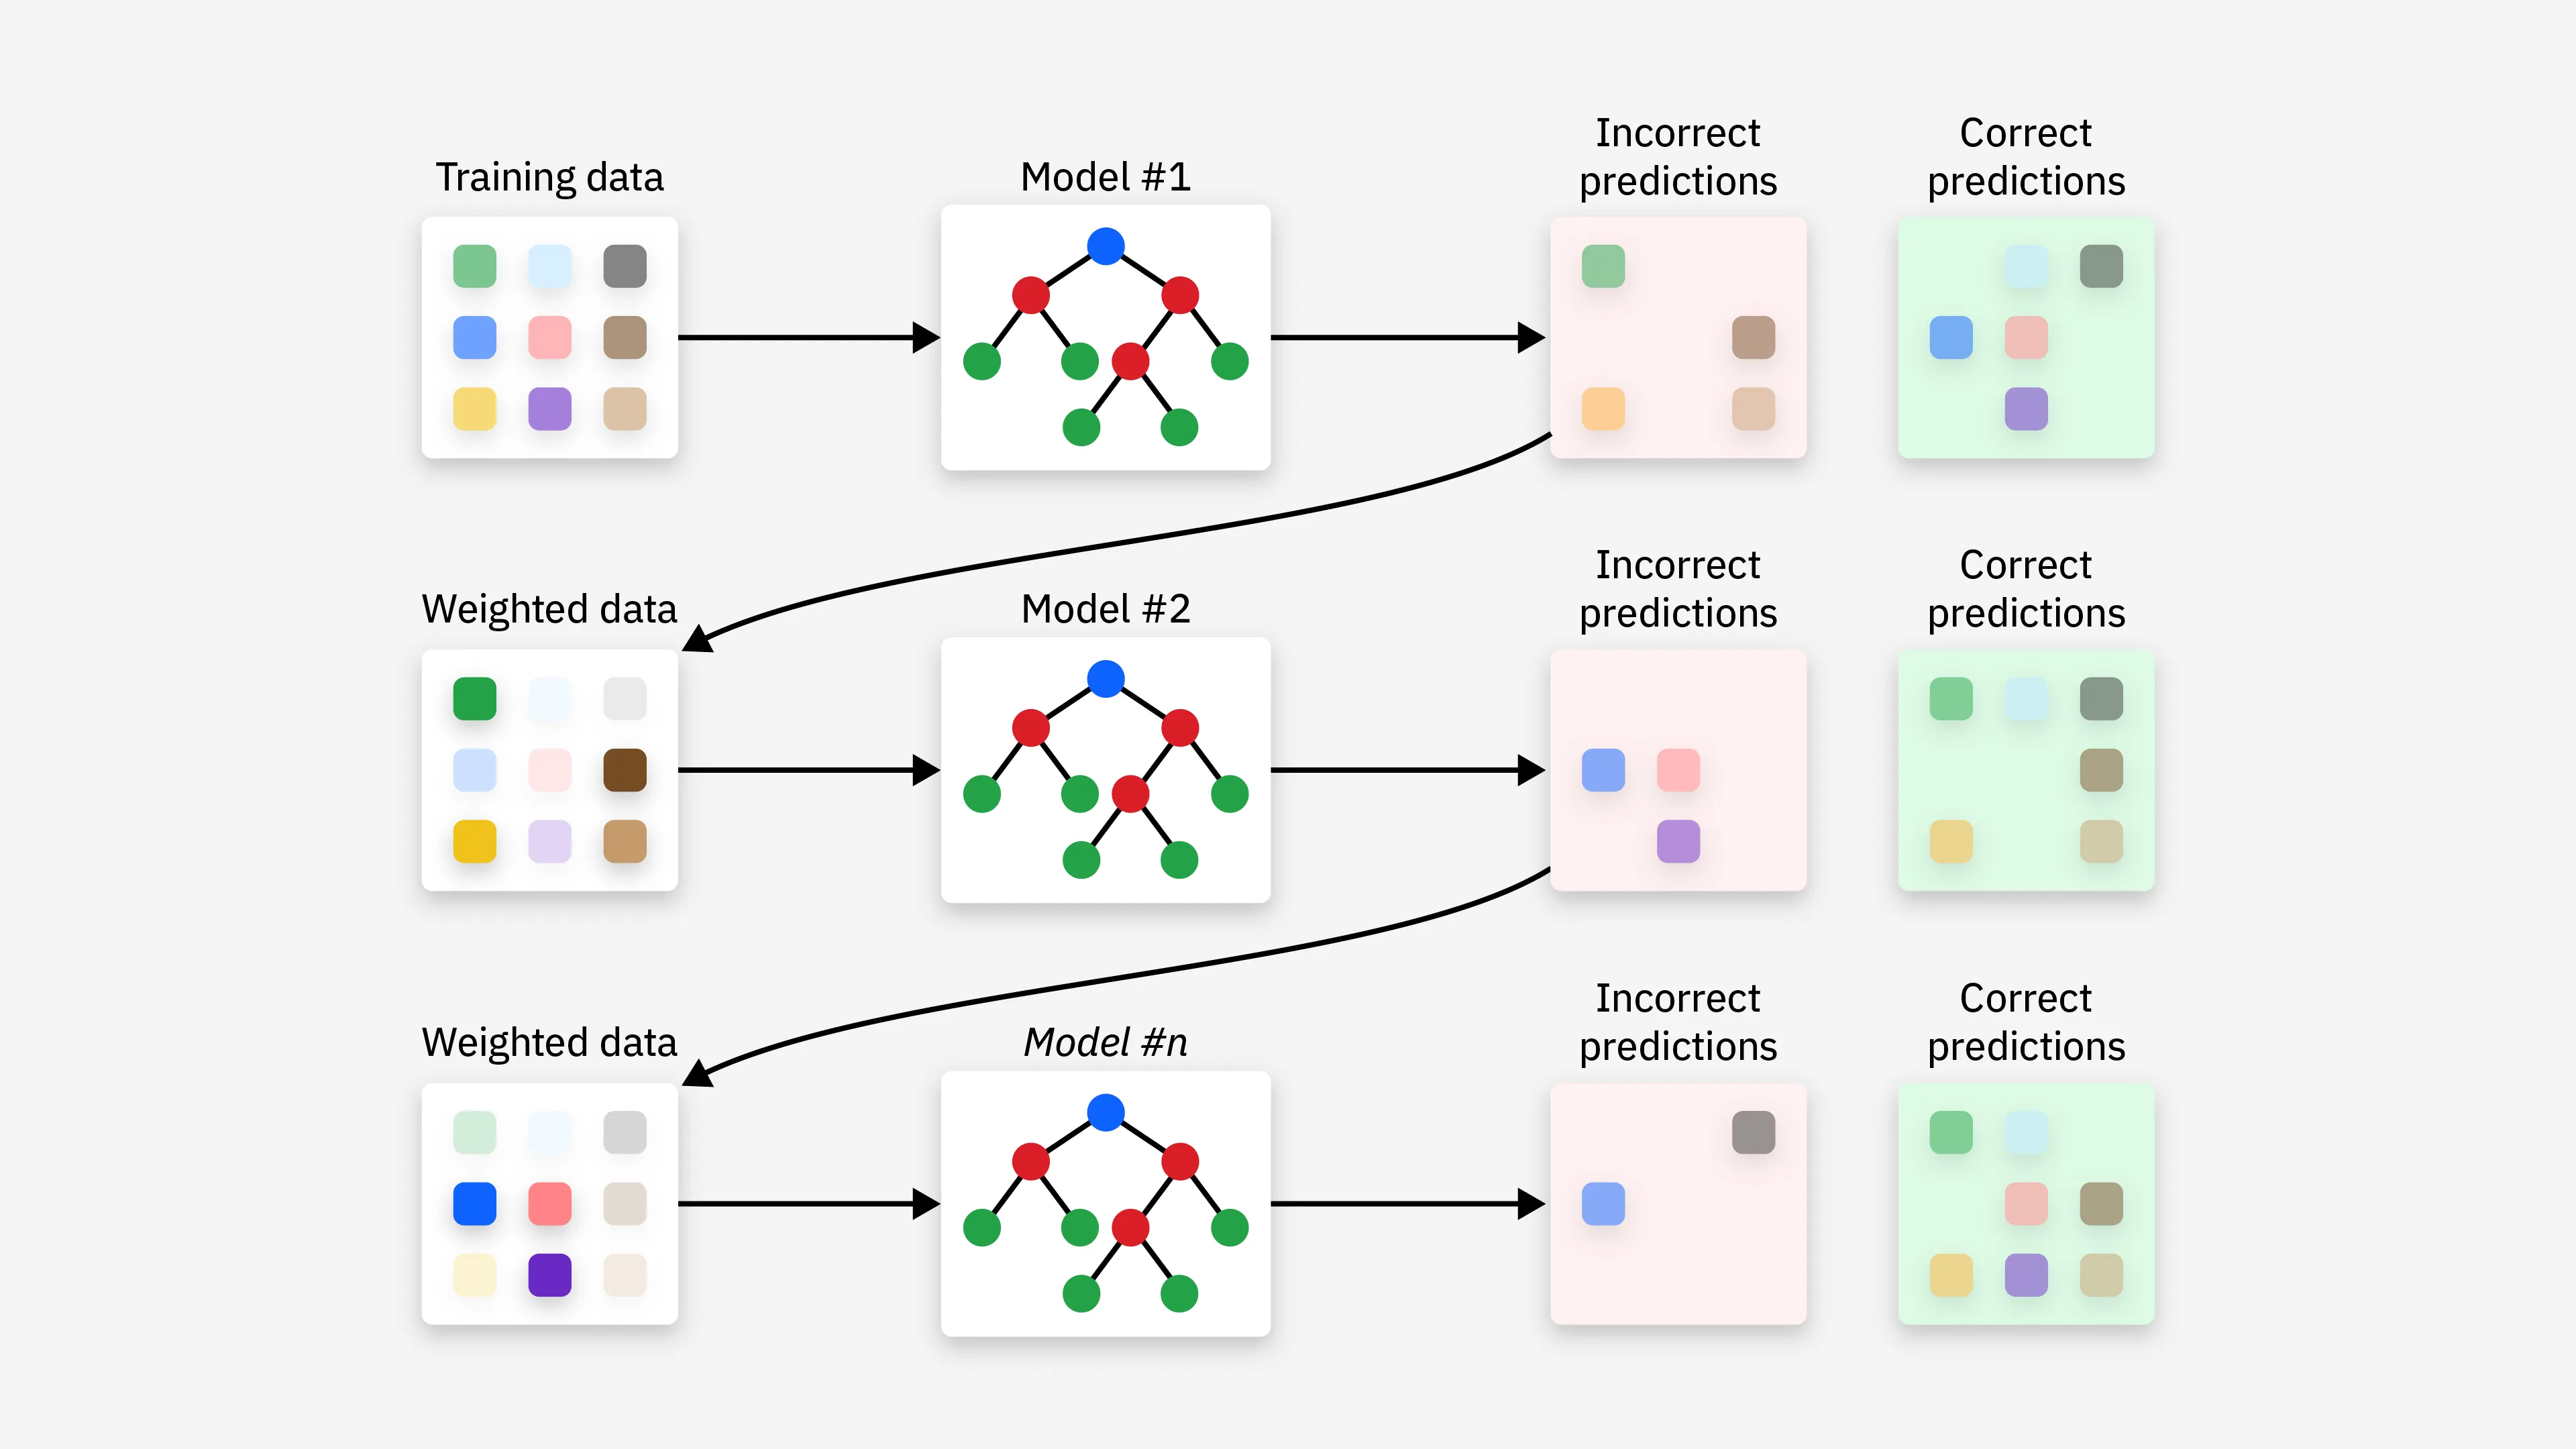
- Бустинг: итеративно обучить несколько моделей; каждая модель пытается исправить ошибки предыдущей модели, и в итоге результат получается путём взвешенного голосования.
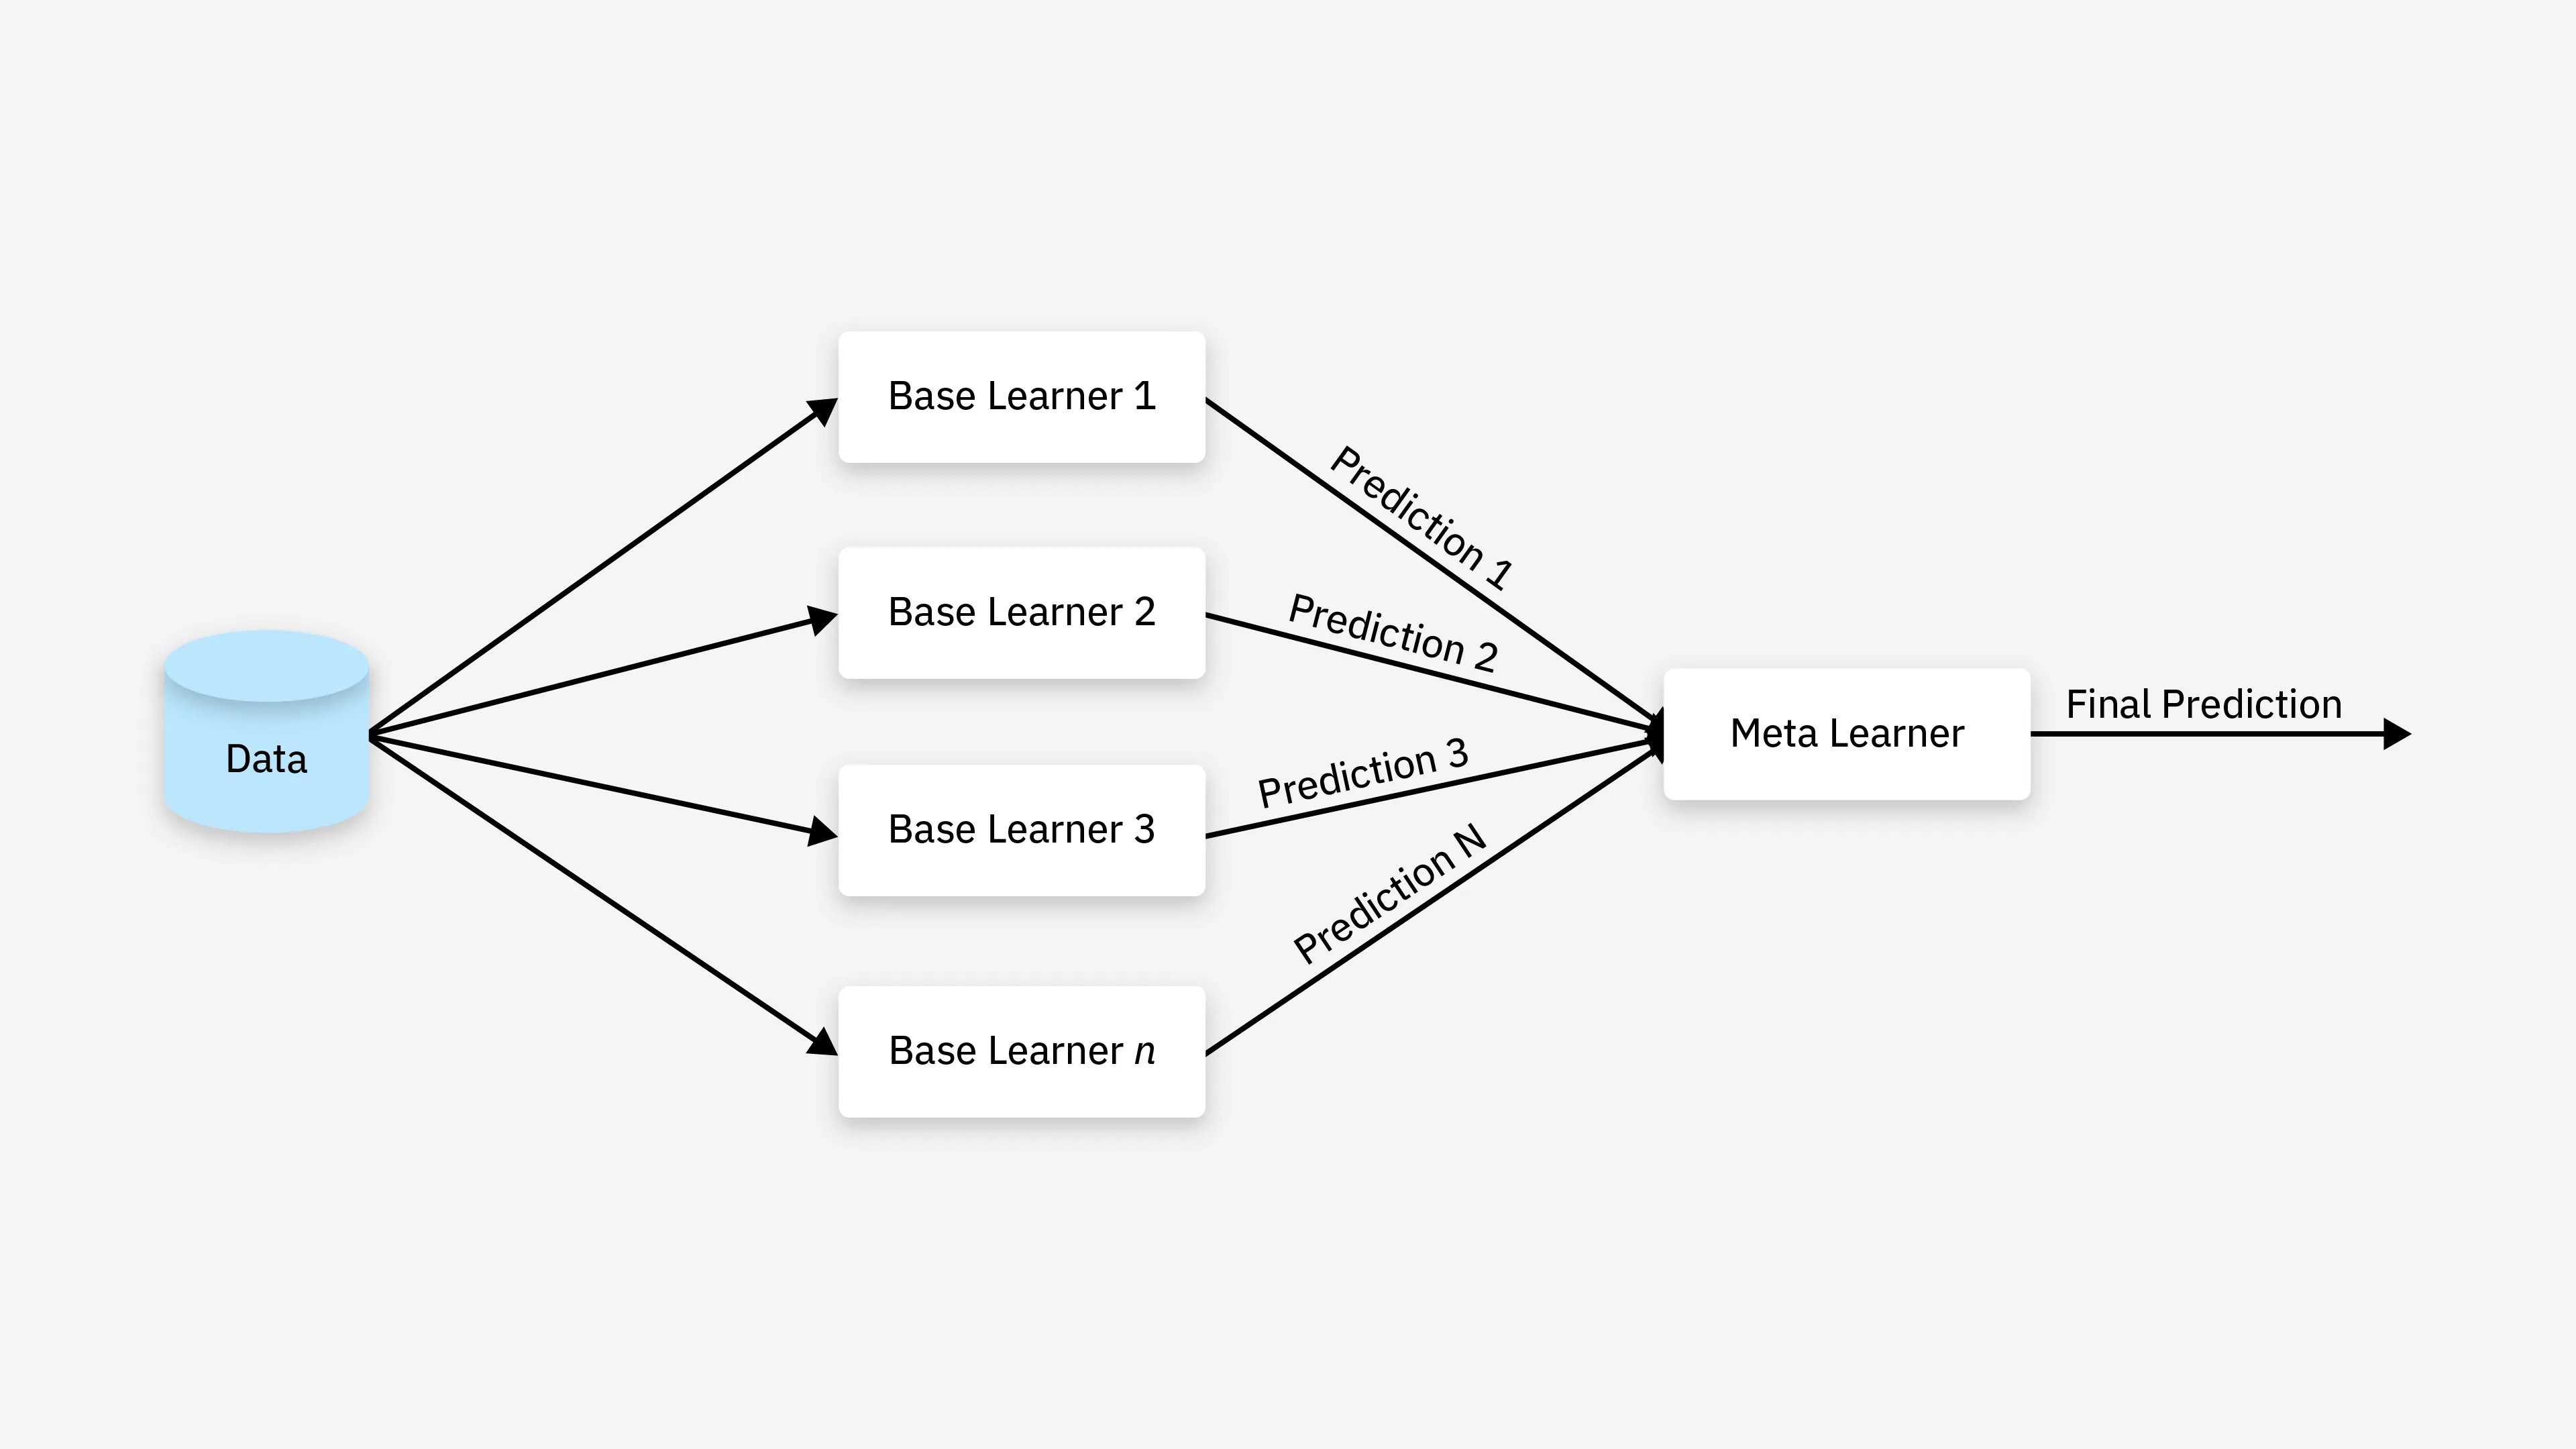
- Стекинг: обучить несколько разных моделей, затем использовать выходы этих моделей в качестве новых признаков и обучить метамодель для итогового предсказания.
1. Бэггинг(бутстрэп-агрегирование)
Цель бэггинга — улучшить эффективность за счёт уменьшения дисперсии модели; он подходит для моделей с высокой дисперсией и склонностью к переобучению. Он реализуется с помощью следующих шагов:
- Пересэмплирование набора данных: выполнить несколько случайных выборок с возвращением (бутстрэп) из обучающего набора данных, причём каждая выборка даёт подмножество.
- Обучение нескольких моделей: обучить базовый алгоритм (обычно модель того же типа) на каждом подмножестве.
- Объединение результатов: объединить результаты нескольких базовых алгоритмов, обычно с помощью голосования (для задач классификации) или усреднения (для задач регрессии).
Типичные алгоритмы:
- Случайный лес: случайный лес — это классическая реализация бэггинга. Он снижает риск переобучения за счёт построения множества решающих деревьев, при этом каждое дерево случайным образом выбирает признаки во время обучения.
Преимущества:
- Он может эффективно уменьшать дисперсию и повышать стабильность модели.
- Подходит для моделей с высокой дисперсией, таких как решающие деревья.
Недостатки:
- Процесс обучения занимает много времени, потому что нужно обучить несколько моделей.
- Результаты трудно интерпретировать, поскольку нет единой модели.
2. Бустинг
Цель бустинга — повысить эффективность за счёт уменьшения смещения модели, и он подходит для слабых моделей. Основная идея бустинга — постепенно корректировать вес каждой модели, уделяя особое внимание тем примерам, которые были неправильно классифицированы предыдущим раундом моделей. Бустинг реализуется с помощью следующих шагов:
- Последовательное обучение: Модели обучаются одна за другой, и каждый раунд обучения корректируется в соответствии с ошибками предыдущего раунда.
- Взвешенное голосование: Итоговый прогноз представляет собой взвешенную сумму прогнозов всех слабых моделей, при этом неправильно классифицированным примерам присваиваются более высокие веса.
- Объединение моделей: Вес каждой модели определяется её эффективностью в процессе обучения.
Типичные алгоритмы:
- AdaBoost(Adaptive Boosting): AdaBoost изменяет веса примеров, заставляя каждый последующий классификатор уделять больше внимания примерам, неправильно классифицированным в предыдущем раунде.
- Градиентный бустинг деревьев (GBT): GBT итеративно оптимизирует целевую функцию, постепенно уменьшая смещение.
- XGBoost(Extreme Gradient Boosting): XGBoost — это эффективный алгоритм градиентного бустинга, широко используемый в соревнованиях по анализу данных, обладающий высокой эффективностью и оптимизацией.
- LightGBM(Light Gradient Boosting Machine): LightGBM — это фреймворк, основанный на деревьях градиентного бустинга. По сравнению с XGBoost он имеет более высокую скорость обучения и меньшее потребление памяти.
Преимущества:
- Подходит для моделей с большим смещением и может эффективно повысить точность прогнозирования.
- Высокая эффективность, и он отлично работает во многих реальных приложениях.
Недостатки:
- Он чувствителен к зашумлённым данным и может легко привести к переобучению.
- Процесс обучения медленный, особенно при больших наборах данных.
3. Стекинг (Stacked Generalization)
Стекинг — это метод, который повышает общую точность прогнозирования за счёт обучения моделей разных типов и объединения их прогнозов. Его основная идея заключается в следующем:
- Первый уровень (базовые модели): Обучите несколько базовых моделей разных типов (например, деревья решений, SVM, KNN и т. д.) для прогнозирования данных.
- Второй уровень (мета-модель): Используйте результаты прогнозирования моделей первого уровня в качестве входных данных и обучите мета-модель (обычно логистическая регрессия, линейная регрессия и т. д.) для получения окончательного прогноза.
Преимущества:
- Разные типы базовых моделей можно использовать для выявления различных закономерностей в данных.
- Теоретически он может объединить преимущества нескольких моделей, чтобы достичь более сильной предсказательной способности.
Недостатки:
- Процесс обучения сложен: требуется обучение нескольких моделей, и способ объединения моделей также должен быть тщательно продуман.
- Он сложнее других ансамблевых методов, таких как Bagging и Boosting, и склонен к переобучению.
Демонстрация примера
Пример
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Загрузить набор данных
iris = load_iris()
X, y = iris.data, iris.target
# Разделите набор данных на обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Создайте классификатор случайного леса
rf = RandomForestClassifier(n_estimators=100, random_state=42)
# Обучаем модель
rf.fit(X_train, y_train)
# Прогнозирование
y_pred = rf.predict(X_test)
# Вычислите точность
accuracy = accuracy_score(y_test, y_pred)
print(f"Точность случайного леса: {accuracy:.2f}")
Результат вывода следующий:
随机森林的准确率: 1.00
Пояснение к коду:
- Загрузите набор данных: Мы используем
load_iris()функцию для загрузки классического набора данных Iris. - Разделите набор данных на обучающую и тестовую выборки: Используйте
train_test_split()функцию для разделения набора данных на обучающую и тестовую выборки. - Создайте классификатор случайного леса: Используйте
RandomForestClassifierкласс для создания классификатора случайного леса,n_estimators=100означает, что используются 100 деревьев решений. - Обучение модели: Используйте
fit()метод для обучения модели. - Предсказание: Используйте
predict()метод для выполнения предсказаний на тестовом наборе. - Вычисление точности: Используйте
accuracy_score()функцию для вычисления точности модели.
Бустинг:AdaBoost
Принцип алгоритма:Основная идея бустинга — итеративно обучать несколько моделей, при этом каждая модель пытается исправить ошибки предыдущей модели. AdaBoost (Adaptive Boosting) — один из самых классических алгоритмов бустинга.
Пример
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.tree import DecisionTreeClassifier
# Загрузить набор данных
iris = load_iris()
X, y = iris.data, iris.target
# Разделите набор данных на обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Использовать слабый обучающий алгоритм по умолчанию (дерево решений) и указать алгоритм SAMME
ada = AdaBoostClassifier(DecisionTreeClassifier(max_depth=1),
n_estimators=50,
random_state=42,
algorithm='SAMME')
# Обучаем модель
ada.fit(X_train, y_train)
# Прогнозирование
y_pred = ada.predict(X_test)
# Вычислите точность
accuracy = accuracy_score(y_test, y_pred)
print(f"Точность AdaBoost: {accuracy:.2f}")
Результат вывода следующий:
AdaBoost的准确率: 1.00
Пояснение к коду:
- Загрузите набор данных: Используйте
load_iris()функцию для загрузки набора данных Iris, содержащего данные признаковXи данные меток.y。 - Разделите набор данных на обучающую и тестовую выборки: Используйте
train_test_split()функцию для разделения набора данных на обучающую и тестовую выборки, при этом тестовая выборка составляет 30%, а обучающая — 70%. - Создайте классификатор дерева решений: Используйте
DecisionTreeClassifier(max_depth=1)для создания классификатора дерева решений с глубиной 1 в качестве базового алгоритма AdaBoost. - Создайте классификатор AdaBoost: Используйте
AdaBoostClassifier()класс для создания классификатора AdaBoost,n_estimators=50означает, что используются 50 слабых алгоритмов,algorithm='SAMME'и указан алгоритм SAMME. - Обучение модели: Используйте
fit()метод для обучения модели AdaBoost на обучающих данных. - Предсказание: Используйте
predict()метод для выполнения предсказаний на тестовом наборе, генерирующий предсказанные метки.y_pred。 - Вычисление точности: Используйте
accuracy_score()функция для вычисления и вывода точности предсказаний модели.
Стекинг: Стекинг моделей
Принцип алгоритма:Основная идея стекинга — обучить несколько различных моделей, затем использовать выходы этих моделей в качестве новых признаков и обучить мета-модель для выполнения окончательного предсказания.
Пример
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.svm import SVC
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Загрузить набор данных
iris = load_iris()
X, y = iris.data, iris.target
# Разделите набор данных на обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Определить базовые алгоритмы
estimators = [
('dt', DecisionTreeClassifier(max_depth=1)),
('svc', SVC(kernel='linear', probability=True))
]
# Создайте классификатор стекинга
stacking = StackingClassifier(estimators=estimators, final_estimator=LogisticRegression())
# Обучаем модель
stacking.fit(X_train, y_train)
# Прогнозирование
y_pred = stacking.predict(X_test)
# Вычислите точность
accuracy = accuracy_score(y_test, y_pred)
print(f"Точность стекинга: {accuracy:.2f}")
Результат вывода следующий:
tacking的准确率: 1.00
Пояснение к коду:
- Загрузите набор данных: Аналогично используйте
load_iris()Функция загружает набор данных Iris. - Разделите на обучающий и тестовый наборы: Используйте
train_test_split()Функция разделяет набор данных на обучающий и тестовый наборы. - Определите базовый алгоритм обучения: Используйте
DecisionTreeClassifierиSVCв качестве базового алгоритма обучения. - Создайте классификатор стекинга: Используйте
StackingClassifierкласс для создания классификатора Stacking,final_estimator=LogisticRegression()указывая, что логистическая регрессия используется в качестве метамодели. - Обучите модель: Используйте
fit()метод для обучения модели. - Выполните прогноз: Используйте
predict()метод для выполнения предсказаний на тестовом наборе. - Вычислите точность: Используйте
accuracy_score()функция для вычисления точности модели.