Машинное обучение — Пример обучения с подкреплением
Представьте, что вы учите щенка команде «сидеть». Вы не объясняете ему напрямую, что означает слово «сидеть», а направляете его с помощью наград и наказаний.
- Когда щенок случайно совершает действие сидения, вы сразу даете ему лакомство (награда)。
- Когда он поступает неправильно, вы не даёте ему лакомство (наказание)。
После многих попыток щенок в конце концов понимает связь между командой "sit" и получением лакомства и таким образом осваивает этот навык.
Обучение с подкреплениемЭто метод машинного обучения, который позволяет компьютеру (или агенту) научиться принимать оптимальные решения для получения максимального совокупного вознаграждения через взаимодействие с окружающей средой, подобное методу проб и ошибок.
Обучение с подкреплениемЕсть принципиальное отличие от обучения с учителем (со стандартными ответами) и обучения без учителя (поиск внутренней структуры в данных), которые мы изучали ранее. Ядро обучения с подкреплением — этоагентиокружающая среданепрерывное взаимодействие между [агентом и окружающей средой].
Анализ ключевых понятий
Прежде чем погружаться в код, давайте разберём несколько ключевых понятий. Они как правила игры, определяющие, как устроен мир обучения с подкреплением.
-
Агент:Агент — это наш ученик или лицо, принимающее решения. В приведённой выше аналогии это щенок. В программе это алгоритм, отвечающий за наблюдение за окружающей средой, выполнение действий и обучение на результатах.
-
Окружающая среда:Окружающая среда — это внешний мир, в котором существует агент. Она получает действия агента и даёт два сигнала обратной связи: новое состояние окружающей среды и немедленное вознаграждение, принесённое действием.
-
Состояние:Состояние — это описание конкретной ситуации окружающей среды в данный момент. Например, в игре-лабиринте состояние — это координаты текущего положения агента.
-
Действие:Действие — это выбор, который агент может сделать в определённом состоянии. Например, в лабиринте действиями могут быть вверх, вниз, влево или вправо.
-
Вознаграждение:Вознаграждение — это прямой оценочный сигнал от окружающей среды за действие агента, обычно числовое значение.Положительное вознаграждениеозначает поощрение,Отрицательное вознаграждениеозначает наказание. Конечная цель агента — максимизироватьобщая награда (суммарная награда)。
-
Политика:Политика — это кодекс поведения агента. Она определяет, какое действие следует выбирать в каждом возможном состоянии. Процесс обучения по сути представляет собой процесс оптимизации этой политики.
Чтобы более наглядно понять, как эти концепции работают вместе, давайте рассмотрим базовый цикл взаимодействия в обучении с подкреплением:
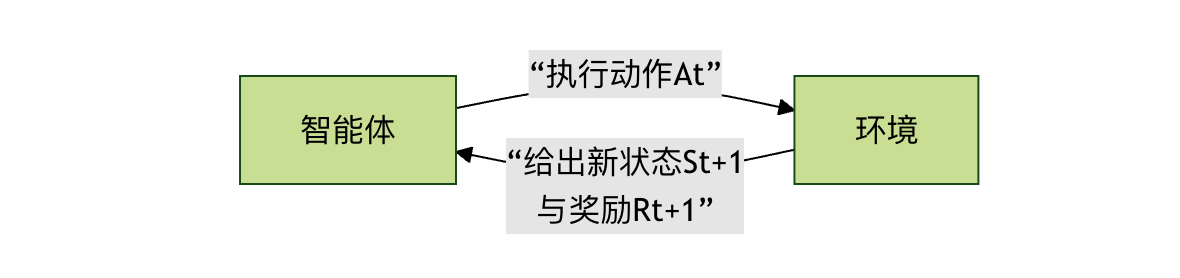
Этот цикл продолжается до достижения терминального состояния (например, прохождения или провала игры).
Классическая задача: Cliff Walking
Чтобы применить теорию на практике, мы будем использовать классическую примерную среду обучения с подкреплением:CliffWalking-v0(Cliff Walking). Она происходит изgymnasiumбиблиотеки (поддерживаемой ветки оригинального OpenAI Gym).
Описание среды
- Сценарий: сеточный мир 4x12.
- Начальная точка: левый нижний угол (координаты [3, 0]).
- Конечная точка: правый нижний угол (координаты [3, 11]).
- Обрыв: все позиции в нижнем ряду, кроме начальной и конечной точек ([3, 1] до [3, 10]). Падение с обрыва приводит к огромному штрафу и возвращению в начальную точку.
- Цель: Агент должен безопасно пройти из начальной точки в конечную, избегая падения с обрыва.
- Действия: вверх (0), вправо (1), вниз (2), влево (3).
- Награды:
- Каждый шаг по обычной клетке: -1 (поощряет достижение цели за меньшее число шагов)
- Падение с обрыва: -100, и агент отправляется обратно в начальную точку
- Достижение цели: 0, и завершает этот эпизод
Введение в алгоритм: Q-Learning
Мы будем использовать алгоритмQ-Learningдля решения этой задачи. Этоmodel-freeалгоритм обучения с подкреплением, означающий, что агенту не нужно заранее знать основные правила среды (например, вероятности переходов между состояниями). Он обучается через непрерывные пробы и ошибки.
В его основе лежит таблица под названиемQ-таблица.
- СтрокаСтроки представляют все возможные состояния.
- СтолбецСтолбцы представляют все возможные действия.
- Значение ячейки (Q-значение)представляет собой долгосрочную ожидаемую отдачу от выполнения определённого действия в определённом состоянии.
Процесс обучения Q-Learning можно обобщить в следующих шагах. Он показывает, как агент обновляет свои знания (Q-таблицу) через отдельный опыт:
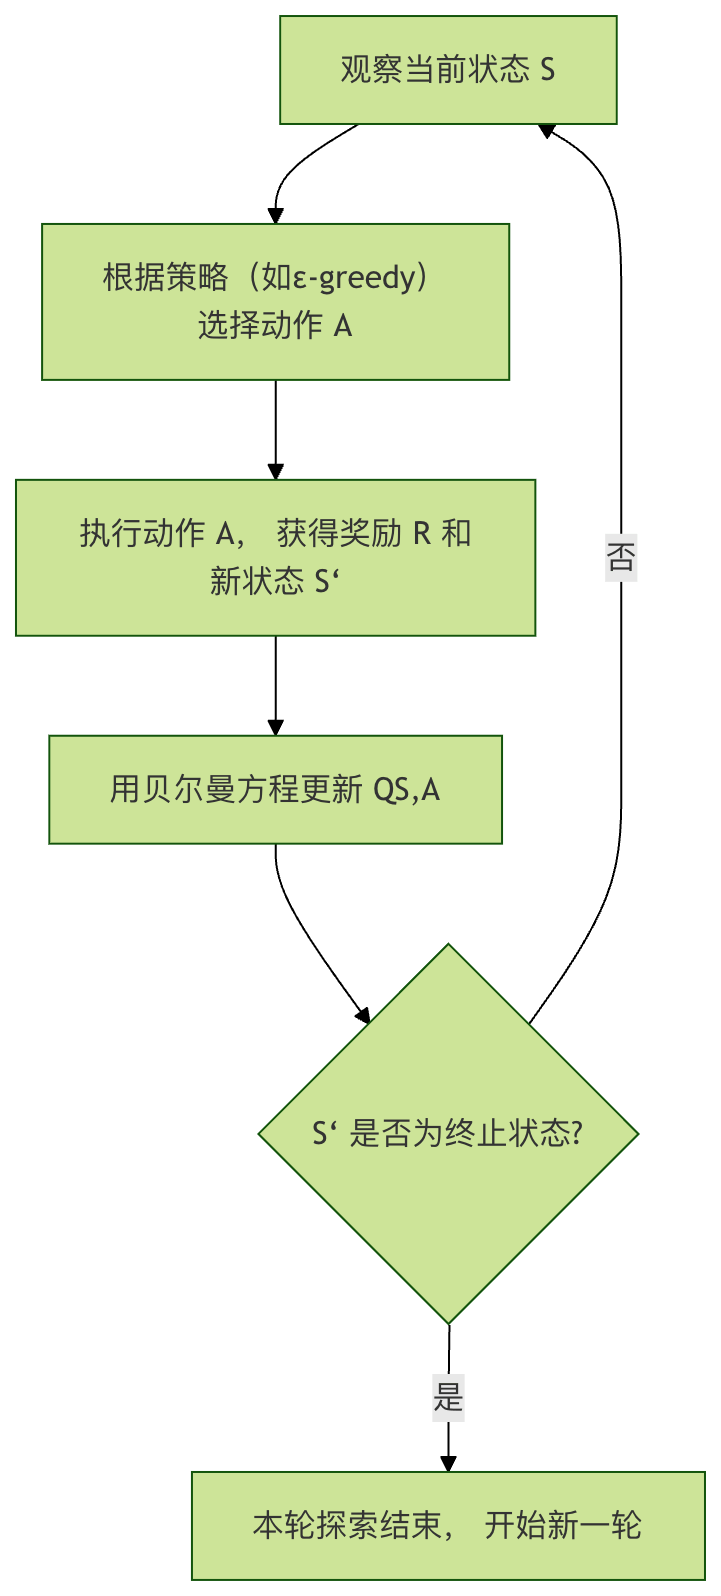
Основная формула: уравнение Беллмана
Математической основой обновления Q-таблицы является уравнение Беллмана, а формула его обновления выглядит так:
\[ Q(S, A) \leftarrow Q(S, A) + \alpha [R + \gamma \max_{a} Q(S', a) - Q(S, A)] \]
Давайте разберём каждую часть этой формулы:
| Символ | Значение | Объяснение по аналогии |
|---|---|---|
| \( Q(S, A) \) | Исходное Q-значение действия A в состоянии S | Ваша предыдущая старая оценка решения ехать прямо на перекрёстке |
| \(\alpha \) | Скорость обучения (0 < α ≤ 1) | Насколько вы доверяете этому новому опыту. α=1 означает полную замену старых знаний новым опытом; α=0.1 означает, что новый опыт лишь слегка корректирует старые знания |
| \(R \) | Немедленноевознаграждение | После того как вы едете прямо, вы обнаруживаете, что дорога свободна, и получаете небольшую положительную обратную связь (+1) |
| \(\gamma \) | Коэффициент дисконтирования (0 ≤ γ < 1) | Насколько сильно вы цените будущие награды. γ=0 означает, что вас интересуют только немедленные награды; γ=0.9 означает, что долгосрочная отдача имеет большое значение |
| \(\max_{a} Q(S', a) \) | Максимальное Q-значение среди всех возможных действий в новом состоянии S' | После прибытия на новый перекрёсток вы оцениваете, какой из вариантов — повернуть налево, повернуть направо или поехать прямо — имеет наибольшую будущую отдачу |
| \(R + \gamma \max_{a} Q(S', a)\) | Целевое Q-значение, представляющее собой новую и лучшую оценку текущего решения | Объединяя немедленную награду и наилучшую будущую отдачу, получаем новую оценку для решения ехать прямо на старом перекрёстке |
| \(R + \gamma \max_{a} Q(S', a) - Q(S, A)\) | Ошибка временной разности, разрыв между новым и старым знанием | Разница между новой оценкой и старой оценкой. Эта разница движет обучением. |
Проще говоря, эта формула позволяет агенту использоватьнемедленную награду + дисконтированную наилучшую оценку будущегодля непрерывного пересмотра своего суждения о ценности текущего решения.
Практика: написание агента Q-обучения
Теперь давайте с помощью кода реализуем агента Q-обучения, который решает задачу Cliff Walking.
Шаг 1: Установка и импорт библиотек
Сначала убедитесь, что вы установили необходимые библиотеки. Выполните следующее в терминале или командной строке:
Пример
Затем импортируйте их в Python-файле:
Пример
import numpy as np
import random
Шаг 2: Инициализация среды и Q-таблицы
Пример
env = gym.make("CliffWalking-v0", render_mode="human") # render_mode="human" используется для визуализации
# 2. Получить информацию о среде
n_states = env.observation_space.n # Общее количество состояний (4*12=48)
n_actions = env.action_space.n # Общее количество действий (4 направления)
# 3. Инициализируйте Q-таблицу с формой [число состояний, число действий], все начальные значения 0
Q_table = np.zeros((n_states, n_actions))
print(f"Количество состояний среды: {n_states}, количество действий: {n_actions}")
print(f"Форма Q-таблицы: {Q_table.shape}")
Шаг 3: Установка гиперпараметров
Гиперпараметры — это рычаги, которые управляют поведением алгоритма и должны настраиваться в зависимости от задачи.
Пример
alpha = 0.1 # Скорость обучения: степень влияния новой информации
gamma = 0.99 # Коэффициент дисконтирования: важность будущих наград
epsilon = 0.1 # Коэффициент исследования: вероятность выполнения случайного исследования (а не выбора известного лучшего)
num_episodes = 500 # Количество эпизодов обучения (сколько раз агент играет в игру)
Шаг 4: Реализуйте ε-жадную стратегию
Это основная стратегия принятия решений агентом; она балансирует междуисследованиемиэксплуатацией。
- Исследование: случайный выбор действий для обнаружения потенциально лучших стратегий.
- Эксплуатация: выбор действия, которое текущая Q-таблица считает оптимальным, для получения максимальной выгоды.
Пример
"""
Выберите действие в соответствии с ε-жадной политикой.
Параметры:
state: текущее состояние
Q_table: таблица Q-значений
epsilon: вероятность исследования
Возвращает:
action: выбранное действие (0, 1, 2, 3)
"""
# Сгенерировать случайное число от 0 до 1
if random.uniform(0, 1) < epsilon:
# Исследование: случайно выбрать действие
action = env.action_space.sample()
else:
# Эксплуатация: выбрать действие с наибольшим Q-значением в текущем состоянии
# np.argmax возвращает индекс максимального значения, т. е. оптимальное действие
action = np.argmax(Q_table[state])
return action
Шаг 5: Основной цикл обучения
Это основной процесс, с помощью которого алгоритм обучается.
Пример
reward_history = []
for episode in range(num_episodes):
# Сбросить среду и получить начальное состояние
state, _ = env.reset()
total_reward = 0 # Суммарное вознаграждение за этот эпизод
terminated = False # Достигнуто ли терминальное состояние (цель/обрыв)
truncated = False # Было ли завершение из-за превышения лимита шагов (обычно в этой среде этого не произойдёт)
# Цикл взаимодействия для этого эпизода до окончания игры
while not (terminated or truncated):
# 1. Выбрать действие
action = choose_action(state, Q_table, epsilon)
# 2. Выполнить действие и получить обратную связь от среды
next_state, reward, terminated, truncated, _ = env.step(action)
# 3. Обновить Q-таблицу (основная формула обновления Q-Learning)
# Получить текущее Q-значение
current_q = Q_table[state, action]
# Вычислить целевое Q-значение: немедленная награда + дисконтированное максимальное будущее Q-значение
# Примечание: если следующее состояние — терминальное, будущего Q-значения нет
if terminated:
target_q = reward
else:
target_q = reward + gamma * np.max(Q_table[next_state])
# Применить уравнение Беллмана для обновления Q-значения
Q_table[state, action] = current_q + alpha * (target_q - current_q)
# 4. Переход к следующему состоянию и накопление награды
state = next_state
total_reward += reward
# Записать суммарную награду за этот эпизод
reward_history.append(total_reward)
# Выводить прогресс каждые 100 эпизодов
if (episode + 1) % 100 == 0:
avg_reward = np.mean(reward_history[-100:]) # Средняя награда за последние 100 эпизодов
print(f"Эпизод {episode + 1}, средняя награда за последние 100 эпизодов: {avg_reward:.2f}")
# Обучение завершено, закрыть среду
env.close()
Шаг 6: Тестирование обученного агента
После завершения обучения мы отключаем исследование и позволяем агенту использовать исключительно полученные знания (Q-таблицу), чтобы пройти среду и посмотреть, как он справляется.
Пример
# Создайте новую тестовую среду (можно опустить render_mode или изменить его на "human" для просмотра)
test_env = gym.make("CliffWalking-v0", render_mode="human")
state, _ = test_env.reset()
test_terminated = False
test_truncated = False
step_count = 0
while not (test_terminated or test_truncated):
# При тестировании мы устанавливаем epsilon=0, то есть чистая эксплуатация, без исследования
action = choose_action(state, Q_table, epsilon=0)
state, reward, test_terminated, test_truncated, _ = test_env.step(action)
step_count += 1
print(f"Шаг {step_count}: состояние {state}, действие {action}, награда {reward}")
print(f"Тестирование завершено! Всего шагов: {step_count}, общая награда: {reward} (награда за достижение цели равна 0)")
test_env.close()
Результаты выполнения и анализ
Полный код:
Пример
import numpy as np
import random
# =========================
# 1. Создать среду
# =========================
env = gym.make("CliffWalking-v0", render_mode="human")
# =========================
# 2. Получить информацию о среде
# =========================
n_states = env.observation_space.n
n_actions = env.action_space.n
# =========================
# 3. Инициализация Q-таблицы
# =========================
Q_table = np.zeros((n_states, n_actions))
print(f"Количество состояний среды: {n_states}")
print(f"Количество действий: {n_actions}")
print(f"Форма Q-таблицы: {Q_table.shape}")
# =========================
# 4. Установка гиперпараметров
# =========================
альфа = 0.1
гамма = 0.99
эпсилон = 0.1
num_episodes = 500
# =========================
# 5. ε-жадная стратегия
# =========================
def choose_action(state, Q_table, epsilon):
if random.uniform(0, 1) < epsilon:
return env.action_space.sample()
return np.argmax(Q_table[state])
# =========================
# 6. Цикл обучения
# =========================
reward_history = []
for episode in range(num_episodes):
state, _ = env.reset()
total_reward = 0
terminated = False
truncated = False
while not (terminated or truncated):
action = choose_action(state, Q_table, epsilon)
next_state, reward, terminated, truncated, _ = env.step(action)
current_q = Q_table[state, action]
if terminated:
target_q = reward
else:
target_q = reward + gamma * np.max(Q_table[next_state])
Q_table[state, action] = current_q + alpha * (target_q - current_q)
state = next_state
total_reward += reward
reward_history.append(total_reward)
if (episode + 1) % 100 == 0:
avg_reward = np.mean(reward_history[-100:])
print(f"Эпизод {episode + 1}, средняя награда за последние 100 эпизодов: {avg_reward:.2f}")
env.close()
# =========================
# 7. Проверка результатов обучения
# =========================
print("\n"=== Начало теста ===")
test_env = gym.make("CliffWalking-v0", render_mode="human")
state, _ = test_env.reset()
terminated = False
truncated = False
step_count = 0
total_reward = 0
while not (terminated or truncated):
action = choose_action(state, Q_table, epsilon=0)
state, reward, terminated, truncated, _ = test_env.step(action)
step_count += 1
total_reward += reward
print(f"Шаг {step_count}: состояние {state}, действие {action}, награда {reward}")
print(f"Тестирование завершено, всего шагов: {step_count}, суммарная награда: {total_reward}")
test_env.close()
После запуска всего кода выше вы увидите два очень наглядных явления: изменение вознаграждений на этапе обучения и фактический путь действий агента на этапе тестирования.
1. Фаза обучения: награды постепенно растут
Во время обучения консоль каждые 100 эпизодов выводит среднюю награду за последние 100 эпизодов. Например:
轮次 100, 最近100轮平均奖励: -120.45
轮次 200, 最近100轮平均奖励: -65.32
轮次 300, 最近100轮平均奖励: -32.18
轮次 400, 最近100轮平均奖励: -18.06
轮次 500, 最近100轮平均奖励: -13.94
Вы заметите очевидную тенденцию:Средняя награда продолжает расти (абсолютное значение отрицательных значений становится меньше)。
Что это означает?
- На ранней стадии обучения агент часто срывается с обрыва и получает большое количество
-100штрафов. - По мере обучения Q-таблица постепенно учится тому, «какие пути опасны, а какие безопасны».
- Агент начинает активно избегать обрыва и выбирать безопасный маршрут, который длиннее, но имеет меньшие штрафы.
Улучшение наград по сути отражает улучшение качества политики.
2. Фаза тестирования: поведенческие показатели агента
На фазе тестирования мы устанавливаемepsilonε равным 0, что означает:
- Больше не выполнять никакого случайного исследования
- Действовать полностью в соответствии с оптимальной политикой, изученной в Q-таблице
Если вы включили этоrender_mode="human", вы увидите очень типичное поведение:
- Агент начинает из стартовой точки
- Двигается горизонтально на позиции на одну клетку выше обрыва
- Затем движется вниз, приближаясь к цели, и безопасно достигает её
Именно это считается в среде CliffWalkingоптимальной политикой:
- не кратчайший путь (вплотную к обрыву)
- а скореепуть с минимальным ожидаемым штрафомpath
Это отражает ключевую особенность обучения с подкреплением:оно стремится к долгосрочной совокупной награде, а не к краткосрочной оптимальности。
3. Почему он научился идти в обход вместо того, чтобы выбрать рискованный прямой путь?
Это очень важный и также очень классический вопрос.
С точки зрения человеческой интуиции, идти вдоль обрыва — это кратчайший путь, но для агента:
- При одном неверном шаге он сразу получает
-100огромный штраф. - Для сравнения, несколько лишних шагов приводят лишь к нескольким дополнительным штрафам.
-1
Под кумулятивным эффектом уравнения Беллмана:
Постоянные небольшие потери < редкие крупные катастрофы
Следовательно, Q-Learning естественным образом сойдётся к более консервативной политике с более высокой общей ожидаемой доходностью.
Частые проблемы и влияние параметров
1. Что произойдёт, если скорость обучения α слишком велика или слишком мала?
- α слишком велика: процесс обучения колеблется, политика нестабильна, и она легко многократно перечёркивает накопленный опыт
- α слишком мала: обучение идёт очень медленно и требует много эпизодов для сходимости
В этом примере,0.1является относительно безопасным выбором.
2. Интуитивное значение коэффициента дисконтирования γ
γ → 0: агент заботится только о немедленных наградах и легко становится недальновиднымγ → 1: агент высоко ценит долгосрочные последствия и больше похож на дальновидного планировщика
В задаче прогулки по обрыву большее значение γ помогает агенту понять, что сделать один дополнительный шаг сейчас — значит избежать больших потерь в будущем.
3. Ключевая роль ε
εЭто определяет характер агента:
- ε большой → любит рисковать, больше исследует
- ε малый → консервативен, больше использует имеющийся опыт
В реальных проектах мы обычно используемстратегию снижения ε::
- больше исследуем на раннем этапе
- и постепенно сходимся к стабильной политике на более позднем этапе
Ограничения этого примера и направления для расширения
Хотя Q-обучение — это классика, у него также есть очевидные ограничения:
- Размер Q-таблицы линейно растёт с ростом пространства состояний
- Не может напрямую обрабатывать непрерывные состояния (например, реальный физический мир)
- Медленно сходится в сложных средах
Именно поэтому в более сложных задачах мы вводим:
- Глубокая Q-сеть(DQN)
- Градиент политики
- Актор-критик
Они используют нейронные сети для замены Q-таблицы, что позволяет применять обучение с подкреплением к реальным сценариям, таким как игры, управление роботами и автономное вождение.
Итог
Благодаря этому полному примеру обучения с подкреплением вы:
- Поняли фундаментальное различие между обучением с подкреплением и обучением с учителем / без учителя
- Освоен полный замкнутый цикл: агент, среда, состояние, действие, награда и политика
- Собственноручно реализован работающий, наблюдаемый и сходящийся агент Q-Learning
- Усвоена основная идея обучения с подкреплением: максимизация долгосрочной отдачи