Машинное обучение - Сегментация клиентов
В современном бизнес-мире, управляемом данными, понимание клиентов является ключом к успеху.
Однако, когда ваша клиентская база достигает десятков тысяч или даже миллионов, ручной анализ характеристик и поведенческих моделей каждого клиента становится непрактичным.
В этот момент методы машинного обучения, особеннообучение без учителя— алгоритмы кластеризации в нём — становятся мощным инструментом.
Сегментация клиентов, также известная как сегментация клиентской базы, имеет основной целью разделение большой клиентской базы на несколько подгрупп со схожими характеристиками. Это похоже на опытного владельца магазина, который больше не рассматривает клиентов как расплывчатое целое, а может четко выделять разные группы: экономных домохозяек, любителей технологий, следящих за новинками, и премиальных клиентов, ценящих сервис и впечатления. Применяя целевые маркетинговые, сервисные и продуктовые стратегии к разным группам, компании могут значительно повысить операционную эффективность и удовлетворенность клиентов.
В этой статье мы шаг за шагом проведем вас через полный практический проект по сегментации клиентов. Мы будем использовать классический алгоритм кластеризации K-Means для анализа смоделированного набора данных о розничных клиентах, от понимания данных до оценки модели, и в итоге получим результаты сегментации с бизнес-инсайтами.
Понимание кластерного анализа и алгоритма K-Means
Прежде чем начать практику, нам нужно понять основные инструменты, которые мы собираемся использовать.
Что такое кластерный анализ?
Кластерный анализ — это метод обучения без учителя. В отличие от обучения с учителем (например, прогнозирования цен на дома или распознавания изображений кошек и собак), у алгоритмов кластеризации нет заранее размеченных «правильных ответов» (то есть меток). Их задача — исследовать внутреннюю структуру данных, автоматически группируя похожие точки данных в одну группу (называемую «кластером»), при этом делая точки данных в разных группах как можно более непохожими.
Простая аналогия: Представьте, что у вас есть корзина со смешанными фруктами: яблоками, апельсинами и бананами. Задача алгоритма кластеризации — автоматически сложить вместе фрукты, похожие по форме, цвету и размеру, без того чтобы кто-то сообщал вам названия категорий.
Как работает алгоритм K-Means
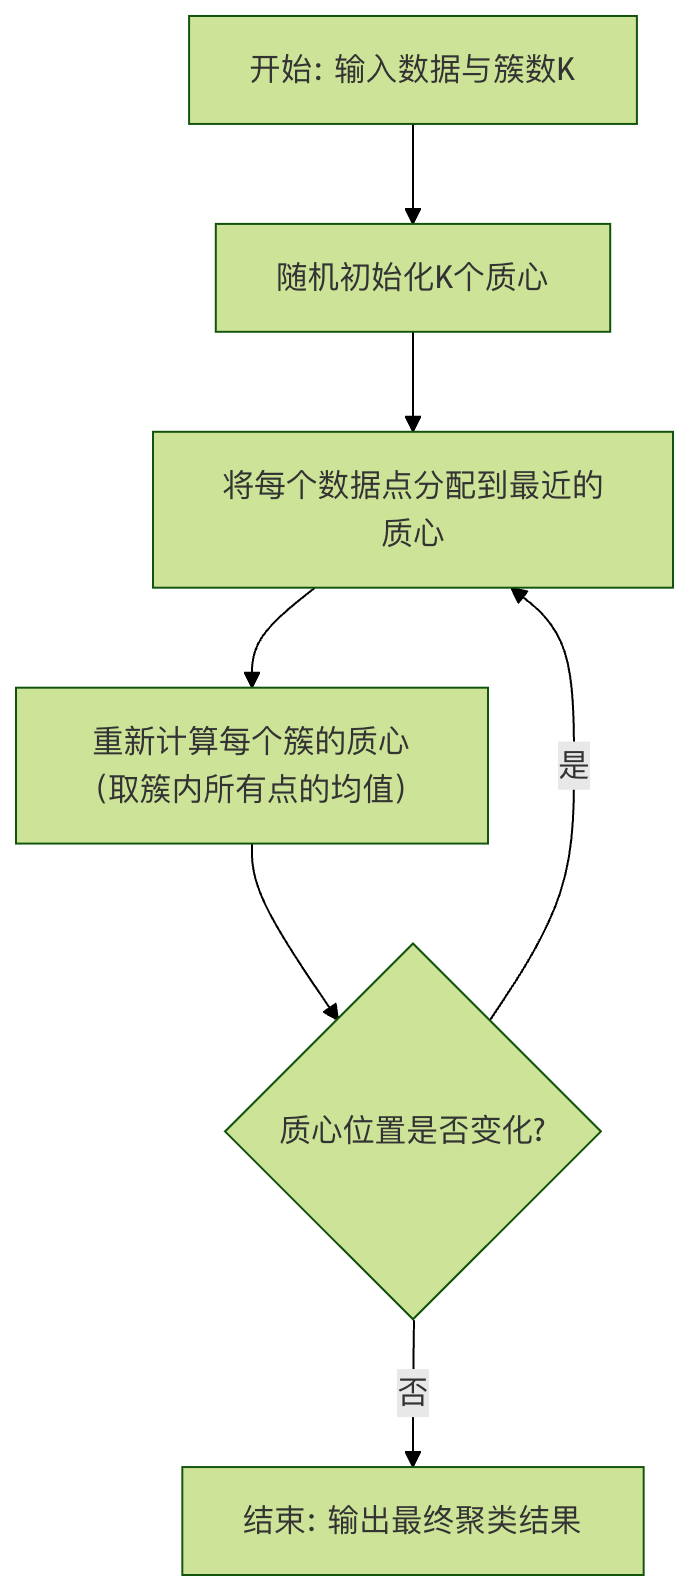
K-Means — один из наиболее часто используемых и интуитивно понятных алгоритмов кластеризации. «K» обозначает число кластеров, на которые мы хотим разделить данные. Его принцип работы можно кратко описать четырьмя шагами:
- Инициализация: случайным образом выбираем K точек данных в качестве начальных «центров кластеров» (центроидов).
- Назначение: вычисляем расстояние от каждой точки данных до каждого центроида (обычно используя евклидово расстояние), затем относим каждую точку к кластеру ближайшего центроида.
- Обновление: пересчитываем центроид каждого кластера (то есть среднее всех точек в этом кластере).
- Итерация: повторяем шаги 2 и 3, пока положения центроидов больше не меняются существенно или пока не достигнуто заданное число итераций.
Приведённая ниже блок-схема наглядно иллюстрирует этот процесс:
Ключевые моменты алгоритма:
- Метрика расстояния: обычно для измерения схожести между точками данных используется евклидово расстояние; чем меньше расстояние, тем выше схожесть.
- Центроид: представляет «среднюю точку» или центр кластера.
- Цель: минимизировать сумму квадратов расстояний от точек данных до их центроида внутри каждого кластера (называется «внутрикластерной суммой квадратов» или Inertia).
Практическое занятие: сегментация розничных клиентов
Теперь применим теорию на практике. Мы будем использовать Python и его мощные библиотеки экосистемы Data Science, чтобы выполнить этот проект.
Шаг 1: Настройка окружения и загрузка данных
Сначала убедитесь, что необходимые библиотеки установлены в вашей среде Python:pandasдля обработки данных,numpyдля численных вычислений,matplotlibиseabornдля визуализации,scikit-learnявляется основной библиотекой машинного обучения.
Пример
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import silhouette_score
import warnings
warnings.filterwarnings('ignore') # Игнорировать некритические предупреждения
# Установить стиль визуализации
sns.set_style("whitegrid")
# -------------------------- Начало настройки китайского шрифта --------------------------
plt.rcParams['font.sans-serif'] = [
# Сначала Windows
'SimHei', 'Microsoft YaHei',
# Сначала macOS
'PingFang SC', 'Heiti TC',
# Сначала Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Исправить проблему отображения отрицательных знаков в виде квадратов
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Конец настройки китайского шрифта --------------------------
Мы будем использовать смоделированный набор данных о клиентахcustomer_data.csv, который обычно содержит следующие признаки:
CustomerID: Уникальный идентификатор клиентаAnnual_Income_(k$): Годовой доход клиента (в тысячах долларов)Spending_Score: Оценка расходов (0-100, комплексно рассчитывается на основе частоты покупок, суммы и т. д.)Age: Возраст
Содержимое выглядит следующим образом:
CustomerID,Age,Annual_Income_(k$),Spending_Score
1,19,15,39
2,21,15,81
3,20,16,6
4,23,16,77
5,31,17,40
6,22,17,76
7,35,18,6
8,23,18,94
9,64,19,3
10,30,19,72
11,67,20,14
12,35,20,99
13,58,21,15
14,24,21,77
15,37,22,13
16,22,22,79
17,35,23,35
18,20,23,66
19,52,24,29
20,35,24,98
21,46,25,35
22,25,25,73
23,54,26,5
24,28,26,73
25,45,27,28
26,23,28,82
27,40,28,36
28,35,28,61
29,60,29,4
30,21,30,87
31,62,30,17
32,23,30,73
33,18,31,92
34,49,33,14
35,21,33,81
36,42,34,17
37,30,34,73
38,36,37,26
39,20,37,75
40,65,38,35
41,24,38,92
42,48,39,36
43,31,39,61
44,49,40,29
45,24,40,98
46,50,41,15
47,27,42,65
48,29,43,88
49,31,43,19
50,49,44,75
Пример
df = pd.read_csv('customer_data.csv')
print("Форма данных (строки, столбцы):", df.shape)
print("\n"Первые 5 строк данных:")
print(df.head())
print("\n"Основная информация о данных:")
print(df.info())
print("\n"Описательная статистика:")
print(df.describe())
Вывод:
数据形状(行数,列数): (50, 4)

数据前5行:
   CustomerID  Age  Annual_Income_(k$)  Spending_Score
0           1   19                  15              39
1           2   21                  15              81
2           3   20                  16               6
3           4   23                  16              77
4           5   31                  17              40

数据基本信息:
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 50 entries, 0 to 49
Data columns (total 4 columns):
 #   Column              Non-Null Count  Dtype
---  ------              --------------  -----
 0   CustomerID          50 non-null     int64
 1   Age                 50 non-null     int64
 2   Annual_Income_(k$)  50 non-null     int64
 3   Spending_Score      50 non-null     int64
dtypes: int64(4)
memory usage: 1.7 KB
None

描述性统计:
       CustomerID        Age  Annual_Income_(k$)  Spending_Score
count    50.00000  50.000000           50.000000       50.000000
mean     25.50000  35.560000           28.160000       51.680000
std      14.57738  14.283085            8.739682       31.506682
min       1.00000  18.000000           15.000000        3.000000
25%      13.25000  23.000000           21.000000       20.750000
50%      25.50000  31.000000           27.500000       61.000000
75%      37.75000  47.500000           36.250000       77.000000
max      50.00000  67.000000           44.000000       99.000000
Шаг 2: Исследование данных и предварительная обработка
Прежде чем применять алгоритм, необходимо сначала понять данные и правильно выполнить "очистку".
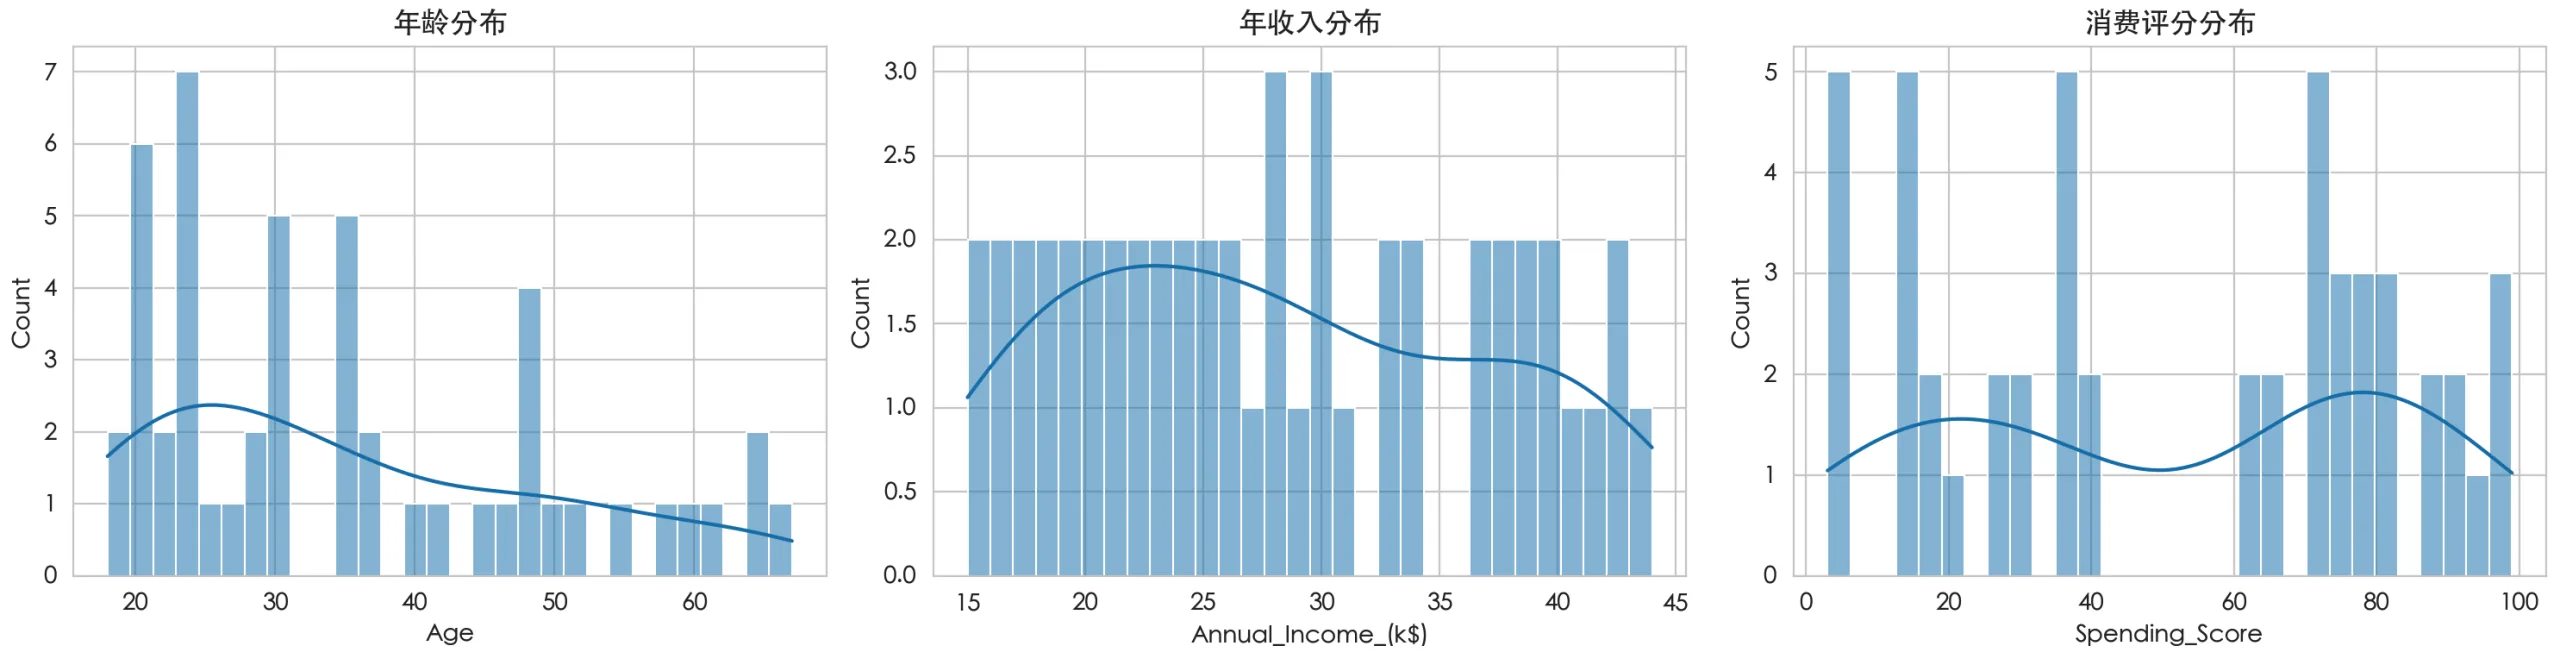
1. Разведочный анализ данныхСначала выявляйте закономерности с помощью визуализации и статистики.
Пример
fig, axes = plt.subplots(1, 3, figsize=(15, 4))
sns.histplot(df['Age'], bins=30, kde=True, ax=axes[0])
axes[0].set_title('Распределение возраста')
sns.histplot(df['Annual_Income_(k$)'], bins=30, kde=True, ax=axes[1])
axes[1].set_title('Распределение годового дохода')
sns.histplot(df['Spending_Score'], bins=30, kde=True, ax=axes[2])
axes[2].set_title('Распределение показателя расходов')
plt.tight_layout()
plt.show()
# Просмотр взаимосвязей между признаками
sns.pairplot(df[['Age', 'Annual_Income_(k$)', 'Spending_Score']])
plt.suptitle('Матрица диаграмм рассеяния взаимосвязей признаков', y=1.02)
plt.show()
2. Предобработка данныхАлгоритмы кластеризации очень чувствительны к размерности (единицам измерения) признаков. Числовые диапазоны годового дохода (десятки тысяч) и возраста (десятки) сильно различаются, что серьёзно повлияет на вычисление расстояния и приведёт к тому, что признак дохода будет доминировать в результатах кластеризации. Поэтому нам нужно выполнитьстандартизацию признаков, которая масштабирует каждый признак к стандартному нормальному распределению со средним 0 и дисперсией 1.
Пример
features = ['Age', 'Annual_Income_(k$)', 'Spending_Score']
X = df[features].copy()
# Стандартизация признаков
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X) # fit вычисляет среднее и дисперсию, transform применяет преобразование
X_scaled_df = pd.DataFrame(X_scaled, columns=features)
print("Первые 5 строк стандартизированных данных:")
print(X_scaled_df.head())
Шаг 3: Определение оптимального числа кластеров (значение K)
K-Means требует заранее указать значение K. Как выбрать разумное значение K? Мы используем два классических метода:
1. Метод локтяПостройте график внутрикластерной суммы квадратов (инерции) для разных значений K. Инерция уменьшается с ростом K; мы ищем точку перегиба кривой (похожую на локоть), после которой выгода (уменьшение инерции) от дальнейшего увеличения K становится меньше.
Пример
K_range = range(1, 11) # Проверить K от 1 до 10
for k in K_range:
kmeans = KMeans(n_clusters=k, random_state=42, n_init='auto') # n_init='auto' — это использование в новых версиях
kmeans.fit(X_scaled)
inertia.append(kmeans.inertia_) # Получить инерцию для этого значения K
# Построить график метода локтя
plt.figure(figsize=(8,5))
plt.plot(K_range, inertia, 'bo-')
plt.xlabel('Количество кластеров (K)')
plt.ylabel('Внутрикластерная сумма квадратов (инерция)')
plt.title('Метод локтя: выбор наилучшего значения K')
plt.xticks(K_range)
plt.show()
2. Метод силуэтного коэффициентаСилуэтный коэффициент измеряет сходство точки данных с её собственным кластером (сплочённость) и её отделённость от других кластеров. Его значение находится в диапазоне от -1 до 1,чем выше, тем лучше, что указывает на лучшее качество кластеризации.
Пример
K_range = range(2, 11) # Для силуэтного коэффициента требуется как минимум 2 кластера
for k in K_range:
kmeans = KMeans(n_clusters=k, random_state=42, n_init='auto')
cluster_labels = kmeans.fit_predict(X_scaled)
score = silhouette_score(X_scaled, cluster_labels)
silhouette_scores.append(score)
# Построить график коэффициента силуэта
plt.figure(figsize=(8,5))
plt.plot(K_range, silhouette_scores, 'go-')
plt.xlabel('Количество кластеров (K)')
plt.ylabel('Коэффициент силуэта')
plt.title('Метод коэффициента силуэта: выбор наилучшего значения K')
plt.xticks(K_range)
plt.show()
Объединяя график метода локтя (точка перегиба) и график коэффициента силуэта (пик), мы предполагаем и определяем, чтоK=5— хороший выбор.
Шаг 4: Применение K-Means для кластеризации
Обучите модель, используя выбранное значение K, и присвойте метки кластеров каждому клиенту.
Пример
final_k = 5
kmeans_final = KMeans(n_clusters=final_k, random_state=42, n_init='auto')
df['Cluster'] = kmeans_final.fit_predict(X_scaled) # Добавить метки кластеров к исходному датафрейму
# Посмотреть количество клиентов в каждом кластере
cluster_counts = df['Cluster'].value_counts().sort_index()
print("Распределение количества клиентов по кластерам:")
print(cluster_counts)
# Посмотреть средние значения признаков по кластерам (в исходном масштабе)
cluster_profile = df.groupby('Cluster')[features].mean().round(2)
print("\nСредние значения признаков по кластерам:)
print(cluster_profile)
Шаг 5: Анализ результатов и визуализация
Преобразуйте абстрактные метки кластеров в интуитивно понятные выводы.
1. Визуализируйте результаты кластеризацииПоскольку у нас есть три признака, мы можем выбрать два наиболее важных признака (например, доход и оценку расходов) для визуализации на двумерной плоскости.
Пример
plt.figure(figsize=(10, 6))
scatter = plt.scatter(df['Annual_Income_(k$)'], df['Spending_Score'],
c=df['Cluster'], cmap='viridis', s=50, alpha=0.7)
plt.colorbar(scatter, label='Метка кластера')
plt.xlabel('Годовой доход (k$)')
plt.ylabel('Оценка расходов')
plt.title('Результаты сегментации клиентов (на основе годового дохода и оценки расходов)')
plt.show()
2. Профилирование клиентских сегментовСогласноcluster_profileтаблице, мы можем присвоить бизнес-смысл каждому кластеру:
| Метка кластера | Age | Годовой доход | Оценка расходов | Возможный профиль клиента |
|---|---|---|---|---|
| 0 | Средняя | Высокая | Низкая | Осторожный тип с высоким доходом: высокий доход, но консервативные расходы; могут быть вкладчиками или состоятельными людьми, чувствительными к цене. |
| 1 | Средняя | Низкая | Низкая | Тип с низким доходом и низкими расходами: и доход, и покупательная способность ограничены; им нужны продукты с оптимальным соотношением цены и качества. |
| 2 | Средняя | Низкая | Высокая | Тип, ищущий выгоду: доход невысокий, но они любят тратить; они ценят тренды и впечатления и являются целевой аудиторией для промоакций. |
| 3 | Средняя | Высокая | Высокая | Идеальный VIP-тип: высокий доход и высокие расходы; они — основной источник прибыли предприятия, и им следует предоставлять первоклассные услуги и эксклюзивные преимущества. |
| 4 | Молодые | Средняя | Средняя | Молодой потенциальный тип: молодые клиенты, чьи доходы и расходы находятся на стадии роста; они важны для формирования лояльности к бренду. |
Шаг 6: Оценка модели и рекомендации по применению
Оценка: помимо силуэтного коэффициента, можно проверить, сбалансировано ли распределение выборок внутри кластеров, и с учётом бизнес-логики судить, разумна ли сегментация.
Рекомендации по применению:
- Точечный маркетинг: продвигайте высококлассные новые продукты и эксклюзивные мероприятия для «Идеального VIP-типа» (кластер 3); отправляйте скидочные купоны и информацию о групповых покупках «Типу, ищущему выгоду» (кластер 2).
- Разработка продуктов: Создавайте модные продукты с сильными социальными характеристиками для «Молодого потенциального типа» (Кластер 4).
- Обслуживание клиентов: Предоставляйте «Осторожному типу с высоким доходом» (Кластер 0) подробные данные о продукте и гарантии безопасности, чтобы развеять их опасения.
- Распределение ресурсов: Выделяйте больше ресурсов на обслуживание клиентов и маркетинг для сегментов высокоценных клиентов.
Итоги и дальнейшее исследование
В этом практическом кейсе вы полностью прошли процесс сегментации клиентов с помощью алгоритма K-Means:Подготовка данных -> Исследовательский анализ -> Предобработка -> Определение значения K -> Обучение модели -> Анализ результатов。
Обзор ключевых моментов:
- Кластеризация — это метод обучения без учителя, используемый для обнаружения внутренних группировок в данных.
- Стандартизация признаков— ключевой этап перед использованием алгоритмов кластеризации, основанных на расстоянии.
- Метод локтяиоценка силуэта— практические инструменты для определения оптимального числа кластеров.
- Интерпретация результатов кластеризации должнасочетаться со знанием бизнеса, чтобы приносить реальную ценность.